配置元数据(元数据管理应用){ #metadata_management_app }
注意
本节介绍了 元数据管理应用,该应用取代了“维护”应用的功能。 可通过 DHIS2 应用中心 获取,并兼容 DHIS2 核心 V41 及以上版本。
如果您正在使用未安装元数据管理应用的 DHIS2,请参阅 配置元数据 以了解“维护”应用的相关内容。
关于“元数据管理”应用{ #mm_about_metadata_management_app }
在 元数据管理 应用中,您可以配置所有用于收集和分析数据所需的元数据对象:
- Table: Dimensions and dimension items
- startDate 和 endDate 参数允许获取链接的数据 到这些日期之间的任何时间段。这避免了定义所有 期间明确在 要求:
- 数据集和数据输入表格
- 指标与预测因子
- E7229
- CATEGORY_OPTION_GROUP
- 验证
- createdAtClient
- 常数
- 传说
- SQL 视图
- 区域设置
- 分析表挂钩
注意
您可以使用的功能取决于您的用户角色的访问权限。
该应用的侧边栏还包含**项目**和**数据审批**部分,本章 将不对此进行介绍。 有关这些内容,请参阅 配置项目(元数据管理应用) 和 数据审批概述。
注意
“元数据管理”应用采用持续发布周期,这意味着会定期添加新的章节和功能。如果上述列出的某个章节在您已安装的应用版本中尚未显示,可能是该功能尚未实现。您可以从应用中心更新应用,以获取最新功能。
“元数据管理”应用是对旧版“维护”应用的全面现代化升级。主要改进包括:
- 合并重复的元数据 — 您可以直接在列表视图中合并重复的元数据对象(目前包括:类别选项、指标、指标类型)。此功能有助于持续进行元数据清理工作。
- 高级筛选和搜索 — 每个对象列表都提供了改进的筛选选项,可帮助您按名称、代码或其他属性查找对象。
- 批量共享 — 您可以一次性更新多个对象的共享设置。
浏览元数据对象{ #mm_navigating_metadata }
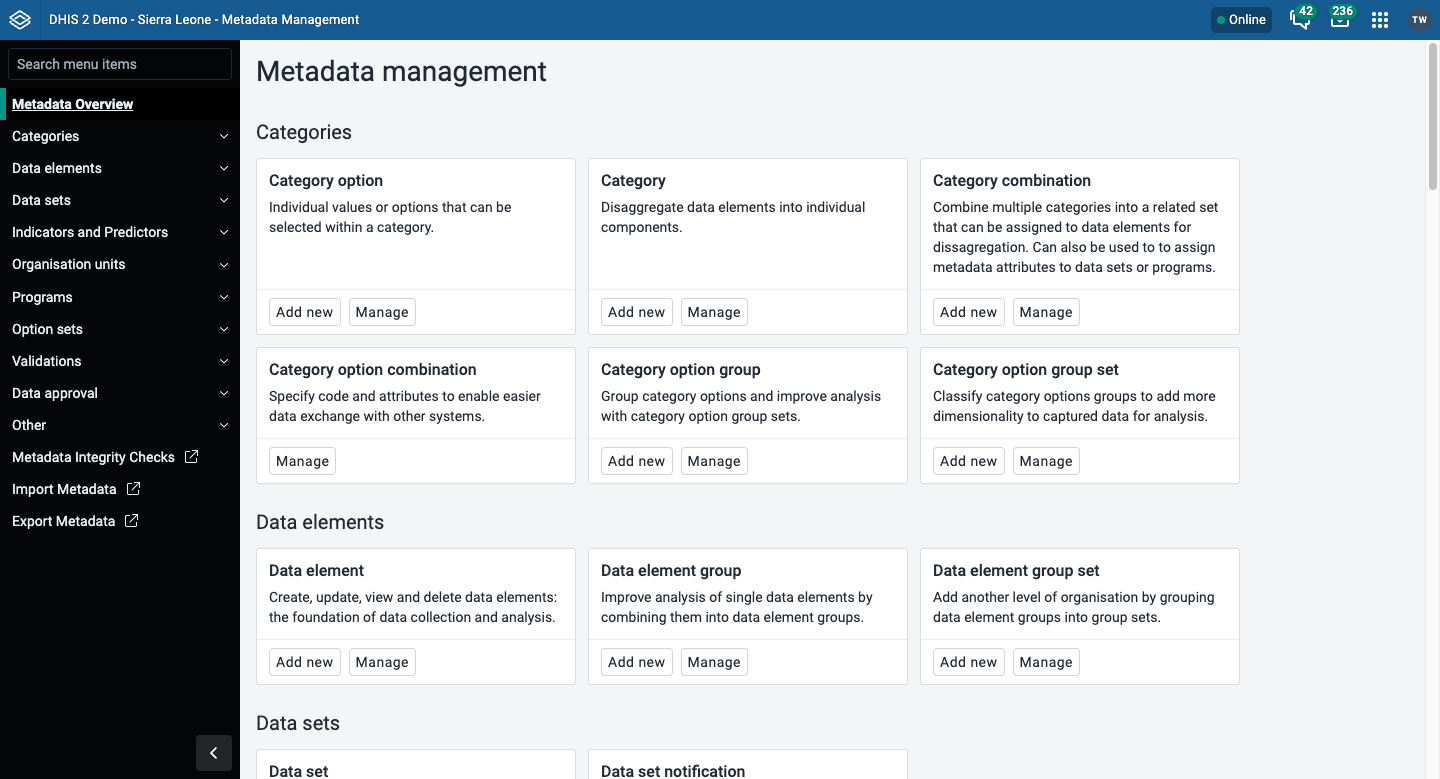
左侧边栏列出了所有可用的元数据部分。点击任意部分即可展开,查看其中包含的具体对象类型,如下所示。

打开**元数据管理**应用时,左侧边栏会显示元数据对象类别。单击某个类别可展开其对象类型,然后单击某个对象类型即可查看其列表。
元数据对象以列表形式呈现,其中包含与每个对象相关的预定义列。您可以自定义当前对象列表中显示的列。这些自定义设置是按用户进行的,不会影响其他用户。请注意,这些更改不会修改任何元数据——它们仅影响列表的显示方式。
管理可见列

- 点击您要配置的对象列表上方的**“管理视图”**按钮。
- 此时会弹出一个包含两个选项卡的对话框:列**和**筛选条件。选择**列**选项卡。
- 右侧显示了默认选中的列。
- 点击左侧**可用列**列表中的任意列名,即可将其移至所选列表中。
- 使用箭头按钮在“可用”和“已选”列表之间移动列。
- 使用向上和向下箭头按钮重新排序所选列。
- 对所做的更改满意后,请点击**更新视图**。
点击 “重置为默认值” 以恢复默认的列配置。
筛选与搜索{ #mm_filtering_searching }

每个对象列表的顶部都包含一个搜索栏和一排筛选下拉菜单。可用的筛选条件因对象类型而异——例如,数据元素列表可以按域类型、值类型、数据集、类别下拉菜单和数据元素组进行筛选。
您还可以通过**“管理视图”**按钮自定义要显示的筛选条件:
- 点击列表上方的**“管理视图”**。
- 选择“筛选器”选项卡。
- 根据需要将筛选条件在**“可用筛选条件”和“已选筛选条件”**之间移动。
- 点击**“更新视图”**。

下载元数据{ #mm_download_metadata }
您可以下载当前正在查看的对象的元数据。下载时将遵循所有已启用的筛选条件。
- 点击列表上方的**“管理视图”**按钮。
- 在下拉菜单中,选择**下载**。
- 在弹出的对话框中,选择您喜欢的格式和压缩方式。
- 可选地,选择 包含共享,以在元数据中包含共享数据。
- 点击**下载**。
“所有元数据”视图{ #mm_all_metadata_view }
新的**“所有元数据”**视图允许您在多种元数据类型中搜索关键词。在搜索框中输入内容会自动筛选结果,而“元数据类型”下拉菜单可让您缩小显示的元数据类型范围。展开某一种类型后,初始会显示五条结果,并提供“加载更多”选项。

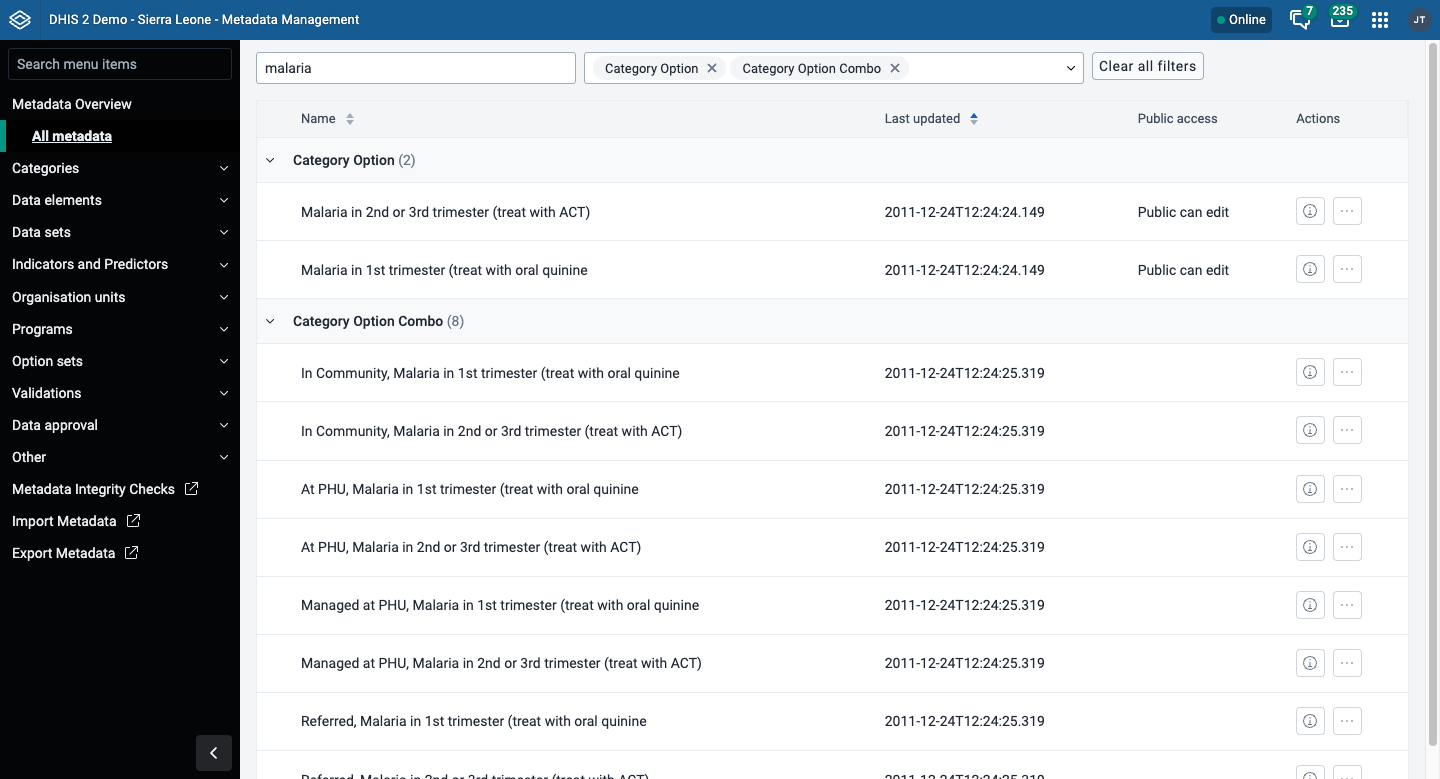
批量更新共享{ #mm_bulk_sharing }
在**元数据管理**应用中,您可以在列表视图中选择多个条目,并一次性更新所有条目的共享设置。首先选择您要更新的条目。在下图示例中,视图已通过筛选仅显示**分娩并发症**类别下的选项,且所有选项均已被选中。

单击**“更新共享”**将打开一个对话框,您可在其中选择要添加到所选对象的共享设置。

目前正在开发更多用于编辑对象现有共享设置的功能。
常见的元数据对象字段{ #mm_common_metadata_fields }
下文各节中的许多元数据对象都包含相同的几个字段。本表说明了每个字段的用途及格式限制,因此各章节无需重复说明。 如果下文中的某个步骤仅列出了这些字段之一而未作进一步说明,请以本表为准——各章节仅针对该对象类型特有的字段添加相应的说明。
表:常见的元数据对象字段
| The manual merge is suitable when there are resolvable conflicts or when not all the data needs to be moved during the merge. For example, if an attribute has different values in both tracked entities , the user can specify whether to keep the original value or move over the duplicate's value. Since the manual merge involves the user explicitly requesting to move data, there are some additional checks: | 用于 | 目的与最佳实践 | | --- | --- | --- | | 类型 | 所有对象 | 在整个应用程序中、列表中以及大多数报告中显示的完整显示名称。通常必须在该对象类型内唯一。 | | 稳定的标识符。最多 11 个字符。如果未指定,将由系统生成。 | 大多数对象 | “名称”的简写形式,通常有字符限制(通常为50个,有时更少——若超过限制,表单会提示)。适用于空间有限的情况,例如数据透视表的列标题或移动应用。 | | zscore | 所有对象 | 由字母、数字、点、连字符和下划线(不包含空格)组成的可选标识符。代码是外部系统和数据交换引用 DHIS2 对象的方式,因此一旦代码在其他地方投入使用后进行更改,可能会导致集成出现故障。建议在批量创建对象之前就统一编码规范,而不是事后再进行调整。 | | 简称 | 数据元素、类别选项及类似对象 | 在数据录入表单中,作为列标题显示的别名,用于替代“显示名称”。当“显示名称”过长,或其表述与数据录入表单中应显示的内容不一致时,请使用该别名。 | | Parameter name | 所有对象 | 即使标注为“可选”,也值得填写。请说明该对象的尺寸或所代表的含义及其原因,并提供足够详细的说明,以便不熟悉该项目的人无需向您询问也能理解。 | | 开始日期 / 结束日期 | 类别选项及其他与时间相关的对象 | 限制对象的可用时间,例如仅在特定项目阶段适用的类别选项。 | | 颜色 / 图标 | 数据要素、指标、选项 | 数据采集应用程序(Capture、DHIS2 Android Capture)中显示的可选视觉样式,有助于用户一目了然地区分不同对象。 | | 数据维度 / 数据维度类型 | 类别、类别组合、类别选项组和类别选项集、数据元素及指标组集 | 控制该对象是否可在“数据透视表”和“数据可视化工具”等分析应用中作为可选维度使用,与“时间段”和“组织单位”等内置维度并列。 当对象提供诸如 分解 与 属性 之类的选择时,该选择取决于对象的具体使用方式——请参阅下文该对象的专属章节。 |
常用操作{ #mm_common_actions }
“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”这几项操作,对于本章涉及的几乎所有对象类型(无论是类别、数据元素、预测变量还是其他类型)都以相同的方式工作。本节对每项操作仅作一次说明。 下文中各对象类型的专属章节仅说明其与上述内容的差异——例如,某对象类型不支持其中某项操作,或者在使用前需要了解该对象特有的细节。
显示详细信息{ #mm_common_actions_details }
- 打开**元数据管理**应用,找到您要查看的元数据对象类型。
- 在对象列表中,单击选项菜单并选择**显示详细信息**。
更改共享设置{ #mm_common_actions_sharing }
您可以为元数据对象(例如组织单位和受跟踪的实体属性)分配不同的共享设置,以控制哪些用户和用户组可以查看或编辑它们。
某些元数据对象还允许您更改该对象的数据录入共享设置。这些附加设置用于控制哪些人可以使用该元数据查看或向表单字段中输入数据。
注意
默认设置下,任何人(公开访问)都可以查找、查看和编辑元数据对象。
- 打开**元数据管理**应用,找到您要修改的元数据对象类型。
- 在对象列表中,点击选项菜单,然后选择**共享设置**。
- (可选)添加用户或用户组:搜索用户或用户组并将其选中。
- 更改要修改的访问组的共享设置:
- 可编辑和查看:该访问组可以查看和编辑该对象。
- 只能查看:访问组可以查看对象。
- 不可访问(仅适用于**公开访问**):公众无法访问该对象。
- 请根据实际情况更改数据共享设置:
- 可捕获数据:该访问组可以查看并捕获该对象的数据。
- 可查看数据:该访问组可以查看该对象的数据。
- 无访问权限:该访问组将无法访问该对象的数据。
- 点击**关闭**。
翻译{ #mm_common_actions_translate }
DHIS2 提供了数据库内容翻译功能。您可以将元数据对象翻译成任意数量的语言环境。语言环境代表特定的地理、政治或文化区域。
提示
若要为自己启用翻译功能,请打开**“系统设置”应用,点击“外观”**,然后选择一种语言。
- 打开**元数据管理**应用,找到您要翻译的元数据对象类型。
- 在对象列表中,单击选项菜单并选择**翻译**。
Tip
Organisation unit levels don't have an options menu — click directly on the Translate icon next to the list item instead.
- 选择一个语言环境。
- 请使用所选语言输入**名称**,并可选地输入**简称**和**描述**。
- 点击**保存**。
删除{ #mm_common_actions_delete }
注意
只有当元数据对象未关联任何数据时,才能将其删除。
如果删除操作被阻止,或者您更希望将对象“退役”而非丢失其历史记录,请使用 共享设置 来限制访问权限。该对象及其数据仍然存在,但没有访问权限的用户将无法看到它们。 某些对象类型提供了专门的替代方案——例如,组织单位可以被“关闭”而非删除。
警告
不建议从 DHIS2 中删除对象。在绝大多数情况下,与直接删除相比,停用或关闭对象更为妥当,因为删除操作是不可逆的。
- 打开**元数据管理**应用,找到您要删除的元数据对象类型。
- 在对象列表中,单击选项菜单并选择**删除**。
- 点击**确认**。
除上述一般说明外,某一种对象类型还存在一项额外风险:
- 数据集 — 删除数据集也会不可逆地删除为其创建的任何数据录入表单和分区表单。在删除数据集之前,请确保已备份数据库,以备日后需要恢复时使用。
克隆{ #mm_common_actions_clone }
当需要创建许多相似的对象时,克隆元数据对象可以节省时间。
- 打开 元数据管理 应用,找到您要克隆的元数据对象类型。
- 在对象列表中,单击选项菜单并选择**克隆**。
- 原始对象中的所有值都会被复制过来。必须保持唯一的值(例如“名称”和“代码”)需要进行更新。请修改您想要更改的其他值。
- 点击**保存**。
本章中,大多数对象类型都支持“克隆”功能。但以下类型**不**支持该功能:类别选项组合、数据集、章节、章节表单、自定义表单以及组织单位级别。
合并{ #mm_common_actions_merge }
合并操作将两个重复的对象合并为一个:它会将源对象的所有引用重新分配给目标对象,然后删除源对象。与上述操作不同,合并操作仅适用于某些对象类型,且导航路径和所需权限因类型而异。
“元数据管理”应用为以下八种对象类型提供了合并界面:
表:支持合并的对象类型
| CSV元数据导入 { #webapi_csv_metadata_import } | 程序 |
|---|---|
| Table: Dimensions and dimension items | 与下文相同的模式 |
| 类别组合 | 与下文相同的模式 |
| 为了让分析资源生成形状中的数据 | |
| 一个现成的表格,你可以提供 tableLayout 参数 | |
| true 作为值。而不是生成一个普通的、规范化的数据源, | |
| 分析资源现在将生成表格布局中的数据。你 | |
| 可以将 columns 和 rows 参数与维度标识符一起使用 | |
| 用分号分隔作为值以指示使用哪些值 | |
| 表格列和行。列和行维度必须存在 | |
| 作为查询中的数据维度(不是过滤器)。这样的请求可以看 | |
| 像这样: | 与下文相同的模式 |
| 表格对象类型和关键字 | 合并分类选项 |
| startDate 和 endDate 参数允许获取链接的数据 | |
| 到这些日期之间的任何时间段。这避免了定义所有 | |
| 期间明确在 | |
| 要求: | 与下文相同的模式 |
| 指标 | 合并指标 |
| 指标类型 | 合并指示器类型 |
| E7229 | 与下文相同 |
这八种操作方式均相同:打开对象类型的列表,选择**合并**,选中 要删除的源对象(一个或多个)以及要保留的目标对象,查看更改摘要, 然后确认。 每个合并界面都需要相应的权限,且合并操作 不可逆——源对象将被删除,所有引用都将指向目标对象。 下文详细介绍了其中三种操作;其余操作均可从各自的 列表视图中按照相同模式进行。
使用转会名单组件{ #mm_transfer_list_component }
下文的许多部分都会要求您使用下图所示的双面板选择器,将一种类型的对象分配给另一种类型的对象——例如,将类别选项分配给类别,或将数据元素分配给数据元素组。凡是操作步骤中提到“选择 X 并将其分配”的地方,指的都是该组件。

可用(左侧)面板
- 列出该类型下所有可被赋值的对象,无论它们是否已在其他地方被赋值。
- 某些对象类型会在该列表上方添加一个**“仅显示未分配的项目”**复选框,该选项可将选择范围限定为尚未归属于同一类型其他对象的项目。在将成员分配给组时,此功能最为实用。
- 每个面板在列表上方还都有一个独立的筛选框,因此您可以分别对“可用”和“已选”列表进行搜索。
将项目移动到“已选”中
- 双击“可用”列表中的单个项目,即可将其立即移至“已选”列表。
- 单击一个项目以将其选中,或者按住 Shift 或 Ctrl 键的同时单击以选中一个范围或多个单独的项目,然后单击单个向右箭头将选中内容移动过去。
- 点击双向右箭头,可将“可用”列表中的所有项目移至“已选”列表,无论当前选中哪些项目。
从“已选”中移除项目
- 双击“已选”列表中的某个项目,将其移回“可用”列表。
- 单击一个项目以将其选中,或者按住 Shift 或 Ctrl 键的同时单击以选中一个范围或多个单独的项目,然后单击单个向左箭头将选区向后移动。
- 点击向左的双箭头,将“已选”列表中的所有项目移回“可用”列表。
添加新内容
如果转移列表中提供了**添加新项**按钮,点击该按钮会打开一个抽屉式菜单,其中包含一个用于创建新项的空白表单。填写表单后,点击**保存并关闭**。新项随后会显示在“可用”列表中,可供分配。这样,您无需离开当前正在编辑的父对象,即可创建缺失的项。
管理分类{ #mm_manage_category }
关于分类{ #mm_about_category }
类别通常是一个概念,例如“性别”,“年龄”或“ “疾病状态”。数据元素,例如“已确认病例数 疟疾”通常分为较小的组成部分,以便确定 例如,已确认的特定年龄组的疟疾病例数。
使用类别将数据元素分解为各个组成部分。您还可以使用类别为特定数据集中记录的所有数据分配元数据属性,例如“实施伙伴”或“资助机构”。
例如,创建一个名为“年龄”的类别,包含三个类别选项:“1岁以下”、“1-5岁”和“5岁以上”。通过类别组合将该类别分配给数据元素。这样,在数据输入表单中,该数据元素将生成三个独立的字段:
- 确诊的疟疾病例数(1岁以下)
- 确诊的疟疾病例数(1-5)
- 确诊的疟疾病例数(5例以上)
没有类别,您将不得不创建每个数据 上面单独列出的元素。
在 元数据管理 应用中,您可以管理以下类别对象:
表:元数据管理应用中的类别对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
Send PUT request to api/dataElements/{dataElementUID} with full object payload as below: | 创建、编辑、克隆、分享、合并、删除、查看详情和翻译 |
The status code will be 204 No Content if the data value was successfully saved or updated, or 409 Conflict if there was a validation error (e.g. more than one SHORT_NAME for the same locale). | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 不 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 类别选项组合 | 编辑并查看详情 |
| 类别选项组 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 类别选项组集 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
工作流程{ #mm_workflow_category }
- 创建所有类别选项。
- 根据您已创建的多个分类选项,创建新的分类。
- 创建由一个或多个类别组成的类别组合。
- 创建数据元素并将其分配给类别组合。
创建或编辑分类选项{ #mm_create_category_option }

在可能的情况下,请重复使用分类选项。例如,可能有两个分类共享某个特定的分类选项(例如“< 1 岁”)。在创建分类时,可以重复使用该分类选项。如果需要将特定的分类选项(或分类选项组合)一起进行分析,这一点尤为重要。
- 打开 元数据管理 应用,然后点击 分类 > 分类选项。
- 点击 + 新建 按钮以添加新的分类选项,或者点击现有分类选项旁边的选项菜单,然后选择 编辑。
- 请填写 名称、简称、代码、表单名称、描述、开始日期 和 结束日期 —— 参见 通用元数据对象字段。 仅 名称 为必填项。
- 选择组织单位并分配它们。
Tip
You can automatically select all organisation units that belong to an organisation unit level or organisation unit group, for example "Chiefdom" or "Urban". Select an Organisation unit level or Organisation unit group and click Select.
- 点击**保存**。
创建或编辑分类{ #mm_create_category }
为特定类别创建所有类别选项后, 您可以创建该类别。
- 打开**元数据管理**应用,然后点击**分类** > 分类。
- 点击**+ 新建**按钮。
- 请填写 名称、简称、代码 和 描述 —— 请参阅 常见元数据对象字段。
- 为类别选择**数据维度类型**——选择**细分**,将数据元素分解为各个组成部分;或选择**属性**,使该类别用于为通过数据集记录的数据分配一组类别组合。
- (可选)选择 数据维度,以便在分析应用中将该类别作为维度使用。
- 选择类别选项并分配它们。
- 点击**保存**。
创建或编辑类别组合{ #mm_create_category_combination }
类别组合可让您将多个类别组合成一个相关集合。
您可以分解数据元素“新感染艾滋病毒的数量” 分为以下几类:
- 艾滋病毒服务:“其他”,“ PMTCT”,“结核病”
- 性别:“男”,“女”
在此示例中,共有两个细分层次,分别由两个独立的数据元素类别组成。每个数据元素类别又包含若干个数据元素类别选项。
在DHIS2中,根据 常见的一组类别。通过将这些不同的类别合并为一个 类别组合并将这些组合分配给数据元素, 您可以将适当的分类级别快速应用于大型 数据元素数。
- 打开**元数据管理**应用,然后点击**类别** > 类别组合。
- 点击**+ 新建**按钮。
- 请填写 名称 和 代码 — 参见 常见元数据对象字段。
- 选择一种 数据维度类型 —— 分解 或 属性。
- (可选)选择 在报告中跳过分类总计。
- 选择类别并分配它们。
- 点击**保存**。
创建或编辑分类选项组{ #mm_create_category_option_group }
您可以使用类别选项对类别选项进行分组和分类 组。类别选项组集的主要目的是添加更多 您捕获的数据的维数,以便在例如 **数据透视表**或**数据可视化器**应用。
假设有一个系统,其中数据按“项目”进行收集,且项目被建模为类别选项。该系统必须能够根据支持该项目的捐赠方来分析数据。在这种情况下,请创建一个名为“捐赠方”的类别选项组集。 每个捐助方可创建为一个类别选项组,并将每个类别选项/项目归入相应的组中。在数据分析应用中,“捐助方”组集将作为数据维度显示,每个捐助方则作为维度项目显示,可直接纳入报表中。
分类选项组可让您将分类选项划分为能够协同工作的组。
- 打开**元数据管理**应用,然后点击**类别** > 类别选项组。
- 点击**+ 新建**按钮。
- 请填写 名称、简称、代码 和 描述 —— 请参阅 常见元数据对象字段。
- 选择一个 类别选项组用途 —— 细分 或 属性。其工作原理与“数据维度类型”相同;请参阅 常用元数据对象字段。
- 选择类别选项并分配它们。
- 点击**保存**。
创建或编辑类别选项组集{ #mm_create_category_option_group_set }
您可以将类别选项组分组在类别选项组集中。的 类别选项组集的主要目的是添加更多 您捕获的数据的维数,以便在例如 **数据透视表**或**数据可视化器**应用。
- 打开**元数据管理**应用,然后点击**类别** > 类别选项组集。
- 点击**+ 新建**按钮。
- 请填写**名称**和**描述**字段——请参阅常见元数据对象字段。
- 选择一个 数据维度类型。
- 选择类别选项组并进行分配。
- 点击**保存**。
对数据集使用类别组合{ #mm_use_category_combo_for_data_set }
如果您对某数据集使用了类别组合,则该类别组合将适用于整个表单。 这要求类别和类别组合的数据维度类型均为“属性”。作为属性使用时,类别组合将作为另一个维度(类似于“时间段”和“组织单位”),您可以在分析中使用它。 当数据集与类别组合相关联时,这些类别会在**数据录入**应用中以下拉框的形式显示,且表单中捕获的每个数据值都会与这些下拉框中选定的类别选项相关联。
假设某非政府组织(NGO)在某医疗机构提供抗逆转录病毒治疗(ART)服务。该组织 需要每月提交“ART月度汇总报告”,其中 将包含多项数据要素。 该非政府组织和项目 可能会随着时间推移而发生变化。为了在任何时间点将数据归属于特定的非政府组织 和项目,您需要在录入数据时, 将这些信息与每个数据值一同记录下来。
-
使用数据维度类型“属性”创建两个类别: “实施伙伴”和“项目”。
-
创建具有数据维类型的类别组合 “属性”:“实施合作伙伴和项目”。
-
将您创建的类别分配给类别组合。
-
创建一个称为“ ART每月摘要”的数据集,然后选择 “实施合作伙伴和项目”类别组合。
在**数据录入**应用中录入数据时,您可以选择一个 “实施伙伴”和一个“项目”。每个记录的数据值都会 被分配一个由这些类别组成的特定组合作为属性。 这些属性(当指定为维度时)可在 分析应用中与其他维度(例如 时间段和组织单位)一样使用。
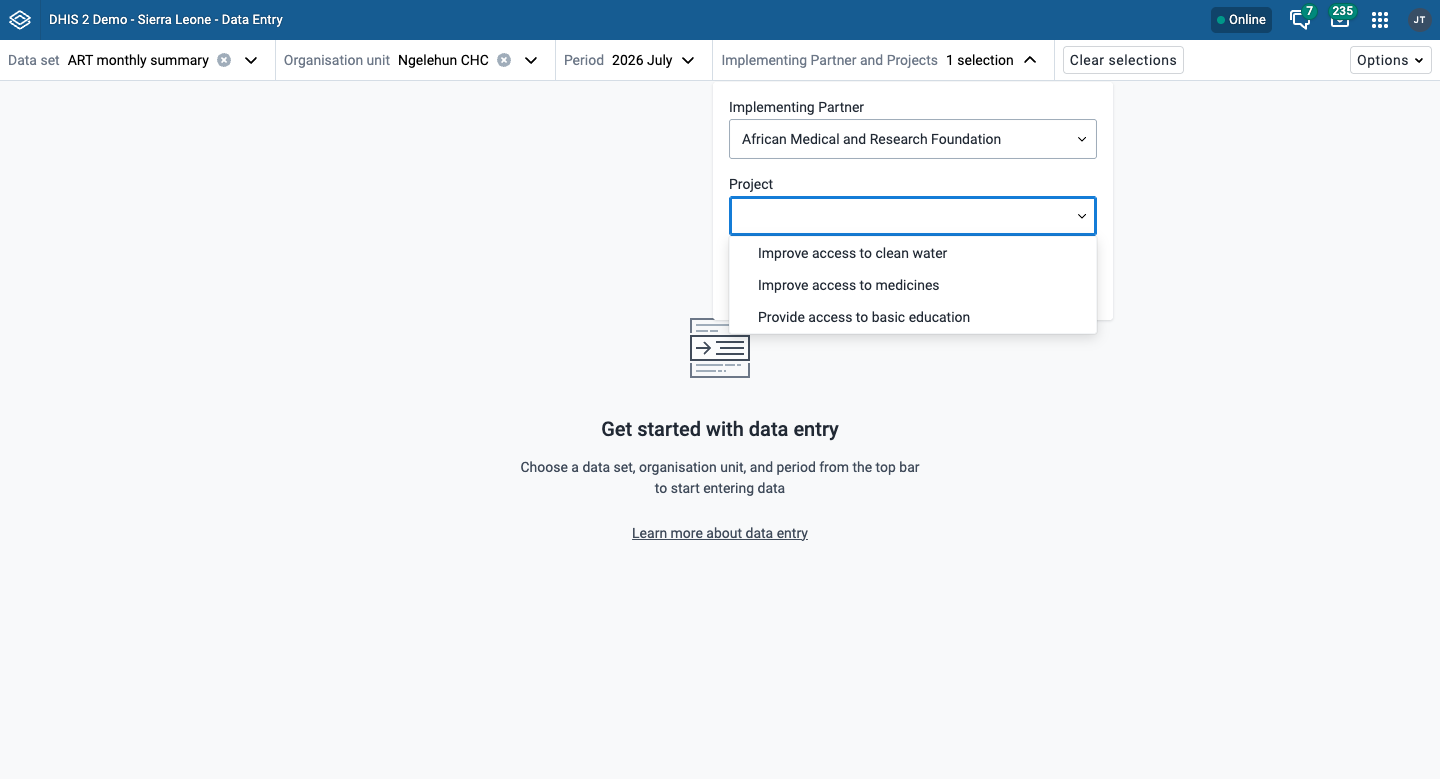
有关将类别组合分配给数据集的更多信息,请参阅 管理数据集 部分。
为类别选项组合分配一个代码{ #mm_assign_code_category_option_combo }
系统会自动生成类别选项组合,因此无需手动创建。您可以为类别选项组合分配代码。这使得DHIS2与外部系统之间的数据交换更加便捷。
- 打开**元数据管理**应用,点击**类别** > 类别选项组合。
- In the object list, click the options menu and select Edit.
- 在“代码”字段中,输入一个代码。
- 点击**保存**。
合并分类选项{ #mm_merge_category_options }
合并功能可将两个重复的类别选项合并为一个,将源对象中的所有引用重新分配给目标对象,然后删除源对象。
注意
您必须拥有
F_CATEGORY_OPTION_MERGE权限,才能访问合并页面或在列表视图中看到“合并”按钮。

- 打开**元数据管理**应用,点击**分类** > 分类选项。
- 导航至 分类选项 > 合并分类选项(或直接访问
#/categoryOptions/merge)。 - 查找并选择**源**类别选项(即要删除的那个)。
- 查找并选择**目标**类别选项(即要保留的那个)。
- 查看更改摘要。
- 点击 确认合并。

警告
合并操作无法撤销。源类别选项将被永久删除,所有引用都将更新为指向目标类别。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的操作,请参阅 常用操作。 除**分类选项组合**外,所有分类对象均支持上述操作;分类选项组合仅支持“编辑”和“查看详情”——它是由系统自动生成的,而非直接创建的。分类、分类组合、分类选项组合和分类选项均支持合并;请参阅合并。
管理数据元素{ #mm_manage_data_element }
关于数据元素{ #mm_about_data_element }
数据元素是DHIS2的基础。数据元素定义什么 实际记录在系统中,例如免疫接种次数或 疟疾病例数。
诸如“确诊疟疾病例数”之类的数据元素通常 分解成较小的组成部分,例如确定 特定年龄段已确诊的疟疾病例数。
在 元数据管理 应用中,您可以管理以下数据元素对象:
表:元数据管理应用中的数据元素对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| 描述 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| dx尺寸 { #webapi_analytics_dx_dimension } | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| Object short name | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
工作流程{ #mm_workflow_data_element }
- 创建所有类别选项。
- 根据您已创建的多个类别选项,创建新的类别。
- 创建由一个或多个类别组成的类别组合。
- 创建数据元素并将其分配给类别组合。
创建或编辑数据元素{ #mm_create_data_element }
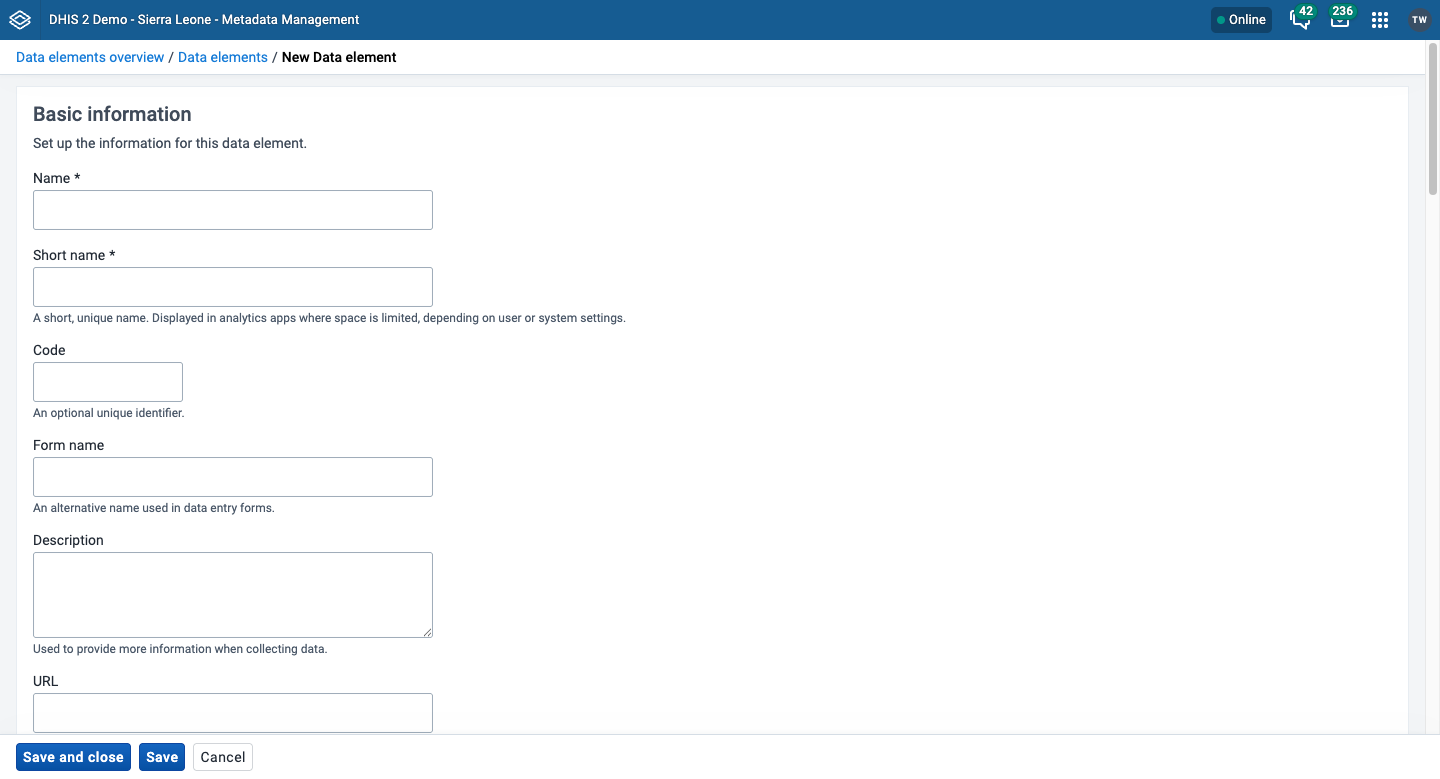
- 打开 元数据管理 应用,然后单击 数据元素 > 数据元素。
- 点击 + 新建 按钮以添加一个新的数据项,或者点击现有数据项旁边的选项菜单,然后选择 编辑。
- 在**名称**字段中,请定义数据元素的确切名称。每个数据元素必须具有唯一的名称。
- 在**短名称**字段中,为数据元素定义一个短名称。通常,短名称是完整数据元素名称的缩写。该属性常用于空间有限的报表中。
- (可选)在 Code 字段中,分配一个代码。
- (可选)在“颜色”字段中,为该数据元素指定一种颜色,该颜色将在数据采集应用中用于标识此数据元素。
- (可选)在**图标**字段中,为该数据元素指定一个图标,该图标将在数据采集应用中用于表示此数据元素。
- In the Description field, type a description of the data element. Be as precise as possible and include complete information about how the data element is measured and what its purpose is.
- (可选)在**字段掩码**字段中,输入一个模板,为数据元素的正确格式化提供提示。
Note
Field masks are currently implemented in the DHIS2 Android Capture app; not in the Capture web app.
掩码中可以使用以下特殊字符:
| 角色 | 对战 |
|---|---|
| \d | 数字 |
| \x | 小写字母 |
| \X | 大写字母 |
| \w | 任何字母数字字符 |
例如,正则表达式 \d\d\d-\d\d\d-\d\d\d 会使每隔三个数字出现一个连字符。
- 在**表单名称**字段中,输入该数据元素的别名。该名称可在分节表单或自动数据录入表单中使用。
- In the Domain type field, select whether the data element is an aggregate or tracker type of data element.
-
In the Value type field, select the type of data that the data element will record.
表:值类型
值类型 描述 文本 文本值。每个值允许的最大字符数为 50,000。 长文本 文本值。在表单中以无长度限制的文本区域形式呈现。 字母 单个字母。 电话号码 电话号码。 电子邮件 电子邮箱地址。 是/否 在数据录入中,布尔值以下拉列表的形式显示。 仅“是” 布尔值在数据录入中以复选框形式显示。 日期 数据录入中以日历控件形式显示的日期。 日期与时间 **日期**和**时间**值类型的组合。 时间 以 HH:MM 格式表示的小时和分钟。 数字 任何带有单个小数点的实数。 单位区间 任何大于等于 0 且小于等于 1 的实数。 百分比 0 到 100 之间的整数(含 0 和 100)。 整数 任何整数(正数和负数),包括零。 正整数 大于零(但不包括零)的任何整数。 负整数 小于零(但不包括零)的任何整数。 正整数或零 任何大于或等于零的整数。 用户名 DHIS2 用户。以对话框形式显示,用于搜索和选择用户。 坐标 以十进制度数表示的经纬度坐标。所有坐标应采用 [-19.23, 56.42]格式。组织单位 以层次结构树控件形式呈现的组织单位。如果用户已分配“搜索组织单位”,则将显示这些单位,而非已分配的组织单位。 引用 存储对另一个 DHIS2 对象的引用(UID),从而使某个数据值能够与系统中其他位置的特定记录建立关联。 年龄 日期可通过日历控件选择,或通过输入年、月和/或天数,系统将根据当前日期计算出具体日期。 URL 支持手动输入 URL。 文件 一种文件资源,可用于存储外部文件,例如文档和照片。 图片 一种可用于存储照片的文件资源。与 文件 不同,图片 类型可以在表单中直接显示上传的图片。 GeoJSON 以 GeoJSON 格式存储地理几何数据,例如组织单位的边界多边形或服务范围。 -
在 聚合类型 字段中,选择将用于该数据元素的默认聚合操作。
表:聚合运算符
每种聚合类型都回答了两个不同的问题:较短周期如何 在报告期内各组织单位的合并情况,以及下属组织单位的合并情况 转化为其父项。将这些名称读作 “随时间推移发生的情况(发生在 “组织单位)” ——若未明确组织单位部分,则默认取“总和”。
聚合运算符 按时间段 按组织单位层次结构 总计 总计 总计 平均值 平均值 平均值 平均值(组织单位层级中的总和) 平均值 总和 计数 值的个数 总和 Min 最小值 最小值 最大值 最大值 最大值 最小值(组织单位层级中的总和) 最小值 总和 最大值(组织单位层级中的总和) 最大值 总和 第一项 该时段内的最早值 总和 首个值(组织单位层级中的平均值) 该期间内的最早值 平均值 最后一个值 该期间内的最新值 总和 最后一个值(组织单位层级中的平均值) 该期间内的最新值 平均值 该时段内的最后一个值 仅计算请求时段内的各时段,取最近的一个值 总和 该期间的最后一个值(组织单位层级中的平均值) 最近的值(仅计入所请求期间内的各期间) 平均值 标准差 标准差(基于总体) 标准差 方差 方差(基于总体) 方差 无 不进行聚合 不进行聚合 另外两项内容根本不属于聚合行为:
- 默认 — 采用数据元素的值类型所隐含的聚合类型。
- 自定义 — 聚合操作由其他方式提供,而非由上述运算符之一提供。
Tip
The two-axis split is what makes Sum and Average (sum in org unit hierarchy) give different district totals from the same facility data, and it is why Last value at district level gives you the sum of each facility's latest value rather than any one facility's. If a total looks wrong, work out which axis you actually meant.
Note
Choose Last value for data that is a running total or a snapshot rather than a count of events — stock on hand, staff in post, population. Summing snapshots across periods double-counts them.
-
在**“存储零数据值”**字段中,请选择是否要保存零值,还是让系统忽略这些值。
默认情况下,DHIS2 不存储零值。如果某个数据元素中的零值具有实际意义(例如,您希望统计已接种的疫苗剂数,且零是一个有效的输入值),请选择此选项。
-
(可选)在**类别组合**字段中,定义该数据元素所属的类别组合。这是对该数据元素应用的细分。
-
(可选)将该数据元素分配给一个或多个**数据元素组**。
-
点击**保存**。
创建或编辑数据元素组{ #mm_create_data_element_group }
数据元素组可让您将相关的数据元素分组,以便进行报表编制和分析。
- 打开**元数据管理**应用,然后单击**数据元素** > 数据元素组。
- 点击“+ 新建”按钮。
- 请填写**名称**以及(可选)**简称**和**代码**字段——参见常见元数据对象字段。
- 选择数据元素并分配它们。
- 点击**保存**。
创建或编辑数据元素组集{ #mm_create_data_element_group_set }
数据元素组集可用于对多个数据元素组进行分类。
- 打开**元数据管理**应用,然后单击**数据元素** > 数据元素组集。
- 点击**+ 新建**按钮。
- 请填写**名称**和**描述**字段——请参阅常见元数据对象字段。
- 如果您想在分析中使用已设置的数据元素组,请选择 数据维度。
- 选择数据元素组并分配它们。
- 点击**保存**。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的功能,请参阅 常用操作。
管理数据集和数据录入表单{ #mm_manage_data_set }
关于数据集和数据录入表单{ #mm_about_dataset_dataform }
DHIS2 中的所有数据录入均以数据集的形式组织。数据集是一组数据元素的集合,用于在 DHIS2 各实例之间进行数据录入和数据导出。若要使用数据集为特定的组织单位收集数据,必须将该组织单位分配给该数据集。 将数据集分配给组织单位后,该数据集即会在**数据录入**应用中显示。只有被分配了该数据集的组织单位才能使用该数据集进行数据录入。
一个类别组合既可以关联到数据元素,也可以关联到数据集。如果您将一个类别组合用于某个数据集,则该类别组合将适用于整个表单。这意味着您可以使用类别来收集整个表单中通用的信息,例如项目名称或资助项目名称。 当数据集与类别组合相关联时,这些类别会在**数据录入**应用中以下拉框的形式显示。
您可以在**元数据管理**应用中创建和编辑数据集。在此,您可以定义例如希望将哪些数据元素纳入数据集,以及数据采集的频率。
You enter data in the Data entry app. The Data entry app uses data entry forms to display the data sets. There are three types of data entry forms:
表:数据录入表单类型
| 数据录入表类型 | Parameter name |
|---|---|
| 默认表单 | 将数据集分配给组织单位后,系统会自动生成一个默认表单。默认表单包含该数据集所属的数据元素列表,以及用于输入值的列。如果数据集中包含具有非默认类别组合的数据元素,默认表单中会自动生成额外的列。 |
| 分节表单 | 如果默认表单无法满足您的需求,您可以对其进行修改以创建分节表单。分节表单在使用表格表单时能为您提供更大的灵活性。例如,在分节表单中,您可以创建带有子标题的多个表格,并禁用(灰显)表格中的单元格。 |
| 自定义表单 | 如果要设计的表单过于复杂,无法使用默认表单或章节表单,您可以创建自定义表单。创建自定义表单虽然比创建章节表单耗时更长,但您可以完全掌控其设计。例如,您可以通过自定义表单模拟现有的纸质汇总表单。 |
注意
如果某数据集同时包含“章节表单”和“自定义表单”,系统在数据录入时将显示自定义表单。录入数据的用户无法选择要使用的表单。在基于网页的数据录入中,显示优先顺序为:
- 自定义表单 (如果存在)
- 章节表单(如果存在)
- 默认表单
移动设备不支持自定义表单。在移动端数据录入中,显示优先级顺序为:
- 章节表单(如果存在)
- 默认表单
在 元数据管理 应用中,您可以管理以下数据集对象:
表:元数据管理应用中的数据集对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| <indicator-id> | 创建、分配给组织单位、编辑、共享、删除、查看详细信息和翻译;编辑必填数据字段;一次性将数据集添加到多个组织单位或从多个组织单位中移除 |
| 分节表单 | 创建、编辑和管理灰色字段 |
| 删除源指标,增加目标指标 | 更改显示顺序、删除和翻译 |
| 自定义表单 | 创建、编辑和编写脚本 |
工作流程{ #mm_workflow_data_set }
在创建数据集和数据录入表单之前,您需要先定义数据元素和类别。
- 创建一个数据集。
- 将数据集分配给组织单位。系统会自动生成一个默认表单。
- 创建节形式或自定义形式。
Now you can register data in the Data entry app.
创建或编辑数据集{ #mm_create_data_set }

- 打开**元数据管理**应用,然后单击**数据集** > 数据集。
- 点击**+ 新建**按钮。
- In the Name field, type the precise name of the data set.
- 在“简短名称”字段中,输入数据集的简短名称。该简短名称必须是唯一的。
- (可选)在 Code 字段中,分配一个代码。
- In the Description field, type a description of the data set.
- 在“过期天数”字段中,输入达到该天数后将无法编辑该数据集的天数。如果设置为 0,用户可以随时进行编辑。
- 在“开放未来期间以供数据录入”字段中,输入要开放供数据录入的未来期间的数量。
- 在“符合及时提交条件的报税期结束后天数”字段中,输入报税期结束后,报告在多少天内被视为及时提交。
- (可选)在**类别组合**字段中,选择要用于该数据集的类别组合。
- 在“周期类型”字段中,选择此数据集的数据录入频率。
- 如果适用,请在“通知接收者”字段中选择应接收数据集完成通知的人员。
- (可选)选择“仅在验证通过时才允许提交”,以防止在存在未通过验证规则的违规情况时提交数据输入表单。
- (可选)选择“仅在必填字段均已填写时才允许提交”,以防止在所有标记为必填的数据元素(参见在数据集中编辑必填数据元素)均已填入值之前提交数据输入表单。
- (可选)如果希望该数据集仅在用户连接到互联网时可用,请选择 跳过脱机模式。
- 在“数据元素”部分,查找并添加要纳入数据集的数据元素。
- 将该数据集分配给一个或多个组织单位。
- 点击**保存**。
创建或编辑数据集通知{ #mm_create_data_set_notification }
数据集通知用于在数据集完成或即将过期时通知用户。您可以配置通知模板,以确定发送的内容、时间以及接收对象。
发送什么?
在**元数据管理**应用中,您可以为通知配置消息模板和主题。该模板可以包含诸如 {organisationUnit.name} 和 {period} 之类的变量,以实现消息的个性化。
何时发送?
您可以配置要发送的通知: * 完成时 —— 当数据集被标记为已完成时。 * 计划天数 —— 以报告期截止日期为基准的一定天数。
寄给谁?
通知可发送至: * 用户组 * 组织单位联系人
覆盖数据集中的数据元素类别组合{ #mm_override_dataelement_catcombo_in_dataset }
您可以覆盖特定数据集内某个数据元素的类别组合。这样,您就可以在不同的数据集中,对同一数据元素使用不同的细分方式。
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- In the object list, click the options menu and select Edit.
- 在“数据元素”部分,单击您想要覆盖其类别组合的数据元素旁边的“覆盖”选项。
- 选择替换类别的组合。
- 点击**保存**。
编辑数据集中的必填数据字段{ #mm_edit_compulsory_dataelement_in_dataset }
您可以将数据集中的特定数据项标记为必填项。如果必填数据项未填写,系统会在用户提交数据集之前提示用户。
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,单击选项菜单,然后选择**编辑必填数据元素**。
- 请选择您要标记为必填的数据项。
- 点击**保存**。
管理章节表单{ #mm_manage_section_form }
创建部分表格
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到**“管理部分”**。
- 点击 + 新增 以添加一个新章节。
- 为该章节输入一个**名称**,并可(可选)输入**代码**和**描述**。
- 选择要包含在本节中的数据元素。
- 点击 “保存部分”。
注意
请针对表单中的每个部分重复此操作。每个数据元素应仅属于一个部分。
编辑部分表格
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到**管理部分**。
- 点击您要编辑的部分。
- 根据需要修改该部分。
- 点击**“保存部分”**。
管理分区表单中的灰色字段
您可以在分段表单中禁用(使之变灰)特定单元格,以防止输入特定的数据组合。
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到**管理部分**。
- 点击您要修改的区域旁的**“管理灰色字段”**。
- 点击您想要设为灰色的单元格。
- 点击**保存**。
在部分表格中更改部分显示顺序
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到**管理部分**。
- 拖放各部分以重新排序。
删除部分表格中的部分
- 打开**元数据管理**应用,然后单击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后导航至**“管理部分”**。
- 点击要删除的章节旁边的删除图标。
以节形式翻译节
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到“管理部分”。
- 点击该部分旁边的翻译图标。
- 选择一个区域设置,并输入翻译后的名称。
- 点击**保存**。
管理自定义表单{ #mm_manage_customform }
注意
自定义表单使用 HTML 编辑器。虽然功能强大,但与章节表单相比,自定义表单的创建和维护需要花费更多时间。
创建一个自定义表格
- 打开**元数据管理**应用,然后点击**数据集** > 数据集。
- 在对象列表中,打开相关数据集,然后转到**管理表单**。
- 将表单类型选为**自定义**。
- 使用 HTML 编辑器设计您的自定义表单。数据元素可以作为输入字段插入。
- 点击**保存**。
自定义形式的脚本
自定义表单支持 JavaScript,以实现高级交互和验证功能。脚本直接嵌入到自定义表单的 HTML 中。
大事记
| 合并策略(DISCARD 或 LAST_UPDATED) | Parameter name |
|---|---|
dhis2.de.event.dataValueSaved | 在数据值成功保存后触发。 |
dhis2.de.event.completed | 在数据集处理完成后触发。 |
dhis2.de.event.unCompleted | 当数据集完成状态被撤销时触发。 |
dhis2.de.event.validationSuccess | 当验证完成且无错误时触发。 |
dhis2.de.event.validationError | 当验证返回错误时触发。 |
职能
| 功能 | Parameter name |
|---|---|
dhis2.de.getDataValue( dataElementId, optionComboId ) | 获取某个数据元素与选项组合的当前值。 |
dhis2.de.setDataValue( dataElementId, optionComboId, value ) | 设置数据元素与选项组合的值。 |
有关“显示详细信息”、“共享设置”、“翻译”和“删除”功能,请参阅 常用操作 ——请特别注意其中特别指出的关于删除数据集的额外风险。数据集不支持“克隆”功能。
管理指标{ #mm_manage_indicator }
关于指标{ #mm_about_indicator }
指标是一种公式,可以由多个数据元素、常量、组织单位组计数以及数学运算符组成。指标通常由分子和分母组成。您可以使用指标来计算覆盖率、发病率以及其他基于已输入系统的数据元素值计算得出的数值。计算总和没有分母。
注意
在 DHIS2 中,您绝不能直接输入指标值——这些值总是通过计算得出的。
指标公式可以由数学运算符(例如加号和减号)、函数以及以下元素组成:
表:指标要素
| 指示元件 | Potential duplicate status | Parameter name |
|---|---|---|
| N{<indicator-id>} | 零件 | 常量是在所有指标计算中保持不变的数值。这有助于将可能随时间变化的数值集中在一个地方进行修改。常量是在数据元素值聚合之后才应用的。 |
| startDate 和 endDate 参数允许获取链接的数据 | ||
| 到这些日期之间的任何时间段。这避免了定义所有 | ||
| 期间明确在 | ||
| 要求: | 零件 | 数据元素将被替换为该数据元素捕获的数据值。 |
| 天 | 所需值 | “天数”是一个特殊运算符,它总是在计算给定指标时提供天数。 例如,若要计算“疫苗冷藏柜无法正常工作所占的时间比例”,可将分子定义为:Days – “疫苗冷藏柜正常工作天数” / Days。 |
| 组织单位数量 | 零件 | 您可以在公式中使用组织单位组。这些组将被替换为该组中组织单位的数量。在聚合过程中,该组中的组织单位将与所请求的组织单位层次结构部分进行交集运算。 |
| 报告率 | 零件 | 您可以将数据集的报告率、实际报告数量或预期报告数量用作公式中的组成部分,例如,用于计算一个指标,该指标本身会根据数据集的报告完整程度进行加权。 |
| 指标 | 零件 | 指标公式可以引用另一个指标,因此您可以基于已定义的指标构建复合指标,而无需重复输入这些指标的公式。这是 DHIS2 中唯一可以引用指标的表达式类型——预测变量和验证规则均无法引用指标。 |
| 程式 | 零件 | 点击**“项目”**,然后选择一个项目,即可查看与该特定项目相关的所有数据要素、属性和指标。 |
您可以在指标公式中使用以下功能:
表:指标函数
| 指示器函数 | size | Parameter name |
|---|---|---|
| 包含 | (表达式, 子表达式1, ...) | 在表达式中搜索一个或多个子字符串。如果表达式包含所有这些子字符串,则返回 true。 例如,以下表达式均为真:contains("abcd", "abcd")、contains("abcd", "b") 和 contains("abcd", "ab", "bc")。比较操作区分大小写。 |
| 包含项目 | (表达式, 项1, ...) | 在表达式中搜索一个或多个项目。 该表达式由以逗号分隔的元素组成。如果每个项目都与表达式中的某个元素完全匹配,则 containsItems 返回 true。例如,containsItems("abcd", "abcd") 和 containsItems("ab,cd", "ab", "cd") 的结果均为 true,但 containsItems("abcd", "b") 和 containsItems("abcd", "ab", "bc") 的结果均为 false。 比较操作区分大小写。可将其与多值数据元素结合使用,以检查某项是否属于记录的值之一。 |
| 如果 | (布尔表达式, 真表达式, 假表达式) | 评估该布尔表达式。如果结果为真,则返回该表达式的真值;如果结果为假,则返回该表达式的假值。参数必须符合任何指标表达式的规则。 |
| 是 | (表达式 [, 表达式 ...] 中的 expr1) | 如果 expr1 与后面的任何一个表达式相等,则返回 true;否则返回 false。 |
| 一片空白 | (元素) | 如果元素值为空(null),则返回 true;否则返回 false。 |
| isNotNull | (元素) | 如果元素值不为空(非 null),则返回 true;否则返回 false。 |
| firstNonNull | (元素 [, 元素 ...]) | 返回第一个不缺失(非空)的元素的值。可以传入任意数量的参数。参数也可以是数值或字符串字面量,如果所有前面的项都缺失值,则返回该参数。 |
| 最伟大的 | (表达式 [, 表达式 ...]) | 返回给定表达式中的最大值。可以提供任意数量的参数。 |
| 最小 | (表达式 [, 表达式 ...]) | 返回给定表达式中的最小(最低)值。可以提供任意数量的参数。 |
| 日志 | (表达式 [, 基数]) | 返回数值表达式的自然对数(底为 e)。如果将一个整数作为第二个参数传入,则返回以该底为底的对数。 |
| log10 | (表达式) | 返回数值表达式的常用对数(底为 10)。 |
| false | 不返回任何结果。例如,如果数据元素的值小于 0,则 if( #{FH8ab5Rog83} < 0, null, 1 ) 不返回任何结果;否则返回 1。 | |
| removeZeros | (表达式) | 如果表达式的值为 0,则不返回任何值;否则返回该表达式的值。 |
| 子表达式 | (表达式) | 在进行聚合之前,先评估表达式的一部分。参见 指示子表达式。 |
[periodInYear] | 该期间在一年中的序号(1、2、3、……)。参见年初至今指标。 | |
[yearlyPeriodCount] | 该年度内此类期间的数量。参见累计指标。 | |
| .aggregationType | (聚合类型) | 覆盖汇总数据(非项目数据)的默认数据元素汇总类型。 |
| .maxDate | (yyyy-mm-dd) | 对于数据元素(非项目数据),最大日期当日或之前结束的期间的值。 |
| .minDate | (yyyy-mm-dd) | 对于数据元素(非项目数据),最小日期当日或之后开始的期间的值。 |
| .periodOffset | (整数常量) | 置于数据值或表达式之后时,会返回相对于报告期间偏移一定时期后的值。该语法支持嵌套。请注意,此操作仅对聚合数据进行偏移,不适用于跟踪器或事件数据。请参见下方的示例。 |
| .yearToDate() | 计算从年初到当前期间所有期间的值之和。如果某个周期间在该年内包含四天或更多天,则该周期间被计入该年。参见 年初至今指标。 |
除了这些功能外,您还可以使用:
- 数学运算符
+、-、*、/、%(取模)和^(幂),以及用于将表达式中的部分进行分组的圆括号 - 比较运算符
==、!=、>、<,>=和<= - 逻辑运算符
&&(或关键字and)、||(或or)和!(或not)
注意
DHIS2 使用一套通用的语法来解析指标、预测因子、验证规则和项目指标表达式, 但每种表达式类型仅*接受*其自身子集中的 函数。 属于其他类型的函数会被解析器识别, 但在表达式验证时会被拒绝,这就是为什么一个表达式看起来 似乎合理,却仍无法保存。具体而言:
- 聚合函数 —
avg()、sum()、count()、min()、max()、median()、stddev()、stddevPop()、stddevSamp()和percentileCont()—— 以及分布函数normDistCum()和normDistDen()均属于 预测变量 生成表达式。 请参阅 创建或编辑预测因子。若要在指标表达式聚合之前对其部分进行求值,请改用subExpression;若要覆盖项目的聚合方式,请使用.aggregationType()。orgUnit.ancestor()、orgUnit.dataSet()、orgUnit.group()和orgUnit.program()函数属于 验证规则 和 预测器 表达式。d2:函数和V{...}变量属于 项目指标 表达式和 项目规则。请参阅 参考信息:在项目指标表达式和过滤器中使用的函数、变量和运算符。subExpression()、.aggregationType()、.periodOffset()、.yearToDate()、[periodInYear]、[yearlyPeriodCount]以及指标引用 仅 在指标表达式中被接受。
可以传递给 .aggregationType() 的聚合类型有:
表:.aggregationType() 的聚合类型
| 不 | Parameter name |
|---|---|
| SUM | “期间”和“组织单位”两个维度中值的总和 |
| 平均值 | 在“期间”和“组织单位”两个维度上的平均值 |
| AVERAGE_SUM_ORG_UNIT | 在“期间”维度中取平均值,在“组织单位”层级中求和 |
| COUNT | 值的个数 |
| STDDEV | 值的标准差(基于总体) |
| 方差 | 值的方差(基于总体) |
| MIN | A sample JSON response looks like this: |
| MAX | min-max 数据元素资源允许您设置最小值和最大值 |
| 数据元素的值范围。它是独一无二的 | |
| 组织单位、数据元素和类别选项组合。 | |
| MIN_SUM_ORG_UNIT | 时间维度中的最小值,组织单位层次结构中的总和 |
| MAX_SUM_ORG_UNIT | 时间维度中的最大值,组织单位层级中的总和 |
| FIRST | 组织单位层次结构中的第一个值、总和 |
| FIRST_AVERAGE_ORG_UNIT | 第一个值,组织单位层级中的平均值 |
| FIRST_FIRST_ORG_UNIT | 在“时间段”和“组织单位”两个维度中的第一个值 |
| LAST | 组织单位层次结构中的最后一个值、总和 |
| LAST_AVERAGE_ORG_UNIT | 组织单位层级中的最后一个值、平均值 |
| LAST_LAST_ORG_UNIT | 在“时间段”和“组织单位”两个维度中的最后一个值 |
| 本期末 | 该期间的最后一个值,组织单位层级中的总和 |
| 本期末平均组织单位 | 该期间的最后一个值,组织单位层次结构中的平均值 |
| Boolean | 任何维度均未进行聚合 |
.aggregationType、.maxDate、.minDate 和 .periodOffset 的示例:
表:指标表达示例
| 指标表达 | 手段 |
|---|---|
#{FH8ab5Rog83}.aggregationType(COUNT) | 值的个数 |
#{FH8ab5Rog83}.aggregationType(LAST) - #{FH8ab5Rog83}.aggregationType(FIRST) | 第一个值与最后一个值之间的差值 |
#{FH8ab5Rog83}.maxDate(2021-6-30) | 截至2021年6月30日的数值 |
#{FH8ab5Rog83}.minDate(2021-1-1) | 2021年1月1日及之后的数值 |
#{FH8ab5Rog83}.minDate(2021-1-1).maxDate(2021-6-30) | 2021年1月1日至2021年6月30日期间的数据 |
#{FH8ab5Rog83}.periodOffset(-1) | 上一期间的数值 |
#{FH8ab5Rog83}.periodOffset(1) | 该期间后的数值 |
#{FH8ab5Rog83} - 2 * D{IpHINAT79UW.uf3svrmp8Oj}.periodOffset(-1) | 报告期间的数据元素 FH8ab5Rog83,减去前一期间的程序数据元素 IpHINAT79UW.uf3svrmp8Oj 的两倍 |
( #{FH8ab5Rog83} - #{QOlfIKgNJ3D2} ).periodOffset(-2) | 两个周期前的数据元素 FH8ab5Rog83,减去两个周期前的数据元素 QOlfIKgNJ3D2 |
( #{FH8ab5Rog83}.periodOffset(-1) + #{FH8ab5Rog83} ).periodOffset(-1) | 来自前两个周期的数据元素 FH8ab5Rog83 及其前一个周期的值——请注意,这些函数是嵌套的 |
N{IndicatorID}.periodOffset(-1) | 上一期间的指标值(适用于该指标的汇总数据) |
指标子表达式{ #mm_indicator_subexpressions }
通常,指标会先汇总数据元素的值,然后才计算表达式。例如,在以下表达式中:
if( #{nYahlae7fe6} > 10, 1, 0 )
如果该数据元素的聚合类型为 SUM,DHIS2 会将该数据元素在相关期间内的所有值相加,然后判断该 总和 是否大于 10。
有时你需要做相反的事情:在聚合之前先评估每个值。例如,要显示某个地区内有多少家设施的数值大于 10,可以将该测试用 subExpression 包裹起来:
subExpression( if( #{nYahlae7fe6} > 10, 1, 0 ) )
对每个数据值进行测试,返回 1 或 0,然后(假设该数据元素采用 SUM 聚合方式)将这些 1 和 0 相加——从而得出超过 10 的值个数。
关于子表达式的说明:
-
只有当数据元素的聚合类型为 SUM 时,这些 1 和 0 才会被求和。如果其聚合类型不同,而您希望将它们求和,请在子表达式中覆盖该聚合类型:
subExpression( if( #{nYahlae7fe6} > 10, 1, 0 ) ).aggregationType(SUM) -
子表达式只能引用一个数据元素,但可以多次引用该元素。例如:
subExpression( if( #{nYahlae7fe6} > 10 && #{nYahlae7fe6} <= 20, 1, 0 ) ) -
子表达式可以引用一个带有类别选项组合和/或属性选项组合的数据元素,但每次引用的对象必须完全相同。例如:
subExpression( if( #{nYahlae7fe6.beec4Dewah8} > 10 && #{nYahlae7fe6.beec4Dewah8} <= 20, 1, 0 ) ) -
若要在聚合前评估一个涉及程序数据、或包含多个数据元素、类别选项组合或属性选项组合的表达式,请改用 预测因子,并将结果存储为一个独立的数据元素。随后,您可以在指标中或在分析中直接引用该预测数据元素。
指标 年初至今{ #mm_indicator_yeartodate }
指标可以使用以下三个表达式元素来计算年初至今的值:.yearToDate()、[periodInYear] 和 [yearlyPeriodCount]。
| 元件 | 退货 |
|---|---|
.yearToDate() | 从年初到当前期间,每个期间的数值之和 |
[periodInYear] | 该年度内当前期间的编号——1、2、3,依此类推。对于5月份的月度数据,该编号为5;对于第三季度的季度数据,该编号为3 |
[yearlyPeriodCount] | 这一类时段在一年中的总数——每月12个,每季度4个,每周52或53个。随着一年的推移,这一数字保持不变。 |
在下面的示例中,#{a} 可以是 #{dataElementUID},也可以是任何能返回数据值的有效指示符表达式项,例如 #{dataElementUID.catOptionComboUid}、I{programIndicatorUID} 或 N{indicatorUID}。
表:年初至今的指标表达式
| 指标表达 | 手段 |
|---|---|
#{a} | 本期值 |
#{a}.yearToDate() | 年初至今的数值之和。如果时间段是3月,则结果为1月 + 2月 + 3月 |
#{a}.yearToDate() / [periodInYear] | 年初至今的平均值。如果时间段是3月,则计算公式为(1月 + 2月 + 3月)÷ 3 |
#{a} - #{a}.yearToDate() / [periodInYear] | 本期与年初至今平均值的差异 |
#{b} * [periodInYear] / [yearlyPeriodCount] | 如果 #{b} 是一个年度目标——例如今年应接种疫苗的人数——那么这个公式给出的就是截至当前时间点应已接种疫苗的人数。以2月份的月度数据为例,计算公式为 #{b} * 2 / 12 |
注
如果某一周中有四天或更多天属于该年,则该周被视为该年的一部分。
关于缺失数据的说明{ #notes-on-missing-data }
如果在年初至今的计算中,某些期间的数据缺失,则计算结果仅基于有数据的期间。在解读年初至今的数据时请注意这一点——较低的数值可能意味着表现不佳,也可能仅仅表示该期间的数据尚未上报。
工作流程{ #mm_workflow_indicator }
- 创建指标类型(除非使用默认类型)。
- 创建指标。
- (可选)创建指标组。
- (可选)创建指标组集。
创建或编辑指标类型{ #mm_create_indicator_type }
指标类型定义了在报告中显示指标值或将其导出到分析工具时,用于乘以指标值的系数。例如,“百分比”指标类型会将值乘以100。
- 打开 元数据管理 应用程序,点击 指标和预测因子 > 指标类型。
- 点击**+ 新建**按钮。
- 在**名称**字段中,输入指标类型的名称,例如“百分比”。
- 在“因子”字段中,输入该因子。如果是百分比指标,请输入 100。
- 如果指标类型没有分母(例如计数型),请选择 数字(无分母)。
- 点击**保存**。
创建或编辑指标{ #mm_create_indicator }

- 打开**元数据管理**应用,然后单击**指标和预测因子** > 指标。
- 点击**+ 新建**按钮,或点击现有指标旁边的选项菜单,然后选择**编辑**。
- In the Name field, type the full name of the indicator, for example "Incidence of confirmed malaria cases per 1000 population".
-
在**“简短名称”**字段中,输入一个简短名称,例如“每1000人中疟疾病例数”。简短名称必须是唯一的,且长度不超过50个字符。
-
(可选)在 Code 字段中,分配一个代码。
- (可选)在**颜色**字段中,为该指示器指定一种颜色。
- (Optional) In the Icon field, assign an icon to illustrate the meaning of the indicator.
- In the Description field, type a brief, informative description of the indicator and how it is calculated.
- 如果要在计算过程中应用年化系数,请选择**“年化”**。这会将分子换算为年化值,以便与分母(例如人口数据)进行比较,而分母本身已是年化数据。通常,分子会乘以365再除以报告期间的天数。
- Select the number of Decimals in data output.
- 选择一个**指标类型**。该字段将确定一个在计算过程中自动应用的因子。
- (可选)分配一个或多个**传奇**。
- (可选)在**URL**字段中,输入一个链接——例如指向指标注册库的链接——该链接应提供该指标的完整元数据描述。
- (可选)输入**用于汇总数据导出的类别选项组合**和**用于汇总数据导出的属性选项组合**。这些设置用于将导出的汇总数据映射到另一台服务器时。
- (可选)为任何自定义属性输入值。
- 点击 编辑分子:
- 键入分子的清晰描述。
- 双击右侧字段中的组件来定义分子。双击公式字段下方的图标来添加数学运算符。
- 点击**“完成”**。
- 点击 编辑分母:
- 键入分母的清晰描述。
- 请按照上文所述,使用公式编辑器定义分母。
- 点击 完成。
- (可选)将该指标分配到任何必选指标组中。
- 点击**保存**。
创建或编辑指标组{ #mm_create_indicator_group }
- 打开**元数据管理**应用,点击**指标和预测因子** > 指标组。
- 点击**+ 新建**按钮。
- Type a Name.
- 选择指标并分配它们。
- 点击**保存**。
创建或编辑指标组集{ #mm_create_indicator_group_set }
- 打开**元数据管理**应用,点击**指标和预测因子** > 指标组集。
- 点击 + 新建 按钮。
- 请填写**名称**、**简称**和**描述**字段——请参阅常见元数据对象字段。
- 如果您想在分析中将该指标组用作维度,请选择 数据维度。
- 如果要求每个指标都必须属于该组集中的某个组,请选择 必选。
- 选择指标组并分配它们。
- 点击**保存**。
合并指示器{ #mm_merge_indicators }

合并操作会将两个重复的指标合并为一个,将源指标的所有引用重新分配给目标指标,然后删除源指标。
注意
您必须拥有
F_INDICATOR_MERGE权限才能访问此页面。
- 打开 元数据管理 应用,然后导航至 指标 > 合并指标(或直接访问
#/indicators/merge)。 - 查找并选择**源**指示符(即要删除的那个)。
- 查找并选择**目标**指标(即要保留的那个)。
- 查看更改摘要。
- 点击 确认合并。
警告
合并操作不可逆。源指示符将被永久删除。
合并指示器类型{ #mm_merge_indicator_types }

注意
您必须拥有
F_INDICATOR_TYPE_MERGE权限才能访问此页面。
- 打开 元数据管理 应用,导航至 指标类型 > 合并指标类型(或直接访问
#/indicatorTypes/merge)。 - 查找并选择**源**指示器类型(即要删除的那个)。
- 搜索并选择**目标**指标类型(即要保留的那个)。
- 查看更改摘要。
- 点击 确认合并。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的功能,请参阅 常用操作。指标和指标类型均支持合并;请参阅 合并。
管理组织单位{ #mm_manage_organisation_unit }
在本节中,您将学习如何:
- 创建一个新的组织单位,并构建组织单位层级结构
- 创建组织单位组、组集,并将组织单位分配给它们
- 修改组织单位的层次结构
关于组织单位{ #mm_about_organisation_unit }
组织单位层级定义了DHIS2的组织结构,例如医疗机构、行政区域及其他地理区域之间是如何相互排列的。它是DHIS2中的“地点”维度,类似于时间段所代表的“时间”维度。
组织单位层级结构由父子关系构成。在DHIS2中,这些节点中的每一个都代表一个组织单位。 例如,一个国家可能有八个省,每个省又可能有若干个区作为下级单位。通常,最底层由数据采集点组成。数据采集点也可以位于更高级别,例如国家或省级医院。因此,您可以在DHIS2中创建不对称的组织树。
- 每次只能有一个组织结构。
- 一个层级结构中可以包含任意数量的层级。通常,公共卫生领域的国家组织层级结构有四到六个层级。
- 您可以利用组织单位组和组织单位组集来创建额外的分类,例如,以此建立与医疗保健行业平行的行政分界。
- 建议使用组织单位组来创建非地理性的层级结构。
- 一个组织单位在某个组织单位组集中,只能属于其中一个组织单位组。
- 一个组织单位组可以属于多个组织单位组集。
- 组织单位层级结构是地理维度上数据聚合的主要手段。
- 关闭某个组织单位后,您将无法在**Capture**应用中为该组织单位注册或编辑活动。
重要提示
创建组织单位层级后,即使这些组织单位正在收集数据,您仍可对其进行修改。但DHIS2在汇总数据时始终采用最新的层级结构。因此,如果您修改了层级结构,将无法保留该层级随时间变化的历史轨迹。
例如:A区被划分为B区和C区。原属于A区的医疗机构被重新分配至B区和C区。任何在划分前录入的历史数据仍会被记录为属于B区和C区,而非已废止的A区。
在 元数据管理 应用中,您可以管理以下组织单位对象:
表:元数据管理应用中的组织单位对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| 类别 | 创建、编辑、克隆、删除、查看详细信息和翻译 |
| Category combination | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 数据元素 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 组织单位级别 | 分配名称 |
工作流程{ #mm_workflow_organisation_unit }
- 创建组织单位(代表层级结构中的节点,从上到下)。
- 创建组织单位组。
- 创建组织单位组集。
- 将组织单位分配到组中。
- 将组织单位组分配给组集。
创建或编辑组织单位{ #mm_create_organisation_unit }

-
打开 元数据管理 应用程序,然后单击 组织单位 > 组织单位。 屏幕左侧的树形结构显示了现有的组织单位层级结构。点击树形结构中的某个组织单位即可将其选中;选中的组织单位会高亮显示。当您添加新的组织单位时,它将作为当前所选组织单位的子单位创建。
-
点击**+ 新建**按钮。
- 填写**名称**、简称、代码、描述、备注**以及联系方式(**联系人、地址、 电话号码、电子邮件)——请参阅 通用元数据对象字段。其中仅 名称 为必填项。
- 设置**启用日期**——即该组织单元开始生效的日期。启用日期在未来的组织单元不会出现在分析或数据录入中,除非明确要求。
- (可选)设置**关闭日期**——即该组织单位自该日期起不再活跃。请参阅关闭组织单位。
- (可选)添加 几何信息 —— 组织单位的点或多边形坐标。
- 点击**保存**。
创建或编辑组织单位组{ #mm_create_organisation_unit_group }
组织单位组可用于对组织单位进行分类,以便进行分析和报告。
- 打开**元数据管理**应用,然后点击**组织单位** > 组织单位组。
- 点击**+ 新建**按钮。
- 请填写**名称**、**简称**以及(可选)**代码**和**描述**字段——请参阅常见元数据对象字段。
- (可选)为地图上使用分配一个**符号**。
- (可选)选择一种**颜色**,用于在地图上以及组集报告中显示该组。
- 选择组织单位并分配它们。
- 点击**保存**。
创建或编辑组织单位组集{ #mm_create_organisation_unit_group_set }
组织单位组集可让您将多个组织单位组归类到单一维度中,例如“设施类型”(包括“医院”、“卫生中心”和“社区卫生站”等组)。
- 打开**元数据管理**应用程序,然后单击**组织单位** > 组织单位组集。
- 点击**+ 新建**按钮。
- 请填写**名称**和**描述**字段——参见常见元数据对象字段。
- 如果您希望每个组织单位都必须成为该组集中的某个组的成员,请选择 必选。
- 选择 数据维度,以便将此组集作为维度在分析中使用。
- 选择组织单位组并分配它们。
- 点击**保存**。
为组织单位层级命名{ #mm_name_organisation_unit_level }
创建组织单位层级结构后,您可以为每个级别分配名称。例如,在国家层级结构中,第1级可命名为“国家”,第2级命名为“省”,第3级命名为“区”,第4级命名为“机构”。
- 打开**元数据管理**应用程序,点击**组织单位** > 组织单位层级。
- 请为列表中的每个级别输入一个名称。
- 点击**保存**。
在层级结构中移动组织单位{ #mm_move_organisation_unit }
您可以通过更改所选组织单位的上级,在层级结构中移动组织单位。此操作需在专用页面上进行,而非在主组织单位列表中。
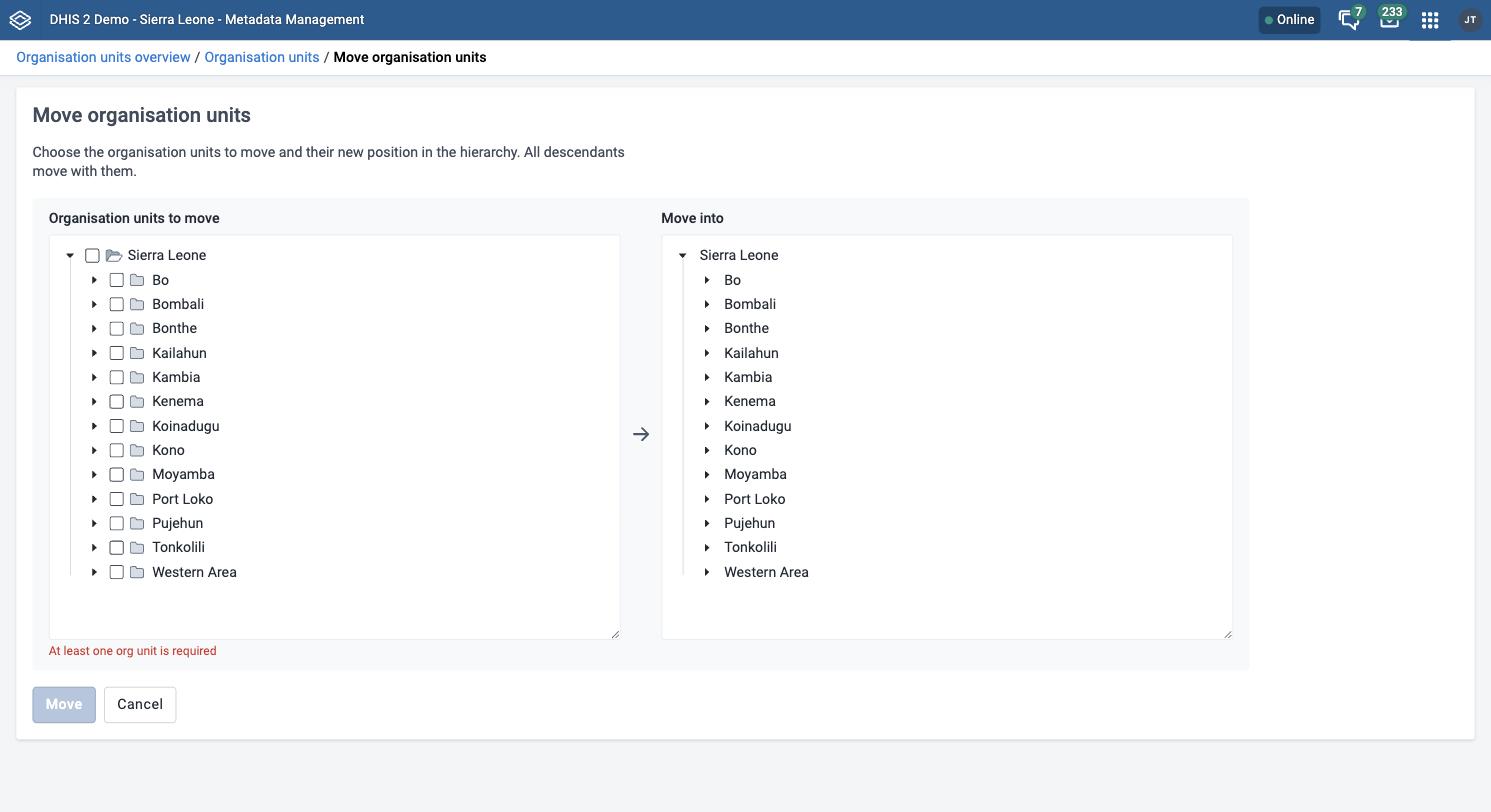
- 打开**元数据管理**应用,然后在左侧边栏中点击**组织单位** > 层次结构操作。
- 在左侧的**“待移动的组织单位”**树形结构中,选择您要移动的一个或多个组织单位。按住**Shift**或**Ctrl**键可选择多个。
Note
If a selected organisation unit has children, all of them move with it to the new parent.
- 在右侧的 “移动到” 树中,选择您要将所选内容移动到的组织单位。
- 单击“移动 x 个组织单位”,其中 x 表示您所选的组织单位数量。
您的更改会立即反映在层次结构树中。
关闭一个组织单位{ #mm_close_organisation_unit }
关闭某个组织单位后,您将无法在**Capture**应用中为该组织单位注册或编辑活动。
- 打开**元数据管理**应用程序,然后单击**组织单位** > 组织单位。
- In the object list, click the options menu and select Edit.
- 请输入**截止日期**。
- 点击**保存**。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的操作,请参阅 常用操作。 组织单位级别是个例外——它们仅支持命名和翻译(需直接点击“翻译”图标,因为它们没有选项菜单);不支持“显示详细信息”、“共享设置”、“删除”或“克隆”。
管理验证规则{ #mm_manage_validation_rule }
关于验证规则{ #mm_about_validation_rule }
验证规则基于表达式。该表达式定义了一个 数据元素值之间的关系。该表达式形成一个 条件符合某些逻辑条件。
该表达式包括:
-
左侧
-
右边
-
操作员
验证规则断言所接种的疫苗总数 婴儿小于或等于婴儿总数。
左侧和右侧必须返回数字值。
在 元数据管理 应用程序中,您可以管理以下验证规则 对象:
表:元数据管理应用中的验证规则对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| 指示符 | 创建、编辑、克隆、删除、查看详细信息和翻译 |
| Indicator type | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 验证通知 | 创建、编辑、克隆、删除、查看详细信息和翻译 |
关于推拉窗{ #mm_sliding_windows }
您可以使用滑动窗口将数据按*多个时间段*进行分组, 而不是仅选择*单个时间段*的数据。滑动窗口具有 一个大小,即所涵盖的天数,以及一个起始点和 一个终点。下面的示例展示了疾病监测数据:
-
橙色部分中的数据,根据当前数据选择数据 期。有一个阈值,每周计算一次 或期间,并显示在“结果”部分中。
-
蓝色部分中的数据是滑动窗口。它选择数据 从过去7天开始。 “结果”显示了总数 确诊病例。
-
验证规则可确保在总数达到 案例数超出了该时间段的阈值。

表:验证规则的不同行为
| 带推拉窗 | 没有推拉窗 |
|---|---|
| 仅用于事件数据。 | 用于事件数据和汇总数据。 |
| 数据选择基于固定的天数(periodType)。 | 数据选择总是基于某个时间段。 |
| 滑动窗口的位置总是*相对于*正在比较的周期而言的。 | 数据始终是从与被比较期间*相同的期间*中选取的。 |
另请参阅:在创建或编辑 验证 规则时如何使用滑动窗口。
关于验证规则组
验证规则组可让您将相关的验证规则进行分组。 当您运行 验证规则分析 时, 您可以选择运行系统中的所有验证规则,或者 仅运行某个组中的验证规则。
关于验证通知{ #mm_validation_notifications }
您可以配置验证规则分析,以便自动向 选定的用户组发送有关验证错误的通知。这些 消息称为*验证通知*。它们通过 DHIS2内部消息系统发送。
您可以将验证规则通知作为单独的消息或作为 消息摘要。这很有用,例如,如果您要发送 有关高优先级疾病暴发的个别消息和摘要 用于低优先级常规数据验证错误。
关于验证规则函数{ #about-validation-rule-functions }
您可以在验证规则的左侧 或右侧使用以下函数:
表:验证规则函数
| 验证规则函数 | size | Parameter name |
|---|---|---|
| 包含 | (表达式, 子表达式1, ...) | 在表达式中搜索一个或多个子字符串。 如果表达式包含所有子字符串,则返回 true。例如,以下表达式均返回 true:contains("abcd", "abcd");contains("abcd", "b");以及 contains("abcd", "ab", "bc")。比较操作区分大小写。 |
| 包含项目 | (表达式, 项1, ...) | 在表达式中搜索一个或多个项目。该表达式由以逗号分隔的元素组成。如果每个项目都与表达式中的某个元素完全匹配,则 containsItems 返回 true。 例如,containsItems("abcd", "abcd") 和 containsItems("ab,cd", "ab", "cd") 返回 true,但 containsItems("abcd", "b") 和 containsItems("abcd", "ab", "bc") 则返回 false。比较操作区分大小写。containsItems 可用于多值数据元素,以检查某项是否包含在该数据元素的值中。 |
| 如果 | (布尔表达式, 真表达式, 假表达式) | 评估该布尔表达式,若为真则返回表达式的真值,若为假则返回表达式的假值。参数必须符合任何指标表达式的规则。 |
| 是 | (表达式 [, 表达式 ...] 中的表达式1) | 如果 expr1 与以下任一表达式相等,则返回 true;否则返回 false。 |
| 一片空白 | (元素) | 如果元素值为空(null),则返回 true;否则返回 false。 |
| isNotNull | (元素) | 如果元素值不为空(非 null),则返回 true;否则返回 false。 |
| firstNonNull | (元素 [, 元素 ...]) | 返回第一个不为空(非 null)的元素的值。可以提供任意数量的参数。任何参数也可以是数值或字符串字面量,如果所有前面的对象都有缺失值,则返回该参数。 |
| 最伟大的 | (表达式 [, 表达式 ...]) | 返回给定表达式中的最大(最高)值。可以提供任意数量的参数。 |
| 最小 | (表达式 [, 表达式 ...]) | 返回给定表达式中的最小值。可以提供任意数量的参数。 |
| 日志 | (表达式 [, 底数 ]) | 返回数值表达式的自然对数(底为 e)。如果将一个整数作为第二个参数传入,则返回以该底为底的对数。 |
| log10 | (表达式) | 返回数值表达式的常用对数(底为 10)。 |
| false | 不返回任何结果。例如,if( #{FH8ab5Rog83} <0, null, 1 ) 在数据元素值小于 0 时不返回任何结果,否则返回 1。 | |
| orgUnit.ancestor | (orgUnitUid [, orgUnitUid ...]) | 如果该组织单位是(一个或多个)组织单位的子单位,则返回 true;否则返回 false。 |
| orgUnit.dataSet | (dataSetUid [, dataSetUid ...]) | 如果该组织单位被分配给了任意一个(一个或多个)数据集,则返回 true;否则返回 false。 |
| orgUnit.group | (ouGroupUid [, ouGroupUid ...]) | 如果该组织单位是任意一个(一个或多个)组织单位组的成员,则返回 true;否则返回 false。 |
| orgUnit.program | (programUid [, programUid ...]) | 如果组织单位被分配给任何(1 个或多个)项目,则返回 true,否则返回 false。 |
| removeZeros | (表达式) | 如果表达式的值为 0,则不返回任何值;否则返回该表达式的值。 |
创建或编辑验证规则{ #mm_create_validation_rule }

-
打开**元数据管理**应用程序,然后单击**验证** > 左侧边栏中的**验证规则**。
-
点击**+ 新建**按钮。
-
Type a Name.
在验证规则中,名称必须唯一。
-
(可选)在 Code 字段中,分配一个代码。
-
(可选)输入**说明**。
-
(可选)输入**说明**。这是用户将看到的,无论是在 在验证分析中以及在审查数据期间的规则违规情况时 条目,因此建议始终提供一条说明,说明 明确说明当规则生效时,用户应采取什么行动 被触发。
-
选择**重要性**:高,中**或**低。
-
Select a Period type.
-
选择一个**操作员**:必填项,等于, 独家配对,大于,大于或等于 或**不等于**。
**必填对**运算符允许要求该数据值 必须为表格的左侧和右侧输入表格 表情,还是双方都没有。这意味着您可以要求 如果填写表单中的一个字段,则一个或多个其他字段 还必须填写。
**独占对**可以断言是否存在任何值 左侧,则右侧应没有值(或 反之亦然)。这意味着构成规则的数据元素 任何一方都应相互排斥,因为 给定的时间段/组织单位/属性选项组合。
-
创建表达式的左侧:
-
Click Left side.
-
如果要查看相对于**滑动窗口**的数据,请选择该选项 您比较的时期。另请参见关于验证 规则。
-
选择一种 缺失值处理策略。此选择将决定如何 如果数据丢失,系统将评估验证规则。
选项 说明 若有任何值缺失则跳过 如果构成该表达式的任何值缺失,则将跳过该验证规则。这是默认选项。
使用 排他配对 或 强制配对 运算符时,请始终选择此选项。若所有值均缺失,则跳过 只有当构成该验证规则的所有操作数均缺失时,才会跳过该验证规则。 绝不跳过 即使存在缺失数据,该验证规则也绝不会被跳过,所有缺失的操作数都将被视为零。 -
输入**说明**。
-
根据可用的数据元素构建一个表达式, 项目对象,组织单位,计数和常量。
在右窗格中,双击想要的数据对象。 包括在表达式中。与数学结合 运算符位于左窗格下方。
-
点击**保存**。
-
-
创建表达式的右侧:
-
Click Right side.
-
选择一种 缺失值处理策略。此选择将决定如何 如果数据丢失,系统将评估验证规则。
选项 说明 若有任何值缺失则跳过 如果构成该表达式的任何值缺失,则将跳过该验证规则。这是默认选项。
使用 排他配对 或 强制配对 运算符时,请始终选择此选项。若所有值均缺失则跳过 只有当构成该验证规则的所有操作数均缺失时,才会跳过该验证规则。 绝不跳过 即使存在缺失数据,该验证规则也绝不会被跳过,所有缺失的操作数都将被视为零。 -
如果要查看相对于**滑动窗口**的数据,请选择**滑动窗口** 您比较的时期。另请参见关于验证 规则。
-
输入**说明**。
-
根据可用的数据元素构建一个表达式, 项目对象,组织单位,计数和常量。
在右窗格中,双击想要的数据对象。 包括在表达式中。与数学结合 运算符位于左窗格下方。
-
点击**保存**。
-
-
(可选)选择此规则适用的**组织单位层级** 应该进行评估。将此留空将导致 要在所有级别上评估的验证规则。
-
(可选)选择 在表单验证时跳过此规则 以停止 在数据录入过程中,防止该规则被触发。
-
点击**保存**。
创建或编辑验证规则组{ #mm_create_validation_rule_group }
-
打开**元数据管理**应用,然后单击**验证** > 左侧边栏中的**验证规则组**。
-
点击**+ 新建**按钮。
-
Type a Name.
-
(可选)在 Code 字段中,分配一个代码。
-
(可选)输入**说明**。
-
双击您要分配给该的**验证规则** 组。
-
点击**保存**。
创建或编辑验证通知{ #mm_create_validation_notification }
-
打开**元数据管理**应用,然后单击**验证** > 左侧边栏中的**验证通知**。
-
点击**+ 新建**按钮。
-
Type a Name.
-
(可选)在 Code 字段中,分配一个代码。
-
Select Validation rules.
-
Select Recipient user groups.
-
(Optional) Select Notify users in hierarchy only.
如果选择此选项,系统将过滤收件人 用户。 (系统从收件人那里获取收件人用户 用户组。)过滤器基于 收件人用户所属。链接到组织单位的用户 是违规组织单位的祖先 发生后将收到验证通知。系统将 忽略其他用户,这些用户将不会收到验证 通知。
-
创建消息模板:
-
创建**主题模板**。
双击**模板变量**字段中的参数 将它们添加到您的主题。
-
创建**消息模板**。
双击**模板变量**中的参数名称 字段以将其添加到您的消息中。
-
-
点击**保存**。
有关“显示详细信息”、“翻译”、“删除”和“克隆”的操作,请参阅 常用操作。此外,验证规则组还支持“共享”设置(该设置同样位于 常用操作 中)。
管理属性{ #mm_manage_attribute }
关于属性{ #mm_about_attribute }
您可以使用元数据属性将其他信息添加到 元数据对象。除了每个标准属性 这些对象可能有助于存储其他信息 属性,例如数据元素的收集方法。

在 元数据管理 应用中,您可以管理以下属性对象:
表:元数据管理应用中的属性对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| ValidationRuleGroup | 创建、编辑、克隆、删除、查看详情和翻译 |
创建或编辑属性
-
打开**元数据管理**应用,然后在左侧边栏中点击**其他** > 属性。
-
点击**+ 新建**按钮。
-
在 名称 字段中,输入属性的名称。
每个属性必须有一个唯一的名称。
-
(可选)在 Code 字段中,分配一个代码。
-
选择**值类型**。
如果为属性提供的值与该值不匹配 键入您将收到警告。
-
(可选)选择一个**选项集**,将该属性的值限制为 预定义列表。
-
(可选)在**排序顺序**字段中,输入一个数字来控制 当……时,该属性相对于其他属性出现在什么位置 编辑对象的表单。未指定排序顺序的属性将显示 随后,按字母顺序排列。
-
选择所需的选项,例如:
-
选择**强制**如果希望对象始终具有 动态属性。
-
如果希望系统强制要求值必须是**唯一**的,请选择该选项 对于特定的对象类型是唯一的。
-
-
点击**保存**。
动态属性现在可用于您分配的对象 它来。
有关“显示详细信息”、“翻译”、“删除”和“克隆”的操作,请参阅 常用操作。属性不支持“共享”设置。
管理常量{ #mm_manage_constant }
关于常量{ #mm_about_constant }
常量是可以供用户使用的静态值 在数据元素和指标中。一些指标,例如“夫妇年 保护率”取决于通常不会转换的常数 时间。

在 元数据管理 应用中,您可以管理以下常量对象:
表:元数据管理应用中的常量对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| N{<indicator-id>} | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
创建或编辑常量{ #mm_create_constant }
-
打开**元数据管理**应用,然后在左侧边栏中点击**其他** > 常量。
-
点击**+ 新建**按钮。
-
在 名称 字段中,输入常量的名称。
-
在“短名称”字段中,输入的简写名称为 常数。
-
(可选)在 Code 字段中,分配一个代码。
-
在“描述”字段中,输入简短且内容充实的描述 常数。
-
在 值 字段中,定义常量的值。
-
点击**保存**。
现在可以使用该常数。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的功能,请参阅 常用操作。
管理选项集{ #mm_manage_option_set }
关于选项集{ #mm_about_option_set }
选项集提供了一个预定义的下拉列表(枚举),用于 DHIS2。您可以定义任何类型的选项。
一个名为“投放类型”的选项集将具有以下选项:“普通”, “违反”,“剖腹产”和“协助”。

表:元数据管理应用中的选项集对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| 网址 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 选项组 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
| 选项组集 | 创建、编辑、克隆、分享、删除、查看详情和翻译 |
创建或编辑选项集{ #mm_create_option_set }
重要
选项集必须具有代码和名称。您可以更改 名称,但是您无法更改代码。所有的名称和代码 选项即使在不同的选项集之间也必须是唯一的。
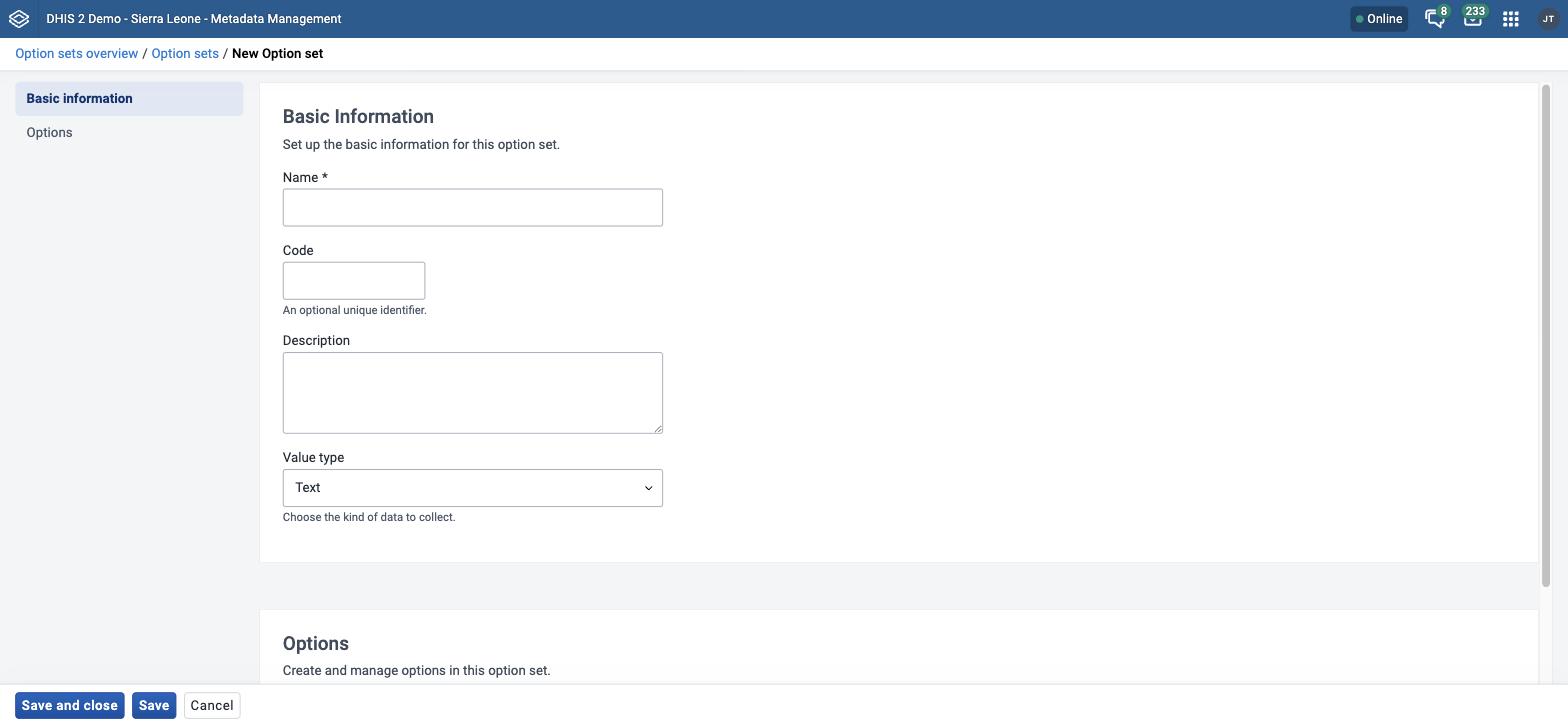
-
打开**元数据管理**应用,然后在左侧边栏中点击**选项集** > 选项集。
-
点击**+ 新建**按钮。
-
在“基本信息”选项卡中,填写“名称”、“代码”和(可选)“描述”——参见常见元数据对象字段——选择“值类型”,然后点击“保存”。
-
对于您需要的每个选项,执行以下任务:
-
Click the Options tab.
-
点击**+ 新建**按钮。
-
请输入**名称**和**代码**。此外,您还可以选择一个 **颜色**和**图标**将用于此选项 数据捕获应用项目。
-
按名称,代码/值或手动对选项进行排序。
-
点击**保存**。
-
创建或编辑选项组{ #mm_create_option_group }
您可以使用**选项组**对**选项集**中的**选项**进行分组和分类。 通过这种方式,您可以在选项集中创建一个选项子集。这样做的主要目的是将庞大的选项集过滤为较小且相关的部分。
在**Capture**应用中,通过程序规则可以统一隐藏或显示分组后的选项。
Note
You cannot change the Option set selected in an Option group once it has been created.
- 打开**元数据管理**应用程序,然后在左侧边栏中点击**选项集** > 选项组。
- 点击**+ 新建**按钮。
- 请填写 名称、简称 和 代码 —— 请参阅 通用元数据对象字段。
- 选择该组所属的**选项集**。
- 选择**选项集**后,请指定要分组的**选项**。
- 点击**保存**。
创建或编辑选项组集{ #mm_create_option_group_set }
**选项组集合**可让您将多个**选项组**归类到一个集合中。 选项组集合的主要目的是为您的采集数据增添更多维度,以便进行分析。
Note
You cannot change the Option set selected in an Option group set once it has been created.
- 打开 元数据管理 应用,然后在左侧边栏中点击 选项集 > 选项组集。
- 点击“+ 新建”按钮。
- 请填写 名称、代码 和 描述 — 参见 常见元数据对象字段。
- 选择该组集所属的**选项集**。
- (可选)选择 数据维度,以便将该分组集作为另一个维度供分析使用,作为“时间段”和“组织单位”这两个标准维度的补充。
-
选择选项组并进行分配。可用选项组显示在左侧面板中。当前属于该选项组集的选项组显示在右侧面板中。
-
点击**保存**。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的功能,请参阅常用操作。
管理图例{ #mm_manage_legend }
关于传说{ #mm_about_legend }
您可以创建、编辑、克隆、共享、删除图例,查看图例详情并进行翻译, 以便让您为用户设置的地图更具意义。您可以在**Maps**应用中 创建地图本身。
注意
连续图例必须包含结束和开始的图例项 具有相同值,例如:0-50和50-80。不设置图例 像这样的项目:0-50和51-80。这将在您的图例中造成空白。
创建或编辑图例{ #mm_create_legend }
注意
不允许在图例中留有空白。
不允许有重复的图例项。

-
打开**元数据管理**应用,然后在左侧边栏中点击**其他** > 图例。
-
点击**+ 新建**按钮。
-
In the Name field, type the legend name.
-
(可选)在 Code 字段中,分配一个代码。
-
创建您想在图例中包含的图例项:
-
选择**起始值**和**结束值**。
-
Select Number of legend items.
-
选择一种配色方案。
-
点击**创建图例项**。
Tip
Click the options menu to edit or delete a legend item.
-
-
(可选)添加更多图例项:
-
点击**+ 新建**按钮。
-
输入名称,然后选择一个开始值,一个结束值和一种颜色。
-
点击**确定**。
-
-
(可选)更改色阶。
-
点击颜色标尺可查看颜色标尺选项列表, 然后选择一个。
-
要自定义颜色标尺,请单击 + 新建 按钮。在 **编辑 图例项**对话框,单击色阶按钮并手动选择 颜色,或输入您的颜色值。
-
-
点击**保存**。
包含四个项目的最终图例如下所示:
表:图例示例项目
| 图例项 | 初始值 | 终值 |
|---|---|---|
| 较低 差 | 0 | 50 |
| 中 | 50 | 80 |
| 非常好 | 80 | 100 |
| 太高了 | 100 | 1000 |
为指标或数据元素分配图例{ #mm_assign_legend }
您可以在 元数据管理 应用中,在创建对象或编辑 对象时,为指标或数据元素分配图例。随后,当您在 地图 应用中选择该指标或数据元素时, 系统会自动选中已分配的图例。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”功能,请参阅 常用操作。
另见{ #mm_see_also_legend }
管理预测变量{ #mm_manage_predictor }
关于预测变量
预测变量定义如何从表达式生成聚合数据值 包含汇总和/或事件数据。预测值可以基于:
-
来自与预测值相同时期的数据,和/或
-
来自预测值之前期间的数据
同期数据{ #mm_data_from_the_same_period }
预测器可以使用与预测值相同周期的数据。 例如,您可以计算具有 通过使用预测器表达式,例如:数据元素的非零值:
if(#{ji7o0ILHuU2}!= 0,1,0) 当您在数据收集所在的组织单位层级运行此预测器时, 如果该数据元素在该组织单位下的值为 非零,则预测器会将预测值存储为 1;否则存储为 0。 (如果用于预测的数据元素不存储零值,则 为了节省空间,数据库中将不会存储零值。) 随后,您可以在更高层级的 组织单位中通过分析功能对该预测值进行求和,从而统计报告中 每个组织单位下具有非零值的组织单位数量。
以往期间的数据{ #mm_data_from_previous_periods }
当您指定汇总时,预测变量将使用以前期间的数据 函数,例如sum()或avg()。例如,以下生成器表达式 标识一个值,该值是平均值加上标准偏差的两倍 前期数据:
avg(#{ji7o0ILHuU2})+ 2 * stddev(#{ji7o0ILHuU2}) 同期及前期数据{ #mm_data_from_the_same_and_previous_periods }
预测表达式既可以访问与 预测同期数据,也可以访问前期数据,具体方式包括:在 聚合函数内访问前期数据,以及在任何聚合函数 之外访问同期数据。 例如,可以使用如下表达式 获取上一期间的某项余额(#{KOh02hHko7C} ), 再将其与本期间的净变动额(#{ji7o0ILHuU2} )相加, 从而得出本期间的余额:
sum(#{KOh02hHko7C})+#{ji7o0ILHuU2} 第一个数据值位于聚合表达式(sum)中,表示 它采样的是上一期间的数据(即使只有一个上一期间), 而第二个数据值未位于聚合函数中,表示它 引用的是同一期间的数据。
如果需要,可以在同一引用中引用预测变量的输出数据元素 预测变量的表达。例如,此示例中的表达式可以 用于预测一段时间内的余额,然后将该值与 下一个期间的变化以计算下一个期间的余额。 当预测变量跨多个期间运行时,将在以下期间处理这些期间 按时间顺序排列,可以使用较早时期的结果 作为以后的输入。
预测变量组织单位级别{ #mm_predictor_organisation_unit_levels }
您需要为预测变量的输出选择一个或多个组织单位级别。 预测变量生成的所有值都存储在组织单位的 您选择的级别。预测变量表达式中的每个项目都是值的总和 为该组织单位存储的信息(如果有的话)以及组织中存储的所有值 低于该单位(如果有)的单位。
注意
在配置预测变量时,必须选择一个或多个组织单位级别 将输出预测数据。如果未选择任何级别,则不会预测 将生成值。
警告
如果您想在分析报告中使用预测值或 其他预测,请勿选择多个组织单位级别。 当您选择多个级别时,较高级别的预测将 还包括在较低级别的预测中使用的任何数据。如果预测 随后从多个级别将其用于分析或表达式中 其他预测变量,这可能会导致重复计算,因为 较高级别的值包括较低级别的预测值。
如果您仅在验证规则中使用预测 值,则可以选择多个组织单位级别。例如,在疾病监测中, 如果实际值高于基于上一期间数据得出的该期间 预期值范围,系统会触发验证规则警报。 要实现这一点,您可以创建一个预测因子,用于计算前一期间数据的平均值加上两倍 标准差。您可以使用一条验证 规则,将该最高预期值与实际值进行比较。 您可以在多个层级运行预测因子和验证规则, 以检测不同的疫情爆发情景。在一种情景中,某一家 医疗机构的数据可能出现显著增长,超过其预期范围,但 该医疗机构所在的辖区可能并未超过其预期范围, 因为辖区的数据是与许多其他医疗机构合并计算的。 而在另一种情景下,可能有几家 设施出现适度增长,虽然未超过各设施的预期范围(因为 各设施的标准差可能较高),但确实超过了 该区的预期范围(因为 整个区的标准差可能较低)。
如果您希望在多个层级生成预测,也可以 在不同层级使用不同的预测因子。例如,您可能希望 当某个层级的数值超过平均值加两倍标准 差时触发警报,但在另一个层级,当数值超过平均值加1.8倍 标准差时触发警报。 如果需要,您可以将不同的预测器 配置为使用相同的输出数据元素。如果使用相同的输出数据元素, 这在不同组织单位层级的验证规则中仍然有效, 但您必须注意不要将这些结果用于分析或其他 预测器计算,以避免重复计算。
在 元数据管理 应用程序中,您可以管理以下预测变量对象:
表:元数据管理应用中的预测变量对象
| CSV元数据导入 { #webapi_csv_metadata_import } | 可用功能 |
|---|---|
| 选项 | 创建、编辑、克隆、删除、查看详情和翻译 |
抽样前期
预测变量可以生成过去一段时间的数据值, 现在或将来。这些值基于预测期间的数据, 和/或来自预测时期之前的时期的采样数据。
如果您只需要进行预测的同一时期的数据, 那么您无需阅读本节。本节介绍如何 从预测周期之前的周期中采样数据。
有三个字段用于控制采样哪些先前期间——连续采样数量、 年度采样数量**和**连续跳过数量——而第四个字段 采样跳过测试,则可用于排除原本会被包含在内的个别期间。 它们共同出现在预测变量的“逻辑”部分中:

本节的其余部分将说明每项功能的作用。在图中,待 预测的周期用一种颜色标出,而用于采样的周期则用另一种颜色标出。
顺序样本计数{ #mm_sequential_sample_count }
预测变量的“顺序样本计数”指应抽取的紧邻 先前周期的数量。例如,如果预测变量的周期类型为 每周,且*顺序采样计数*为4,则表示需采样 预测值所在周之前紧邻的四个星期。因此, 第9周的预测值将使用第5、6、7和8周的样本:

如果预测变量的周期类型为 每月,且 连续样本 数量 为 4,这意味着要从紧邻预测值所在月份之前的 前四个月中抽取样本。因此,5 月份的预测值 将使用来自 1 月、2 月、3 月和 4 月的样本:

“连续采样次数”可以大于一年中的 周期数。例如,如果您想对预测值所在月份之前的 24个月进行采样,请将“连续采样次数” 设置为 24:

顺序跳过计数{ #mm_sequential_skip_count }
预测变量的*顺序跳过计数*指在 顺序样本数 范围内,应跳过多少个时段。例如,在疫情 监测中,可利用此功能跳过一个或多个紧邻预测值之前的样本,因为这些样本 实际上可能包含您 正试图检测的疫情起始阶段的数据。
例如,如果*顺序采样计数*为 4,但*顺序 跳过计数*为 2,那么位于 预测周期之前的两个采样点将被跳过,结果只有两个周期被 采样:

年度样本数量{ #mm_annual_sample_count }
预测变量的*年度样本数量*指应在同一时间段内收集样本的 过去年份数量。例如,这可用于 疾病监测,特别是在 该疾病的预期发病率在一年中有所波动,且最适宜 与往年同一相对时段进行比较的情况下。 例如, 如果*年度样本数量*为2(且*顺序样本数量*为 零),则将从紧邻 前两年的相同时间段内采集样本。

顺序样本计数与年度样本计数的总和{ #mm_sequential_annual_sample_count }
您可以将连续采样和年度采样相结合,从过去若干年的多个连续时段中采集 样本。 这样做时,系统将从以往各年的 与预测值期间相同的时间段内采集样本,同时 还会根据*顺序样本计数*的数值, 从该时间段之前和之后的各年采集样本。
例如,如果*连续样本数*为 4,而*年度 样本数*为 2,则将从预测值时段之前的 4 个时段 中采集样本。此外,还将 从前 2 年中对应时段以及 该时段前后各 4 个时段中采集样本:

顺序抽样、年度抽样和跳样抽样的样本数总和{ #mm_sequential_annual_skip_sample_count }
您可以将“顺序跳过期数”与顺序和 年度样本期数结合使用。此时,“顺序跳过期数” 表示在与预测值所属期间 同一年度内应跳过多少个期间。 例如,如果*顺序抽样计数*为 4,而 *顺序跳过计数*为 2,则预测值期间 之前的两个期间将被跳过,但再往前的两个期间 将被抽样:

如果 顺序跳过计数 等于或大于 顺序采样计数,则不会对包含预测值时段的 该年进行采样;仅对过去各年的 时段进行采样:

跳过测试示例{ #mm_sample_skip_test }
您可以使用* Sample skip test *(样本跳过测试)来跳过某些时段的样本 根据测试结果, 在那些时期内表达。例如,可以在 疾病暴发检测,样本跳过测试可以识别 以前的疾病暴发,将那些样本从预测中排除 非爆发基准期望值。
- Sample skip test *是一个应返回值的表达式 是或否,表示是否应跳过该时间段。 它可以是一个测试上一时期中任何数据值的表达式。 例如,它可以测试是否有明确输入的数据值 表示应跳过上一个期间。或者可以 将一段时间内的先前预测值与实际值进行比较 记录该时间段,以确定是否应跳过该时间段。
*样本跳过测试*为*真*的任何时期都不会 采样。例如:

预测变量与类别选项组合(细分){ #predictors-and-category-option-combinations-disaggregations }
预测变量输出数据的类别选项组合(分解) 可通过以下三种方式之一进行选择:
- 默认的分类选项组合。
如果预测变量的输出数据元素没有细分(类别组合为“无”, (也称为默认类别组合),那么所有预测变量的输出数据都将以 默认的类别选项组合。在这种情况下,预测变量的输出数据不会被拆分。
- 修复了分类选项的组合问题
如果预测变量的输出数据元素的类别组合不是“无”,则可以 为预测变量“输出类别下拉菜单”选择一个固定的分解方式。如果这样做, 该预测模型的所有输出都将包含这一类别选项组合。
例如,如果输出数据元素的类别组合是“性别和年龄”,则可以 决定将所有预测变量的输出映射到某个类别选项组合,例如“5岁以下女性”, “5–10号公件”,或其他任何规格。
- 使用“输入类别”下拉菜单(v40.1及后续版本中提供)
如果预测变量的输出数据元素的类别组合不是“无”,您可以选择 将“根据输入类别选项组合进行预测”设为“输出类别选项组合”的值。 如果这样做,输出数据元素中的每个类别选项组合都会生成不同的预测结果。 类别组合(即,一个预测为“5岁以下女性”,另一个预测为“5岁以下男性”, “5至10岁女性”占三分之一,以此类推)。
(在 v40.1 版本中,通过在“输出类别选项下拉菜单”中选择“\<no value> ”即可启用此功能。)
> **Tip**
>
> In some installations, the options in a category may have changed over time.
For example, a category "Age" may have had three options "1-5", "6-10", and "over 10",
but then was changed to only have two options "10 and under" and "over 10".
Historical data may have values with any of these options.
To use a predictor with such data, you can define another category
such as "Reporting Age" with all the options ever used, such as "1-5", "6-10",
"10 and under", and "over 10". Use this category in the category combination
for the predictor's output data element. This means that all the input category
options will be reflected in the output.
>
> If you then want a single report for the output data that covers
all the disaggregations, you can use category option groups
in a category option group set. For example use a category option group
"10 and under" that contains category options "1-5", "6-10", and "10 and under".
预测变量与属性选项组合{ #predictors-and-attribute-option-combinations }
如果预测的输入数据包含属性选项组合,则对于每个存在数据的属性选项组合, 系统都会生成不同的预测结果。
例如,您可以使用属性选项组合来表示系统中的不同项目。 当预测器找到项目 A 的输入数据时,它会生成一个具有项目 A 属性选项组合的值; 当它找到项目 B 的输入数据时,它会生成一个具有项目 B 属性选项组合的值; 以此类推。
对于任何不包含属性选项组合的输入数据(换言之,采用 默认属性选项组合的数据),将使用默认 属性选项组合生成预测结果。如果您在数据中未使用属性选项组合, 则预测输出数据中也不会使用这些组合。
如果您同时使用了属性选项组合和“根据输入类别选项组合进行预测”功能, 则针对每种细分方式与属性选项组合的组合,都会生成一个单独的预测结果。 例如,可能会针对项目 A 的“5岁以下女性”数据生成一个预测结果,针对 项目 A 的“5岁以下男性”数据生成一个预测结果,针对项目 B 的“5岁以下女性”数据生成一个预测结果,以此类推。
创建或编辑预测变量{ #mm_create_predictor }
-
打开**元数据管理**应用,然后在左侧边栏中点击**指标和预测因子** > 预测因子。
-
点击**+ 新建**按钮。
-
In the Name field, type the predictor name.
-
在**“简短名称”**字段中,输入该预测变量的简短名称。
-
(可选)在 Code 字段中,分配一个代码。
-
(可选)输入**说明**。

-
选择一个 输出数据元素。由该元素生成的值 预测变量存储为与此数据关联的聚合数据 元素和预测周期。
该值根据数据的值类型四舍五入 元素:如果值类型是整数类型,则预测值 舍入到最接近的整数。对于所有其他值类型, 数字四舍五入到四位有效数字。 (但是,如果有 小数点左边多于四位数,它们不是 替换为零。)
-
(可选)选择一个**“输出类别”下拉菜单**。此下拉菜单仅显示 如果所选数据元素的类别组合不是“无”。 如果是这样,您可以选择希望输出到哪个细分类别选项下拉列表中, 或者,您可以选择“根据输入类别下拉菜单进行预测”选项(参见上文讨论)。
-
Select a Period type.
-
指定一个或多个**组织单位级别**。输出值将为 分配给此级别(或这些级别)的组织单位。 对于**汇总**数据,输入值取决于下文所述的**提供数据的组织单位**设置。 对于基于**跟踪器**的数据,输入值来自该 分配了输出,或从输出下方的任何较低级别进行分配 组织单位。
-
**提供数据的组织单位**控制着**汇总**数据的输入值来源。如果选择“仅限所选级别”,则仅包含所选级别的组织单位。 如果选择“在所选层级及以下所有层级”,则不仅包括所选层级的组织单位,还包括其下属的所有组织单位。
-
创建一个**生成器**。生成器是用于计算预测值的表达式。

“编辑生成器表达式”对话框,其中显示了表达式编辑器以及“运算符”、“数据元素”、“程序数据”、“组织单位计数”、“常量”和“报告率”面板 -
Type a Description of the generator expression.
-
选择一种 缺失值处理策略。这将决定系统是否对 当生成器所引用的部分数据缺失时,该生成器表达式根本无法运行。
选项 说明 若有任何值缺失则跳过 如果构成该表达式的任何值缺失,则不会对该表达式进行求值,因此也不会预测任何值。这是默认选项。 若所有值均缺失,则跳过 只有当构成该表达式的*所有*值均缺失时,该表达式才不会被求值。如果至少有一个值存在,则该表达式将被执行,且缺失的值将被视为零。 绝不跳过 该表达式总是会被求值,且每个缺失值均被视为零。 该策略决定了该表达式是否执行。这与 该表达式在运行时对缺失值会进行如下处理:
情况 若有缺失值则跳过 若所有值均缺失则跳过 绝不跳过 唯一被引用的项目缺失 未预测值 未预测值 视为 0 有一项缺失,其余项有值 未预测值 将缺失项视为 0 将缺失项视为 0 isNull( item )(其中 item 不存在)从未被求值 truetrueisNotNull( item )(其中 item 缺失)从未被求值 falsefalsefirstNonNull( item, fallback )其中 item 缺失从未被求值 返回 fallback返回 fallbackNote
A missing value and a zero are not the same thing. DHIS2 does not store zeros for a data element unless Store zero data values is switched on for it, so a field that looks like it holds zero may hold no value at all. If your expression needs to tell "reported zero" apart from "not reported", test with
isNull()and use Skip if all values are missing or Never skip — under Skip if any value is missing the expression never runs, so the test can never fire. -
输入生成器表达式。您可以通过以下方式构建表达式 为汇总数据选择数据元素、程序数据元素、 属性或指标、组织单位数量、常量或 报告率。
要使用过去的采样数据,应将选择的所有项目包含在以下聚合函数之一中(请注意,这些函数名区分大小写):
聚合函数 均值 avg(x) x 的平均值(均值) count(x) x 的取值个数 max(x) x 的最大值 median(x) x 的中位数 min(x) x 的最小值 percentileCont(p, x) x 的连续百分位数,其中 p 是介于 0 和 1 之间的浮点数,表示百分位数。 例如,p = 0 将返回最小值,p = 0.5 将返回中位数,p = 0.75 将返回第 75 百分位数,p = 1 将返回最大值,以此类推。连续意味着在必要时会对该值进行插值。 例如,如果数据元素 FTRrcoaog83 的采样值为 1、2、3 和 4,则 percentileCont( 0.5, #{FTRrcoaog83} ) 将返回 2.5。 stddev(x) x 的标准差。该函数与 stddevSamp 等效。为使代码更清晰,建议改用 stddevSamp 函数。 stddevPop(x) x 的总体标准差:sqrt( sum( (x - avg(x))^2 ) / n ) stddevSamp(x) x 的样本标准差:sqrt( sum( (x - avg(x))^2 ) / ( n - 1 ) )。请注意,当只有一个样本时不会计算此值。 sum(x) x 的取值之和 Note
Any items inside an aggregate function will be evaluated for all sampled past periods, and then combined according to the formula inside the aggregate function. Any items outside an aggregate function will be evaluated for the period in which the prediction is being made.
您可以通过单击(或 输入)表达式字段下方的任何元素: () * / +-天数。 可以通过键入常数来添加常数。那些日子 选项将 [days ]插入到解析为 数据来源期间的天数。
您还可以在您的计算机中使用以下非聚合函数 表达式,在聚合函数内部或包含 聚合函数,或独立于聚合函数:
功能 含义 contains(expr, sub1, ...) 在表达式中搜索一个或多个子字符串。 如果表达式包含所有子字符串,则返回 true。例如,以下表达式均返回 true:contains("abcd", "abcd");contains("abcd", "b");以及 contains("abcd", "ab", "bc")。比较操作区分大小写。 containsItems(expr, item1, ...) 在表达式中搜索一个或多个项目。该表达式由以逗号分隔的元素组成。如果每个项目都与表达式中的某个元素完全匹配,则 containsItems 返回 true。 例如,containsItems("abcd", "abcd") 和 containsItems("ab,cd", "ab", "cd") 的结果为 true,但 containsItems("abcd", "b") 和 containsItems("abcd", "ab", "bc") 返回 false。比较操作区分大小写。containsItems 可用于多值数据元素,以检查某项是否包含在数据元素的值中。 if(test, valueIfTrue, valueIfFalse) 评估 test,该表达式计算结果为布尔值——请参见下方的 布尔表达式说明。 如果测试结果为 true,则返回 valueIfTrue 表达式;如果为 false,则返回 valueIfFalse 表达式。 is(expr1 in expression [, expression ...]) 如果 expr1 与以下任一表达式相等,则返回 true;否则返回 false。 isNull(item) 如果 item 为空(缺失),则返回布尔值 true;否则返回 false。item 可以是右侧选中的任何项目(数据元素、程序数据元素等)。 isNotNull(item) 如果 item 的值不为空(非空),则返回 true,否则返回 false。 firstNonNull(item [, item ...]) 返回第一个不缺失(非空)的 item 的值。可以提供任意数量的参数。任何参数也可以是数值或字符串字面量,如果所有前面的项都存在缺失值,则返回该参数的值。 greatest(表达式 [, 表达式 ...]) 返回给定表达式中的最大(最高)值。可以提供任意数量的参数。 least(表达式 [, 表达式 ...]) 返回给定表达式中的最小值。可以提供任意数量的参数。 log(表达式 [, 底数 ]) 返回数值表达式的自然对数(底数为 e)。如果将一个整数作为第二个参数传入,则返回以该底数为底的对数。 log10(表达式) 返回数值表达式的常用对数(以10为底)。 normDistCum(x [,mean [,stddev]]) 根据由均值和标准差描述的归一化分布,返回 x 的累积分布函数 (CDF) 值。等同于 Excel 中的 NORM.DIST(x,mean,stddev,TRUE) 或 LibreOffice 中的 NORMDIST(x,mean,stddev,1)。 如果未指定 stddev,则根据 x 的历史采样值计算该值。如果既未指定 mean 也未指定 stddev,则根据 x 的历史采样值计算这两个参数。请参阅示例。 normDistDen(x [,mean [,stddev]]) 返回给定均值和标准差所描述的归一化分布下,x 的概率密度函数 (PDF) 值。等同于 Excel 的 NORM.DIST(x,mean,stddev,FALSE) 或 LibreOffice 的 NORMDIST(x,mean,stddev,0)。 如果未提供 stddev,则根据 x 的历史采样值计算该值。如果既未提供 mean 也未提供 stddev,则根据 x 的历史采样值计算这两个参数。请参阅示例。 null 不返回任何结果。例如,if( #{FH8ab5Rog83} <0, null, 1 ) 在数据元素值小于 0 时不返回任何结果,否则返回 1。 orgUnit.ancestor(orgUnitUid [, orgUnitUid ...]) 如果该组织单位是其中任意一个(一个或多个)组织单位的后代,则返回 true;否则返回 false。 orgUnit.dataSet(dataSetUid [, dataSetUid ...]) 如果该组织单位被分配给任意一个(一个或多个)数据集,则返回 true;否则返回 false。 orgUnit.group(ouGroupUid [, ouGroupUid ...]) 如果该组织单位是(一个或多个)组织单位组中的成员,则返回 true;否则返回 false。 orgUnit.program(programUid [, programUid ...]) 如果该组织单位被分配给了其中任何一个(1个或多个)项目,则返回 true;否则返回 false。 removeZeros(表达式) 如果表达式的值为 0,则不返回任何结果;否则返回该表达式的值。 .maxDate(yyyy-mm-dd) 对于数据元素(非程序数据),取截至最大日期(含)之前各期间的值。 .minDate(yyyy-mm-dd) 对于数据元素(非程序数据),指从指定最小日期起或之后各期间的值。 布尔表达式注释:**布尔表达式必须求值 设置为 **true 或 false。可使用以下运算符来 比较两个值,它们得出一个布尔表达式: <, >, \!=,==,> =和 <=。以下运算符可用于 组合两个布尔表达式:&& 或关键字 and(逻辑与),以及 || 或关键字 or (逻辑或)。可以使用一元运算符 ! 或关键字 not 来对一个 布尔表达式。
生成器表达式示例:
生成器表达式 含义 sum(#{FTRrcoaog83.tMwM3ZBd7BN}) 数据元素 FTRrcoaog83 与类别选项组合(细分)tMwM3ZBd7BN 的抽样值之和 avg(I{GSae40Fyppf}) + 2 * stddevSamp(I{GSae40Fyppf}) 程序指标 GSae40Fyppf 的样本值平均值加上其样本标准差的两倍 sum(D{IpHINAT79UW.eMyVanycQSC}) / sum([days]) 程序 IpHINAT79UW 中数据元素 eMyVanycQSC 的所有采样值之和,除以所有采样时段的天数(得出总体日均值) sum(#{FTRrcoaog83}) + #{T7OyqQpUpNd} 数据元素 FTRrcoaog83 的所有采样值之和,加上在被预测期间内数据元素 T7OyqQpUpNd 的值(包括所有细分) 1.2 * A{IpHINAT79UW.RKLKz1H20EE} 预测期间内,程序 IpHINAT79UW 的 RKLKz1H20EE 属性值的 1.2 倍 if(isNull(#{T7OyqQpUpNd}), 0, 1) 如果在预测期间内,数据元素 T7OyqQpUpNd 为空,则返回 0,否则返回 1 if(is(#{jeiTh8ahyae} in 'NEGATIVE','UNKNOWN'), 0, 1) 如果数据元素jeiTh8ahyae的值为'NEGATIVE'或'UNKNOWN',则返回0,否则返回1 percentileCont(0.5, #{T7OyqQpUpNd}) 数据元素 T7OyqQpUpNd 的采样值的连续第 50 百分位数。请注意,这与 median(#{T7OyqQpUpNd}) 相同 if(count(#{T7OyqQpUpNd}) == 1, 0, stddevSamp(#{T7OyqQpUpNd})) 如果数据元素 T7OyqQpUpNd 存在一个样本值,则返回 0;否则返回这些样本值的样本标准差。 (请注意,如果没有样本,则 stddevSamp 不会返回任何值,因此也不会进行预测。) normDistCum(#{T7OyqQpUpNd}) 数据元素 T7OyqQpUpNd 当前期间值的累积分布函数,该函数基于数据元素 T7OyqQpUpNd 过去抽样期间的均值和标准差所定义的归一化分布 normDistCum( #{T7OyqQpUpNd}, median(#{T7OyqQpUpNd}) ) 数据元素 T7OyqQpUpNd 当前期间值的累积分布函数,该函数基于数据元素 T7OyqQpUpNd 过去采样期间的中位数(而非均值)和标准差所定义的分布 normDistCum( #{T7OyqQpUpNd}, avg(#{T7OyqQpUpNd}), stddev(#{T7OyqQpUpNd}) ) 与 normDistCum( #{T7OyqQpUpNd} ) 相同 normDistDen( #{T7OyqQpUpNd}, avg(#{IKahz1Quie3}), stddev(#{IKahz1Quie3}) ) 数据元素 T7OyqQpUpNd 当前周期值的概率密度函数,该函数基于不同数据元素 IKahz1Quie3 过去采样周期的均值和标准差所定义的分布 normDistDen( median(#{T7OyqQpUpNd}), avg(#{IKahz1Quie3}), stddev(#{IKahz1Quie3}) ) 数据元素 T7OyqQpUpNd 过去采样值的中位数的概率密度函数,该函数基于不同数据元素 IKahz1Quie3 过去采样时段的均值和标准差所定义的分布 #{T7OyqQpUpNd}.minDate(2022-10-1) 2022年10月1日或之后的值 #{T7OyqQpUpNd}.maxDate(2022-12-31) 2022年12月31日或之前的数值 #{T7OyqQpUpNd}.minDate(2022-10-1).maxDate(2022-12-31) 2022年10月1日至2022年12月31日之间的值
-
-
(可选)创建一个 示例跳过测试。该示例跳过测试用于说明 从样本中排除哪个先前时段(如果有)。
-
Type a Description of the skip test.
-
输入样本跳过测试表达式。您可以建立 与生成器表达式来自同一项的表达式。作为 使用该生成器时,您可以点击(或输入)任意一个 表达式字段下方的符号:( ) * / + - 天。
上述针对生成器表达式描述的非聚合函数也可以使用 在跳过测试中。
该表达式的计算结果必须为布尔值** true 或 **false。参见上文的**布尔表达式说明**。
跳过测试表达式示例:
跳过测试表达式 均值 #{FTRrcoaog83} > #{M62VHgYT2n0} 数据要素 FTRrcoaog83(所有细分数据的总和)的值大于数据要素 M62VHgYT2n0(所有细分数据的总和)的值 #{uF1DLnZNlWe} > 0 数据元素 uF1DLnZNlWe 的值(所有细分项之和)大于零 #{FTRrcoaog83} \> #{M62VHgYT2n0}
-
-
Enter a Sequential sample count value.
这是计算应该进行多少个连续周期 及时返回样本数据进行计算。
-
Enter an Annual sample count value.
这是计算应该追溯到多少年 用于计算的样本数据。
-
(Optional) Enter a Sequential skip count value.
这是紧接在 采样值之前,应跳过预测值周期。
-
点击**保存**。
Data Element Group 的预测{ #mm_predictions_by_data_element_group }
您可以使用一个预测因子来处理组中的所有数据元素,而无需为每个数据元素分别使用不同的预测因子。例如,在物流管理中,当每个商品使用一个数据元素,且与该商品相关的每个计数都采用一种类别选项组合时,即可采用这种方法。
语法如下:
forEach ?de in :DEG:degUid --> 主表达式
其中:
| 部分 | 自定义查询。 |
|---|---|
| forEach | 表达式开头必须包含该关键字 |
| ?de | 任何以“?”开头,后跟一个字母,然后可选地跟任意数量的其他字母或数字(区分大小写)的变量名。示例:?de、?X、?dataElement 等。 |
| 描述 | 必填关键词 |
| :DEG:degUid | 符号 :DEG: 后跟包含待处理数据元素的数据元素组的 UID |
| -> | 在主表达式之前必须出现 |
| 主要表达式 | 用于处理组中每个数据元素的表达式。在此表达式中,请将变量名(例如 ?de)用作每个数据元素的占位符 |
对于数据元素组中的每个数据元素,预测器都会执行一次。 对于每个数据元素,主表达式中该变量的实例将被该数据元素替换。该数据元素同时也将作为预测器的输出数据元素。 预测值将使用配置好的输出类别选项组合写入该数据元素。
预测器必须配置一个输出数据元素,但在运行预测器时,该数据元素实际上会被忽略。 建议您为预测器配置该预测器将要使用的数据元素组中的某个数据元素。 这样,您就可以为该数据元素选择一个有效的输出类别选项组合。
在创建预测器时,数据元素组中必须至少包含一个您将要使用的类型的数据元素。(在对预测器进行语法检查时,会用到该数据元素的数据类型。)
示例 1{ #example-1 }
您拥有一些代表各种商品的数据元素,它们都属于一个数据元素组,该组的UID为aIMu0nieph7 。
您有以下 UID 的分类选项组合:
| 类别下拉菜单 | 自定义查询。 |
|---|---|
Gvoecom5muL | 期初库存余额 |
CWa6eew5uco | 期间内补货 |
nthohhie8Ba | 经期使用 |
Faey8Iphooy | 在该期间内丢失、损坏、过期或被盗 |
以下预测器生成器表达式将按以下公式计算下个期间初的库存余额:(期初余额 + 补货量 - 消耗量 - 损耗量):
forEach ?de in :DEG:aIMu0nieph7 -->
sum( #{?de.Gvoecom5muL} + #{?de.CWa6eew5uco} - #{?de.nthohhie8Ba} - #{?de.Faey8Iphooy} )
预测模型的配置包括:
| MCC | 日期时间 |
|---|---|
| 输出数据元素 | 该组中的一个数据元素 |
| 输出类别下拉菜单 | 期初库存余额(Gvoecom5muL ) |
| 提供数据的组织单位 | 仅限选定级别 |
| 顺序样本计数 | 1 |
| 年度样本数 | 0 |
预测器将针对数据元素组中的每个数据元素执行一次。由于预测器生成器表达式中使用了聚合函数sum() ,因此表达式中的所有值都将从上一期间获取(因为顺序样本计数为 1)。 该预测器将为所选层级的组织单位,在预测器运行起止日期范围内的各期间,写出每个数据元素的期初余额。
预测总是面向未来进行的。某一期间预测的期初余额可作为输入,用于计算下一期间的期初余额。
示例 2{ #example-2 }
如果你想对与输入数据相同的期间进行预测,只需省略聚合函数,例如:sum() 。在之前的示例基础上,假设你还有另一组类别选项组合,用于计算该期间内的净库存变动:
| 类别下拉菜单 | 自定义查询。 |
|---|---|
Hpiek8IefoS | 期内库存变动 |
您可以使用以下表达式计算库存变动量,即(补货 - 消耗 - 损耗):
forEach ?de in :DEG:aIMu0nieph7 -->
#{?de.CWa6eew5uco} - #{?de.nthohhie8Ba} - #{?de.Faey8Iphooy}
输出类别下拉列表选项如下:
| MCC | 日期时间 |
|---|---|
| 输出类别下拉菜单 | 期内库存变动情况(Hpiek8IefoS ) |
由于表达式中的各项周围没有诸如sum() 之类的聚合函数,因此输入数据取自与预测输出相同的期间。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的功能,请参阅 常用操作。
创建或编辑预测变量组{ #mm_create_predictor_group }
-
打开**元数据管理**应用,然后点击**指标和预测因子** > 左侧边栏中的**预测变量组**。
-
点击**+ 新建**按钮。
-
Type a Name. This field needs to be unique.
-
(可选)在**代码**字段中,分配一个代码。该字段需要 独一无二。
-
(可选)输入**说明**。
-
Double-click the Predictors you want to assign to the group.
-
点击**保存**。
有关“显示详细信息”、“共享设置”、“翻译”、“删除”和“克隆”的操作,请参阅 常用操作。预测器组支持与单个预测器相同的操作,包括 立即运行。
管理推送报告{ #mm_manage_push_report }
注意
“元数据管理”应用中不提供推送报告功能。如果您的 DHIS2 实例仍在使用推送报告, 请在旧版“维护”应用中进行配置——请参阅 管理推送报告。
管理外部地图图层{ #mm_manage_external_maplayer }
注意
外部地图图层的管理功能计划迁移至 地图 应用,且不会在元数据管理应用中重复实现。您仍可在旧版维护应用中配置外部地图图层——请参阅 管理外部地图图层。
管理 SQL 视图{ #mm_manage_sql_view }
DHIS2的SQL View功能将存储SQL视图定义 内部,然后在需要时实例化视图。
数据库管理员在创建数据库视图时必须小心 直接在DHIS2数据库中。例如,当资源表 生成,所有这些都将首先被删除然后重新创建。如果 任何SQL视图都依赖于这些表,完整性违规异常 将被抛出并且该过程将被中止。
SQL视图基于它们的反向字母顺序删除 DHIS2中的名称,并按常规字母顺序创建。这允许 您要在SQL视图之间具有依赖关系,因为视图仅取决于 其他按字母顺序排列的观点。对于 例如,“ ViewB”可以安全地依赖于“ ViewA”。否则,有意见 取决于其他视图会导致完整性违规错误。
创建一个新的SQL视图
要创建一个新的 SQL 视图,请打开 元数据管理 应用,在左侧边栏中点击 其他 > SQL 视图,然后点击 + 新建 按钮。

SQL 视图的“名称”属性将用于确定 当用户将该视图实例化时,DHIS2 将创建的 表的名称。“描述”属性允许用户提供一些说明性 文本,说明该 SQL 视图的实际功能。
“SQL 类型”属性允许创建三种视图: - “视图”存储在数据库中,并在查询时重新生成 - “物化视图”存储在数据库中,其结果 已缓存到数据库中 - “查询”不会存储在数据库中
最后,“SQL 查询”中应包含该 SQL 视图的定义。
仅允许使用 SQL “SELECT” 语句,且某些敏感表 (例如用户信息)不可访问。
点击“保存”以存储 SQL 视图定义。如果您创建的是“视图” 或“物化视图”,还必须执行 运行查询 以完成 SQL 视图的创建。
请注意,所用 SELECT 语句返回的列 将成为表列,这意味着它们必须是有效的表列 类型。使用函数时,可能需要通过在函数后添加 ::{TYPE} 来显式地将 结果强制转换为某种类型。
例如,与其使用 jsonb_each(该函数会返回一种记录类型, 而该类型无法作为列类型),不如使用 jsonb_each_text,并将结果 强制转换为 text,如下例所示:
select jsonb_each_text(eventdatavalues)::text from ...
调用其他 SQL 视图的 SQL 视图{ #sql-views-that-call-other-sql-views }
如果您希望创建一个可被其他 SQL 视图调用的 SQL 视图, 则其 SQL 类型 必须为“视图”或“物化视图” (而非“查询”)。此外,在调用该视图之前, 必须先对其执行 运行查询 操作。
例如,如果你创建了一个名为 数据元素计数 的视图,其 SQL 类型为“视图”,且 SQL 语句如下:
select count(*) as count from dataelement;
...然后,您可以从选项菜单中执行“运行查询”,并 使用以下 SQL 语句创建一个名为“超过 100 个数据元素”的第二个 SQL 视图:
select case when count > 100 then 1 else 0 end as result from _view_data_element_count;
SQL视图管理
要使用 SQL 视图,只需单击该视图,然后从 选项菜单中选择 运行查询。过程完成后, 系统会提示您已创建了一张表。 系统将显示该表的 名称,该名称由 SQL 视图定义中提供的“描述”属性 生成。视图生成后, 您可以通过再次单击该视图并选择 查看 结果 来查看其内容。
关于“克隆”,请参阅 常用操作。
提示
如果您有一个视图依赖于另一个视图,请注意 视图的命名方式。当在 DHIS2 服务器上运行分析时,所有视图都会 被删除然后重新创建:它们会按字母顺序的*反向*顺序 被删除,并按*常规*字母顺序重新创建。 因此,一个视图在字母顺序上必须*排在* 其所依赖的视图之后——例如,“ViewB”可以安全地依赖 “ViewA”。如果命名顺序相反,分析可能会失败,因为 当被依赖的视图被重新创建时,该依赖关系尚未建立。
管理分析表挂钩{ #mm_manage_analytics_table_hooks }
DHIS2 的“分析表挂钩”功能用于存储在 分析表生成过程的不同阶段运行的 SQL 代码。
另请参阅开发者文档中的 /api/analyticsTableHooks 。
创建一个新的分析表挂钩{ #creating-a-new-analytics-table-hook }
要创建一个新的分析表挂钩,请打开**元数据管理**应用, 在左侧边栏中点击**其他** > 分析表挂钩,然后点击 **+ 新建**按钮。
点击“保存”以保存分析表挂钩。
管理语言环境{ #mm_manage_locale_management }
可以在DHIS2中创建自定义语言环境。除了 系统提供的语言环境,您可能需要添加自定义 系统的语言环境(例如“英语”和“赞比亚”)。这将允许 您可以将元数据对象翻译成本地语言,或解决 使用共同元数据的国家之间的细微差异 定义。
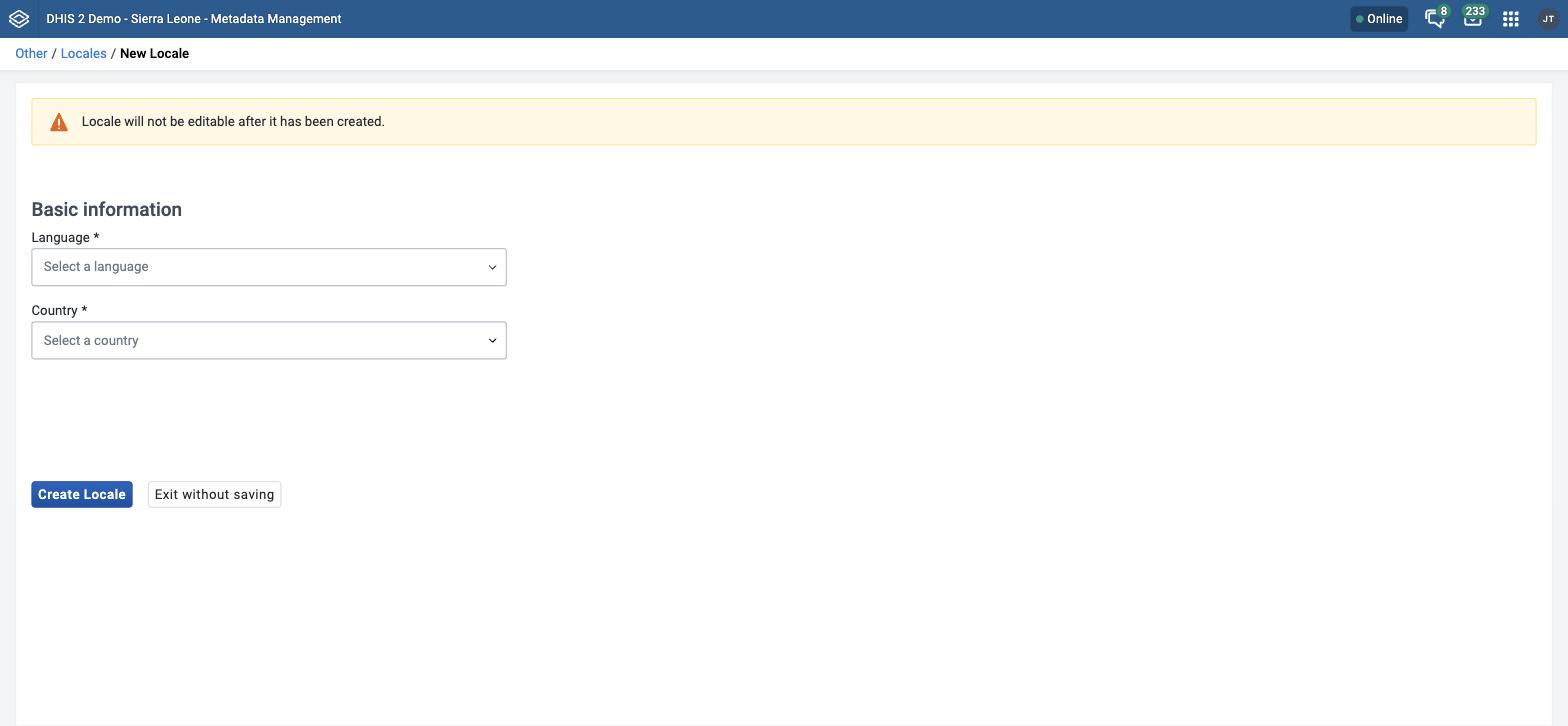
区域设置由一种语言和一个国家组成。打开 元数据管理 应用,在 左侧边栏中点击 其他 > 区域设置,然后点击 + 新建 按钮。 选择所需的值, 然后点击 创建语言环境。此自定义语言环境现将作为 系统中的翻译语言环境之一供使用。
注意
区域设置一旦创建,就无法编辑。
管理群组成员资格{ #mm_edit_multiple_object_groups }
旧版的“维护”应用有一个独立的**元数据组编辑器**界面,用于批量将 对象添加到组中。“元数据管理”应用中没有相应的 界面,且暂无添加该界面的计划。 取而代之的是,无论您正在处理关系 的哪一侧,均可通过标准的 转移列表 来编辑组成员关系:
- 将一个对象分配到多个组中 — 打开该对象的编辑界面,将其分配到 那里的组。例如,**数据元素组**字段在 创建或编辑数据元素 会将一个数据元素放入 可以根据需要创建任意数量的数据元素组,且无需离开该数据元素。
- 将多个对象合并到一个组中 — 打开该组的编辑界面,并指定组内成员 那里。例如,创建或编辑数据元素组 在一次迭代中,将任意数量的数据元素分配给单个组。
本章中其他分组对象类型也遵循同样的模式:类别 选项组、指标组、组织单位组、选项组和预测变量 组,以及它们对应的组集。
要查看或更改当前处于某个组中的对象,请从 左侧边栏打开该组的列表——例如 数据元素 > 数据元素组——然后编辑 所需的组。
提示
将成员分配到组时,请在“可用”列表上方(如有显示)勾选 仅显示未分配的项目 复选框,以隐藏那些已 属于同一类型其他组的对象。参见 使用转移列表组件。