
DHIS2 Documentation Team
Copyright © 2008-2023 DHIS2 Team
source.revision.date: 2026-06-16
Warranty: THIS DOCUMENT IS PROVIDED BY THE AUTHORS ‘’AS IS’’ AND ANY EXPRESS OR IMPLIED WARRANTIES, INCLUDING, BUT NOT LIMITED TO, THE IMPLIED WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE ARE DISCLAIMED. IN NO EVENT SHALL THE AUTHORS OR CONTRIBUTORS BE LIABLE FOR ANY DIRECT, INDIRECT, INCIDENTAL, SPECIAL, EXEMPLARY, OR CONSEQUENTIAL DAMAGES (INCLUDING, BUT NOT LIMITED TO, PROCUREMENT OF SUBSTITUTE GOODS OR SERVICES; LOSS OF USE, DATA, OR PROFITS; OR BUSINESS INTERRUPTION) HOWEVER CAUSED AND ON ANY THEORY OF LIABILITY, WHETHER IN CONTRACT, STRICT LIABILITY, OR TORT (INCLUDING NEGLIGENCE OR OTHERWISE) ARISING IN ANY WAY OUT OF THE USE OF THIS MANUAL AND PRODUCTS MENTIONED HEREIN, EVEN IF ADVISED OF THE POSSIBILITY OF SUCH DAMAGE.
License: Permission is granted to copy, distribute and/or modify this document under the terms of the GNU Free Documentation License, Version 1.3 or any later version published by the Free Software Foundation; with no Invariant Sections, no Front-Cover Texts, and no Back-Cover Texts. A copy of the license is included in the source of this documentation, and is available here online: http://www.gnu.org/licenses/fdl.html
L'API Web est un composant qui permet aux systèmes externes d'accéder aux données stockées dans une instance DHIS2 et de les manipuler. Plus précisément, elle fournit une interface programmatique à un large éventail de données exposées et de méthodes de service pour des applications telles que des clients logiciels tiers, des portails web et des modules DHIS2 internes.
L'API Web adhère à de nombreux principes du style architectural REST. Pour n'en citer que certains, importants :
L'API Web DHIS2 prend en charge trois protocoles d'authentification :
Verify and get information about the currently authenticated user by making a GET request to the following endpoint.
GET /api/me
Get the list of authorities for the currently authenticatd user.
GET /api/me/authorization
Check whether the currently authenticated user has the given authority.
GET /api/me/authorization/{authority}
For example, to check whether the user has the F_CONSTANT_ADD authority.
GET /api/me/authorization/F_CONSTANT_ADD
The response will be either true or false in JSON format.
L'API Web DHIS2 prend en charge l'authentification de base. L'authentification de base est une technique qui permet aux clients d'envoyer des informations d'identification par HTTP à un serveur web. Techniquement parlant, le nom d'utilisateur est suivi de deux points et le mot de passe, encodé en Base64, est préfixé par Basic et fourni en tant que valeur de l'en-tête HTTP Authorization (autorisation). De manière plus formelle, il s'agit de :
Authorization: Basic base64encode(nom d'utilisateur:mot de passe)
La plupart des environnements de développement compatibles avec les réseaux prennent en charge l'authentification de base, comme Apache HttpClient et Spring RestTemplate. Il est important de noter que ce schéma d'authentification n'offre aucune sécurité puisque le nom d'utilisateur et le mot de passe sont envoyés en texte clair et peuvent être facilement observés par un pirate. L'utilisation de Basic n'est recommandée que si le serveur utilise SSL/TLS (HTTPS) pour crypter la communication avec les clients. Ceci est un impératif, afin de garantir des interactions sécurisées avec l'API Web.
DHIS2 prend en charge l'authentification à deux facteurs. Cette fonction peut être activée pour chaque utilisateur. Lorsque cette option est activée, les utilisateurs sont invités à saisir un code 2FA lorsqu'ils se connectent. Pour en savoir plus sur l'authentification à deux facteurs, cliquez [ici] (https://www.google.com/landing/2step/).
Les jetons d'accès personnels (PAT) sont une alternative à l'utilisation de mots de passe lors de l'authentification au système DHIS2 lorsque l'on utilise l'API.
Les jetons d'accès personnel peuvent être une alternative plus sécurisée à l'authentification de base HTTP et devraient être votre choix privilégié lorsque vous créez une nouvelle application, un script, etc.
L'authentification de base HTTP est considérée comme non sécurisée car, entre autres, elle envoie votre nom d'utilisateur et votre mot de passe de façon indiscrète. Il est possible qu'elle soit abandonnée dans les versions futures de DHIS2 ou qu'elle devienne facultative, ce qui signifie que l'authentification de base devra être explicitement activée dans la configuration.
Vos jetons d'accès personnel hériteront automatiquement de toutes les permissions et autorisations dont dispose votre utilisateur. Il est donc extrêmement important de limiter l'accès que vous accordez à votre jeton en fonction de l'utilisation que vous comptez en faire, voir Configurer votre jeton.
Si vous souhaitez que le jeton n'ait accès qu'à une partie restreinte et spécifique du serveur, il est plutôt recommandé de créer un nouvel utilisateur spécial auquel vous n'attribuerez que les rôles et autorisations auxquels vous souhaitez qu'il ait accès.
Pour créer un nouveau PAT, vous avez deux possibilités : * A. Créez un jeton dans l'interface utilisateur de la page de profil de votre compte. * B. Créer un jeton via l'API.
Connectez-vous avec votre nom d'utilisateur et votre mot de passe, allez sur votre page de profil (cliquez en haut à droite, et choisissez « Modifier le profil » dans le menu déroulant). Sur votre page de profil, choisissez « Jetons d'accès personnels » dans le menu à gauche. Vous devriez maintenant être sur la page « Gérer les jetons d'accès personnels » et voir le texte : « Vous n'avez pas de jetons d'accès personnels actifs ». Cliquez sur « Générer un nouveau jeton » pour créer un nouveau jeton. Une fenêtre contextuelle « Générer un nouveau jeton » s'affiche et vous propose deux choix :
"Ce type est utilisé pour les intégrations et les scripts qui ne seront pas accessibles par un navigateur".
Si vous prévoyez d'utiliser le jeton dans une application, un script ou autre, ce type de jeton devrait être votre choix.
"Ce type d'application est utilisé pour les applications, telles que les portails publics, auxquelles on accède à l'aide d'un navigateur web".
Si vous devez créer un lien vers DHIS2 sur une page web, ou par exemple l'intégrer dans une iframe, c'est probablement le type de jeton qu'il vous faut.
Après avoir choisi le type de jeton que vous désirez, vous pouvez configurer différentes contraintes d'accès à votre jeton. Par contrainte, nous entendons la manière de limiter et de restreindre l'utilisation de votre jeton. Cela peut être d'une importance cruciale si vous envisagez d'utiliser le jeton dans un environnement public, par exemple sur un tableau de bord public d'un autre site, intégré dans une iframe. Étant donné que les jetons ont toujours les mêmes accès/autorisations que ceux dont dispose actuellement votre utilisateur, il convient d'être particulièrement vigilant si vous avez l'intention de les utiliser dans un environnement que vous ne contrôlez pas à 100 %.
NB : Si quelqu'un d'autre met la main sur votre jeton, il peut faire tout ce que votre utilisateur est capable de faire. Il n'est pas possible de faire la distinction entre les actions effectuées à l'aide du jeton et les autres actions effectuées par votre utilisateur.
Important : Il est fortement conseillé de créer un utilisateur distinct et unique ayant uniquement les rôles/autorisations si vous envisagez d'utiliser les jetons PAT dans un environnement non sécurisé et/ou public, par exemple, sur un PC ou un serveur que vous ne contrôlez pas à 100 %, ou « intégré » dans une page web sur un autre serveur.
La durée d'expiration définit simplement la durée pendant laquelle vous souhaitez que votre jeton soit utilisable, le délai par défaut étant de 30 jours. Passé ce délai, le jeton renverra simplement un message 401 (non autorisé). Vous pouvez définir le délai d'expiration que vous souhaitez, mais il est fortement conseillé de définir un délai d'expiration raisonnable pour votre cas d'utilisation.
Il s'agit d'une liste d'adresses IP séparées par des virgules, à partir desquelles vous souhaitez limiter la provenance des requêtes de jetons.
Important: La validation de l'adresse IP repose sur l'en-tête X-Transféré-À, qui peut être usurpé. Pour des raisons de sécurité, assurez-vous qu'un équilibreur de charge ou un proxy inverse écrase cet en-tête.
Une liste de méthodes HTTP séparées par des virgules que vous souhaitez que votre jeton puisse utiliser. Si vous n'avez besoin de votre jeton que pour consulter des données, et non pour les modifier ou les supprimer, la sélection de la méthode GET HTTP est judicieuse.
Le référent HTTP est un en-tête ajouté à la requête lorsque vous cliquez sur un lien, il indique le site/la page sur lequel/laquelle vous étiez lorsque vous avez cliqué sur le lien. Pour en savoir plus sur l'en-tête du référent HTTP, cliquez sur le lien suivant : https://en.wikipedia.org/wiki/HTTP_referer
Cela peut servir à limiter l'utilisation d'un jeton « public » intégré à une autre page sur un autre site. S'assurer que l'en-tête du référent correspond au nom d'hôte du site d'où le jeton doit provenir peut éviter l'utilisation abusive du jeton, par exemple si quelqu'un le publie sur un forum public.
Important Ceci n'est pas une fonctionnalité de sécurité. L'en-tête référence peut être facilement usurpé. Ce paramètre est destiné à dissuader les développeurs tiers non autorisés à se connecter aux instances d'accès public.
Lorsque vous avez fini de configurer votre jeton, vous pouvez l'enregistrer en cliquant sur le bouton « Générer un nouveau jeton » en bas à droite de la fenêtre contextuelle. Le jeton sera alors sauvegardé et une clé secrète sera générée sur le serveur. La nouvelle clé secrète sera affichée en bas de la liste des jetons PAT sur fond vert, et le texte « Jeton nouvellement créé ». La clé du jeton secret ressemble à ceci :
d2pat_5xVA12xyUbWNedQxy4ohH77WlxRGVvZZ1151814092
Example of how to create a new Personal Access Token using the API:
POST /api/apiToken
Content-Type: application/json
Authorization: Basic admin district

{}
{}) dans la charge utile ! Il renverra une réponse contenant un jeton similaire à celui-ci :
{
  "httpStatus": "Created",
  "httpStatusCode": 201,
  "status": "OK",
  "response": {
     "responseType": "ApiTokenCreationResponse",
     "key": "d2pat_5xVA12xyUbWNedQxy4ohH77WlxRGVvZZ1151814092",
     "uid": "jJYrtIVP7qU",
     "klass": "org.hisp.dhis.security.apikey.ApiToken",
     "errorReports": []
  }
}
Note: The token key will only be shown once here in this response. You need to copy and save this is in a secure place for use later!
Le jeton lui-même se compose de trois parties : 1. Préfixe : (d2pat_) indique de quel type de jeton il s'agit. 2. Octets aléatoires codés en Base64: (5xVA12xyUbWNedQxy4ohH77WlxRGVvZZ) 3. Somme de contrôle CRC32 : (1151814092) la partie de la somme de contrôle est complétée par 0 de sorte qu'elle conserve toujours une longueur de dix caractères.
Pour modifier l'une des contraintes de votre jeton, vous pouvez envoyer la requête API HTTP suivante.
Note: Only the constraints are possible to modify after the token has been created.
PUT /api/apiToken/jJYrtIVP7qU
Content-Type: application/json
Authorization: Basic admin district
{
  "version": 1,
  "type": "PERSONAL_ACCESS_TOKEN",
  "expire": 163465349603200,
  "attributes": [
      {
        "type": "IpAllowedList",
        "allowedIps": ["192.168.0.1"]
      },
      {
        "type": "MethodAllowedList",
        "allowedMethods": ["GET"]
      }
  ]
}
To issue a request with your newly created token, use the Authorization header accordingly. The authorization header format is:
Autorisation : ApiToken [YOUR_SECRET_API_TOKEN_KEY]
Par exemple :
GET /api/apiToken/jJYrtIVP7qU
Content-Type: application/json
Authorization: ApiToken d2pat_5xVA12xyUbWNedQxy4ohH77WlxRGVvZZ1151814092
Vous pouvez supprimer vos PAT soit dans l'interface utilisateur de votre page de profil où vous les avez créés, soit via l'API comme ceci :
DELETE /api/apiToken/jJYrtIVP7qU
Content-Type: application/json
Authorization: ApiToken d2pat_5xVA12xyUbWNedQxy4ohH77WlxRGVvZZ1151814092
DHIS2 prend en charge le protocole d'authentification OAuth2. OAuth2 est une norme ouverte d'autorisation qui permet aux clients tiers de se connecter au nom d'un utilisateur DHIS2 et d'obtenir un bearer token (jeton porteur) réutilisable pour les requêtes ultérieures à l'API Web. DHIS2 ne prend pas en charge les rôles OAuth2 à granularité fine, mais fournit aux applications un accès basé sur les rôles d'utilisateur de DHIS2.
Chaque client pour lequel vous voulez autoriser l'authentification OAuth 2 doit être enregistré dans DHIS2. Pour ajouter un nouveau client OAuth2, allez dans Applications > Paramètres > Clients OAuth2 dans l'interface utilisateur, cliquez sur Ajouter nouveau et entrez le nom du client souhaité et les types d'autorisations.
Un client OAuth2 peut être ajouté via l'API Web. Par exemple, nous pouvons envoyer une charge comme celle-ci :
{
  "name": "OAuth2 Demo Client",
  "cid": "demo",
  "secret": "1e6db50c-0fee-11e5-98d0-3c15c2c6caf6",
  "grantTypes": [
    "password",
    "refresh_token",
    "authorization_code"
  ],
  "redirectUris": [
    "http://www.example.org"
  ]
}
La charge utile peut être envoyée avec la commande suivante :
SERVER="https://play.dhis2.org/dev"
curl -X POST -H "Content-Type: application/json" -d @client.json
  -u admin:district "$SERVER/api/oAuth2Clients"
This client will be used as the basis for the next grant type examples.
Le type d'autorisation le plus simple est le type mot de passe. Ce type d'autorisation est similaire à l'authentification de base en ce sens qu'il exige du client qu'il recueille le nom d'utilisateur et le mot de passe de l'utilisateur. Prenons l'exemple de notre serveur de démonstration :
SERVER="https://play.dhis2.org/dev"
SECRET="1e6db50c-0fee-11e5-98d0-3c15c2c6caf6"

curl -X POST -H "Accept: application/json" -u demo:$SECRET "$SERVER/uaa/oauth/token"
  -d grant_type=password -d username=admin -d password=district
Vous obtiendrez une réponse similaire à ceci :
{
  "expires_in": 43175,
  "scope": "ALL",
  "access_token": "07fc551c-806c-41a4-9a8c-10658bd15435",
  "refresh_token": "a4e4de45-4743-481d-9345-2cfe34732fcc",
  "token_type": "bearer"
}
Pour l'instant, nous allons nous concentrer sur le access_token, qui sera utilisé comme jeton d'authentification (porteur). À titre d'exemple, nous allons obtenir tous les éléments de données en utilisant notre jeton :
SERVER="https://play.dhis2.org/dev"
curl -H "Authorization: Bearer 07fc551c-806c-41a4-9a8c-10658bd15435" "$SERVER/api/33/dataElements.json"
En général, les jetons d'accès ont une validité limitée. Vous pouvez jeter un coup d'œil à la propriété expires_in (expire dans) de la réponse dans l'exemple précédent pour comprendre quand un jeton expire. Pour obtenir un nouveau access_token (jeton d'accès), vous pouvez visiter le serveur et utiliser refresh_token (rafraîchir le jeton) qui vous permet d'obtenir un jeton mis à jour sans avoir besoin de demander les informations d'identification de l'utilisateur une fois de plus.
SERVER="https://play.dhis2.org/dev"
SECRET="1e6db50c-0fee-11e5-98d0-3c15c2c6caf6"
REFRESH_TOKEN="a4e4de45-4743-481d-9345-2cfe34732fcc"

curl -X POST -H "Accept: application/json" -u demo:$SECRET "$SERVER/uaa/oauth/token"
  -d "grant_type=refresh_token" -d "refresh_token=$REFRESH_TOKEN"
La réponse sera exactement la même que lorsque vous obtenez un jeton au départ.
Le type "code autorisé" est l'approche recommandée si vous ne voulez pas stocker les informations d'identification de l'utilisateur en externe. Elle permet à DHIS2 de collecter le nom d'utilisateur et le mot de passe directement auprès de l'utilisateur au lieu que le client les collecte et s'authentifie ensuite au nom de l'utilisateur. Notez que cette approche utilise la partie redirectUris de la charge du client.
Étape 1 : Visitez l'URL suivante à l'aide d'un navigateur web. Si vous avez plus d'un URI de redirection, vous pouvez ajouter &redirect_uri=http://www.example.org à l'URL :
SERVER="https://play.dhis2.org/dev"
$SERVER/uaa/oauth/authorize?client_id=demo&response_type=code
Étape 2 : Une fois que l'utilisateur s'est connecté avec succès et a accepté votre accès client, il sera redirigé vers votre uri de redirection comme suit :
http://www.example.org/?code=XYZ
Étape 3 : Cette étape est similaire à celle du type d'autorisation "mot de passe". En utilisant le code fourni, nous allons maintenant demander un jeton d'accès :
SERVER="https://play.dhis2.org/dev"
SECRET="1e6db50c-0fee-11e5-98d0-3c15c2c6caf6"

curl -X POST -u demo:$SECRET -H "Accept: application/json" $SERVER/uaa/oauth/token
-d "grant_type=authorization_code" -d "code=XYZ"
L'API Web utilise un format cohérent pour tous les messages d'erreur, d'avertissement et d'information :
{
  "httpStatus": "Forbidden",
  "message": "Vous n'avez pas la permission de lire ce type d'objet.",
  "httpStatusCode": 403,
  "status": "ERROR"
}
Le message indique que l'utilisateur a essayé d'accéder à une ressource à laquelle je n'ai pas accès. Il utilise le code de statut http 403, le message de statut http interdit et un message descriptif.
Tableau : Propriétés de WebMessage
| Nom | Description |
|---|---|
| Statut http | Message de statut HTTP pour cette réponse, voir RFC 2616 (Section 10) pour plus d'informations. |
| Code de statut http | Code de statut HTTP pour cette réponse, voir RFC 2616 (Section 10) pour plus d'informations. |
| status | Les valeurs possibles du statut DHIS2 sont OK | ; AVERTISSEMENT | ; ERREUR, où OK signifie que tout a réussi, ERREUR signifie que l'opération ne s'est pas terminée et AVERTISSEMENT signifie que l'opération a partiellement réussi, si le message contient une propriété réponse, veuillez y jeter un coup d'oeil pour obtenir plus d'informations. |
| message | Un message convivial indiquant si l'opération a réussi ou non. |
| Message dev | Un message plus technique, adapté aux développeurs (non utilisé actuellement). |
| réponse | Point d'extension pour les futures extensions du format MessageWeb. |
Dans l'API Web, nous faisons référence à des dates et à des périodes. Le format de la date est le suivant :
yyyy-MM-dd
For example, if you want to express March 20, 2014, you must use 2014-03-20.
Le format de la période est décrit dans le tableau suivant (également disponible dans le endpoint de l'API /api/periodTypes)
Tableau : Format de la période
| Intervale | Format | Exemple | Description |
|---|---|---|---|
| Jour | aaaaMMjj | 20040315 | 15 Mars, 2004 |
| Semaine | aaaaWn | 2004W10 | Semaine 10 2004 |
| Semaine Mercredi | aaaaMerWn | 2015MerS5 | Semaine 5 avec début le mercredi |
| Semaine Jeudi | aaaaJeuSn | 2015JeuS6 | Semaine 6 avec début le Jeudi |
| Semaine Samedi | aaaaSamSn | 2015SamS7 | Semaine 7 avec début le Samedi |
| Semaine Dimanche | aaaaDimSn | 2015DimS8 | Semaine 8 avec début le Dimanche |
| Bi-hebdomadaire | aaaaBiSn | 2015BiS1 | Semaine 1-2 20015 |
| Mois | aaaaMM | 200403 | Mars 2004 |
| Bi-mensuel | aaaaMMB | 200401B | Janvier-février 2004 |
| Trimestre | aaaaTn | 2004Q1 | Janvier-Mars 2004 |
| Semestre | aaaaSn | 2004S1 | Janvier-juin 2004 |
| Semestre Avril | aaaaAvrilSn | 2004AvrilS1 | Avril-Septembre 2004 |
| Année | aaaa | 2004 | 2004 |
| Année financière Avril | aaaaAvril | 2004Avril | Avril 2004 - mars 2005 |
| Année financière Juillet | aaaaJuillet | 2004Juillet | juillet 2004-juin 2005 |
| Année financière Octobre | aaaaOctobre | 2004Octobre | Octobre 2004-septembre 2005 |
In some parts of the API, like for the analytics resource, you can utilize relative periods in addition to fixed periods (defined above). The relative periods are relative to the current date and allow e.g. for creating dynamic reports. The available relative period values are described in the table below.
| Nom | Keyword |
|---|---|
| Aujourd'hui | TODAY |
| Hier | YESTERDAY |
| Last 3 days | LAST_3_DAYS |
| Last 7 days | LAST_7_DAYS |
| Last 14 days | LAST_14_DAYS |
| Last 30 days | LAST_30_DAYS |
| Last 60 days | LAST_60_DAYS |
| Last 90 days | LAST_90_DAYS |
| Last 180 days | LAST_180_DAYS |
| Ce mois | THIS_MONTH |
| This bi-month | THIS_BIMONTH |
| Last bi-month | LAST_BIMONTH |
| Ce trimestre | THIS_QUARTER |
| Last quarter | LAST_QUARTER |
| This six-month | THIS_SIX_MONTH |
| Last six-month | LAST_SIX_MONTH |
| Weeks this year | WEEKS_THIS_YEAR |
| Months this year | MONTHS_THIS_YEAR |
| Bi-months this year | BIMONTHS_THIS_YEAR |
| Quarters this year | QUARTERS_THIS_YEAR |
| This year | THIS_YEAR |
| Months last year | MONTHS_LAST_YEAR |
| Quarters last year | QUARTERS_LAST_YEAR |
| L'année dernière | LAST_YEAR |
| Last 5 years | LAST_5_YEARS |
| Last 10 years | LAST_10_YEARS |
| Les 12 derniers mois | LAST_12_MONTHS |
| Last 6 months | LAST_6_MONTHS |
| Last 3 months | LAST_3_MONTHS |
| Last 6 bi-months | LAST_6_BIMONTHS |
| Last 4 quarters | LAST_4_QUARTERS |
| Last 2 six-months | LAST_2_SIXMONTHS |
| This financial year | THIS_FINANCIAL_YEAR |
| Last financial year | LAST_FINANCIAL_YEAR |
| Last 5 financial years | LAST_5_FINANCIAL_YEARS |
| Last 10 financial years | LAST_10_FINANCIAL_YEARS |
| Cette semaine | THIS_WEEK |
| Semaine dernière | LAST_WEEK |
| This bi-week | THIS_BIWEEK |
| Last bi-week | LAST_BIWEEK |
| Last 4 weeks | LAST_4_WEEKS |
| Last 4 bi-weeks | LAST_4_BIWEEKS |
| Last 12 weeks | LAST_12_WEEKS |
| Last 52 weeks | LAST_52_WEEKS |
It is possible retrieve the ISO representations of these relative periods by making a GET request to the /api/relativePeriods/{RELATIVE_PERIOD_KEYWORD}
The endpoint supports the following parameters: - startDate: Represents the start date to calculate the relative period from. Format: yyyy-MM-dd. Default is today if not provided. - financialYearStart: Should be one of FINANCIAL_YEAR_FEBRUARY, FINANCIAL_YEAR_APRIL, FINANCIAL_YEAR_JULY, FINANCIAL_YEAR_AUGUST, FINANCIAL_YEAR_SEPTEMBER, FINANCIAL_YEAR_OCTOBER. Default is FINANCIAL_YEAR_OCTOBER if not provided.
As an example, to get the ISO representation of the relative period LAST_3_MONTHS from the date 2021-08-15, you can issue the following request: GET /api/relativePeriods/LAST_3_MONTHS?startDate=2021-08-15
The response in this case would be:
{
[
"202105",
"202106",
"202107"
]
}
Les ressources analytiques query supportent des paramètres supplémentaires pour exprimer des périodes.
La dimension pe par défaut sera utilisée :
eventDate pour /analytics/events/queryenrollmentDate pour /analytics/enrollments/queryIl est possible d'ajouter des conditions sur un ou plusieurs champs de date et de les combiner.
Dans les ressources prenant en charge des périodes de dates personnalisées, il existe des paramètres de requête supplémentaires qui seront combinés pour exprimer des conditions sur la dimension temporelle.
| période de date personnalisée | ressources de requête d'événements | ressource de requête d'inscription |
|---|---|---|
date d'événement | [x] | [ ] |
date d'inscription | [x] | [x] |
date programmée | [x] | [ ] |
date d'incident | [x] | [x] |
lastUpdated | [x] | [x] |
Conditions can be expressed in the following format:
/api/analytics/events/query/...?...&eventDate=2021&...
Il est possible de combiner plusieurs champs temporels dans la même requête :
/api/analytics/events/query/...?...&eventDate=2021&incidentDate=202102&...
Toutes ces conditions peuvent être combinées avec la dimension pe :
/api/analytics/events/query/...?...&dimension=pe:TODAY&enrollmentDate=2021&incidentDate=202102&...
Les formats pris en charge sont décrits dans la section « Format de date et de période » ci-dessus. Un format supplémentaire est fourni pour exprimer un intervalle de dates : aaaaMMjj_aaaaMMjj et aaaa-MM-jj_aaaa-MM-jj.
Dans l'exemple ci-dessous, le point d'extrémité renvoie les événements prévus entre 20210101 et 20210104 :
/api/analytics/events/query/...?...&dimension=pe:TODAY&enrollmentDate=2021&incidentDate=202102&scheduledDate=20210101_20210104&...
All available system authorities can be listed with identifiers and names using the following endpoint.
GET /api/authorities
Il renvoie le format suivant :
{
  "systemAuthorities": [
    {
      "id": "ALL",
      "name": "ALL"
    },
    {
      "id": "F_ACCEPT_DATA_LOWER_LEVELS",
      "name": "Accept data at lower levels"
    }
  ]
}
Cette section explique le concept de schéma d'identification. Les schémas d'identification sont utilisés pour relier des objets de métadonnées à d'autres métadonnées lors des importations et également pour envoyer les métadonnées lors des exportations. Tous les schémas ne fonctionnent pas avec tous les appels d'API, et tous les schémas ne peuvent pas être utilisés à la fois pour les entrées et les sorties. Cet aspect est abordé dans les sections où sont expliqués les différents points d'extrémité d'API.
Tous les types d'objets disponibles pour le schéma d'identification sont énumérés ci-dessous. Sont fournis les noms des propriétés à utiliser dans les requêtes :
Le schéma d'identification général (idScheme) s'applique à tous les types d'objets. Il peut être remplacé par des types d'objets spécifiques.
Le schéma par défaut pour tous les paramètres est UID (identifiants DHIS2 permanents). Les schémas d'identification pris en charge sont décrits dans le tableau ci-dessous.
Tableau : Valeurs du schéma
| Schéma | Description |
|---|---|
| ID, UID | Correspondre avec l'identifiant permanent DHIS2. il s'agit du schéma d'identification par défaut. |
| CODE | Correspondre avec le code DHIS2, principalement utilisé pour échanger des données avec un système externe. |
| NOM | Correspondre avec le nom DHIS2. Notez que c'est l'élément disponible en tant que object.name (nom de l'objet) qui est utilisé, et non le nom traduit. Notez également que les noms ne sont pas toujours uniques et que, par conséquent, ils ne peuvent pas être utilisés. |
| ATTRIBUT:ID | Correspondre avec l'attribut de métadonnées. Cet attribut doit être assigné au type avec lequel vous établissez la correspondance, d'autant plus que la propriété unique est définie sur vrai. Cette fonctionnalité permet principalement d'échanger des données avec des systèmes externes. Il présente certains avantages par rapport à CODE puisque plusieurs attributs peuvent être ajoutés. Il peut donc se synchroniser avec plus d'un système. |
Notez que les schémas d'identification ne constituent pas une fonctionnalité indépendante, mais ils doivent être utilisés en combinaison avec des ressources telles que l'importation de valeurs de données, l'importation de métadonnées et l'importation GeoJson.
Par exemple, pour spécifier CODE comme schéma d'identification général et le remplacer par UID pour le schéma d'identification de l'unité d'organisation, vous pouvez utiliser les requêtes suivantes :
?idScheme=CODE&orgUnitIdScheme=UID
Autre exemple, pour spécifier un attribut pour le schéma d'identification de l'unité d'organisation, un code pour le schéma d'identification de l'élément de données et utiliser le schéma d'identification par défaut UID pour tous les autres objets, vous pouvez utiliser les paramètres suivants :
?orgUnitIdScheme=ATTRIBUTE:j38fk2dKFsG&dataElementIdScheme=CODE
Le point d'entrée pour naviguer dans l'API Web est /api. Cette ressource fournit des liens vers toutes les ressources disponibles. Quatre formats de représentation sont systématiquement disponibles pour toutes les ressources : HTML, XML, JSON et JSONP. D'autres formats sont disponibles pour des ressources comme MS Excel, PDF, CSV et PNG. Pour explorer l'API à partir d'un navigateur web, accédez au point d'entrée /api et suivez les liens vers la ressource que vous recherchez, par exemple /api/dataElements. Pour toutes les ressources qui renvoient une liste d'éléments, certains paramètres de requête peuvent être utilisés pour modifier la réponse :
Tableau : Paramètres de requête
| Paramètre | Valeurs des options | Option par défaut | Description |
|---|---|---|---|
| pagination | vrai | faux | true |
| page | numéro | 1 | Définit le numéro de page à renvoyer. |
| pageSize | numéro | 50 | Définit le nombre d'éléments à renvoyer pour chaque page. |
| order | property:asc/iasc/desc/idesc | Ordonne la sortie dans un ordre spécifique. Seules les propriétés qui sont à la fois persistantes et simples (pas de collections, d'identifiants d'objets, etc.) sont prises en charge. iasc et idesc sont des tris insensibles à la casse. Si vous souhaitez trier plusieurs propriétés, séparez-les par une virgule. |
Voici un exemple de comment ces paramètres peuvent être utilisés pour obtenir une liste complète de groupes d'éléments de données dans un format de réponse XML :
/api/dataElementGroups.xml?links=false&paging=false
Vous pouvez rechercher des éléments à partir de la propriété "nom" au lieu de renvoyer toute une liste d'éléments à l'aide de la variable de requête query. Dans cet exemple, nous recherchons tous les éléments de données dont le nom contient le mot "anémie" :
/api/dataElements?query=anaemia
Vous pouvez obtenir des pages spécifiques et des tailles de page pour des objets en utilisant la requête suivante :
/api/dataElements.json?page=2&pageSize=20
Vous pouvez désactiver complètement la pagination à l'aide de cette requête :
/api/indicatorGroups.json?paging=false
Pour que le résultat soit ordonné selon une propriété spécifique :
/api/indicators.json?order=shortName:desc
Pour que le résultat soit d'abord ordonné selon la propriété créée "date et heure" (ordre décroissant), puis selon la propriété "nom" (ordre croissant) :
/api/indicators.json?order=created:desc,name:asc
La ressource identifiableObjects vous permet de rechercher tout objet à partir de son identifiant, quel que soit son type :
/api/identifiableObjects/<id>
DHIS2 propose des traductions pour le contenu de la base de données, notamment les éléments de données, les indicateurs et les programmes. Tous les objets de métadonnées qui figurent dans l'API Web ont des propriétés destinées à être utilisées pour l'affichage et l'interface utilisateur. Il s'agit entre autres de displayName (nom d'affichage), displayShortName (nom d'affichage court), displayDescription (description de l'affichage) et displayFormName (nom du formulaire d'affichage). Ces propriétés sont utilisées pour les éléments de données et les attributs d'entités suivies.
Tableau : Options de traduction
| Paramètre | Valeurs | Description |
|---|---|---|
| traduction | vrai | faux |
| langue | Emplacement à utiliser | Traduire les métadonnées dans une langue donnée (nécessite que la traduction soit définie sur 'vrai'). |
Les traductions d'un objet sont rendues comme faisant partie de l'objet lui-même dans le tableau traductions. Le tableau traductions qui figure dans les charges JSON/XML est normalement préfiltré pour vous, ce qui signifie qu'il ne peut pas être utilisé directement pour importer/exporter des traductions (car cela aurait pour effet de remplacer les langues autres que celles des utilisateurs actuellement connectés).
Exemple d'élément de données dont le tableau de traduction est filtré sur la langue de l'utilisateur :
{
  "id": "FTRrcoaog83",
  "displayName": "Accute French",
  "translations": [
    {
      "property": "SHORT_NAME",
      "locale": "fr",
      "value": "Accute French"
    },
    {
      "property": "NAME",
      "locale": "fr",
      "value": "Accute French"
    }
  ]
}
Exemple d'élément de données dont les traductions sont désactivées :
{
  "id": "FTRrcoaog83",
  "displayName": "Accute Flaccid Paralysis (Deaths < 5 yrs)",
  "translations": [
    {
      "property": "FORM_NAME",
      "locale": "en_FK",
      "value": "aa"
    },
    {
      "property": "SHORT_NAME",
      "locale": "en_GB",
      "value": "Accute Flaccid Paral"
    },
    {
      "property": "SHORT_NAME",
      "locale": "fr",
      "value": "Accute French"
    },
    {
      "property": "NAME",
      "locale": "fr",
      "value": "Accute French"
    },
    {
      "property": "NAME",
      "locale": "en_FK",
      "value": "aa"
    },
    {
      "property": "DESCRIPTION",
      "locale": "en_FK",
      "value": "aa"
    }
  ]
}
Notez que même si vous obtenez un résultat non filtré, et que vous utilisez le type de endpoint approprié, c'est-à-dire /api/dataElements, nous n'autorisons pas les mises à jour, car cela pourrait facilement entraîner des erreurs et remplacer les autres langues disponibles.
Pour lire et mettre à jour les traductions, vous pouvez utiliser le endpoint spécial des traductions pour chaque ressource d'objet. Vous pouvez y accéder en utilisant GET ou PUT sur le endpoint /api/<object-type>/<object-id>/translations approprié.
Par exemple, pour un élément de données dont l'identifiant est FTRrcoaog83, vous pouvez utiliser /api/dataElements/FTRrcoaog83/translations pour obtenir les traductions et les mettre à jour. Les champs disponibles sont property avec les options NOM, NOM_COURT, NOM DU_FORMULAIRE, DESCRIPTION, locale qui prend en charge tout ID de langue valide et la propriété traduite value.
Exemple de propriété NOM pour la langue française :
{
  "property": "NAME",
  "locale": "fr",
  "value": "Paralysie Flasque Aiguë (Décès <5 ans)"
}
Cette charge est ensuite ajoutée à un tableau de traduction et renvoyée au endpoint approprié :
{
  "translations": [
    {
      "property": "NAME",
      "locale": "fr",
      "value": "Paralysie Flasque Aiguë (Décès <5 ans)"
    }
  ]
}
Pour un élément de données dont l'ID est FTRrcoaog83, vous pouvez effectuer une requête PUT comme suit : /api/dataElements/FTRrcoaog83/translations. Assurez-vous d'envoyer toutes les traductions disponibles pour cet objet et pas seulement pour une langue (sinon vous risquez de remplacer les langues existantes par d'autres langues).
Le code de statut sera 204 No Content si la valeur de données a été sauvegardée ou mise à jour avec succès, ou 404 Not Found si une erreur de validation s'est produite (par exemple, plus d'un NOM_COURT pour la même langue).
The Web API /api can be used with a DHIS2 version number, example:
/api/42/dataElements
Versions 28-43 are supported. Calling an endpoint with or without a version does not change the behaviour of the API. The behaviour is the same no matter which approach is used. We aim to remove supporting API calls with versions, so please use API calls without the use of a version number.
The support for using versions is due to legacy design, which didn't evolve as originally envisioned.
Pour filtrer les métadonnées, plusieurs opérations de filtrage peuvent être appliquées à la liste de métadonnées renvoyée. Le format du filtre lui-même est simple et suit le modèle propriété:opérateur:valeur, où propriété est la propriété des métadonnées sur lesquelles vous voulez effectuer le filtrage, opérateur est l'opérateur de comparaison que vous voulez utiliser et valeur est la valeur à vérifier (tous les opérateurs ne requièrent pas de valeur).
Veuillez consulter la section schéma pour savoir quelles propriétés sont disponibles. En plus des propriétés listées, les filtres peuvent s'appliquer à des valeurs d'attributs personnalisés où l'ID de l'attribut est utilisé comme nom de propriété.
Le filtrage récursif, c'est-à-dire le filtrage sur des objets associés ou une collection d'objets, est également possible.
Tableau : Opérateurs disponibles
| Opérateur | Types | Valeur requise | Description |
|---|---|---|---|
| eq | chaîne | booléen | entier |
| !eq | chaîne | booléen | entier |
| ieq | chaîne | true | Case insensitive string, match exact |
| ne | chaîne | booléen | entier |
| like | chaîne | true | Chaîne sensible à la casse ; peut correspondre avec tout élément |
| !like | chaîne | true | Chaîne sensible à la casse ; ne peut pas correspondre avec tous les éléments |
| $like | chaîne | true | Chaîne sensible à la casse ; début de la correspondance |
| !$like | chaîne | true | Chaîne sensible à la casse, pas de début de correspondance |
| like$ | chaîne | true | Chaîne sensible à la casse ; fin de la correspondance |
| !like$ | chaîne | true | Case sensitive string, not match end |
| ilike | chaîne | true | Chaîne insensible à la casse ; peut correspondre avec tout élément |
| !ilike | chaîne | true | Chaîne insensible à la casse ; ne peut pas correspondre avec tous les éléments |
| $ilike | chaîne | true | Chaîne insensible à la casse ; début de la correspondance |
| !$ilike | chaîne | true | Chaîne insensible à la casse, pas de début de correspondance |
| ilike$ | chaîne | true | Case insensitive string, match end |
| !ilike$ | chaîne | true | Case insensitive string, not match end |
| gt | chaîne | booléen | entier |
| ge | chaîne | booléen | entier |
| lt | chaîne | booléen | entier |
| le | chaîne | booléen | entier |
| null | tous | false | La propriété est nulle |
| !null | tous | false | La propriété n'est pas nulle |
| vide | collection | false | La collection est vide |
| token | chaîne | true | Match on multiple tokens in search property |
| !token | chaîne | true | Not match on multiple tokens in search property |
| dans | chaîne | booléen | entier |
| !in | chaîne | booléen | entier |
Les opérateurs sont appliqués sous la forme d'une requête logique et. Si vous avez besoin d'une requête ou, vous pouvez consulter le filtre dans et la section ci-dessous. Le mécanisme de filtrage permet la récursivité. Des exemples sont donnés ci-dessous.
Obtenir des éléments de données avec la propriété ID1 ou ID2 :
/api/dataElements?filter=id:eq:ID1&filter=id:eq:ID2
Get data elements, ignoring case, with name property MyDataElement:
/api/dataElements?filter=name:ieq:mydataelement
Obtenir tous les éléments de données qui ont un ensemble de données avec l'identifiant ID1 :
/api/dataElements?filter=dataSetElements.dataSet.id:eq:ID1
Obtenir tous les éléments de données avec l'opérateur d'agrégation somme et le type de valeur int :
/api/dataElements.json?filter=aggregationOperator:eq:sum&filter=type:eq:int
Vous pouvez effectuer un filtrage à l'intérieur des collections. Par exemple, pour obtenir les éléments de données qui font partie du groupe d'éléments de données * CPN*, vous pouvez utiliser la requête suivante en utilisant la propriété d'identification (id) des groupes d'éléments de données qui lui sont associés :
/api/dataElements.json?filter=dataElementGroups.id:eq:qfxEYY9xAl6
Pour obtenir des éléments de données ayant une valeur d'attribut particulière pour un attribut de métadonnées, un filtre peut être spécifié pour l'ID de l'attribut et la valeur de l'attribut en utilisant la même syntaxe que celle de la requête de collection :
/api/dataElements.json?filter=attributeValues.attribute.id:eq:n2xYlNbsfko&filter=attributeValues.value:eq:AFP
Obtenir les éléments de données pour lesquels une option a été définie :
/api/dataElements?filter=optionSet:!null
Étant donné que tous les opérateurs sont and par défaut, vous ne pouvez pas trouver un élément de données correspondant à plus d'un identifiant. Pour ce faire, vous pouvez utiliser l'opérateur in.
/api/dataElements.json?filter=id:in:[fbfJHSPpUQD,cYeuwXTCPkU]
Comme indiqué dans la section précédente, l'opérateur logique par défaut appliqué aux filtres est AND, ce qui signifie que tous les filtres d'objets doivent trouver une correspondance. Cependant, dans certains cas, l'utilisateur peut vouloir utiliser un seul filtre parmi plusieurs (par exemple le champ de l'identifiant et du code). Dans ce cas, il est possible de changer l'opérateur logique racine de AND à OR à l'aide du paramètre rootJunction.
Exemple : Filtrage normal où l'identifiant et le code doivent trouver une correspondance pour que le résultat soit renvoyé.
/api/dataElements.json?filter=id:in:[id1,id2]&filter=code:eq:code1
Exemple : Filtrage où l'opérateur logique a été remplacé par "OR", ce qui fait qu'un seul des filtres doit trouver une correspondance pour que le résultat soit renvoyé.
/api/dataElements.json?filter=id:in:[id1,id2]&filter=code:eq:code1&rootJunction=OR
Outre le filtrage spécifique basé sur les propriétés mentionné ci-dessus, nous disposons également d'un filtrage AND basé sur les jetons à travers un ensemble de propriétés : identifiant, code et nom (ainsi que 'nom court' s'il est disponible). Ces propriétés sont généralement appelées identifiables. L'idée est de filtrer les métadonnées dont l'identifiant, le nom, le code ou le nom court contiennent des informations.
Exemple : Filtrage de tous les éléments de données contenant 2nd dans l'un des éléments suivants : identifiant, nom, code et nom court.
/api/dataElements.json?filter=identifiable:token:2nd
Il est également possible de spécifier plusieurs valeurs de filtrage.
Exemple : Obtenir tous les éléments de données où ANC visit (visite de CPN) se trouve dans l'une des propriétés identifiables. Le système renvoie tous les éléments de données dans lesquels les deux unités lexicales (ANC et visit) se trouvent quelque part dans les propriétés identifiables.
/api/dataElements.json?filter=identifiable:token:ANC visit
Il est également possible de combiner le filtre identifiable avec le filtre basé sur les propriétés et de s'attendre à ce que le paramètre rootJunction soit appliqué.
/api/dataElements.json?filter=identifiable:token:ANC visit&filter=displayName:ilike:tt1

/api/dataElements.json?filter=identifiable:token:ANC visit
  &filter=displayName:ilike:tt1&rootJunction=OR
Dans de nombreuses situations, les visualisations par défaut des métadonnées peuvent être trop détaillées. Un client peut juste avoir besoin de quelques champs de chaque objet et vouloir supprimer les champs inutiles de la réponse. Pour connaître les champs disponibles pour chaque objet, veuillez consulter la section schéma. En plus des propriétés énumérées, il est possible d'inclure des attributs personnalisés pour les objets de premier niveau en utilisant l'identifiant de l'attribut comme nom de propriété.
Le format inclure/exclure permet une récursivité illimitée. Pour effectuer un filtrage au niveau de la "racine", vous pouvez simplement utiliser le nom du champ, c'est-à-dire ?fields=id,name qui n'affichera que les champs idendifiant et nom pour chaque objet. Pour les objets qui sont soit des collections, soit des objets complexes avec des propriétés indépendantes, vous pouvez utiliser le format ?fields=id,name,dataSets[id,name] qui renverra l'identifiant, le nom de la racine, ainsi que l'identifiant et le nom de chaque ensemble de données sur cet objet. Vous pouvez effectuer une négation à l'aide de l'opérateur d'exclamation, et nous disposons de paramètres prédéfinis pour la sélection des champs. Les formats XML et JSON sont acceptés.
Exemple : Obtenir l'id et le nom à partir de la ressource d'indicateurs :
/api/indicators?fields=id,name
Exemple : Obtenir l'id et le nom des éléments de données, et l'id et le nom des ensembles de données associés :
/api/dataElements?fields=id,name,dataSets[id,name]
Exemple : Obtenir l'id, le nom et la valeur d'un attribut défini par l'utilisateur avec l'ID DnrLSdo4hMl, pour les unités d'organisation :
/api/organisationUnits?fields=id,name,DnrLSdo4hMl
L'attribut est alors inclus en tant que propriété DnrLSdo4hMl de chaque objet correspondant dans la réponse. Il peut être renommé à l'aide du transformateur rename (renommer) tel que présenté dans la section suivante.
Pour exclure un champ de la sortie, vous pouvez utiliser l'opérateur d'exclamation !. Ceci est autorisé à n'importe quel emplacement dans la requête et cette propriété ne sera pas incluse tout simplement car elle pourrait avoir été insérée dans des paramètres prédéfinis.
Quelques paramètres prédéfinis (groupes de champs sélectionnés) sont disponibles et peuvent être appliqués à l'aide de l'opérateur :.
Tableau : Opérateurs de propriété
| Opérateur | Description |
|---|---|
| <field-name> | Inclut la propriété avec le nom, si possible. |
| <object>[<field-name>, ...] | Inclut un champ dans une collection (qui s'appliquera à tous les objets de cette collection) ou dans un seul objet. |
| !<field-name>, <object>[!<field-name> | Le nom du champ est exclu. Cet opérateur fonctionne également à l'intérieur des objets/collections. Il peut vous être utile lorsque vous utilisez un paramètre prédéfini pour inclure des champs. |
| *, <object>[*] | Inclut tous les champs d'un objet spécifique. S'il est appliqué à une collection, tous les champs de tous les objets de cette collection seront inclus. |
| :<preset> | Alias pour sélectionner plusieurs champs. Trois paramètres prédéfinis sont actuellement disponibles ; le tableau ci-dessous en fournit les descriptions. |
Tableau : Paramètres prédéfinies des champs
| Paramètre prédéfini | Description |
|---|---|
| tous | Tous les champs de l'objet |
| * | Alias pour tous |
| identifiable | Includes id, name, code, created, lastUpdated and lastUpdatedBy fields |
| nommable | Inclut les champs pour l'identifiant, le nom, le nom court, le code, la description, la date de création et la dernière mise à jour. |
| conservé | Renvoie toutes les propriétés conservées pour un objet ; ne tient pas compte du fait que l'objet soit le propriétaire de la relation ou non. |
| propriétaire | Renvoie toutes les propriétés conservées pour un objet, dans un contexte où cet objet possède toutes les propriétés. Cette charge peut être utilisée pour effectuer une mise à jour via l'API. |
Exemple : Inclure tous les champs des ensembles de données à l'exception des unités d'organisation :
/api/dataSets?fields=:all,!organisationUnits
Exemple : Inclure uniquement l'identifiant, le nom et la collection d'unités d'organisation d'un ensemble de données, mais exclure l'identifiant des unités d'organisation :
/api/dataSets/BfMAe6Itzgt?fields=id,name,organisationUnits[:all,!id]
Exemple : Inclure les propriétés nommables de tous les indicateurs :
/api/indicators.json?fields=:nameable
Les transformations de champs peuvent être utilisées pour transformer des propriétés. La syntaxe est décrite ci-dessous.
/api/dataElements/ID?fields=id~rename(i),name~rename(n)
La propriété id sera renommée i et la propriété name sera renommée n.
Plusieurs transformateurs peuvent être appliqués à une même propriété. Pour ce faire, il suffit de répéter l'opérateur de transformation :
/api/dataElementGroups.json?fields=id,displayName,dataElements~isNotEmpty~rename(haveDataElements)
Les opérateurs de transformation pris en charge sont décrits dans le tableau ci-dessous.
Tableau : Transformateurs disponibles
| Nom | Arguments | Description |
|---|---|---|
| taille | Donne la taille des chaînes (longueur) et des collections | |
| isEmpty (est vide) | La chaîne ou la collection est vide | |
| isNotEmpty (n'est pas vide) | La chaîne ou la collection n'est pas vide | |
| renommer | Arg1 : nom | Renomme la propriété |
| pagination | Arg1 : page,Arg2 : taille de la page | Pages a collection, default pageSize is 50. |
| pluck | Arg1 facultatif : fieldName (nom du champ) | Convertit un tableau d'objets en un tableau comprenant un champ sélectionné de cet objet. Par défaut, le premier champ renvoyé par la collection est utilisé (normalement l'ID). |
| keyBy | Arg1 facultatif : fieldName (nom du champ) | Convertit un tableau d'objets en un objet où le nom du champ (id par défaut) est utilisé comme clé. Cette fonction peut être utilisée pour faire des recherches rapides en JavaScript, par exemple |
Des exemples d'utilisation de transformateurs sont présentés ci-dessous.
Obtenir la taille d'une collection :
/api/dataElements?fields=dataSets~size
Teste si une collection est vide :
/api/dataElements?fields=dataSets~isEmpty
Teste si une collection n'est pas vide :
/api/dataElements?fields=dataSets~isNotEmpty
Renommer les propriétés :
/api/dataElements/ID?fields=id~rename(i),name~rename(n)
Appliquer la pagination à une collection :
/api/dataElementGroups?fields=id,displayName,dataElements~paging(1;20)
Obtenir un tableau contenant les identifiants des unités d'organisation :
/api/categoryOptions.json?fields=id,organisationUnits~pluck
Obtenir un tableau contenant les noms des unités d'organisation :
/api/categoryOptions.json?fields=id,organisationUnits~pluck[name]
Key the dataElements array by the id field:
/api/dataElementGroups.json?fields=id,name,dataElements~keyBy[id,name,valueType]
Key the dataElements array by the valueType field, since multiple hits this will results in arrays (of data elements):
/api/dataElementGroups.json?fields=id,name,dataElements~keyBy(valueType)[id,name,valueType]
Toutes les entités de métadonnées dans DHIS2 ont leur propre endpoint API qui prend en charge les opérations CRUD (création, lecture, mise à jour et suppression). Les URL des endpoints suivent le format suivant :
/api/<entityName>
Le nom de l'entité utilise la notation camel case. Par exemple, le endpoint pour les éléments de données est :
/api/dataElements
NOTE: Lors de la mise à jour des objets, toutes les valeurs des propriétés existantes seront écrasées, même si la nouvelle valeur est nulle. Veuillez utiliser l'API de patch JSON si vous souhaitez effectuer une mise à jour partielle d'un objet.
Les paramètres de requête suivants sont disponibles pour tous les endpoints de métadonnées.
Tableau : Filtres de requête disponibles
| Param | Type | Obligatoire | Options (par défaut en premier) | Description |
|---|---|---|---|---|
| preheatCache | booléen | false | vrai | faux |
| importStrategy (stratégie d'importation) | énumération | false | CRÉER_ET_METTRE À JOUR | CRÉER |
Pour créer de nouveaux objets, vous devrez connaître le endpoint, le format du type d'objet et vous assurer que vous disposez des autorisations nécessaires. À titre d'exemple, nous allons créer et mettre à jour une constante. Pour connaître le format, nous pouvons utiliser le nouveau endpoint schema pour obtenir la description du format. Nous allons donc commencer par l'obtention de cette information :
http://<server>/api/schemas/constant.json
À partir de la sortie, vous pouvez voir que les autorités requises pour la création sont F_CONSTANT_ADD, et que les propriétés importantes sont : name et value. En nous basant sur ces informations, nous pouvons créer une charge JSON et la sauvegarder dans un fichier appelé constant.json :
{
  "name": "PI",
  "value": "3.14159265359"
}
Pour avoir le même contenu qu'une charge XML :
<constant name="PI" xmlns="http://dhis2.org/schema/dxf/2.0">
  <value>3.14159265359</value>
</constant>
Nous sommes maintenant prêts à créer la nouvelle constante en envoyant une requête POST au point d'extrémité constantes avec la charge JSON, en utilisant le curl :
curl -d @constant.json "http://server/api/constants" -X POST
  -H "Content-Type: application/json" -u user:password
Exemple concret d'envoi de la constante au serveur de démonstration :
curl -d @constant.json "https://play.dhis2.org/api/constants" -X POST
  -H "Content-Type: application/json" -u admin:district
Si tout s'est bien passé, vous devriez obtenir le résultat suivant :
{
  "status": "SUCCESS",
  "importCount": {
    "imported": 1,
    "updated": 0,
    "ignored": 0,
    "deleted": 0
  },
  "type": "Constant"
}
Le processus sera exactement le même pour la mise à jour, vous apportez vos modifications à la charge JSON/XML, vous trouvez l'ID de la constante, puis vous envoyez une requête PUT au endpoint en incluant l'ID :
curl -X PUT -d @pi.json -H "Content-Type: application/json"
  -u user:password "http://server/api/constants/ID"
La suppression d'objets est très simple. Vous devez connaître l'ID et le endpoint du type d'objet que vous voulez supprimer. Reprenons l'exemple de la dernière section et utilisons une constante. Supposons que l'identifiant soit abc123, tout ce que vous avez à faire est d'envoyer la requête DELETE au endpoint + id :
curl -X DELETE -u user:password "http://server/api/constants/ID"
Une suppression réussie doit renvoyer le statut HTTP 204 (pas de contenu).
La ressource des collections vous permet de modifier des collections d'objets.
Pour ajouter ou supprimer des objets dans une collection d'objets, vous pouvez utiliser le modèle suivant :
/api/{collection-object}/{collection-object-id}/{collection-name}/{object-id}
Vous devez utiliser la méthode POST pour ajouter un objet et la méthode DELETE pour le supprimer. Lorsqu'il existe une relation entre plusieurs objets, vous devez d'abord déterminer quel objet est propriétaire de la relation. Si cet objet n'est pas clairement identifiable, essayez les deux méthodes d'appel pour voir laquelle fonctionne.
Les éléments du modèle sont les suivants :
objet de collection : Le type d'objets qui possède la collection que vous voulez modifier.
id de l'objet de collection : L'identifiant de l'objet qui possède la collection que vous voulez modifier.
nom de la collection : le nom de la collection que vous voulez modifier.
Identifiant d'objet : L'identifiant de l'objet que vous voulez ajouter ou supprimer de la collection.
Par exemple, pour supprimer un élément de données avec pour identifiant IDB d'un groupe d'éléments de données dont l'identifiant est IDA, vous pouvez effectuer une requête DELETE :
DELETE /api/dataElementGroups/IDA/dataElements/IDB
Pour ajouter une option de catégorie avec pour identifiant IDB à une catégorie dont l'identifiant est IDA, vous pouvez effectuer une requête POST :
POST /api/categories/IDA/categoryOptions/IDB
Vous pouvez ajouter ou supprimer plusieurs objets d'une collection dans une même requête, en utilisant la charge suivante :
{
  "identifiableObjects": [{
      "id": "IDA"
    }, {
      "id": "IDB"
    }, {
      "id": "IDC"
    }
  ]
}
Cette charge permet d'ajouter, de remplacer ou de supprimer des éléments :
Ajouter des éléments :
POST /api/categories/IDA/categoryOptions
Remplacer des éléments :
PUT /api/categories/IDA/categoryOptions
Supprimer des éléments :
DELETE /api/categories/IDA/categoryOptions
Vous pouvez ajouter et supprimer des objets d'une collection dans une même requête POST, en utilisant l'URL suivante :
POST /api/categories/IDA/categoryOptions
Le format de la charge est le suivant :
{
  "additions": [{
      "id": "IDA"
    }, {
      "id": "IDB"
    }, {
      "id": "IDC"
    }
  ],
  "deletions": [{
      "id": "IDD"
    }, {
      "id": "IDE"
    }, {
      "id": "IDF"
    }
  ]
}
DHIS 2 permet de valider des métadonnées à l'échelle du système, ce qui signifie que les opérations de création et de mise à jour sur les points d'extrémité d'API devront être valides avant que les modifications ne soient autorisées. Pour connaître les validations disponibles pour un point d'extrémité spécifique, consultez ce point d'extrémité : /api/schemas. C'est-à-dire que pour connaître les contraintes d'un élément de données, vous devez vous rendre dans /api/schemas/dataElement.
Vous pouvez également valider votre charge manuellement en l'envoyant au endpoint du schéma approprié. Si vous vouliez valider la constante dans la section de création précédente, vous devriez l'envoyer comme ceci :
POST /api/schemas/constant
Voici un exemple simple (sans validation) :
curl -X POST -d "{\"name\": \"some name\"}" -H "Content-Type: application/json"
  -u admin:district "https://play.dhis2.org/dev/api/schemas/dataElement"
Ce qui donnera le résultat suivant :
[
   {
      "message" : "Required property missing.",
      "property" : "type"
   },
   {
      "property" : "aggregationOperator",
      "message" : "Required property missing."
   },
   {
      "property" : "domainType",
      "message" : "Required property missing."
   },
   {
      "property" : "shortName",
      "message" : "Required property missing."
   }
]
Nos points d'extrémité d'API qui traitent les métadonnées permettent des mises à jour partielles (PATCH) à l'aide du patch JSON [standard] (https://tools.ietf.org/html/rfc6902). La charge décrit essentiellement un ensemble d'opérations que vous voulez appliquer à un objet de métadonnées existant. Pour plus de détails et d'exemples sur le patch JSON, voir jsonpatch.com. Trois opérateurs sont pris en charge : add, remove et replace (ajouter, supprimer et remplacer).
Vous trouverez ci-dessous quelques exemples concernant DHIS2. Notez que toute mise à jour d'une charge doit être considérée comme une opération HTTP PUT, c'est-à-dire que toute modification doit aboutir à une charge de métadonnées PUT valide.
Le importReportMode (mode de rapport d'importation) par défaut pour le patch JSON est ERRORS_NOT_OWNER, ce qui signifie que si vous essayez de mettre à jour une propriété qui n'appartient pas à l'objet traité (par exemple si vous essayez d'ajouter un groupe d'indicateurs directement à un indicateur), vous obtiendrez une erreur.
Conformément à la spécification des patchs JSON, vous devez toujours utiliser le type MIME application/json-patch+json lorsque vous envoyez des patchs.
PATCH /api/dataElements/{id}
[
  {"op": "add", "path": "/name", "value": "New Name"},
  {"op": "add", "path": "/valueType", "value": "INTEGER"}
]
PATCH /api/dataElementGroups/{id}
[
  {"op": "add", "path": "/dataElements/-", "value": {"id": "data-element-id"}}
]
PATCH /api/dataElementGroups/{id}
[
  {"op": "remove", "path": "/dataElements"}
]
PATCH /api/dataElements/{id}
[
    {"op": "add", "path": "/domainType", "value": "TRACKER"},
    {"op": "add", "path": "/valueType", "value": "INTEGER"}
]
PATCH /api/organisationUnitGroups/{id}
[
  {"op": "remove", "path": "/organisationUnits/1"}
]
PATCH /api/dataElements/{id}?importReportMode=ERRORS_NOT_OWNER
[
    {"op": "add", "path": "/dataElementGroups/-", "value": {"id": "data-element-group-id"}}
]
PATCH /api/dataElements/{id}?importReportMode=ERRORS_NOT_OWNER
[
    {"op": "add", "path": "/dataElementGroups/0", "value": {"name": "new-name"}}
]
PATCH /api/dataSets/{id}?importReportMode=ERRORS_NOT_OWNER
[
    {"op": "remove-by-id", "path": "/organisationUnits", "id": "u6CvKyF0Db5"}
]
Si la propriété path (chemin d'accès) est invalide ou n'existe pas, le service de patchs renvoie une erreur comme dans l'exemple suivant
PATCH /api/dataSets/{id}?importReportMode=ERRORS_NOT_OWNER
[
    {"op": "remove-by-id", "path": "/test", "id": "u6CvKyF0Db5"}
]
{
    "httpStatus": "Bad Request",
    "httpStatusCode": 400,
    "status": "ERROR",
    "message": "Invalid path /test"
}
Le filtrage des champs fonctionne presque de la même manière pour le CSV (notez que l'utilisation du CSV sur le point d'extrémité /api/metadata n'est pas possible), mais la transformation des champs n'est pas encore prise en charge.
Pour les points d'extrémité qui acceptent le CSV (par exemple nos points d'extrémité de métadonnées /api/dataElements et /api/organisationUnits), vous pouvez soit utiliser l'en-tête Accept avec la valeur text/csv ou utiliser l'extension .csv. Sachez que nous ne prenons pas en charge les objets complexes, seulement les collections d'objets avec identifiant (une liste d'UID sera donc renvoyée).
| Nom | Options | Description |
|---|---|---|
| champs | Identique au filtre de champ de métadonnées (avec les restrictions mentionnées ci-dessus) | Le filtre par défaut est id,displayName. |
| skipHeader (ignorer l'en-tête) | faux/vrai | Détermine si l'en-tête (avec les noms des colonnes) doit être inclus ou non |
| séparateur | Valeur par défaut : . | Séparateur de colonnes |
| arraySeparator | Valeur par défaut : ; | Si l'un des champs est une collection d'objets d'identification, ce séparateur va se placer entre tous les UID. |
/api/dataElements.csv?fields=id,displayName,dataElementGroups
/api/organisationUnits.csv?fields=id,displayName,organisationUnitGroups,geometry
Cette section décrit l'API de métadonnées qui est disponible ici : /api/metadata. Les représentations des ressources XML et JSON sont prises en charge.
/api/metadata
Les paramètres les plus courants sont décrits dans le tableau "Paramètres d'exportation" ci-dessous. Vous pouvez également appliquer ceci à tous les types disponibles en utilisant type:fields=<filter> et type:filter=<filter>. Vous pouvez également activer/désactiver l'exportation de certains types à travers ceci : type=true|false.
| Nom | Options | Description |
|---|---|---|
| champs | Identique au filtre du champ de métadonnées | Filtre de champ par défaut à appliquer pour tous les types. La valeur par défaut est :owner (propriétaire). |
| filter | Identique au filtre des objets de métadonnées | Filtre d'objets par défaut à appliquer pour tous les types. La valeur par défaut est :none (aucun). |
| order | Identique à l'ordre des métadonnées | Ordre par défaut à appliquer à tous les types. La valeur par défaut est name si un nom est disponible, ou created sinon. |
| traduction | faux/vrai | Permet les traductions. Cette fonction est désactivée par défaut (dans d'autres points d'extrémité, elle est activée par défaut). |
| langue | <locale> | Permet de passer de la langue de l'utilisateur à la langue que vous définissez. |
| defaults | INCLURE/EXCLURE | Permet de déterminer si l'objet de catégorie généré automatiquement doit être inclus ou non dans la charge. Si vous déplacez des métadonnées entre deux instances non synchronisées, vous pouvez définir ce paramètre sur EXCLURE afin de faciliter la gestion de ces objets générés. |
| skipSharing (ignorer le partage) | faux/vrai | L'activation de ce paramètre supprime les propriétés de partage des objets exportés. Il s'agit de utilisateur, accès publique, accès des groupes d'utilisateurs, accès des utilisateurs, et accès externe. |
| inclusionStrategy (stratégie d'inclusion) | NON_NULL, ALWAYS, NON_EMPTY | NON_NULL includes properties which are not null, ALWAYS includes all properties, NON_EMPTY includes non empty properties (will not include strings of 0 length or empty collections) |
| download | faux/vrai | L'activation de ce paramètre ajoutera l'en-tête HTTP Contenu-Disposition qui spécifie que les données doivent être traitées comme une pièce jointe et seront proposées par les navigateurs web sous forme de téléchargement. |
Exporter toutes les métadonnées. Attention, la réponse peut être très volumineuse en fonction de la configuration des métadonnées :
/api/metadata
Exporter toutes les métadonnées classées par ordre décroissant en prenant en compte la dernière mise à jour :
/api/metadata?defaultOrder=lastUpdated:desc
Exporter uniquement les métadonnées qui contiennent des indicateurs et des groupes d'indicateurs :
/api/metadata?indicators=true&indicatorGroups=true
Exporter l'identifiant et le nom d'affichage de tous les éléments de données, classés par nom d'affichage :
/api/metadata?dataElements:fields=id,name&dataElements:order=displayName:desc
Exporter les éléments de données et les indicateurs dont le nom commence par "ANC" (CPN en français):
/api/metadata?filter=name:^like:ANC&dataElements=true&indicators=true
Lorsque vous voulez échanger des métadonnées avec un ensemble de données, un programme, une combinaison de catégories, un tableau de bord, un ensemble d'options ou un groupe d'éléments de données, d'une instance DHIS2 à une autre, six points d'extrémité sont disponibles à cet effet :
/api/dataSets/{id}/metadata.json

/api/programs/{id}/metadata.json

/api/categoryCombos/{id}/metadata.json

/api/dashboards/{id}/metadata.json

/api/optionSets/{id}/metadata.json

/api/dataElementGroups/{id}/metadata.json
Ces éléments exportés peuvent ensuite être importés en utilisant ceci /api/metadata.
Ces endpoints prennent également en charge les paramètres suivants :
| Nom | Options | Description |
|---|---|---|
| skipSharing (ignorer le partage) | faux/vrai | L'activation de ce paramètre supprime les propriétés de partage des objets exportés. Il s'agit de utilisateur, accès publique, accès des groupes d'utilisateurs, accès des utilisateurs, et accès externe. |
| download | faux/vrai | L'activation de ce paramètre ajoutera l'en-tête HTTP Contenu-Disposition qui spécifie que les données doivent être traitées comme une pièce jointe et seront proposées par les navigateurs web sous forme de téléchargement. |
Cette section décrit l'API d'importation des métadonnées. Les représentations des ressources XML et JSON sont prises en charge. Les métadonnées peuvent être importées à l'aide d'une requête POST.
/api/metadata
L'importateur vous permet d'importer des charges de métadonnées qui peuvent inclure plusieurs entités et un nombre quelconque d'objets par entité. Les éléments de métadonnées exportés via l'API d'exportation de métadonnées peuvent être importés directement.
Le endpoint de l'importation des métadonnées prend en charge une variété de paramètres, énumérés ci-dessous.
Tableau : Paramètres d'importation
| Nom | Options (la première est la valeur par défaut) | Description |
|---|---|---|
| Mode d'importation | COMMIT, VALIDATE (commiter, valider) | Définit le mode d'importation général ; décide s'il faut VALIDER ou COMMITER les métadonnées. Cet paramètre fonctionne de la même manière que la fonction dryRun (essai). |
| identifiant | UID, CODE, AUTO | Définit le schéma d'identification à utiliser pour la mise en correspondance des références. Il faut d'abord essayer UID, puis CODE avant de passer à AUTO. |
| importReportMode | ERRORS, FULL, DEBUG (erreurs, plein, débogage) | Définit le mode de rapport d'importation ; contrôle ce qui est rapporté après l'importation. ERRORS n'inclut que les rapports d'objets pour les objets qui contiennent des erreurs. FULL renvoie un rapport d'objet pour tous les objets importés, et DEBUG renvoie la même chose en plus d'un nom pour l'objet (si disponible). |
| preheatMode (mode préchauffage) | REFERENCE, ALL, NONE (référence, tous, aucun) | Définit le mode de préchauffage ; il est utilisé pour signaler si le préchauffage doit être fait pour TOUS (comme c'était le cas auparavant avec preheatCache=true) ou faire un scan plus intelligent des objets pour voir ce qu'il faut préchauffer (actuellement le paramètre par défaut). Il n'est pas recommandé de le définir sur AUCUN. |
| importStrategy (stratégie d'importation) | CREATE_AND_UPDATE, CREATE, UPDATE, DELETE (créer et mettre à jour, créer, mettre à jour, supprimer) | Définit la stratégie d'importation ; CREATE_AND_UPDATE essaiera de trouver une correspondance avec l'identifiant. Si aucune correspondance n'est trouvée, l'objet sera créé. |
| Mode atomique | ALL, NONE (tous, aucun) | Définit le mode atomique. Dans l'ancien importateur, nous faisions toujours une importation best effort (mode au mieux), ce qui signifie que même si certaines références n'existaient pas, l'importation se faisait quand même (par exemple, des éléments de données manquants dans un groupe d'éléments de données). Par défaut, le nouvel importateur ne permet pas cela et rejette les erreurs de validation. Définir le mode NONE (aucun) émulait l'ancien fonctionnement. |
| flushMode (mode de vidage) | AUTO, OBJET | Définit le mode de vidage, qui contrôle quand vider le cache interne. Il est fortement recommandé de maintenir ce mode sur AUTO (qui est le mode par défaut). N'utilisez OBJECT qu'à des fins de débogage, lorsque vous voyez des exceptions liées à l'hibernation et que vous voulez localiser l'emplacement exact où l'empilement se produit (l'hibernation ne se déclenche qu'au moment du vidage, il peut donc être difficile de savoir quel objet a eu des problèmes). |
| skipSharing (ignorer le partage) | faux, vrai | Permet d'ignorer les propriétés de partage, d'éviter la fusion des éléments partagées lors des mises à jour et l'ajout d'un accès à un groupe d'utilisateurs lors de la création de nouveaux objets. |
| skipValidation (ignorer la validation) | faux, vrai | Permet d'ignorer la validation lors de l'importation. Ce paramètre n'est pas recommandé : NOT RECOMMENDED. |
| async | faux, vrai | Importation asynchrone ; la réponse est renvoyée immédiatement avec un en-tête Emplacement qui pointe vers l'emplacement du rapport d'importation. La charge contient également un objet json de la tâche créée. |
| userOverrideMode (utiliser le mode de remplacement) | NONE, CURRENT, SELECTED (aucun, actuel, sélectionné) | Ceci vous permet de remplacer la propriété utilisateur de chaque objet que vous importez. Les options sont NONE (ne rien faire), CURRENT (utiliser l'utilisateur d'importation), SELECTED (sélectionner un utilisateur spécifique en utilisant overrideUser=X). |
| overrideUser (remplacer l'utilisateur) | ID de l'utilisateur | Si le mode de remplacement de l'utilisateur (userOverrideMode) est défini sur "SELECTED", utilisez ce paramètre pour sélectionner l'utilisateur avec lequel vous voulez effectuer le remplacement. |
REMARQUE Lors de la mise à jour des objets, toutes les valeurs des propriétés seront écrasées même si les nouvelles valeurs sont
null. Veuillez utiliser JSON Patch API si vous voulez effectuer une mise à jour partielle d'un objet.
Voici un exemple de charge d'importation de métadonnées. Vous remarquerez que chaque type d'entité possède sa propre propriété avec un tableau d'objets :
{
  "dataElements": [
    {
      "name": "EPI - IPV 3 doses given",
      "shortName": "EPI - IPV 3 doses given",
      "aggregationType": "SUM",
      "domainType": "AGGREGATE",
      "valueType": "INTEGER_ZERO_OR_POSITIVE"
    },
    {
      "name": "EPI - IPV 4 doses given",
      "shortName": "EPI - IPV 4 doses given",
      "aggregationType": "SUM",
      "domainType": "AGGREGATE",
      "valueType": "INTEGER_ZERO_OR_POSITIVE"
    }
  ],
  "indicators": [
    {
      "name": "EPI - ADS stock used",
      "shortName": "ADS stock used",
      "numerator": "#{LTb8XeeqeqI}+#{Fs28ZQJET6V}-#{A3mHIZd2tPg}",
      "numeratorDescription": "ADS 0.05 ml used",
      "denominator": "1",
      "denominatorDescription": "1",
      "annualized": false,
      "indicatorType": {
        "id": "kHy61PbChXr"
      }
    }
  ]
}
Lors de l'envoi de cette charge au endpoint des métadonnées, la réponse contiendra des informations sur les paramètres utilisés lors de l'importation et un récapitulatif par type d'entité, lequel contiendra le nombre d'objets créés, mis à jour, supprimés et ignorés :
{
  "importParams": {
    "userOverrideMode": "NONE",
    "importMode": "COMMIT",
    "identifier": "UID",
    "preheatMode": "REFERENCE",
    "importStrategy": "CREATE_AND_UPDATE",
    "atomicMode": "ALL",
    "flushMode": "AUTO",
    "skipSharing": false,
    "skipTranslation": false,
    "skipValidation": false,
    "metadataSyncImport": false,
    "firstRowIsHeader": true,
    "username": "UNICEF_admin"
  },
  "status": "OK",
  "typeReports": [
    {
      "klass": "org.hisp.dhis.dataelement.DataElement",
      "stats": {
        "created": 2,
        "updated": 0,
        "deleted": 0,
        "ignored": 0,
        "total": 2
      }
    },
    {
      "klass": "org.hisp.dhis.indicator.Indicator",
      "stats": {
        "created": 1,
        "updated": 0,
        "deleted": 0,
        "ignored": 0,
        "total": 1
      }
    }
  ],
  "stats": {
    "created": 3,
    "updated": 0,
    "deleted": 0,
    "ignored": 0,
    "total": 3
  }
}
L'importation GeoJSON est utilisée pour relier les données géométriques aux unités d'organisation.
Pour une importation en masse, il faut un fichier GeoJSON avec une collection d'éléments. Chaque élément de la collection a besoin d'une référence à l'unité d'organisation à laquelle il doit être relié.
Par défaut, la géométrie du fichier est stockée en tant que propriété geometry d'une unité d'organisation. Pour stocker des géométries supplémentaires, des attributs de type GEOJSON peuvent être créés. Lorsque des attributs sont utilisés, toutes les géométries d'un fichier sont stockées pour le même attribut qui est fourni avec un paramètre supplémentaire attributeId.
Tableau : Paramètres d'importation
| Nom | Type | Par défaut | Description |
|---|---|---|---|
geoJsonId | boolean | true | Si le paramètre est défini sur true, la propriété id des éléments GeoJSON est censée contenir l'identifiant de l'unité d'organisation. |
geoJsonProperty | String | non défini | Si geoJsonId est défini sur false, ce paramètre nomme la propriété dans les properties de l'élément GeoJSON qui contient l'identifiant de l'unité d'organisation. |
orgUnitProperty | enum: [id, code, name] | id | La propriété de l'unité d'organisation à laquelle se réfèrent les identifiants utilisés dans le fichier GeoJSON. |
attributeId | String | non défini | Lorsqu'elle est définie, la géométrie est stockée en tant que valeur de l'attribut référencé par l'ID. |
dryRun | boolean | faux | Si le paramètre est défini sur true, l'importation est traitée sans que les unités d'organisation ne soient mis à jour. |
async | boolean | faux | Lorsque le paramètre est défini sur true, l'importation est traitée de manière asynchrone. |
Uasge:
POST /api/organisationUnits/geometry
Le corps du message est le fichier GeoJSON. Le type de contenu doit être application/json ou application/geo+json. Le fichier peut être compressé en .zip ou .gzip.
Par exemple, un fichier par défaut dans lequel id est utilisé pour faire référence à l'identifiant d'une unité d'organisation a la structure suivante :
{
  "type": "FeatureCollection",
  "features": [
    {
      "type": "Feature",
      "id": "O6uvpzGd5pu",
      "geometry": { ... }
    },
    ...
  ]
}
Un fichier dans lequel une propriété d'élément est utilisée pour faire référence au code de l'unité d'organisation devrait avoir la structure suivante :
{
  "type": "FeatureCollection",
  "features": [
    {
      "type": "Feature",
      "properties": { "code": "OU1_CODE" },
      "geometry": { ... }
    },
    ...
  ]
}
coordonnées d'une géométrie peuvent être des paires ou des triplets. Si une troisième dimension est présente, elle est supprimée lors de l'importation. Une geometry peut également être null pour effacer ou supprimer efficacement la géométrie pour des unités d'organisation spécifiques. Il existe une API spéciale de suppression en masse ; elle est décrite dans la section suivante.
Lorsqu'elle est exécutée de manière synchrone, un rapport d'importation est renvoyé directement. Le code de statut HTTP est toujours OK, le status dans le message indique si toutes les lignes ont été importées avec succès. Les statistiques sur le nombre de lignes importées, contenues dans le rapport donnent des informations supplémentaires :
imported : nombre d'unités d'organisation qui ont été mises à jour avec succès avec une géométrie qui n'en avait pas pour la propriété mise à jour.updated : nombre d'unités d'organisation qui ont été mises à jour avec succès avec une géométrie qui avait déjà une valeur pour la propriété mise à jour.ignored : nombre d'unités d'organisation qui n'ont pas été mises à jourdeleted : nombre d'unités d'organisation qui ont été mises à jour avec succès avec une géométrie vide.Lorsque l'importation est exécutée de manière asynchrone, la requête renvoie immédiatement le statut OK de même que la réponse de configuration de la tâche qui contient une référence relative au point d'extrémité de la tâche qui permet de suivre le statut de l'importation asynchrone. Voici un exemple :
/api/system/tasks/GEOJSON_IMPORT/{job-id}
Le récapitulatif renvoyé directement pour une exécution synchrone est disponible à l'adresse suivante
/api/system/taskSummaries/GEOJSON_IMPORT/{job-id}
dès que l'importation est terminée.
Pour effacer ou désactiver les données geometry pour toutes les unités d'organisation, utilisez :
DELETE /api/organisationUnits/geometry
Pour effacer ou désactiver les données géométriques d'un attribut GEOJSON spécifique pour toutes les unités d'organisation :
DELETE /api/organisationUnits/geometry?attributeId={attr-id}
Le nettoyage se fait toujours de façon synchrone et renvoie un rapport similaire à celui de l'importation en masse. Il ne prend en charge aucun autre paramètre. Aucun essai ne peut être effectué. Pour effectuer un nettoyage en masse, l'utilisateur doit disposer de l'autorité F_PERFORM_MAINTENANCE.
L'importation unique permet de mettre à jour la géométrie d'une seule unité d'organisation.
POST /api/organisationUnits/{id}/geometry
Le corps du message ne contient que la valeur GeoJSON geometry, par exemple :
{
  "type": "Polygon",
  "coordinates": [...]
}
attributeId et dryRun. Pour effacer les données GeoJSON de la géométrie d'une seule unité d'organisation, utilisez ceci :
DELETE /api/organisationUnits/{id}/geometry
De même, pour effacer une valeur d'attribut GEOJSON pour une seule unité d'organisation, utilisez ceci :
DELETE /api/organisationUnits/{id}/geometry?attributeId={attr-id}
Le nettoyage se fait toujours de manière synchrone et renvoie un rapport similaire à celui d'une importation simple. Le paramètre dry-run est également pris en charge. L'utilisateur qui effectue l'opération doit disposer de l'autorité qui lui permet de modifier l'unité d'organisation cible.
Pour effectuer une introspection sur tous les objets DXF 2 disponibles, vous pouvez utiliser une ressource disponible à l'adresse /api/schemas. Pour obtenir des ressources spécifiques, vous pouvez consulter /api/schemas/<type>.
Pour obtenir tous les schémas disponibles au format XML :
GET /api/schemas.xml
Pour obtenir tous les schémas disponibles au format JSON :
GET /api/schemas.json
Pour obtenir le schéma JSON d'une classe spécifique :
GET /api/schemas/dataElement.json
DHIS2 dispose d'une collection d'icônes qui peuvent être utilisées pour donner un contexte visuel aux métadonnées. Il existe deux types d'icônes : - Icônes par défaut : elles sont préinstallées dans l'application et ne peuvent ni être modifiées, ni être supprimées. - Icônes personnalisées : elles peuvent être créées, mises à jour et supprimées à volonté.
Ces deux types sont accessibles via la ressource "icônes".
GET /api/icons
Ce point d'extrémité renvoie une liste d'informations sur les icônes par défaut et les icônes personnalisées disponibles. Par défaut, la clé, la description, les mots-clés et la href sont inclus dans la réponse. Mais le paramètre "champs" peut être utilisé pour modifier ce comportement.
{
  key: "mosquito_outline",
  description: "Mosquito outline",
  keywords: [
    "malaria",
    "mosquito",
    "dengue"
  ],
  "created": "2024-02-12T09:50:11.794",
  "lastUpdated": "2024-02-12T09:50:11.794",
  href: "<dhis server>/api/icons/mosquito_outline/icon.svg"
}
Il est également possible d'obtenir directement une icône spécifique en la filtrant par sa clé. Dans l'exemple ci-dessous, la clé est mosquito_outline.
GET /api/icons/mosquito_outline
Une liste d'icônes personnalisées peut être récupérée sur la base de quelques paramètres de requête.
GET /api/icons?type=CUSTOM
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
type | Text | DEFAULT,CUSTOM,ALL (par défaut, personnalisés, tous) | Type d'icônes à récupérer. La valeur par défaut est TOUS |
keys | Text | Liste des clés pour lesquelles des icônes personnalisées doivent être récupérées | |
keywords | Text | Liste des mots clés pour lesquelles des icônes personnalisées doivent être récupérées | |
search | Text | Recherche d'un texte donné dans les clés et les mots-clés des icônes, et récupération de toutes les icônes qui contiennent ce texte dans leur clé ou leurs mots-clés. | |
createdStartDate | Date | Point de départ de la date de création | |
createdEndDate | Date | Point final de la date de création | |
lastUpdatedStartDate | Date | Point de départ de la dernière date de mise à jour | |
lastUpdatedEndDate | Date | Point final de la dernière date de mise à jour |
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
page | Integer | Tout entier positif | Numéro de page à renvoyer. La valeur par défaut est 1 si rien n'est fourni. |
pageSize | Integer | Tout entier positif | Taille de la page. La valeur par défaut est 50. |
paging | Boolean | true|false | Indique si la pagination doit être ignorée et si toutes les lignes doivent être renvoyées. La valeur par défaut est true, ce qui signifie que par défaut toutes les requêtes sont paginées, sauf si paging=false (c'est-à-dire si le paramètre "pagination" est défini sur "faux") |
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
order | Text | created:desc | Liste de paires de noms de propriétés et de directions de tri séparées par des virgules, au format propName:sortDirection. Par défaut, les icônes sont ordonnées comme suit : key:asc |
Les points d'extrémité acceptent un paramètre fields qui contrôle les champs qui seront renvoyés dans la réponse JSON. Le paramètre fields accepte une liste de noms de champs séparés par des virgules. Si rien n'est spécifié, les champs par défaut seront utilisés. Il s'agit de
key,keywords,description,fileResourceUid,createdByUserUid,href (clé, mots-clés, description, uid de la ressource du fichier, uid de la création par l'utilisateur, href)
Vous pouvez télécharger une ressource d'icône personnalisée en fournissant la clé d'icône suivante :
GET /api/icons/{key}/icon
Des icônes personnalisées peuvent être créées, modifiées et supprimées. Pour créer une icône personnalisée, utilisez la ressource ci-dessous.
POST /api/icons
Elle attend une charge contenant la clé de l'icône, la description, la liste des mots-clés et l'identifiant de la ressource du fichier à relier aux données.
{
    "key": "iconKey",
    "description": "description",
    "keywords": ["keyword 1","keyword 2"],
    "fileResourceUid": "ARsqBjfB2cf"
}
Seules les icônes personnalisées peuvent être mises à jour à l'aide de la ressource ci-dessous.
PUT /api/icons
La charge suivante permet de mettre à jour la description et les mots-clés de l'icône.
{
    "key": "iconKey",
    "description": "new description",
    "keywords": ["new keyword 1", "new keyword 2"]
}
Il est également possible de ne mettre à jour qu'un seul des deux éléments. Cela signifie que si nous voulons mettre à jour la description tout en gardant les mots-clés tels qu'ils sont, nous n'aurons qu'à fournir la clé de l'icône et le champ json de la description. Le même procédé s'applique dans l'autre sens, si nous voulons mettre à jour les mots-clés et laisser la description initiale intacte.
Seules les icônes personnalisées peuvent être supprimées à l'aide de la ressource ci-dessous.
DELETE /api/icons/{icon_key}
Certains types de métadonnées ont une propriété appelée renderType (type de rendu). Cette propriété établit une correspondance entre un appareil et un renderingType. Les applications peuvent utiliser ces informations pour savoir comment l'objet doit être rendu sur un appareil spécifique. Par exemple, le rendu d'un élément de données sur un appareil mobile peut être différent de celui d'un ordinateur de bureau.
Il existe actuellement deux types de rendu :
Rendu de type "valeur"
Rendu des sections d'étape de programme
Il existe également deux types d'appareils :
MOBILE
DESKTOP
Le tableau suivant énumère les métadonnées et les types de rendu disponibles. Le rendu de type valeur a des contraintes supplémentaires basées sur la configuration des métadonnées. Elles seront présentées dans un second tableau.
Tableau : Aperçu des métadonnées et des types de restitution
| Type de métadonnées | Types de restitution disponibles |
|---|---|
| Section des étapes de programme | * LISTING (ou liste, par défaut) * SEQUENTIAL (séquentiel) * MATRIX (matrice) |
| Élément de données | * DEFAULT * DROPDOWN * VERTICAL_RADIOBUTTONS * HORIZONTAL_RADIOBUTTONS * VERTICAL_CHECKBOXES * HORIZONTAL_CHECKBOXES * SHARED_HEADER_RADIOBUTTONS * ICONS_AS_BUTTONS * SPINNER * ICON * TOGGLE * VALUE * SLIDER * LINEAR_SCALE * AUTOCOMPLETE * QR_CODE * BAR_CODE * GS1_DATAMATRIX |
Étant donné que la gestion du rendu par défaut des éléments de données et des attributs d'entités suivies dépend du type de valeur de l'objet, il existe également un type DEFAULT qui permet d'indiquer au client qu'il doit être géré normalement. La section des étapes de programme est définie sur LISTING par défaut.
Tableau : Types de restitution autorisés en fonction des types de valeurs
| Type de valeur | L'objet est-il un ensemble d'options ? | Types de restitution autorisés |
|---|---|---|
| TRUE_ONLY (vrai uniquement) | Non | DEFAULT, VERTICAL_RADIOBUTTONS, HORIZONTAL_RADIOBUTTONS, VERTICAL_CHECKBOXES, HORIZONTAL_CHECKBOXES, TOGGLE |
| BOOLEAN | Non | |
| - | Oui | DEFAULT, DROPDOWN, VERTICAL_RADIOBUTTONS, HORIZONTAL_RADIOBUTTONS, VERTICAL_CHECKBOXES, HORIZONTAL_CHECKBOXES, SHARED_HEADER_RADIOBUTTONS, ICONS_AS_BUTTONS, SPINNER, ICON |
| INTEGER | Non | DEFAULT, VALUE, SLIDER, LINEAR_SCALE, SPINNER |
| TEXT | Non | DEFAULT, VALUE, AUTOCOMPLETE, QR_CODE, BAR_CODE, GS1_DATAMATRIX |
| INTEGER_POSITIVE | Non | |
| INTEGER_NEGATIVE | Non | |
| INTEGER_ZERO_OR_POSITIVE | Non | |
| NUMBER | Non | |
| UNIT_INTERVAL | Non | |
| PERCENTAGE | Non |
Vous pouvez également récupérer une référence complète du tableau précédent en utilisant le point d'extrémité suivant :
GET /api/staticConfiguration/renderingOptions
Quelques propriétés supplémentaires peuvent être définies pour le rendu du type de valeur, ce qui est souvent nécessaire lors du rendu de certains types spécifiques :
Tableau : propriétés de l'objet renderType
| Propriété | Description | Type |
|---|---|---|
| type | Le type de restitution de l'objet, tel qu'indiqué dans le premier tableau. Cette propriété est la même pour le type de valeur et la section des étapes de programme, mais c'est la seule propriété disponible pour la section des étapes de programme. | Énumération (voir la liste dans le tableau des métadonnées et des types de restitution) |
| min | Uniquement pour la restitution du type de valeur ; elle représente la valeur minimale que ce champ peut avoir. | Entier |
| max | Uniquement pour la restitution du type de valeur ; elle représente la valeur maximale que ce champ peut avoir. | Entier |
| étape | Uniquement pour la restitution de type valeur ; elle représente la taille des étapes que la valeur doit augmenter, par exemple pour SLIDER ou LINEAR_SCALE. | Entier |
| points décimaux | Uniquement pour la restitution du type de valeur ; elle représente le nombre de points décimaux que la valeur doit utiliser. | Entier |
Le type de rendu peut être défini lors de la création ou de la mise à jour des métadonnées énumérées dans le premier tableau. Voici un exemple de charge pour le type de rendu de la section des étapes de programme :
{
  "renderingType": {
    "type": "MATRIX"
  }
}
Pour les éléments de données et les attributs d'entités suivies :
{
  "renderingType": {
    "type": "SLIDER",
    "min": 0,
    "max": 1000,
    "step": 50,
    "decimalPoints": 0
  }
}
La plupart des métadonnées ont une propriété "style". Cette propriété peut être utilisée par les clients pour représenter l'objet d'une certaine manière. Les propriétés actuellement prises en charge par le style sont les suivantes :
Tableau : Propriétés du style
| Propriété | Description | Type |
|---|---|---|
| couleur | Une couleur, représentée par une valeur hexadécimale. | Chaîne (#000000) |
| icône | Une icône, représentée par un nom d'icône. | Chaîne |
Actuellement, il n'existe pas de liste officielle ni de bibliothèques d'icônes. Il revient donc au client de les fournir. La liste suivante présente tous les objets qui prennent en charge le style :
Élément de données
Option de catégorie d'éléments de données
Ensemble de données
Indicateur
Option
Programme
Indicateur du programme
Section du programme
Étape du programme
Section des étapes de programme
Relation (Tracker)
Attribut d’entité suivie
Type d'entité suivie
Lors de la création ou de la mise à jour de l'un de ces objets, vous pouvez inclure la charge suivante pour modifier le style :
{
  "style": {
    "color": "#ffffff",
    "icon": "my-beautiful-icon"
  }
}
The category merge endpoint allows you to merge a number of categories (sources) into a target category.
Note
Categories can only be merged when:
- they have identical category options
- source and target categories do not share category combos
- source categories do not share category combos with each other
These constraints ensure only duplicate Categories can be merged, and it helps to keep system integrity.
The main authority required to perform a category merge is F_CATEGORY_MERGE.
Merge categories with a POST request:
POST /api/categories/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "FbLZS3ueWbQ",
    "dPSWsKeAZNw"
  ],
  "target": "rEq3Hkd3XXH",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Array of identifiers of the categories to merge (the source categories) |
| cible | Oui | Identifier of the category to merge the sources into (the target category) |
| deleteSources | Non | Whether to delete the source categories after the operation. Default is false. |
The merge operation will merge the source categories into the target category. One or many source categories can be specified. Only one target should be specified.
The merge operation will transfer all source category metadata associations to the target category. The following metadata get updated:
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| CategoryOption | categories | remove sources |
| CategoryCombo | categories | remove sources, add target |
| CategoryDimension | dimension | replace source with target |
| Utilisateur | catDimensionConstraints | - User has one or more sources and target -> delete all source constraints - User has one or more sources, no target -> update one source to target, delete other source constraints |
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source Category must be specified |
| E1531 | Target Category must be specified |
| E1532 | Target Category cannot be a source category |
| E1533 | Source/Target Category does not exist: {uid} |
| E1535 | Source CategoryOptions do not match target CategoryOptions |
| E1536 | Source and target Categories cannot share a CategoryCombo |
| E1537 | Source Categories cannot share a CategoryCombo |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "Category",
            "sourcesDeleted": [
                "FbLZS3ueWbQ", "dPSWsKeAZNw"
            ],
            "message": "Category merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source Category must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target Category does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "Category",
            "sourcesDeleted": [],
            "message": "Category merge has errors"
        }
    }
}
The category option merge endpoint allows you to merge a number of category options (sources) into a target category option.
The main authority required to perform a category option merge is F_CATEGORY_OPTION_MERGE.
Other authorities required relate to the general sharing and access of category options, F_CATEGORY_OPTION_PUBLIC_ADD and F_CATEGORY_OPTION_DELETE.
Merge category options with a POST request:
POST /api/categoryOptions/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "FbLZS3ueWbQ",
    "dPSWsKeAZNw"
  ],
  "target": "rEq3Hkd3XXH",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Array of identifiers of the category options to merge (the source category options) |
| cible | Oui | Identifier of the category option to merge the sources into (the target category option) |
| deleteSources | Non | Whether to delete the source category options after the operation. Default is false. |
The merge operation will merge the source category options into the target category option. One or many source category options can be specified. Only one target should be specified.
The merge operation will transfer all source category option metadata associations to the target category option. The following metadata get updated:
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| Catégorie | categoryOptions | remove sources, add target |
| CategoryDimension | items | remove sources, add target |
| CategoryOptionCombo | categoryOptions | remove sources, add target |
| CategoryOptionGroup | membres | remove sources, add target |
| Unité d'organisation | categoryOptions | remove sources, add target |
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source CategoryOption must be specified |
| E1531 | Target CategoryOption must be specified |
| E1532 | Target CategoryOption cannot be a source category option |
| E1533 | Source/Target CategoryOption does not exist: {uid} |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "CategoryOption",
            "sourcesDeleted": [
                "FbLZS3ueWbQ", "dPSWsKeAZNw"
            ],
            "message": "CategoryOption merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source CategoryOption must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target CategoryOption does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "CategoryOption",
            "sourcesDeleted": [],
            "message": "CategoryOption merge has errors"
        }
    }
}
CategoryOptionCombos are unique in that they are auto-generated by the system, most of the time (imports are allowed with specific expectations, mentioned below). They are generated based on their category model:
- CategoryOption - Category (has category options) - CategoryCombo (has categories)
There will be a CategoryOptionCombo created for each combination of Category CategoryOption.
CategoryCombo [CC1] Category has 2 CategoryOptions C1=[CO1, CO2], C2=[CO3, CO4]CategoryOptionCombos from this category model would produce 4 CategoryOptionCombos: This is important to understand when trying to import CategoryOptionCombos. Validation is performed when importing CategoryOptionCombos to ensure that the provided set of CategoryOptionCombos matches the expected generated set of CategoryOptionCombos. This is to ensure no invalid state/relationships can enter the system, which prevent all sorts of issues (orphaned data, hidden relationships in the DB not exposed in the API etc.).
Note
This validation is performed using the
UIDs of theCategoryOptionCombos. No otheridSchemeis supported.
The category option combo merge endpoint allows you to merge a number of category options (sources) into a target category option. This can be used to clean up the system, removing duplicates for instance.
Note
Only duplicate category option combos can be merged. There's more info about this in the validation section below.
The main authority required to perform a category option combo merge is F_CATEGORY_OPTION_COMBO_MERGE.
Merge category option combos with a POST request:
POST /api/categoryOptionCombos/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "FbLZS3ueWbQ",
    "dPSWsKeAZNw"
  ],
  "target": "rEq3Hkd3XXH",
  "dataMergeStrategy": "DISCARD"
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Array of identifiers of the category option combos to merge (the source category option combos) |
| cible | Oui | Identifier of the category option combo to merge the sources into (the target category option combo) |
| dataMergeStrategy | Oui | How to handle merging of data values. Options are 'DISCARD' or 'LAST_UPDATED'. DISCARD will delete all source data values. LAST_UPDATED will merge all data values and use the last updated value where duplicates are met. |
The merge operation will merge the source category option combos into the target category option combo. One or many source category option combos can be specified. Only one target should be specified.
The merge operation will transfer all source category option combo metadata associations to the target category option combo.
Note
All source category option combos will always be deleted during a merge. The is because after all source references have been handled, empty category option combos are left. These are not seen as valid by the system.
The following metadata get updated:
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| CategoryOption | categoryOptionCombos | remove sources |
| CategoryCombo | optionCombos | remove sources |
| DataElementOperand | categoryOptionCombo | set as target |
| DataDimensionItem | dataelementoperand_categoryoptioncomboid | set as target |
| Expression | expression | replace source with target |
| Indicateur | numérateur | replace source with target |
| Indicateur | dénominateur | replace source with target |
| MinMaxDataElement | Combinaison d'options | set as target |
| Prédicteur | outputCombo | set as target |
| SMSCode | optionId | set as target |
| Données | Propriété | Mesure prise |
|---|---|---|
| DataValue | categoryOptionCombo | merge strategy (DISCARD or LAST_UPDATED) |
| DataValue | attributeOptionCombo (combinaison d'options d'attribut) | merge strategy (DISCARD or LAST_UPDATED) |
| DataApproval | attributeOptionCombo (combinaison d'options d'attribut) | merge strategy (DISCARD or LAST_UPDATED) |
| DataApprovalAudit | attributeOptionCombo (combinaison d'options d'attribut) | DISCARD or leave depending if sources are deleted or not |
| Événement | attributeOptionCombo (combinaison d'options d'attribut) | merge strategy (DISCARD or LAST_UPDATED) |
| DataValueAudit | categoryOptionCombo | DISCARD or leave depending if sources are deleted or not |
| DataValueAudit | attributeOptionCombo (combinaison d'options d'attribut) | DISCARD or leave depending if sources are deleted or not |
| CompleteDataSetRegistration | attributeOptionCombo (combinaison d'options d'attribut) | merge strategy (DISCARD or LAST_UPDATED) |
Note
The following properties haven been purposely excluded from the merge as these may use references for external systems. If you encounter issues with these fields, they may need to be updated.
Indicator: aggregateExportCategoryOptionCombo & aggregateExportAttributeOptionCombo
ProgramIndicator: aggregateExportCategoryOptionCombo & aggregateExportAttributeOptionCombo
The following constraints and error codes apply. One of the main validation points is regarding duplicate CategoryOptionCombos. A duplicate CategoryOptionCombo is one which satisfies the criteria: - has the same CategoryCombo - has the same CategoryOptions - has a different UID
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source CategoryOptionCombo must be specified |
| E1531 | Target CategoryOptionCombo must be specified |
| E1532 | Target CategoryOptionCombo cannot be a source CategoryOptionCombo |
| E1533 | Source/Target CategoryOptionCombo does not exist: {uid} |
| E1534 | dataMergeStrategy field must be specified. With value DISCARD or LAST_UPDATED |
| E1540 | CategoryOptionCombos must be duplicates (same cat combo, same cat options, different UID) in order to merge |
There are unique constraints in place that can prevent a successful merge. These constraints are set by DHIS2 in order to maintain a logical domain model.
Below are a list of the known database unique key constraints at the time of writing. For example, you can only have 1 min max data element with the same org unit, data element and category option combo.
| Tableau | Unique key constraint |
|---|---|
| minmaxdataelement | orgunit, dataelement, categoryoptioncombo |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "CategoryOptionCombo",
            "sourcesDeleted": [
                "FbLZS3ueWbQ", "dPSWsKeAZNw"
            ],
            "message": "CategoryOptionCombo merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source CategoryOptionCombo must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target CategoryOptionCombo does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "CategoryOptionCombo",
            "sourcesDeleted": [],
            "message": "CategoryOptionCombo merge has errors"
        }
    }
}
A database constraint sample error response:
{
  "httpStatus": "Conflict",
  "httpStatusCode": 409,
  "status": "ERROR",
  "message": "ERROR: duplicate key value violates unique constraint \"minmaxdataelement_unique_key\"\n  Detail: Key (sourceid, dataelementid, categoryoptioncomboid)=(193236, 1148617, 167661) already exists."
}
The category combo merge endpoint allows you to merge a number of category combos (sources) into a target category combo.
Note
Category combos can only be merged when:
- source and target category combos have identical categories
- all category option combos belonging to the involved category combos are valid (correct number of options, valid option membership)
- no pre-existing duplicate category option combos exist within the involved category combos
These constraints ensure only equivalent category combos can be merged and help maintain system integrity.
Warning
A category combo merge will result in duplicate category option combos. These should be merged immediately after the category combo merge to maintain system integrity. Duplicates can be found using the data integrity check
category_option_combos_have_duplicates.
The main authority required to perform a category combo merge is F_CATEGORY_COMBO_MERGE.
Merge category combos with a POST request:
POST /api/categoryCombos/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "FbLZS3ueWbQ",
    "dPSWsKeAZNw"
  ],
  "target": "rEq3Hkd3XXH",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Array of identifiers of the category combos to merge (the source category combos) |
| cible | Oui | Identifier of the category combo to merge the sources into (the target category combo) |
| deleteSources | Non | Whether to delete the source category combos after the operation. Default is false. |
The merge operation will merge the source category combos into the target category combo. One or many source category combos can be specified. Only one target should be specified.
The merge operation will transfer all source category combo metadata associations to the target category combo. The following metadata get updated:
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| Catégorie | categoryCombos | remove sources |
| CategoryOptionCombo | categoryCombo | set as target |
| DataElement | categoryCombo | set as target |
| DataSetElement | categoryCombo | set as target |
| Ensemble de données | categoryCombo | set as target |
| Programme | categoryCombo | set as target |
| Programme | enrollmentCategoryCombo | set as target |
| ProgramIndicator | categoryCombo | set as target |
| ProgramIndicator | attributeCategoryCombo | set as target |
| DataApprovalWorkflow | categoryCombo | set as target |
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source CategoryCombo must be specified |
| E1531 | Target CategoryCombo must be specified |
| E1532 | Target CategoryCombo cannot be a source CategoryCombo |
| E1533 | Source/Target CategoryCombo does not exist: {uid} |
| E1545 | Source and target CategoryCombos must have identical Categories: source {uid} has {categories} |
| E1546 | CategoryOptionCombo has incorrect number of CategoryOptions. Expected {n} but found {m} for COC: {uid} |
| E1547 | CategoryOptionCombo has CategoryOptions that are not valid for the CategoryCombo categories: {uid} |
| E1548 | Duplicate CategoryOptionCombo {uid} found for CategoryCombo {uid}. Fix this before attempting the merge. |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "CategoryCombo",
            "sourcesDeleted": [
                "FbLZS3ueWbQ", "dPSWsKeAZNw"
            ],
            "message": "CategoryCombo merge complete. There will be duplicate CategoryOptionCombos as a result of the merge. These should be merged immediately to help keep system integrity. Duplicates can be found using the data integrity check `category_option_combos_have_duplicates`"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source CategoryCombo must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target CategoryCombo does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "CategoryCombo",
            "sourcesDeleted": [],
            "message": "CategoryCombo merge has errors"
        }
    }
}
Caution
Merging DataElements should be carried out with the utmost care. Particular attention should be given to the merging of data values that have data element references involved in the merge. Knowing the potential side effects of a merge should be fully understood before performing the merge. The merging of DataElements has far-reaching effects. The information below will try to help show what's involved in a DataElement merge. A DataElement merge touches all the major parts of the system (metadata, data, tracker, analytics and audit).
System performance may be impacted if the source DataElements are linked to large amounts of Data/Audit records particularly.
The data element merge endpoint allows you to merge a number of data elements (sources) into a target data element.
The main authority required to perform a data element merge is F_DATA_ELEMENT_MERGE.
Other authorities required relate to the general sharing and access of data elements, F_DATAELEMENT_PUBLIC_ADD and F_DATAELEMENT_DELETE.
Merge data elements with a POST request:
POST /api/dataElements/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "jNb63DIHuwU",
    "WAjjFMDJKcx"
  ],
  "target": "V9rfpjwHbYg",
  "deleteSources": true,
  "dataMergeStrategy": "DISCARD"
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Array of identifiers of the data elements to merge (the source data elements) |
| cible | Oui | Identifier of the data element to merge the sources into (the target data element) |
| deleteSources | Non | Whether to delete the source data elements after the operation. Default is false. If true is chosen, then all source audit records will also be deleted. |
| dataMergeStrategy | Oui | How to handle merging of data values. Options are 'DISCARD' or 'LAST_UPDATED'. DISCARD will delete all source data values. LAST_UPDATED will merge all data values and use the last updated value where duplicates are met. |
The merge operation will merge the source data elements into the target data element. One or many source data elements can be specified. Only one target should be specified.
The merge operation will transfer all source data element metadata associations to the target data element. The following metadata get updated:
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| DataDimensionItem | dataElement | set to target |
| EventVisualization | dataElementValueDimension | set to target |
| ProgramStageDataElement | dataElement | set to target |
| Modèle de notification de programme | recipientDataElement | set to target |
| Variable de règle de programme | dataElement | set to target |
| Action de règle de programme | dataElement | set to target |
| TrackedEntityDataElementDimension | dataElement | set to target |
| MinMaxDataElement | dataElement | set to target |
| SMSCode | dataElement | set to target |
| SMSCode | dataElement | set to target |
| Prédicteur | output | set to target |
| DataSetElement | dataElement | set to target |
| DataElementOperand | dataElement | set to target |
| ProgramStageDataElement | dataElements | remove sources, add target |
| Section | dataElements | remove sources, add target |
| Groupe d'Eléments de Données | membres | remove sources, add target |
| Événement | eventDataValues | remove sources, add target |
| Indicateur | numérateur | replace source with target |
| Indicateur | dénominateur | replace source with target |
| Prédicteur | generator | replace source with target |
| Prédicteur | sampleSkipTest | replace source with target |
| Formulaire de saisie de données | code html | replace source with target |
| ProgramIndicator | expression | replace source with target |
| ProgramIndicator | filter | replace source with target |
| DataValue | dataElement |
| Données | Propriété | Mesure prise |
|---|---|---|
| Événement | eventDataValues | action based on merge strategy (DISCARD / LAST_UPDATED). DISCARD will delete all source event data values. LAST_UPDATED will use the event data value which was last updated, when more than one exists. |
| DataValue | dataElement | action based on merge strategy (DISCARD / LAST_UPDATED). DISCARD will delete all source data values. LAST_UPDATED will use the data value which was last updated, when more than one exists. |
| TrackedEntityDataValueChangeLog | deleted if sources are being deleted, otherwise no action. | |
| DataValueAudit | deleted if sources are being deleted, otherwise no action. |
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source DataElement must be specified |
| E1531 | Target DataElement must be specified |
| E1532 | Target DataElement cannot be a source indicator |
| E1533 | Source/Target DataElement does not exist: {uid} |
| E1550 | All source ValueTypes must match target ValueType: ValueType. Other ValueTypes found: ValueType |
| E1551 | All source DataElementDomains must match target DataElementDomain: DataElementDomain. Other DataElementDomains found: DataElementDomain |
| E1534 | dataMergeStrategy field must be specified. With value DISCARD or LAST_UPDATED |
There are unique constraints in place that can prevent a successful merge. These constraints are set by DHIS2 in order to maintain a logical domain model.
Below are a list of the known database unique key constraints at the time of writing. For example, you can only have 1 data set element with the same dataset and data element.
| Tableau | Unique key constraint |
|---|---|
| minmaxdataelement | orgunit, dataelement, categoryoptioncombo |
| programstagedataelement | programstage, dataelement |
| datasetelement | dataset, dataelement |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "DataElement",
            "sourcesDeleted": [
                "vQ0dGV9EDrw"
            ],
            "message": "DataElement merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source DataElement must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target DataElement does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "DataElement",
            "sourcesDeleted": [],
            "message": "DataElement merge has errors"
        }
    }
}
Another sample validation error response:
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "All source ValueTypes must match target ValueType: `TEXT`. Other ValueTypes found: `NUMBER`",
                    "errorCode": "E1550",
                    "args": []
                }
            ],
            "mergeType": "DataElement",
            "sourcesDeleted": [],
            "message": "DataElement merge has errors"
        }
    }
}
A database constraint sample error response:
{
  "httpStatus": "Conflict",
  "httpStatusCode": 409,
  "status": "ERROR",
  "message": "ERROR: duplicate key value violates unique constraint \"minmaxdataelement_unique_key\"\n  Detail: Key (sourceid, dataelementid, categoryoptioncomboid)=(193236, 1148617, 167661) already exists."
}
Cette section décrit les indicateurs et les expressions d'indicateurs.
Pour récupérer les indicateurs, vous pouvez lancer une requête GET à la ressource des indicateurs comme suit :
/api/indicators
Les indicateurs représentent des expressions qui peuvent être calculées et présentées sous forme de résultat. Les expressions des indicateurs sont divisées en un numérateur et un dénominateur. Les numérateurs et les dénominateurs sont des expressions mathématiques qui peuvent contenir des références à des éléments de données, à d'autres indicateurs, à des constantes et à des groupes d'unités d'organisation. Les variables seront remplacées par des valeurs de données lorsqu'elles seront utilisées, par exemple dans des rapports. Les variables autorisées dans les expressions sont décrites dans le tableau suivant.
Tableau : Variables d'indicateurs
| Variable | Objet | Description |
|---|---|---|
| #{<data-element-id>.<category-option-combo-id>.<attribute-option-combo-id>} | Opérande de l'élément de données | Fait référence à la combinaison d'un élément de données agrégé et d'une combinaison d'options de catégorie. Les identifiants des combinaisons d'options de catégorie et d'attribut sont facultatifs et le symbole "*" peut être utilisé pour indiquer n'importe quelle valeur. |
| #{<dataelement-id>.<category-option-group-id>.<attribute-option-combo-id>} | Groupe d'options de catégorie | Fait référence à un élément de données agrégé et à un groupe d'options de catégorie, qui contient plusieurs combinaisons d'options de catégorie. |
| #{<data-element-id>} | Élément de données agrégé | Fait référence à la valeur totale d'un élément de données agrégé pour toutes les combinaisons d'options de catégorie. |
| D{<program-id>.<data-element-id>} | Élément de données de programme | Fait référence à la valeur d'un élément de données Tracker au sein d'un programme. |
| A{<program-id>.<attribute-id>} | Attribut d'entité suivie d'un programme | Fait référence à la valeur d'un attribut d'entité suivie au sein d'un programme. |
| I{<program-indicator-id>} | Indicateur de programme | Fait référence à la valeur d'un indicateur de programme. |
| R{<dataset-id>.<metric>} | Taux de déclaration | Fait référence à une mesure de taux de déclaration. La mesure peut être REPORTING_RATE (taux de déclaration), REPORTING_RATE_ON_TIME (taux de déclarations à temps), ACTUAL_REPORTS (rapports effectifs), ACTUAL_REPORTS_ON_TIME (rapports envoyés à temps), EXPECTED_REPORTS (rapports attendus). |
| C{<constant-id>} | Constant | Fait référence à une valeur constante. |
| N{<indicator-id>} | Indicateur | Fait référence à un indicateur existant. |
| OUG{<orgunitgroup-id>} | Groupe d'unités d'organisation | Fait référence au nombre d'unités d'organisation présentes dans un groupe d'unités d'organisation. |
Dans un opérande d'élément de données ou dans un élément de données agrégé, les substitutions suivantes peuvent être effectuées :
| Élément | Valeur | Description |
|---|---|---|
| data-element-id | data-element-id | Un élément de données agrégé |
| data-element-id | deGroup:data-element-group-id | Tous les éléments de données agrégés d'un groupe d'éléments de données |
| category-option-combo-id | category-option-combo-id | Une combinaison d'options de catégorie |
| category-option-combo-id | co:category-option-id | Toutes les combinaisons d'options de catégorie dans une option de catégorie |
| category-option-combo-id | coGroup:category-option-group-id | Toutes les combinaisons d'options de catégorie dans un groupe d'options de catégorie |
| category-option-combo-id | coGroup:co-group-id1&co-group-id2... | Toutes les combinaisons d'options de catégorie qui font partie de plusieurs groupes d'options de catégorie |
La syntaxe ressemble à ceci :
#{<dataelement-id>.<catoptcombo-id>} + C{<constant-id>} + OUG{<orgunitgroup-id>}
Voici un exemple correspondant :
#{P3jJH5Tu5VC.S34ULMcHMca} + C{Gfd3ppDfq8E} + OUG{CXw2yu5fodb}
Pour les variables d'éléments de données, l'identifiant de la combinaison d'options de catégorie peut être omis. La variable va alors représenter le total pour l'élément de données, par exemple pour toutes les combinaisons d'options de catégorie. Exemple :
#{P3jJH5Tu5VC} + 2
Les opérandes des éléments de données peuvent inclure toute combinaison d'options de catégorie et toute combinaison d'options d'attributs. Elles peuvent également utiliser des caractères génériques pour indiquer n'importe quelle valeur :
#{P3jJH5Tu5VC.S34ULMcHMca} + #{P3jJH5Tu5VC.*.j8vBiBqGf6O} + #{P3jJH5Tu5VC.S34ULMcHMca.*}
Exemple utilisant un groupe d'éléments de données :
#{deGroup:oDkJh5Ddh7d} + #{deGroup:GBHN1a1Jddh.j8vBiBqGf6O}
Exemple utilisant une option de catégorie, un groupe d'éléments de données et un groupe d'options de catégorie :
#{P3jJH5Tu5VC.co:FbLZS3ueWbQ} + #{deGroup:GBHN1a1Jddh.coGroup:OK2Nr4wdfrZ.j8vBiBqGf6O}
Exemple utilisant plusieurs groupes d'options de catégories :
#{P3jJH5Tu5VC.coGroup:OK2Nr4wdfrZ&j3C417uW6J7&ddAo6zmIHOk}
Exemple utilisant un élément de données de programme et un attribut de programme :
( D{eBAyeGv0exc.vV9UWAZohSf} * A{IpHINAT79UW.cejWyOfXge6} ) / D{eBAyeGv0exc.GieVkTxp4HH}
Exemple combinant des indicateurs de programme et des indicateurs agrégés :
I{EMOt6Fwhs1n} * 1000 / #{WUg3MYWQ7pt}
Exemple utilisant un taux de déclaration :
R{BfMAe6Itzgt.REPORTING_RATE} * #{P3jJH5Tu5VC.S34ULMcHMca}
Un autre exemple de taux de déclaration qui utilise des rapports sur des ensembles de données et des rapports attendus :
R{BfMAe6Itzgt.ACTUAL_REPORTS} / R{BfMAe6Itzgt.EXPECTED_REPORTS}
Exemple utilisant un indicateur existant :
N{Rigf2d2Zbjp} * #{P3jJH5Tu5VC.S34ULMcHMca}
Les expressions peuvent être constituées de tout type d'expression mathématique valide, à titre d'exemple :
( 2 * #{P3jJH5Tu5VC.S34ULMcHMca} ) / ( #{FQ2o8UBlcrS.S34ULMcHMca} - 200 ) * 25
Pour récupérer les indicateurs de programme, vous pouvez effectuer une requête GET à la ressource des indicateurs de programme, comme suit :
/api/programIndicators
Les indicateurs de programme peuvent contenir des informations collectées dans le cadre d'un programme. Les indicateurs ont une expression qui peut contenir des références à des éléments de données, des attributs, des constantes et des variables de programme. Les variables autorisées dans les expressions sont décrites dans le tableau suivant.
Tableau : Variables des indicateurs de programme
| Variable | Description |
|---|---|
| #{<programstage-id>.<dataelement-id>} | Fait référence à une combinaison entre l'étape de programme et l'identifiant de l'élément de données. |
| A{<attribute-id>} | Fait référence à un attribut d'entité suivie. |
| V{<variable-id>} | Fait référence à une variable de programme. |
| C{<constant-id>} | Fait référence à une constante. |
La syntaxe ressemble à ceci :
#{<programstage-id>.<dataelement-id>} + #{<attribute-id>} + V{<varible-id>} + C{<constant-id>}
Voici un exemple correspondant :
#{A03MvHHogjR.a3kGcGDCuk6} + A{OvY4VVhSDeJ} + V{incident_date} + C{bCqvfPR02Im}
Les expressions sont des formules mathématiques qui peuvent contenir des références à des éléments de données, des constantes et des groupes d'unités d'organisation. Pour valider une expression et en obtenir la description sous forme de texte, vous pouvez adresser une requête GET à la ressource des expressions :
/api/expressions/description?expression=<expression-string>
La réponse suit le format standard des messages web JSON. La propriété statut indique le résultat de la validation et sera "OK" en cas de succès et "ERROR" en cas d'échec. La propriété message sera "Valid" (valide) si la validation réussit, et en cas d'échec, elle fournira une description textuelle de la raison de cet échec. La propriété description fournit une description textuelle de l'expression.
{
  "httpStatus": "OK",
  "httpStatusCode": 200,
  "status": "OK",
  "message": "Valid",
  "description": "Acute Flaccid Paralysis"
}
Le point d'extrémité de la fusion des indicateurs vous permet de fusionner des indicateurs (sources) en un seul indicateur cible.
Vous devez disposer de l'autorité F_INDICATOR_MERGE pour pouvoir fusionner des indicateurs.
Fusionner des indicateurs à l'aide d'une requête POST :
POST /api/indicators/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "jNb63DIHuwU",
    "WAjjFMDJKcx"
  ],
  "target": "V9rfpjwHbYg",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Tableau des identifiants des indicateurs à fusionner (les indicateurs sources) |
| cible | Oui | Identifiant de l'indicateur dans lequel les sources doivent être fusionnées (l'indicateur cible) |
| deleteSources | Non | Détermine si les indicateurs source doivent être supprimés après l'opération. La valeur par défaut est "false" |
L'opération de fusion permet de fusionner les indicateurs sources dans l'indicateur cible. Un ou plusieurs indicateurs sources peuvent être spécifiés. Un seul indicateur cible doit être spécifiée.
L'opération de fusion transfère toutes les associations de métadonnées de l'indicateur source vers l'indicateur cible. Les métadonnées suivantes sont mises à jour :
| Métadonnées | Propriété | Mesure prise |
|---|---|---|
| Groupe d'indicateurs | membres | Indicateur source supprimé, indicateur cible ajouté |
| Ensemble de données | indicateurs | Indicateur source supprimé, indicateur cible ajouté |
| Élément dimensionnel de données | n/a | Tous les éléments de données associés à des sources seront reliés à la cible. |
| Section | indicateurs | Indicateur source supprimé, indicateur cible ajouté |
| Configuration | Indicateurs infrastructurels (Groupe d'indicateurs) | Indicateur source supprimé, indicateur cible ajouté |
| Indicateur | numérateur / dénominateur | Remplace toute référence source par la référence cible |
| Formulaire de saisie de données | code html | Remplace toute référence source par la référence cible |
| Visualisation | triage | Remplace toute référence source par la référence cible en tant que dimension de tri |
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | Au moins un indicateur source doit être spécifié |
| E1531 | L'indicateur cible doit être spécifié |
| E1532 | L'indicateur cible ne peut pas être un indicateur source |
| E1533 | L'indicateur source/cible n'existe pas : {uid} |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "Indicator",
            "sourcesDeleted": [
                "vQ0dGV9EDrw"
            ],
            "message": "Indicator merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source Indicator must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target Indicator does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "Indicator",
            "sourcesDeleted": [],
            "message": "Indicator merge has errors"
        }
    }
}
Le point d'extrémité de la fusion des types d'indicateur vous permet de fusionner des types d'indicateurs en un seul type d'indicateur cible.
Vous devez disposer de l'autorité F_INDICATOR_TYPE_MERGE pour pouvoir fusionner des types d'indicateur.
Fusionner des types d'indicateur à l'aide d'une requête POST :
POST /api/indicatorTypes/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "jNb63DIHuwU",
    "WAjjFMDJKcx"
  ],
  "target": "V9rfpjwHbYg",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Tableau des identifiants des types d'indicateurs à fusionner (les types d'indicateurs source). |
| cible | Oui | Identifiant du type d'indicateur dans lequel les sources doivent être fusionnées (le type d'indicateur cible). |
| deleteSources | Non | Détermine si les types d'indicateurs source doivent être supprimés après l'opération. La valeur par défaut est "false" |
L'opération de fusion permet de fusionner les types d'indicateur source dans le type d'indicateur cible. Un ou plusieurs types d'indicateur source peuvent être spécifiés. Un seul type d'indicateur cible doit être spécifiée.
L'opération de fusion combine toutes les associations de métadonnées de l'indicateur et les types d'indicateur source, et le tout est transféré vers le type d'indicateur cible.
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1530 | At least one source IndicatorType must be specified |
| E1531 | Target IndicatorType must be specified |
| E1532 | Target IndicatorType cannot be a source indicator type |
| E1533 | Source/Target IndicatorType does not exist: {uid} |
Voici un exemple de réponse après une opération réussie :
{
    "httpStatus": "OK",
    "httpStatusCode": 200,
    "status": "OK",
    "response": {
        "mergeReport": {
            "mergeErrors": [],
            "mergeType": "IndicatorType",
            "sourcesDeleted": [
                "vQ0dGV9EDrw"
            ],
            "message": "IndicatorType merge complete"
        }
    }
}
Voici un exemple de réponse après une opération erronée :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "WARNING",
    "message": "One or more errors occurred, please see full details in merge report.",
    "response": {
        "mergeReport": {
            "mergeErrors": [
                {
                    "message": "At least one source IndicatorType must be specified",
                    "errorCode": "E1530",
                    "args": []
                },
                {
                    "message": "Target IndicatorType does not exist: `abcdefg1221`",
                    "errorCode": "E1533",
                    "args": [
                        "Target",
                        "abcdefg1221"
                    ]
                }
            ],
            "mergeType": "IndicatorType",
            "sourcesDeleted": [],
            "message": "IndicatorType merge has errors"
        }
    }
}
La ressource organisationUnits suit les conventions standard des autres ressources de métadonnées présents dans DHIS2. Cette ressource prend en charge des paramètres de requête supplémentaires.
Pour obtenir une liste des unités d'organisation, vous pouvez utiliser la ressource suivante :
/api/33/organisationUnits
Tableau : Paramètres de requête des unités d'organisation
| Paramètre de requête | Options | Description |
|---|---|---|
| userOnly | false | true |
| userDataViewOnly | false | true |
| userDataViewFallback | false | true |
| query | chaîne | Requête sur les propriétés de nom, code et ID. |
| niveau | entier | Unités d'organisation au niveau spécifié de la hiérarchie. |
| maxLevel | entier | Unités d'organisation au niveau maximal ou à des niveaux plus élevés dans la hiérarchie. |
| withinUserHierarchy | false | true |
| withinUserSearchHierarchy | false | true |
| memberCollection | chaîne | Permet d'afficher le nombre de membres dans une collection ; renvoie au nom de la collection associée aux unités d'organisation. |
| memberObject | UID | Permet d'afficher le nombre de membres dans une collection ; renvoie à l'identifiant de l'objet qui fait partie de la collection. |
Pour obtenir une unité d'organisation ainsi que les unités d'organisation présentes dans sa sous-hiérarchie, vous pouvez utiliser la ressource suivante.
/api/33/organisationUnits/{id}
Tableau : Paramètres de l'unité d'organisation
| Paramètre de requête | Options | Description |
|---|---|---|
| includeChildren | false | true |
| includeDescendants | false | true |
| includeAncestors | false | true |
| niveau | entier | Inclut les descendants de l'unité d'organisation spécifiée à un niveau précis de la sous-hiérarchie. Ce paramètre dépend de l'unité d'organisation, et commence par le premier niveau qui est directement inférieur à l'unité d'organisation. |
Point d'extrémité conçu pour récupérer les associations entre les options de catégorie et les unités d'organisation. Ce point d'extrémité est le moyen idéal pour récupérer les associations entre les programmes et les unités d'organisation.
/api/33/categoryOptions/orgUnits?categoryOptions={categoryOptionIdA},{categoryOptionIdB}
Les réponses auront le format suivant :
{
  "<categoryOptionIdA>": [
    "<orgUnitUid>",
    "<orgUnitUid>"
  ],
  "<categoryOptionIdB>": [
    "<orgUnitUid>",
    "<orgUnitUid>"
  ],
  "<categoryOptionIdC>": []
}
Les options de catégorie accessibles à toutes les unités d'organisation sont renvoyées avec un tableau d'unités d'organisation vide ([]).
Point d'extrémité conçu pour récupérer les associations entre les programmes et les unités d'organisation. Ce point d'extrémité est le moyen idéal pour récupérer les associations entre les programmes et les unités d'organisation.
/api/33/programs/orgUnits?programs={programIdA},{programIdB}
Les réponses auront le format suivant :
{
  "<programIdA>": [
    "<orgUnitUid>",
    "<orgUnitUid>"
  ],
  "<programIdB>": [
    "<orgUnitUid>",
    "<orgUnitUid>"
  ],
  "<programIdC>": []
}
Les programmes accessibles à toutes les unités d'organisation sont renvoyées avec un tableau d'unités d'organisation vide ([]).
Le point d'extrémité de fractionnement des unités d'organisation vous permet de fractionner des unités d'organisation en un certain nombre d'unités d'organisation cibles.
Fractionner des unités d'organisation à l'aide d'une requête POST :
POST /api/organisationUnits/split
La charge au format JSON ressemble à ceci :
{
  "source": "rspjJHg4WY1",
  "targets": [
    "HT0w9YLMLyn",
    "rEpnzuNpRKM"
  ],
  "primaryTarget": "HT0w9YLMLyn",
  "deleteSource": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fractionnement des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| source | Oui | Identifiant de l'unité d'organisation à fractionner (l'unité d'organisation source). |
| cibles | Oui | Tableau des identifiants des unités d'organisation qui seront le résultat du fractionnement de l'unité source (les unités d'organisation cibles). |
| primaryTarget | Non | Identifiant de l'unité d'organisation vers laquelle transférer les données agrégées, les événements et les entités suivies associés à l'unité source. S'il n'est pas spécifié, la première cible sera utilisée. |
| deleteSource | Non | Détermine si l'unité d'organisation source doit être supprimée après l'opération. La valeur par défaut est true |
L'opération de fractionnement consiste à scinder l'unité d'organisation source en unités d'organisation cibles. Il est recommandé de créer de nouvelles unités d'organisation cibles avant de procéder au fractionnement, et de s'assurer au préalable les unités cibles ne contiennent pas de données agrégées. Vous pouvez spécifier un nombre quelconque d'unités d'organisation cibles.
L'opération de fractionnement transfère toutes les associations de métadonnées de l'unité d'organisation source vers les unités d'organisation cibles. Cela inclut les ensembles de données, les programmes, les groupes d'unités d'organisation, les options de catégorie, les utilisateurs, les visualisations, les cartes et les rapports d'événements.
L'opération transfère tous les enregistrements de données de l'unité d'organisation source vers l'unité d'organisation spécifiée comme cible principale ou, si elle n'est pas spécifiée, vers la première unité d'organisation cible spécifiée. Cela inclut les valeurs de données agrégées, les enregistrements relatifs à l'approbation des données, les événements, les entités suivies, etc.
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1510 | L'unité d'organisation source doit être spécifiée |
| E1511 | Au moins deux unités d'organisation cibles doivent être spécifiées |
| E1512 | L'unité d'organisation source ne peut pas être une unité d'organisation cible |
| E1513 | La cible principale doit être spécifiée |
| E1514 | La cible principale doit être une unité d'organisation cible |
| E1515 | L'unité d'organisation cible n'existe pas |
Le point d'extrémité de fusion des unités d'organisation vous permet de fusionner des unités d'organisation en une seule unité d'organisation cible.
The main authority required to perform an organisation unit merge is F_ORGANISATION_UNIT_MERGE.
Fusionner des unités d'organisation à l'aide d'une requête POST :
POST /api/organisationUnits/merge
La charge au format JSON ressemble à ceci :
{
  "sources": [
    "jNb63DIHuwU",
    "WAjjFMDJKcx"
  ],
  "target": "V9rfpjwHbYg",
  "dataValueMergeStrategy": "LAST_UPDATED",
  "dataApprovalMergeStrategy": "LAST_UPDATED",
  "deleteSources": true
}
Les propriétés JSON sont décrites dans le tableau suivant.
Tableau : Fusion des champs de la charge
| Champ | Obligatoire | Valeur |
|---|---|---|
| sources | Oui | Tableau des identifiants des unités d'organisation à fusionner (unités d'organisation source). |
| cible | Oui | Identifiant de l'unité d'organisation qui sera le résultat de la fusion des unités source (l'unité d'organisation cible). |
| dataValueMergeStrategy | Non | Stratégie de fusion des valeurs de données. Options : LAST_UPDATED (par défaut), DISCARD. |
| dataApprovalMergeStrategy | Non | Stratégie de fusion des enregistrements relatifs à l'approbation des données. Options : LAST_UPDATED (par défaut), DISCARD. |
| deleteSources | Non | Détermine si les unités d'organisation source doivent être supprimées après l'opération. La valeur par défaut est true |
L'opération de fusion consiste à combiner des unités d'organisation source pour former une seule unité cible. Il est recommandé de créer une nouvelle unité d'organisation cible avant de procéder à la fusion, et de s'assurer au préalable l'unité cible ne contient pas de données agrégées. Vous pouvez spécifier un nombre quelconque d'unités d'organisation source.
L'opération de fusion transfère toutes les associations de métadonnées des unités d'organisation sources vers l'unité d'organisation cible. Cela inclut les ensembles de données, les programmes, les groupes d'unités d'organisation, les options de catégorie, les utilisateurs, les visualisations, les cartes et les rapports d'événements. L'opération transfère également toutes les données d'événements et de tracker, telles que les événements, les inscriptions, l'historique de la propriété, la propriété des programmes et les entités suivies, vers l'unité d'organisation cible.
La stratégie de fusion des valeurs de données spécifiée définit la manière dont les valeurs de données sont traitées. Pour la stratégie LAST_UPDATED, les valeurs de données de toutes les unités d'organisation sources sont transférées vers l'unité d'organisation cible, et lorsque des valeurs existent pour les mêmes paramètres, c'est la dernière valeur mise à jour ou créée qui sera utilisée. Ceci permet d'éviter la répétition des données. Pour la stratégie DISCARD, les valeurs ne sont pas transférées vers l'unité d'organisation cible, mais elles sont simplement supprimées. La stratégie de fusion de l'approbation des données spécifiée définit la manière dont les enregistrements relatifs à l'approbation des données sont traités, et suit la même logique que les valeurs de données.
Les contraintes et les codes d'erreur suivants s'appliquent.
Tableau : Contraintes et codes d'erreur
| Code d'erreur | Description |
|---|---|
| E1500 | Au moins deux unités d'organisation sources doivent être spécifiées |
| E1501 | L'unité d'organisation cible doit être spécifiée |
| E1502 | L'unité d'organisation cible ne peut pas être une unité d'organisation source |
| E1503 | L'unité d'organisation source n'existe pas |
La ressource dataSets suit les conventions standard des autres ressources de métadonnées présents dans DHIS2. Cette ressource prend en charge des paramètres de requête supplémentaires.
/api/33/dataSets
Pour récupérer la version d'un ensemble de données, vous pouvez effectuer une requête GET :
GET /api/33/dataSets/<uid>/version
Pour augmenter (d'une unité) la version d'un ensemble de données, vous pouvez effectuer une requête POST :
POST /api/33/dataSets/<uid>/version
La ressource modèles de notification des ensembles de données suit les conventions standard des autres ressources de métadonnées présentes dans DHIS2.
GET /api/33/dataSetNotficationTemplates
Pour récupérer un modèle de notification d'ensemble de données, vous pouvez effectuer une requête GET :
GET /api/33/dataSetNotficationTemplates/<uid>
Pour ajouter un modèle de notification d'ensemble de données, vous pouvez effectuer une requête POST :
POST /api/33/dataSetNotficationTemplates
Pour supprimer un modèle de notification d'ensemble de données, vous pouvez effectuer une requête DELETE :
DELETE /api/33/dataSetNotficationTemplates/<uid>
Ci-dessous, un exemple de charge JSON :
{
  "name": "dataSetNotificationTemplate1",
  "dataSetNotificationTrigger": "DATA_SET_COMPLETION",
  "relativeScheduledDays": 0,
  "notificationRecipient": "ORGANISATION_UNIT_CONTACT",
  "dataSets": [{
    "id": "eZDhcZi6FLP"
  }],
  "deliveryChannels": ["SMS","EMAIL"],
  "subjectTemplate": "V{data_set_name}",
  "messageTemplate": "V{data_set_name}V{registration_period}",
  "sendStrategy": "SINGLE_NOTIFICATION"
}
notificationRecipient peut être l'un des éléments suivants : - USER_GROUP pour les messages internes - ORGANISATION_UNIT_CONTACT pour les messages externes
La ressource filledOrganisationUnitLevels fournit une liste ordonnée de niveaux d'unités d'organisation, où les niveaux générés sont introduits dans la liste pour remplir les positions pour lesquelles il n'existe pas de niveau.
GET /api/33/filledOrganisationUnitLevels
Pour définir des niveaux d'unité d'organisation, vous pouvez envoyer une requête POST avec une charge JSON et un type de contenu application/json comme ceci :
{
  "organisationUnitLevels": [{
    "name": "National",
    "level": 1,
    "offlineLevels": 3
  }, {
    "name": "District",
    "level": 2
  }, {
    "name": "Chiefdom",
    "level": 3
  }, {
    "name": "Facility",
    "level": 4
  }]
}
Un prédicteur permet de générer des valeurs de données sur la base d'une expression. Il peut être utilisé, par exemple, pour générer des cibles, des seuils ou des estimations de valeurs.
Pour récupérer les prédicteurs, vous pouvez effectuer une requête GET à la ressource des prédicteurs comme suit :
/api/predictors
Vous pouvez créer un prédicteur à l'aide d'une requête POST à la ressource des prédicteurs :
POST /api/predictors
Voici un exemple de charge :
{
  "id": "AG10KUJCrRk",
  "name": "Malaria Outbreak Threshold Predictor",
  "shortName": "Malaria Outbreak Predictor",
  "description": "Computes the threshold for potential malaria outbreaks based on the mean plus 1.5x the std dev",
  "output": {
    "id": "nXJJZNVAy0Y"
  },
  "generator": {
    "expression": "AVG(#{r6nrJANOqMw})+1.5*STDDEV(#{r6nrJANOqMw})",
    "description": "Maximum normal malaria case count",
    "missingValueStrategy": "NEVER_SKIP",
    "slidingWindow": false
  },
  "periodType": "Monthly",
  "sequentialSampleCount": 4,
  "sequentialSkipCount": 1,
  "annualSampleCount": 3,
  "organisationUnitLevels": [4]
}
L'élément de sortie fait référence à l'identifiant de l'élément de données pour lequel des valeurs de données prédites doivent être sauvegardées. L'élément générateur fait référence à l'expression qui sera utilisée pour calculer les valeurs prédites.
Un prédicteur possède toujours une expression génératrice qui décrit le mode de calcul de la valeur prédite. Le prédicteur peut également avoir une expression permettant de tester la fonction de saut, laquelle expression renvoie une valeur booléenne. Lorsque l'expression de test de saut est présente, elle est évaluée dans chacune des périodes échantillonnées afin de déterminer si les valeurs de cette période doivent être ignorées.
Les variables suivantes peuvent être utilisées dans une expression génératrice ou dans une expression de test de saut :
| Variable | Objet | Description |
|---|---|---|
| #{ | Élément de données agrégé | Fait référence à la valeur totale d'un élément de données agrégé pour toutes les combinaisons d'options de catégorie. |
| #{ | Opérande de l'élément de données | Fait référence à une combinaison entre un élément de données agrégé et une combinaison d'options de catégorie. |
| D{ | Élément de données de programme | Fait référence à la valeur d'un élément de données Tracker au sein d'un programme. |
| A{ | Attribut d'entité suivie d'un programme | Fait référence à la valeur d'un attribut d'entité suivie au sein d'un programme. |
| I{ | Indicateur de programme | Fait référence à la valeur d'un indicateur de programme. |
| R{ | Taux de déclaration | Fait référence à une mesure de taux de déclaration. La mesure peut être REPORTING_RATE (taux de déclaration), REPORTING_RATE_ON_TIME (taux de déclarations à temps), ACTUAL_REPORTS (rapports effectifs), ACTUAL_REPORTS_ON_TIME (rapports envoyés à temps), EXPECTED_REPORTS (rapports attendus). |
| C{ | Constant | Fait référence à une valeur constante. |
| OUG{ | Groupe d'unités d'organisation | Fait référence au nombre d'unités d'organisation présentes dans un groupe d'unités d'organisation. |
| [days] | Nombre de jours | Le nombre de jours dans la période actuelle. |
Pour exécuter tous les prédicteurs (générer des valeurs prédites), vous pouvez envoyer une requête POST à la ressource d'exécution :
POST /api/predictors/run
Pour exécuter un seul prédicteur, vous pouvez envoyer une requête POST à la ressource d'exécution et préciser le prédicteur :
POST /api/predictors/AG10KUJCrRk/run
To retrieve programs you can make a GET request to the programs resource like this:
/api/programs
Starting in version 2.42, a program may optionally define one of more category mappings. These mappings can be used to add disaggregations to program indicators for the program. A program indicator for this program can choose which mappings to use for the categories in its category combination and/or attribute combination.
This allows program indicator data to be viewed by category and category option such as in the Data Visualizer. It also allows an Aggregate data exchange to generate values from the program indicator that contain a category option combination and/or an attribute option combination.
These category mappings can be generated by the Maintenance (Preview) App or they can be added using the Web API. This section describes the format of the category mappings if you are using the Web API.
A new program has no category mappings. In the Web API this looks like:
"categoryMappings": []
To add category mappings to the program, you can edit this part of the program definition and then import the result back into DHIS2. Here is an example of how the edited field could look:
"categoryMappings": [
  {
    "id": "goor7Li4See",
    "categoryId": "cX5k9anHEHd",
    "mappingName": "standard Gender mapping",
    "optionMappings": [
      {
        "optionId": "apsOixVZlf1",
        "filter": "#{Zj7UnCAulEk.oZg33kd9taw} == 'Female'"
      },
      {
        "optionId": "jRbMi0aBjYn",
        "filter": "#{Zj7UnCAulEk.oZg33kd9taw} == 'Male'"
      }
    ]
  },
  {
    "id": "ESesheeva1i",
    "categoryId": "VPqYge5RB93",
    "mappingName": "standard Outcome mapping",
    "optionMappings": [
      {
        "optionId": "e3oqm527jBS",
        "filter": "#{Zj7UnCAulEk.sAg4Niej9bo} == 'Managed at PHU'"
      },
      {
        "optionId": "rSdQZYDmHJm",
        "filter": "#{Zj7UnCAulEk.sAg4Niej9bo} == 'Referred'"
      }
    ]
  },
  {
    "id": "laiHaid9eit",
    "categoryId": "fkAkrdC7eJF",
    "mappingName": "Referrals Age at event",
    "optionMappings": [
      {
        "optionId": "K4gwuiVvW3z",
        "filter": "d2:yearsBetween(#{wYTF0YCHMWr.AZLp9Shoab9},V{event_date})<5"
      },
      {
        "optionId": "oaFqxkefkPs",
        "filter": "d2:yearsBetween(#{wYTF0YCHMWr.AZLp9Shoab9},V{event_date})>=5"
      }
    ]
  },
  {
    "id": "SeNg0bohFah",
    "categoryId": "fkAkrdC7eJF",
    "mappingName": "Referrals Age at analyitcs period start",
    "optionMappings": [
      {
        "optionId": "K4gwuiVvW3z",
        "filter": "d2:yearsBetween(#{wYTF0YCHMWr.AZLp9Shoab9},V{analytics_period_start})<5"
      },
      {
        "optionId": "oaFqxkefkPs",
        "filter": "d2:yearsBetween(#{wYTF0YCHMWr.AZLp9Shoab9},V{analytics_period_start})>=5"
      }
    ]
  }
]
In this example, the program defines four category mappings that can be used by the program indicators assigned to the program: - A mapping for the Gender category - A mapping for the Outcome category - Two mappings for the Referrals Age category. A program indicator can choose which mapping it wants to use depending on whether it wants to show the age at the event date or the age at the analytics period start.
The categoryMappings fields are:
| name | description |
|---|---|
| id | An 11 character UID that uniquely identifies the mapping. The first character must be an upper or lower case letter, followed by 10 characters each being an upper or lower case letter or a digit. The id should be chosen so that it is unique. This UID is used by program indicators for the mappings they choose. |
| categoryId | The UID of the category to be mapped. In this example they are the UIDs for Gender, Outcome, and Referrals Age. |
| mappingName | A name you assign to the mapping. If you define more than one mapping for a category, the name must be unique within the mappings for that category in that program. |
| optionMappings | These specify a filter for each category option within the category. |
| optionId | The UID of the category option to which this filter applies. |
| filter | The filter to use for this category option. The filter must have the same syntax as the filter expression for a program indicator in the program. Tip: You can use the Maintenance App to generate and validate the filter: construct it as a filter expression for a new or existing program indicator for the program, make sure it's valid, and then copy-and-paste it into the metadata. (You don't have to save the program indicator with this filter.) |
A program indicator may select which program mappings to use in its categoryMappingIds field. A new program indicator has no category mapping ids. In the Web API this looks like:
"categoryMappingIds": [],
You can replace this with the category mappings that you want the program indicator to use. For example, if the program indicator has selected a category combination that combines Gender and Outcome, this field could be edited to contain the mapping ids for these categories such as defined in the above categoryMappings example:
"categoryMappingIds": [
    "goor7Li4See",
    "ESesheeva1i"
],
Cette section traite de l'envoi et de la lecture des règles de programme et explique leur modèle de données. Les règles de programme permettent de configurer un fonctionnement dynamique au sein des programmes de DHIS2.
Le modèle de données des règles de programme se compose de variables de règles de programme (programRuleVariables), de règles de programme (programRules) et d'actions de règles de programme (programRuleActions). La règle de programme contient une expression - lorsque cette expression est définie sur "true" (vrai), les actions de règle de programme sous cette expression sont déclenchées. Les variables de règle de programme sont utilisées pour traiter les éléments de données, les valeurs de données des entités suivies et d'autres valeurs de données nécessaires à l'exécution des expressions. Toutes les règles d'un programme partagent la même bibliothèque de variables de règles, et une variable peut être utilisée dans les expressions de plusieurs règles.
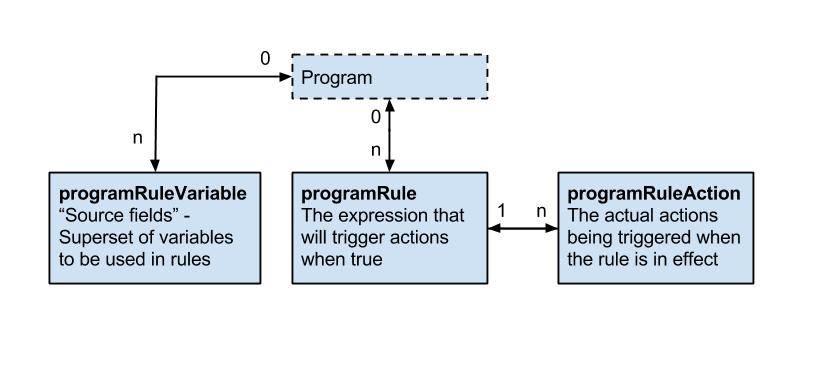
Le tableau suivant donne un aperçu détaillé du modèle de règle de programme.
Tableau : Règle de programme
| name | description | Obligatoire |
|---|---|---|
| program | Le programme dans lequel la règle est exécutée. | Obligatoire |
| name | Le nom sous lequel la règle de programme sera affichée aux configurateurs de dhis2. Il n'est pas visible pour l'utilisateur final du programme. | Obligatoire |
| description | La fonction de description de la règle de programme peut être utilisée par les configurateurs pour décrire la règle. Cette description n'est pas visible pour l'utilisateur final du programme. | Obligatoire |
| programStage | Si une étape de programme est définie pour une règle de programme, la règle ne sera évaluée qu'à l'intérieur de l'étape de programme spécifiée. | facultatif |
| condition | L'expression dont l'évaluation doit être définie sur "true" pour que la règle de programme déclenche les actions qu'elle contient. L'expression est écrite à l'aide d'opérateurs, d'appels de fonctions, de valeurs codées en dur, de constantes et de variables de règles de programme. d2:hasValue('hemoglobin') && #{hemoglobin} <= 7 | Obligatoire |
| priorité | La priorité d'exécution de la règle lorsque l'ordre des règles est important. | |
| Dans la plupart des cas, les règles ne dépendent pas de leur exécution avant ou après d'autres règles, et dans ces cas, la priorité d'exécution peut être omise. Si aucune priorité n'est définie pour une règle, celle-ci sera exécutée après toutes les règles pour lesquelles une priorité d'exécution a été définie. Si une priorité (integer) est définie, la règle la moins prioritaire sera exécutée avant les règles plus prioritaires. | facultatif |
Le tableau suivant donne un aperçu détaillé du modèle d'actions des règles de programme.
Tableau : Action de règle de programme
| name | description | Obligatoire |
|---|---|---|
| Règle de programme | La règle de programme qui est à l'origine de cette action. | Obligatoire |
| programRule- ActionType (règle de programme - type d'action) | The type of action that is to be performed. * DISPLAYTEXT - Displays a text in a given widget.* DISPLAYKEYVALUEPAIR - Displays a key and value pair(like a program indicator) in a given widget.* HIDEFIELD - Hide a specified dataElement or trackedEntityAttribute.- content - if defined, the text in content will be displayed to the end user in the instance where a value is previously entered into a field that is now about to be hidden (and therefore blanked). If content is not defined, a standard message will be shown to the user in this instance. - dataElement - if defined, the HIDEFIELD action will hide this dataElement when the rule is effective. - trackedEntityDataValue - if defined, the HIDEFIELD action will hide this trackedEntityDataValue when the rule is effective. * HIDESECTION - Hide a specified section.- programStageSection - must be defined. This is the programStageSection that will be hidden in case the parent rule is effective. * ASSIGN - Assign a value to either a dataElement or trackedEntityAttribute or a ProgramRuleVariable. Intended to help the user calculate something or fill in an obvious value somewhere.- content - if defined, the value in data is assigned to this variable. If content id defined, and thus a variable is assigned for use in other rules, it is important to also assign a programRule.priority to make sure the rule with an ASSIGN action runs before the rule that will in turn evaluate the assigned variable. - data - must be defined, data forms an expression that is evaluated and assigned to either a variable(#{myVariable}), a dataElement, or both. - dataElement - if defined, the value in data is assigned to this data element. Either the content or dataElement must be defined for the ASSIGN action to be effective. * SHOWWARNING - Show a warning to the user, not blocking the user from completing the event or registration.- content - if defined, content is a static part that is displayed at the end of the error message. - data - if defined, data forms an expression that is evaluated and added to the end of the warning message. - dataElement - if defined, the warning message is displayed next to this data element. - trackedEntityAttribute - if defined, the warning message is displayed next to this tracked entity attribute. Either dataElement or trackedEntityAttribute must be specified. * SHOWERROR - Show an error to the user, blocking the user from completing the event or registration.- content - if defined, content is a static part that is displayed in the start of the error message. - data - if defined, data forms an expression that is evaluated and added to the end of the error message. - dataElement - if defined, the error message is linked to this data element. - trackedEntityAttribute - if defined, the error message is linked to this tracked entity attribute. Either dataElement or trackedEntityAttribute must be specified. * WARNINGONCOMPLETE - Show a warning to the user on the "Complete form" dialog, but allowing the user to complete the event.- content - if defined, content is a static part that is displayed at the end of the error message. - data - if defined, data forms an expression that is evaluated and added to the end of the warning message. - dataElement - if defined, the warning message prefixed with the name/formName of the data element. * ERRORONCOMPLETE - Show an error to the user on in a modal window when the user tries to complete the event. The user is prevented from completing the event.- content - if defined, content is a static part that is displayed in the start of the error message. - data - if defined, data forms an expression that is evaluated and added to the end of the error message. - dataElement - if defined, the error message is linked to this data element. * CREATEEVENT - Create an event within the same enrollment.- content - data - if defined, contains data values to assign the created event. The format is <uid>:<data value>. Where several values is specified, these are separated with comma. AcMrnleqHqc:100,AqK1IHqCkEE:'Polyhydramnios' - programStage - must be defined, and designates the program stage that the rule shall create an event of. * SETMANDATORYFIELD - Set a field to be mandatory.- dataElement - if defined, this data element will be set to be mandatory in the data entry form. - trackedEntityAttribute - if defined, this tracked entity attribute will be set to mandatory in the registration form or profile. * SENDMESSAGE - To send message at completion of event/enrollment or at data value update.- messageTemplate - if defined, this template will be delivered either as SMS or EMAIL depending upon DeliveryChannel value in message template. * SCHEDULEMESSAGE - To schedule message at completion of event/enrollment or at data value update.- messageTemplate - if defined, this template will be delivered either as SMS or EMAIL depending upon DeliveryChannel value in message template. - Date to send message - Expression which is going to be used for evaluation of scheduled date. This expression should result in Date, any other resultant will be discarded and notification will not get scheduled. * HIDEPROGRAMSTAGE - Prevent adding new events to stage. * HIDEOPTION - Hide option (from an optionSet). * HIDEOPTIONGROUP - Hide option group (hide the options that belong to that option group). * SHOWOPTIONGROUP - Show option group (show the options that belong to that option group). | Obligatoire |
| emplacement | Utilisée pour les types d'action DISPLAYKEYVALUEPAIR et DISPLAYTEXT afin de désigner le widget dans lequel le texte ou la paire de valeurs clés seront affichés. Elle est obligatoire pour DISPLAYKEYVALUEPAIR et DISPLAYTEXT. | Voir la description |
| contenu | Utilisée pour les messages de l'utilisateur dans les différentes actions. Consultez l'aperçu des types d'action pour obtenir une explication détaillée de son utilisation dans chacun des types d'action. Elle est obligatoire pour SHOWWARNING, SHOWERROR, WARNINGONCOMPLETE, ERRORONCOMPLETE, DISPLAYTEXT et DISPLAYKEYVALUEPAIR ; et facultative pour HIDEFIELD et ASSIGN. | Voir la description |
| données | Utilisée pour les expressions dans les différentes actions. Consultez l'aperçu des types d'action pour obtenir une explication détaillée de son utilisation dans chacun des types d'action. Elle est obligatoire pour ASSIGN ; et facultative pour SHOWWARNING, SHOWERROR, WARNINGONCOMPLETE, ERRORONCOMPLETE, DISPLAYTEXT, CREATEEVENT et DISPLAYKEYVALUEPAIR. | Voir la description |
| dataElement | Utilisée pour relier les actions des règles aux éléments de données. Consultez l'aperçu des types d'action pour obtenir une explication détaillée de son utilisation dans chacun des types d'action. Elle est facultative pour SHOWWARNING, SHOWERROR, WARNINGONCOMPLETE, ERRORONCOMPLETE, ASSIGN et HIDEFIELD. | Voir la description |
| Entité suivie - Attribut | Utilisée pour relier les actions des règles aux attributs d'entités suivies. Consultez l'aperçu des types d'action pour obtenir une explication détaillée de son utilisation dans chacun des types d'action. Elle est facultative pour SHOWWARNING, SHOWERROR et HIDEFIELD. | Voir la description |
| option | Utilisée pour relier les actions des règles aux options. Consultez l'aperçu des types d'action pour obtenir une explication détaillée de leur utilisation dans chacun des types d'action. Elle est facultative pour HIDEOPTION | Voir la description |
| optionGroup (groupes d'options) | Utilisée pour relier les actions des règles aux groupes d'options. Consultez l'aperçu des type d'action pour obtenir une explication détaillée de son utilisation dans chacun des types d'action. Elle est obligatoire pour SHOWOPTIONGROUP, HIDEOPTIONGROUP. | Voir la description |
| programStage | Utilisée uniquement pour les actions de la règle CREATEEVENT. Elle est obligatoire pour CREATEEEVENT. | Voir la description |
| programStage- Section (étape de programme - section) | Utilisée uniquement pour les actions de la règle HIDESECTION. Elle est obligatoire pour HIDESECTION | Voir la description |
Certaines validations ont été ajoutées au modèle des actions des règles de programme dans la version 2.37. L'objectif principal était d'empêcher l'utilisateur de créer des règles de programme erronées afin de maintenir la cohérence de la base de données. Ces validations dépendent du type d'action de la règle de programme. Chaque type d'action a sa propre validation.
Tableau : Validations des actions des règles de programme
| name | contrôle de validation de l'existence de l'identifiant |
|---|---|
| SENDMESSAGE | Identifiant du modèle de notification |
| SCHEDULEMESSAGE | Identifiant du modèle de notification |
| HIDESECTION | Identifiant de la section de l'étape de programme |
| HIDEPROGRAMSTAGE | Identifiant de l'étape de programme |
| HIDEFIELD | Élément de données ou Attribut d'entité suivie |
| HIDEOPTION | Identifiant de l'option |
| HIDEOPTIONGROUP | Identifiant du groupe d'options |
| SHOWOPTIONGROUP | Identifiant du groupe d'options |
| SETMANDATORYFIELD | Élément de données ou Attribut d'entité suivie |
| SHOWERROR | Toujours valide |
| SHOWWARNING | Toujours valide |
| DISPLAYTEXT | Élément de données ou Attribut d'entité suivie |
| DISPLAYKEYVALUEPAIR | |
| ASSIGN | Élément de données ou Attribut d'entité suivie |
| WARNINGONCOMPLETE | Élément de données ou Attribut d'entité suivie |
| ERRORONCOMPLETE | Élément de données ou Attribut d'entité suivie |
En plus des validations ci-dessus, le champ données dans l'action de la règle de programme qui contient normalement une expression peut également être évalué en utilisant le point d'extrémité de l'api ci-dessous.
POST /api/programRuleActions/data/expression/description?programId=<uid>
{
  "condition": "1 + 1"
}
Le tableau suivant donne un aperçu détaillé du modèle de variables des règles de programme.
Tableau : Variable de règles de programme
| name | description | Obligatoire |
|---|---|---|
| name | le nom de la variable de la règle de programme - ce nom est utilisé dans les expressions. #{myVariable} > 5 | Obligatoire |
| sourceType (type de source) | Defines how this variable is populated with data from the enrollment and events. DATAELEMENT_NEWEST_EVENT_PROGRAM_STAGE - This source type works the same way as DATAELEMENT_NEWEST_EVENT_PROGRAM, except that it only evaluates values from one program stage. This source type can be useful in program rules where the same data element is used in several program stages, and a rule needs to evaluate the newest data value from within one specific stage. In order to know what event is the newest, the report date (event date) is used. If you have many events with the same report date, the system choose the one with the latest createdAt property of the event. DATAELEMENT_NEWEST_EVENT_PROGRAM - This source type is used when a program rule variable needs to reflect the newest known value of a data element, regardless of what event the user currently has open. **NB Future dates are "newer" than current or past dates. In order to know what event is the newest, the report date (event date) is used. If you have many events with the same report date, the system choose the one with the latest createdAt property of the event.DATAELEMENT_CURRENT_EVENT - Program rule variables with this source type will contain the data value from the same event that the user currently has open. This is the most commonly used source type, especially for skip logic (hide actions) and warning/error rules. *DATAELEMENT_PREVIOUS_EVENT - Program rule variables with this source type will contain the value from a specified data element from a previous event. Only older events is evaluated, not including the event that the user currently has open. This source type is commonly used when a data element only should be collected once during an enrollment, and should be hidden in subsequent events. Another use case is making rules for validating input where there is an expected progression from one event to the next - a rule can evaluate whether the previous value is higher/lower and give a warning if an unexpected value is entered. *CALCULATED_VALUE - Program rule variable with this source type is not connected directly to any form data - but will be populated as a result of some other program rules **ASSIGN* action. This variable will be used for making preliminary calculations, having a ASSIGN program rule action and assigning a value, this value can be used by other program rules - potentially making the expressions simpler and more maintainable. These variables will not be persisted and will stay in memory only during the execution of the set of program rules. Any program rule that assigns a data value to a preliminary calculated value would normally also have a priority assigned - to make sure that the preliminary caculation is done before the rule that consumes the calculated value. *TEI_ATTRIBUTE - Populates the program rule variable with a specified tracked entity attribute for the current enrollment. Use this is the source type to create program rules that evaluate data values entered during registration. This source type is also useful when you create program rules that compare data in events to data entered during registration. This source type is only used for tracker programs (programs with registration). | Obligatoire |
| Type de valeur | Le paramètre valueType (type de valeur) définit le type de valeur que cette variable de règle de programme peut contenir. Sa valeur dépend du paramètre sourceType (type de la source). Si la source est un élément de données ou un attribut d'entité suivie , le type de valeur sera dérivé du type de valeur de la source. Lorsque le type de la source est CALCULATED_VALUE, alors le type de valeur doit être fourni par l'utilisateur, sinon il sera par défaut ValueType.TEXT. | Obligatoire |
| dataElement | Utilisé pour relier la variable de la règle de programme à un élément de données. Il est obligatoire pour tous les types de sources commençant par DATAELEMENT_. | Voir la description |
| Entité suivie - Attribut | Utilisé pour relier la variable de la règle de programme à un attribut d'entité suivie. Il est obligatoire pour le type de source TEI_ATTRIBUTE. | Voir la description |
| useCodeFor- OptionSet (utiliser le code pour - Ensemble d'options) | Si ce paramètre est coché, la variable sera remplie avec le code - et non le nom - de tout ensemble d'options qui lui relié. Par défaut, le paramètre n'est pas coché, ce qui signifie que c'est le nom de l'option qui est utilisé. | |
| programStage | Utilisé pour spécifier une étape de programme précise à partir de laquelle la valeur de la variable de la règle de programme doit être récupérée. Il est obligatoire pour DATAELEMENT_NEWEST_EVENT_PROGRAM_STAGE. | Voir la description |
programRules, disponible dans l'API.Pour récupérer la liste des règles de programmes, vous pouvez effectuer une requête GET comme suit :
/api/programRules
Pour récupérer une seule règle de programme, vous pouvez effectuer une requête GET comme suit :
/api/programRules/<program_rule_uid>
Pour sauvegarder ou ajouter une seule règle de programme, vous pouvez effectuer une requête POST comme suit :
/api/programRules/<program_rule_uid>
Pour mettre à jour une seule règle de programme, vous pouvez effectuer une requête PUT comme suit :
/api/programRules/<program_rule_uid>
Pour supprimer une seule règle de programme, vous pouvez effectuer une requête DELETE comme suit :
/api/programRules/<program_rule_uid>
Pour récupérer la description de la condition de la règle de programme, vous pouvez effectuer une requête POST en fournissant la chaîne de la condition dans le corps de la requête.
/api/programRules/condition/description?<program_rule_uid>
Pour récupérer des informations sur un formulaire (qui correspond à un ensemble de données et à ses sections), vous pouvez interagir avec la ressource form. La réponse du formulaire est accessible en XML et JSON et fournira des informations sur chaque section (groupe) du formulaire ainsi que sur chaque champ de ces sections, y compris les étiquettes et les identifiants. En fournissant des identifiants de période et d'unité d'organisation, la réponse du formulaire sera constituée de valeurs de données.
Tableau : Paramètres de requête du formulaire
| Paramètre | Option | Description |
|---|---|---|
| pe | Période ISO | Période pour laquelle les valeurs de données du formulaire doivent être renseignées. |
| ou | UID | Unité d'organisation pour laquelle les valeurs de données du formulaire doivent être renseignées. |
| Métadonnées | false | true |
Pour récupérer le formulaire d'un ensemble de données, vous pouvez effectuer une requête GET comme suit :
/api/dataSets/<dataset-id>/form.json
Pour récupérer le formulaire pour l'ensemble de données ayant l'identifiant "BfMAe6Itzgt" au format XML :
/api/dataSets/BfMAe6Itzgt/form
Pour récupérer le formulaire en incluant les métadonnées, au format JSON :
/api/dataSets/BfMAe6Itzgt/form.json?metaData=true
Pour récupérer le formulaire rempli avec les valeurs de données d'une période et d'une unité d'organisation spécifiques au format XML :
/api/dataSets/BfMAe6Itzgt/form.xml?ou=DiszpKrYNg8&pe=201401
Cette ressource permet également de créer des formulaires de saisie de données personnalisés, directement pour un ensemble de données. Cela peut se faire à l'aide d'une requête POST ou PUT avec un contenu de type text/html où la charge est le balisage du formulaire personnalisé. En voici l'illustration :
curl -d @form.html "localhost/api/dataSets/BfMAe6Itzgt/form"
  -H "Content-Type:text/html" -u admin:district -X PUT
Les références aux fichiers peuvent être stockées avec la ressource "document".
Tableau : Champs du document
| Nom du champ | Description |
|---|---|
| name | nom unique du document |
| externe | drapeau identifiant l'emplacement du document. TRUE pour les fichiers externes, FALSE pour les fichiers internes. |
| url | l'emplacement du fichier. URL pour les fichiers externes. Identifiant de la ressource "fichier" pour les fichiers internes (voir Ressources fichier) |
Une requête GET au point d'extrémité des documents renverra tous les documents :
/api/documents
Une requête POST au point d'extrémité des documents créera un nouveau document :
curl -X POST -d @document.json -H "Content-type: application/json"
  "http://dhis.domain/api/documents"
{
  "name": "dhis home",
  "external": true,
  "url": "https://www.dhis2.org"
}
Une requête GET à laquelle est ajouté l'identifiant d'un document renverra des informations sur ce document. Une requête PUT au même point d'extrémité mettra à jour les champs du document :
/api/documents/<documentId>
Ajouter /data à la requête GET renverra le contenu réel du document :
/api/documents/<documentId>/data
DHIS2 prend en charge l'importation de métadonnées au format CSV, telles que les éléments de données, les unités d'organisation et les règles de validation. Les propriétés des différents objets de métadonnées sont identifiées en fonction de l'ordre ou de l'index des colonnes (voir ci-dessous pour plus de détails). Vous pouvez omettre les propriétés d'objets ou les colonnes non nécessaires, mais puisque l'ordre des colonnes est important, une colonne vide doit être incluse. En d'autres termes, si vous voulez spécifier des propriétés ou des colonnes qui apparaissent tard dans l'ordre des colonnes, mais ne pas spécifier certaines colonnes qui apparaissent tôt dans l'ordre, vous pouvez inclure des colonnes vides pour elles.
La première ligne du fichier CSV est considérée comme un en-tête et est ignorée lors de l'importation. Le caractère virgule doit être utilisé comme séparateur de texte. Le texte qui contient des virgules doit être placé entre guillemets.
Pour télécharger des métadonnées au format CSV, vous pouvez envoyer une requête POST au point d'extrémité des métadonnées :
POST /api/metadata?classKey=CLASS-KEY
Les types d'objets suivants sont pris en charge. Le paramètre de requête classKey (clé class) est obligatoire et se trouve à côté de chaque type d'objet dans le tableau ci-dessous.
Tableau : Types d'objets et clés
| Type d'objet | Clé class |
|---|---|
| Éléments de données | DATA_ELEMENT |
| Groupes d'éléments de données | DATA_ELEMENT_GROUP |
| Options de catégorie | CATEGORY_OPTION |
| Groupes d'options de catégorie | CATEGORY_OPTION_GROUP |
| Unités d’organisation | ORGANISATION_UNIT |
| Groupes d'unités d'organisation | ORGANISATION_UNIT_GROUP |
| Règles de validation | VALIDATION_RULE |
| Ensembles d'options | OPTION_SET |
| Traductions | TRANSLATION |
Astuce
Si vous utilisez curl, l'option
--data-binarydoit être utilisée car elle préserve les sauts de ligne et les nouvelles lignes, ce qui est essentiel pour les données CSV.
Par exemple, pour télécharger un fichier d'éléments de données au format CSV avec curl, vous pouvez utiliser la commande suivante :
curl --data-binary @data_elements.csv "http://localhost/api/metadata?classKey=DATA_ELEMENT"
  -H "Content-Type:application/csv" -u admin:district
Les formats des types d'objets actuellement pris en charge pour l'importation en CSV sont répertoriés dans les sections suivantes.
Tableau : Format CSV des éléments de données
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Exactement 11 caractères alphanumériques, commençant par une lettre. Il est généré par le système s'il n'est pas spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères. | |
| 4 | Nom court | Non | 50 premiers caractères du nom | S'il n'est pas spécifié, il est remplacé par les 50 premiers caractères du nom. Maximum 50 caractères. Unique. |
| 5 | Description | Non | Description en texte libre. | |
| 6 | Nom du formulaire | Non | Maximum 230 caractères. | |
| 7 | Type de domaine | Non | AGRÉGÉ | TRACKER |
| 8 | Type de valeur | Non | ENTIER | NOMBRE |
| 9 | Type d'agrégation | Non | SOMME | MOYENNE |
| 10 | Combinaison de catégories | Non | UID | UID de la combinaison de catégories. La combinaison de catégories par défaut sera utilisée si aucune n'est spécifiée. |
| 11 | Url | Non | URL de la ressource de l'élément de données. Maximum 255 caractères. | |
| 12 | Le zéro est significatif | Non | false | true |
| 13 | Ensemble d'options | Non | UID | UID de l'ensemble d'options à utiliser pour les données. |
| 14 | Ensemble d'options pour les commentaires | Non | UID | UID de l'ensemble d'options à utiliser pour les commentaires. |
Vous trouverez ci-dessous un exemple de fichier CSV pour les éléments de données. La première ligne sera toujours ignorée. Vous pouvez ignorer des colonnes et compter sur les valeurs par défaut utilisées par le système. Vous pouvez également ignorer les colonnes que vous n'utilisez pas
name,uid,code,shortname,description
"Women participated skill development training",,"D0001","Women participated in training"
"Women participated community organizations",,"D0002","Women participated in organizations"
Tableau : Format CSV de l'unité d'organisation
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères. | |
| 4 | Parent | Non | UID | UID de l'unité d'organisation mère. |
| 5 | Nom court | Non | 50 premiers caractères du nom | S'il n'est pas spécifié, il est remplacé par les 50 premiers caractères du nom. Maximum 50 caractères. Unique. |
| 6 | Description | Non | Description en texte libre. | |
| 7 | Date d'ouverture | Non | 1970-01-01 | Date d'ouverture de l'unité d'organisation au format AAAA-MM-JJ. |
| 8 | Date de fermeture | Non | Date de fermeture de l'unité d'organisation au format AAAA-MM-JJ, ignorer si l'unité est actuellement ouverte. | |
| 9 | Commentaire | Non | Commentaire en texte libre pour l'unité d'organisation. | |
| 10 | Type d'élément | Non | AUCUN | MULTI_POLYGONE |
| 11 | Coordonnées | Non | Coordonnées utilisées pour l'analyse géospatiale au format Geo JSON. | |
| 12 | URL | Non | URL de la ressource de l'unité d'organisation. Maximum 255 caractères. | |
| 13 | Personne de contact | Non | Personne de contact pour l'unité d'organisation. Maximum 255 caractères. | |
| 14 | Addresse | Non | Adresse de l'unité d'organisation. Maximum 255 caractères. | |
| 15 | Adresses électronique | Non | Courriel de l'unité d'organisation. Maximum 150 caractères. | |
| 16 | Numéro de téléphone | Non | Numéro de téléphone de l'unité d'organisation. Maximum 150 caractères. |
Voici un exemple d'importation d'unités d'organisation avec une unité mère, en utilisant des informations minimales :
name,uid,code,parent
"West province",,"WESTP","ImspTQPwCqd"
"East province",,"EASTP","ImspTQPwCqd"
Tableau : Format CSV de la règle de validation
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères | |
| 4 | Description | Non | Description en texte libre. | |
| 5 | Instruction | Non | Instruction en texte libre. | |
| 6 | Importance | Non | MOYENNE | ÉLEVÉE |
| 7 | Type de règle (ignoré) | Non | VALIDATION | SURVEILLANCE |
| 8 | Opérateur | Non | égal_à | non_égal_à |
| 9 | Type de période | Non | Mensuel | Quotidien |
| 10 | Expression du côté gauche | Oui | Formule mathématique basée sur les UID des éléments de données et des combinaisons d'options. | |
| 11 | Description de l'expression du côté gauche | Oui | Texte libre | |
| 12 | Stratégie de valeur manquante du côté gauche | Non | IGNORER_SI_UNE_VALEUR_EST MANQUANTE | IGNORER_SI_TOUTES_LES VALEURS_SONT MANQUANTES |
| 13 | Expression du côté droit | Oui | Formule mathématique basée sur les UID des éléments de données et des combinaisons d'options. | |
| 14 | Description de l'expression du côté droit | Oui | Texte libre | |
| 15 | Stratégie de valeur manquante du côté droit | Non | IGNORER_SI_UNE_VALEUR_EST MANQUANTE | IGNORER_SI_TOUTES_LES VALEURS_SONT MANQUANTES |
Tableau : Format CSV de l'ensemble d'options
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom de l'ensemble d'options | Oui | Nom. Maximum 230 caractères. Unique. Doit être répété pour chaque option. | |
| 2 | UID de l'ensemble d'options | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. Il doit être répété pour chaque option. |
| 3 | Code de l'ensemble d'options | Non | Code stable. Maximum 50 caractères. Il doit être répété pour chaque option. | |
| 4 | Nom de l'option | Oui | Nom de l'option. Maximum 230 caractères. | |
| 5 | UID de l'option | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. |
| 6 | Code de l'option | Oui | Code stable. Maximum 50 caractères. |
Le format des ensembles d'options est particulier. Les trois premières valeurs représentent un ensemble d'options. Les trois dernières valeurs représentent une option. Les trois premières valeurs représentant l'ensemble d'options doivent être répétées pour chaque option.
optionsetname,optionsetuid,optionsetcode,optionname,optionuid,optioncode
"Color",,"COLOR","Blue",,"BLUE"
"Color",,"COLOR","Green",,"GREEN"
"Color",,"COLOR","Yellow",,"YELLOW"
"Sex",,,"Male",,"MALE"
"Sex",,,"Female",,"FEMALE"
"Sex",,,"Unknown",,"UNKNOWN"
"Result",,,"High",,"HIGH"
"Result",,,"Medium",,"MEDIUM"
"Result",,,"Low",,"LOW"
"Impact","cJ82jd8sd32","IMPACT","Great",,"GREAT"
"Impact","cJ82jd8sd32","IMPACT","Medium",,"MEDIUM"
"Impact","cJ82jd8sd32","IMPACT","Poor",,"POOR"
Tableau : Format CSV du groupe d'options
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom du groupe d'options | Oui | Nom. Maximum 230 caractères. Unique. Doit être répété pour chaque option. | |
| 2 | Uid du groupe d'options | Non | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. Il doit être répété pour chaque option. | |
| 3 | Code du groupe d'options | Non | Code stable. Maximum 50 caractères. Il doit être répété pour chaque option. | |
| 4 | Nom court du groupe d'options | Oui | Nom court. Maximum 50 caractères. Unique. Doit être répété pour chaque option. | |
| 5 | Uid de l'ensemble d'options | Oui | Identifiant stable. Maximum 11 caractères. Doit être répété pour chaque option. | |
| 6 | Uid de l'option | Non | Identifiant stable. Maximum 11 caractères. | |
| 7 | Code de l'option | Non | Code stable. Maximum 50 caractères. |
Exemple de charge CSV d'un groupe d'options
optionGroupName,optionGroupUid,optionGroupCode,optionGroupShortName,optionSetUid,optionUid,optionCode
optionGroupA,,,groupA,xmRubJIhmaK,,OptionA
optionGroupA,,,groupA,xmRubJIhmaK,,OptionB
optionGroupB,,,groupB,QYDAByFgTr1,,OptionC
Tableau : Format CSV de l'ensemble de groupes d'options
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom de l'ensemble de groupes d'options | Oui | Nom. Maximum 230 caractères. Unique. Doit être répété pour chaque option. | |
| 2 | Uid de l'ensemble de groupes d'options | Non | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. Il doit être répété pour chaque option. | |
| 3 | Code de l'ensemble de groupes d'options | Non | Code stable. Maximum 50 caractères. Il doit être répété pour chaque option. | |
| 4 | Description de l'ensemble de groupes d'options | Non | Description. Doit être répétée pour chaque option. | |
| 5 | Dimension de données | Non | VRAI, FAUX | |
| 6 | Uid de l'ensemble d'options | Non | UID de l'ensemble d'options. Identifiant stable. Maximum 11 caractères. |
Exemple de charge CSV d'un ensemble de groupes d'options
name,uid,code,description,datadimension,optionsetuid
optiongroupsetA,,,,,xmRubJIhmaK
optiongroupsetB,,,,false,QYDAByFgTr1
Tableau : Format CSV de l'indicateur
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Exactement 11 caractères alphanumériques, commençant par une lettre. Il est généré par le système s'il n'est pas spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères. | |
| 4 | Nom court | Oui | 50 premiers caractères du nom | S'il n'est pas spécifié, il est remplacé par les 50 premiers caractères du nom. Maximum 50 caractères. Unique. |
| 5 | dénominateur | Oui | Expression de l'indicateur. | |
| 6 | Description du dénominateur | Non | Maximum 230 caractères. | |
| 5 | numérateur | Oui | Expression de l'indicateur. | |
| 6 | Description du numérateur | Non | Maximum 230 caractères. | |
| 6 | annualisé | Oui | VRAI, FAUX | |
| 6 | décimales | Non | Nombre de décimales à utiliser pour la valeur de l'indicateur. Si ce paramètre est "null", la valeur par défaut sera utilisée. | |
| 6 | Type d'indicateur | Oui | UID |
Vous trouverez ci-dessous un exemple de fichier CSV pour les indicateurs. La première ligne sera toujours ignorée. Vous pouvez ignorer des colonnes et compter sur les valeurs par défaut utilisées par le système. Vous pouvez également ignorer les colonnes que vous n'utilisez pas
Name,UID,Code,Description,shortName,denominator,denominatorDescription,numerator,numeratorDescription,annualized,decimals,indicatorType
Indicator A,yiAKjiZVoOU,CodeA,Indicator A description,Indicator A shortname,#{fbfJHSPpUQD},denominatorDescription,#{h0xKKjijTdI},numeratorDescription,false,2,sqGRzCziswD
Indicator B,Uvn6LCg7dVU,CodeB,Indicator B description,Indicator B shortname,#{fbfJHSPpUQD},denominatorDescription,#{h0xKKjijTdI},numeratorDescription,false,2,sqGRzCziswD
Outre l'importation d'objets, vous pouvez également choisir de n'importer que la relation groupe-membre entre un objet et un groupe. Actuellement, les paires de groupes et d'objets suivantes sont prises en charge
Groupe d'unités d'organisation - Unité d'organisation
Groupe d'éléments de données - Élément de données
Groupe d'indicateurs - Indicateur
Ensemble de groupes d'options - Groupe d'options
Le format CSV pour ces importations est le même
Tableau : Format CSV des membres d'une collection
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | UID | Oui | UID | L'UID de la collection à laquelle ajouter un objet |
| 2 | UID | Oui | UID | L'UID de l'objet à ajouter à la collection |
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères. | |
| 4 | Nom court | Non | Nom court. 50 caractères maximum. | |
| 5 | Type de dimension des données | Oui | Type de dimension des données. Il peut être une DÉSAGRÉGATION ou un ATTRIBUT |
Tableau : Groupe d'éléments de données, option de catégorie, groupe d'unités d'organisation, Format CSV
| Index | Colonne | Obligatoire | Valeur (par défaut en premier) | Description |
|---|---|---|---|---|
| 1 | Nom | Oui | Nom. Maximum 230 caractères. Unique. | |
| 2 | UID | Non | UID | Identifiant stable. Maximum 11 caractères. Il est généré par le système si aucun n'est spécifié. |
| 3 | Code | Non | Code stable. Maximum 50 caractères. | |
| 4 | Nom court | Non | Nom court. 50 caractères maximum. |
Voici un exemple d'options de catégorie :
name,uid,code,shortname
"Male",,"MALE"
"Female",,"FEMALE"
La ressource des objets supprimés fournit un journal des objets de métadonnées qui ont été supprimés.
/api/deletedObjects
Chaque fois qu'un objet de métadonnées est supprimé, un journal est conservé avec l'identifiant, le code, le type et l'heure de la suppression. Cette API est disponible à l'adresse /api/deletedObjects. Le filtrage des champs et des objets fonctionne de la même manière que pour les autres ressources de métadonnées.
Obtenir des objets supprimés de type éléments de données :
GET /api/deletedObjects.json?klass=DataElement
Obtenir un objet de type indicateur qui a été supprimé dans la période de 2015 et plus :
GET /api/deletedObjects.json?klass=Indicator&deletedAt=2015-01-01
Certains types d'objets de métadonnées peuvent être marqués comme favoris pour l'utilisateur actuellement connecté. Cela s'applique actuellement aux tableaux de bord.
/api/dashboards/<uid>/favorite
Pour faire d'un tableau de bord un favori, vous pouvez envoyer une requête POST (aucun type de contenu n'est requis) à une URL comme suit :
/api/dashboards/iMnYyBfSxmM/favorite
Pour supprimer un tableau de bord en tant que favori, vous pouvez effectuer une requête DELETE en utilisant l'URL ci-dessus.
Le statut de favori apparaîtra comme un champ booléen favori sur l'objet (par exemple, le tableau de bord) dans la réponse de métadonnées.
Un utilisateur connecté peut s'abonner à certains types d'objets. Actuellement, les objets auxquels il est possible de s'abonner sont ceux de type EventChart (graphique d'événement), EventReport (rapport d'événement), Map (carte), Visualization (visualisation) et EventVisualization (visualisation d'événement).
Note
Les objets EventChart et EventReport sont obsolètes. Utilisez plutôt EventVisualization.
Pour connaître les abonnés d'un objet (obtenir un tableau contenant leurs identifiants d'utilisateurs), vous pouvez effectuer une requête GET comme suit :
/api/<object-type>/<object-id>/subscribers
Voir l'exemple suivant :
/api/visualizations/DkPKc1EUmC2/subscribers
Pour vérifier si l'utilisateur actuel est abonné à un objet (obtenir une valeur booléenne), vous pouvez effectuer un appel GET :
/api/<object-type>/<object-id>/subscribed
Voir l'exemple suivant :
/api/visualizations/DkPKc1EUmC2/subscribed
Pour s'abonner ou se désabonner d'un objet, effectuez une requête POST/DELETE (aucun type de contenu n'est requis) :
/api/<object-type>/<object-id>/subscriber
Les Ressources de fichiers sont des objets utilisés pour représenter et stocker du contenu binaire. L'objet FileResource (ressource de fichier) contient les métadonnées du fichier (nom, type de contenu, taille, etc.) ainsi qu'une clé permettant d'extraire le contenu à partir d'un magasin de fichiers externe à la base de données. L'objet FileResource est stocké dans la base de données comme n'importe quel autre objet, mais le contenu (fichier) est stocké ailleurs et peut être récupéré à l'aide de la référence du contenu (storageKey) ou clé de stockage.
/api/fileResources
Le contenu des ressources de fichiers n'est pas directement accessible, mais il est référencé à partir d'autres objets (tels que les valeurs de données) pour stocker des données binaires d'une taille pratiquement illimitée.
Pour créer une ressource de fichier qui ne nécessite pas de valeur de données correspondante, envoyez une requête POST au point d'extrémité /api/fileResources avec un téléchargement en plusieurs parties :
curl "https://server/api/fileResources" -X POST
  -F "file=@/path/to/file/name-of-file.png"
uid d'une ressource de fichier peut être fourni lors de sa création, par exemple : curl "https://server/api/fileResources?uid=0123456789x" -X POST
-F "file=@/path/to/file/name-of-file.png"
Pour créer à la fois une ressource de fichier et une valeur de données qui fait référence au fichier, envoyez une requête POST au point d'extrémité /api/dataValues/file avec DHIS version 2.36 ou une version plus récente :
curl "https://server/api/dataValues/file?de=xPTAT98T2Jd
  &pe=201301&ou=DiszpKrYNg8&co=Prlt0C1RF0s" -X POST
  -F "file=@/path/to/file/name-of-file.png"
Pour le point d'extrémité api/fileResources, le seul paramètre de formulaire requis est file, qui correspond au fichier à télécharger. Pour le point d'extrémité api/dataValues/file, les paramètres requis sont les mêmes que pour une requête POST à api/dataValues, avec l'ajout de file.
Le nom de fichier et le type de contenu doivent également être inclus dans la requête, mais ils seront remplacés par des valeurs par défaut s'ils ne sont pas fournis.
Lorsque la création d'une ressource fichier est réussie, les données renvoyées contiennent un champ response qui contient à son tour fileResource comme suit :
{
  "httpStatus": "Accepted",
  "httpStatusCode": 202,
  "status": "OK",
  "response": {
    "responseType": "FileResource",
    "fileResource": {
      "name": "name-of-file.png",
      "created": "2015-10-16T16:34:20.654+0000",
      "lastUpdated": "2015-10-16T16:34:20.667+0000",
      "externalAccess": false,
      "publicAccess": "--------",
      "user": { ... },
      "displayName": "name-of-file.png",
      "contentType": "image/png",
      "contentLength": 512571,
      "contentMd5": "4e1fc1c3f999e5aa3228d531e4adde58",
      "storageStatus": "PENDING",
      "id": "xm4JwRwke0i"
    }
  }
}
Notez la réponse 202 Accepted, qui indique que la ressource renvoyée a été soumise à un traitement en arrière-plan (persistance vers le magasin de fichiers externe dans ce cas). Notez également le champ storageStatus qui indique si le contenu a été stocké ou non. À ce stade, la persistance vers le magasin externe n'est pas encore terminée (elle est probablement en train d'être téléchargée vers un magasin basé sur le cloud) comme le montre le statut PENDING.
Même si le contenu n'a pas encore été entièrement stocké, la ressource de fichier peut maintenant être utilisée, par exemple comme contenu référencé dans une valeur de données (voir Travailler avec des valeurs de données de fichier). Si nous avons besoin de vérifier le storageStatus mis à jour ou de récupérer les métadonnées du fichier, une requête peut être envoyée au point d'extrémité fileResources.
curl "https://server/api/fileResources/xm4JwRwke0i" -H "Accept: application/json"
Cette requête renverra l'objet FileResource comme le montre la réponse de l'exemple ci-dessus.
Les ressources de fichiers doivent être référencées (attribuées) à partir d'un autre objet. afin d'être conservées à long terme. Une ressource de fichier qui est créée mais non référencée par un autre objet, par exemple une valeur de données, est est considérée comme étant en staging. Toutes les ressources de fichiers dans ce état et datant de plus de deux heures seront marqués pour suppression et seront retirées du système.
L'ID renvoyé par la création initiale de la ressource de fichier n'est pas récupérable à partir d'un autre emplacement, sauf si la ressource de fichier a été référencée (auquel cas l'ID sera stocké en tant que référence), de sorte que sa perte nécessitera que la requête POST soit répétée et qu'un nouvel objet soit créé. La ressource de fichier orpheline sera effacée automatiquement.
Les objets de ressources de fichiers sont immuables, ce qui signifie qu'ils ne peuvent pas être modifiés et nécessitent plutôt la création d'une ressource entièrement nouvelle.
Pour des raisons de sécurité, certains types de fichiers ne peuvent pas être téléchargés.
Les types de contenu suivants sont bloqués.
| Type de contenu | Type de contenu |
|---|---|
| text/html | application/x-ms-dos-executable |
| text/css | application/vnd.microsoft.portable-executable |
| text/javascript | application/vnd.apple.installer+xml |
| font/otf | application/vnd.mozilla.xul+xml |
| application/x-shockwave-flash | application/x-httpd-php |
| application/vnd.debian.binary-package | application/x-sh |
| application/x-rpm | application/x-csh |
| application/java-archive |
Les extensions de fichiers suivantes sont bloquées.
| Extension de fichier | Extension de fichier | Extension de fichier |
|---|---|---|
| html | deb | xul |
| htm | rpm | php |
| css | jar | bin |
| js | jsp | sh |
| mjs | exe | csh |
| otf | msi | bat |
| swf | mpkg |
Cette section explique les API de versionnage des métadonnées.
/api/metadata/version : Cet endpoint renvoie la version actuelle des métadonnées du système sur lequel il est appelé.Tableau : Paramètres de requête
| Nom | Obligatoire | Description |
|---|---|---|
| versionName | false | Si ce paramètre n'est pas spécifié, il renvoie la version actuelle du système ou, dans le cas contraire, les détails du nom de version utilisé comme paramètre. (le nom de la version utilise la syntaxe "Version_<id>"). |
Exemple: Obtenir la version actuelle des métadonnées de ce système
Requête :
/api/metadata/version
Réponse :
{
  "name": "Version_4",
  "created": "2016-06-30T06:01:28.684+0000",
  "lastUpdated": "2016-06-30T06:01:28.685+0000",
  "externalAccess": false,
  "displayName": "Version_4",
  "type": "BEST_EFFORT",
  "hashCode": "848bf6edbaf4faeb7d1a1169445357b0",
  "id": "Ayz2AEMB6ry"
}
Exemple: Obtenir les détails de la version portant le nom "Version_2".
Requête :
/api/metadata/version?versionName=Version_2
Réponse :
{
  "name": "Version_2",
  "created": "2016-06-30T05:59:33.238+0000",
  "lastUpdated": "2016-06-30T05:59:33.239+0000",
  "externalAccess": false,
  "displayName": "Version_2",
  "type": "BEST_EFFORT",
  "hashCode": "8050fb1a604e29d5566675c86d02d10b",
  "id": "SaNyhusVxBG"
}
/api/metadata/version/history : Ce endpoint renvoie la liste de toutes les versions des métadonnées du système sur lequel il est appelé.Tableau : Paramètres de requête
| Nom | Obligatoire | Description |
|---|---|---|
| baseline | false | Si ce paramètre n'est pas spécifié, la liste de toutes les versions de métadonnées sera renvoyée. Dans le cas contraire, nous devons fournir un paramètre versionName de la forme "Version_<id>". Il renverra alors la liste des versions présentes dans le système, qui ont été créées après que le nom de la version ait été fourni en tant que paramètre de la requête. |
Exemple: Obtenir la liste de toutes les versions de ce système
Requête :
/api/metadata/version/history
Réponse :
{
  "metadataversions": [{
    "name": "Version_1",
    "type": "BEST_EFFORT",
    "created": "2016-06-30T05:54:41.139+0000",
    "id": "SjnhUp6r4hG",
    "hashCode": "fd1398ff7ec9fcfd5b59d523c8680798"
  }, {
    "name": "Version_2",
    "type": "BEST_EFFORT",
    "created": "2016-06-30T05:59:33.238+0000",
    "id": "SaNyhusVxBG",
    "hashCode": "8050fb1a604e29d5566675c86d02d10b"
  }, {
    "name": "Version_3",
    "type": "BEST_EFFORT",
    "created": "2016-06-30T06:01:23.680+0000",
    "id": "FVkGzSjAAYg",
    "hashCode": "70b779ea448b0da23d8ae0bd59af6333"
  }]
}
Exemple : Obtenir la liste de toutes les versions de ce système créées après "Version_2".
Requête :
/api/metadata/version/history?baseline=Version_2
Réponse :
{
  "metadataversions": [{
    "name": "Version_3",
    "type": "BEST_EFFORT",
    "created": "2016-06-30T06:01:23.680+0000",
    "id": "FVkGzSjAAYg",
    "hashCode": "70b779ea448b0da23d8ae0bd59af6333"
  }, {
    "name": "Version_4",
    "type": "BEST_EFFORT",
    "created": "2016-06-30T06:01:28.684+0000",
    "id": "Ayz2AEMB6ry",
    "hashCode": "848bf6edbaf4faeb7d1a1169445357b0"
  }]
 }
/api/metadata/version/create : Ce endpoint va créer une version de métadonnées pour le type de version spécifié dans le paramètre.Tableau : Paramètres de requête
| Nom | Obligatoire | Description |
|---|---|---|
| type | true | Le type de version de métadonnées à créer. * BEST_EFFORT * ATOMIQUE |
Les utilisateurs peuvent sélectionner le type de métadonnées à créer. Le type de version des métadonnées régit la manière dont l'importateur traite la version en question. Ce type sera utilisé lors de l'importation des métadonnées. Il existe deux types de métadonnées.
BEST_EFFORT : Ce type suggère que les références manquantes peuvent être ignorées et l'importateur peut continuer à importer les métadonnées (par exemple, les éléments de données manquants lors de l'importation d'un groupe d'éléments de données).
ATOMIQUE : Ce type garantit une vérification stricte des références de métadonnées et l'importation des métadonnées échouera si l'une des références n'existe pas.
Remarque
Il est recommandé d'avoir un type de versions ATOMIQUE pour s'assurer que tous les systèmes (centraux et locaux) aient les mêmes métadonnées. Les références manquantes sont prises en compte dans la phase de validation elle-même. Veuillez consulter les détails de l'importateur pour obtenir une explication complète.
Exemple: Créer une version de métadonnées du type BEST_EFFORT.
Requête :
curl -X POST -u admin:district "https://play.dhis2.org/dev/api/metadata/version/create?type=BEST_EFFORT"
Réponse :
{
  "name": "Version_1",
  "created": "2016-06-30T05:54:41.139+0000",
  "lastUpdated": "2016-06-30T05:54:41.333+0000",
  "externalAccess": false,
  "publicAccess": "--------",
  "user": {
    "name": "John Traore",
    "created": "2013-04-18T17:15:08.407+0000",
    "lastUpdated": "2016-04-06T00:06:06.571+0000",
    "externalAccess": false,
    "displayName": "John Traore",
    "id": "xE7jOejl9FI"
  },
  "displayName": "Version_1",
  "type": "BEST_EFFORT",
  "hashCode": "fd1398ff7ec9fcfd5b59d523c8680798",
  "id": "SjnhUp6r4hG"
}
/api/metadata/version/{versionName}/data : Ce endpoint va télécharger les métadonnées spécifiques au nom de version utilisé comme paramètre du chemin d'accès
/api/metadata/version/{versionName}/data.gz: Ce point d'extrémité va télécharger les métadonnées spécifiques au nom de version utilisé comme paramètre du chemin d'accès dans un format compressé (gzippé).
Tableau : Paramètres du chemin d'accès
| Nom | Obligatoire | Description |
|---|---|---|
| versionName | true | Paramètre de chemin d'accès de la forme "Version_<id>" pour que l'API télécharge la version spécifique. |
Exemple: Obtenir les métadonnées pour la "Version 5"
Requête :
curl -u admin:district "https://play.dhis2.org/dev/api/metadata/version/Version_5/data"
Réponse :
{
  "date": "2016-06-30T06:10:23.120+0000",
  "dataElements": [
    {
      "code": "ANC 5th Visit",
      "created": "2016-06-30T06:10:09.870+0000",
      "lastUpdated": "2016-06-30T06:10:09.870+0000",
      "name": "ANC 5th Visit",
      "id": "sCuZKDsix7Y",
      "shortName": "ANC 5th Visit ",
      "aggregationType": "SUM",
      "domainType": "AGGREGATE",
      "zeroIsSignificant": false,
      "valueType": "NUMBER",
      "categoryCombo": {
        "id": "p0KPaWEg3cf"
      },
      "user": {
        "id": "xE7jOejl9FI"
      }
    }
  ]
}
Cette section explique l'API de synchronisation des métadonnées disponible à partir de la version 2.24
/api/metadata/sync : Ce endpoint effectue la synchronisation des métadonnées du nom de version utilisé dans le paramètre de requête. Cela se fait par le téléchargement et l'importation de la version spécifiée à partir du serveur distant, tel que défini dans l'application de Paramètres.Tableau : Paramètres de requête
| Nom | Obligatoire | Description |
|---|---|---|
| versionName | true | Le paramètre de requête VersionName est de la forme "Version_<id>" . L'api télécharge cette version depuis le serveur distant et l'importe dans le système local. |
Cette API doit être utilisée avec la plus grande prudence. Sachez qu'il existe une autre façon d'effectuer la synchronisation de manière complètement automatisée en s'appuyant sur la tâche de synchronisation des métadonnées à partir de l'application "Administration des données". Voir le chapitre 22, section 22.17 du manuel de l'utilisateur pour plus de détails concernant la tâche de synchronisation des métadonnées.
Cette API de synchronisation peut également être utilisée pour synchroniser les métadonnées pour les versions qui ont échoué dans le planificateur de synchronisation des métadonnées. En raison de sa dépendance à un numéro de version de métadonnées spécifique, il convient de faire attention à l'ordre dans lequel cette API est appelée. Par exemple, si cette API est utilisée pour synchroniser une version supérieure à partir de l'instance centrale, la synchronisation peut échouer car les dépendances des métadonnées ne sont pas présentes dans l'instance locale.
Supposons que l'instance locale soit à la Version_12 et que ce point d'extrémité soit utilisé pour synchroniser la Version_15 (de type BEST_EFFORT) depuis l'instance centrale, le planificateur commencera à synchroniser les métadonnées à partir de la Version_16. Donc l'instance locale n'aura pas les versions de métadonnées entre la Version_12 et la Version_15. Vous devez synchroniser manuellement les versions manquantes en utilisant uniquement ces points d'extrémité.
Exemple: Synchroniser la Version_6 du système central vers ce système
Requête :
curl -u admin:district "https://play.dhis2.org/dev/api/metadata/sync?versionName=Version_6"
DHIS2 fournit un référentiel de métadonnées qui contient des packages de métadonnées avec différents contenus. Un package de métadonnées est un document JSON compatible avec DHIS2 qui décrit un ensemble d'objets de métadonnées.
Pour récupérer un index des packages de métadonnées disponibles, vous pouvez envoyer une requête GET à la ressource metadataRepo :
GET /api/synchronization/metadataRepo
L'entrée d'un package de métadonnées contient des informations sur le package et une URL vers le package concerné. Un index pourrait ressembler à ceci :
{
  "packages": [
    {
      "id": "sierre-leone-demo",
      "name": "Sierra Leone demo",
      "description": "Sierra Leone demo database",
      "version": "0.1",
      "href": "https://dhis2.org/metadata-repo/221/sierra-leone-demo/metadata.json"
    },
    {
      "id": "trainingland-org-units",
      "name": "Trainingland organisation units",
      "description": "Trainingland organisation units with four levels",
      "version": "0.1",
      "href": "https://dhis2.org/metadata-repo/221/trainingland-org-units/metadata.json"
    }
  ]
}
Un client peut suivre les URL et installer un package de métadonnées via une requête POST de type de contenu text/plain et avec le package de métadonnées utilisé comme charge de la ressource metadataPull :
POST /api/synchronization/metadataPull
Voici un exemple de commande curl :
curl "localhost:8080/api/synchronization/metadataPull" -X POST
  -d "https://dhis2.org/metadata-repo/221/trainingland-org-units/metadata.json"
  -H "Content-Type:text/plain" -u admin:district
Note
The supplied URL will be checked against the config property
metadata.sync.remote_servers_allowedin thedhis.conffile. If the base URL is not one of the configured servers allowed then the operation will not be allowed. See failure example below.
Some examples where the config set ismetadata.sync.remote_servers_allowed=https://server1.org/,https://server2.org/- supplyhttps://server1.org/path/to/resource-> this will be accepted - supplyhttps://server2.org/resource/path-> this will be accepted - supplyhttps://oldserver.org/resource/path-> this will be rejected
Sample failure response in JSON format.
 {
  "httpStatus": "Conflict",
  "httpStatusCode": 409,
  "status": "ERROR",
  "message": "Provided URL is not in the remote servers allowed list",
  "errorCode": "E1004"
}
Chaque objet créé dans DHIS2 aura une propriété user qui est liée à l'utilisateur qui a créé l'objet.
Depuis la version 2.36, nous avons changé le nom de cette propriété en createdBy pour éviter toute confusion.
Cependant, afin de conserver la compatibilité rétroactive, l'ancienne propriété user est toujours incluse dans la charge et fonctionne normalement comme auparavant.
{
  "createdBy": {
      "displayName": "John Kamara",
      "name": "John Kamara",
      "id": "N3PZBUlN8vq",
      "username": "district"
  },
  "user": {
      "displayName": "John Kamara",
      "name": "John Kamara",
      "id": "N3PZBUlN8vq",
      "username": "district"
  }
}
Le point d'extrémité des propositions pour les métadonnées permet de proposer et d'accepter des modifications sur les métadonnées.
/api/metadata/proposals
Une proposition vise toujours un seul objet de métadonnées. La requête suivante peut être utilisée :
POST /api/metadata/proposals
En fonction de la charge, la proposition peut :
Pour proposer l'ajout d'un nouvel objet de métadonnées, envoyez une charge JSON comme celle-ci :
{
  "type": "ADD",
  "target": "ORGANISATION_UNIT",
  "change": {"name":"My Unit", "shortName":"MyOU", "openingDate": "2020-01-01"}
}
change contient le même objet JSON qui peut être directement envoyé au point d'extrémité de création de l'objet. Pour proposer la mise à jour d'un objet de métadonnées existant, envoyez une charge JSON comme dans l'exemple ci-dessous :
{
  "type": "UPDATE",
  "target": "ORGANISATION_UNIT",
  "targetId": "<id>",
  "change": [
    {"op": "replace", "path": "/name", "value": "New name"}
  ]
}
targetId fait référence à l'ID de l'objet qui doit être mis à jour. La propriété change contient ici une charge de patch JSON. Il s'agit de la même charge de patch qui peut être envoyée au point d'extrémité correspondant pour appliquer directement la mise à jour. Pour proposer la suppression d'un objet existant, envoyez une charge comme dans le dernier exemple :
{
  "type": "REMOVE",
  "target": "ORGANISATION_UNIT",
  "targetId": "<id>"
}
targetId fait référence à l'ID de l'objet qui doit être supprimé. Un commentaire en texte libre peut être ajouté à n'importe quel type de commentaire. Seul le type de cible ORGANISATION_UNIT est actuellement pris en charge.
Pour accepter une proposition ouverte, envoyez une requête POST à la ressource des propositions.
POST /api/metadata/proposals/<uid>
En cas de succès, le statut de la proposition passe à ACCEPTED (acceptée). Une fois acceptée, la proposition ne peut plus être rejetée.
Si une proposition ne s'applique pas, le statut passe à NEEDS_UPDATE (besoin de mise à jour). Le champ reason contient un résumé des échecs lorsque cette information est disponible.
Si une proposition n'est pas tout à fait correcte et doit être ajustée, vous pouvez effectuer une requête PATCH sur la ressource des propositions.
PATCH /api/metadata/proposals/<uid>
En option, un texte simple peut être ajouté pour fournir une raison au refus de la proposition.
Une proposition refusée doit avoir au préalable le statut PROPOSED (proposée) avant de passer à NEEDS_UPDATE.
Une proposition au statut NEEDS_UPDATE doit être ajustée avant d'être acceptée. Pour ajuster la proposition, une requête PUT est faite pour la ressource.
PUT /api/metadata/proposals/<uid>
Un tel ajustement peut être effectué soit sans corps, soit avec un corps JSON contenant un objet dont les propriétés change et targetId sont mises à jour pour l'ajustement :
{
  "targetId": "<id>",
  "change": ...
}
change dépend du type de la proposition, de la même manière que lorsqu'une proposition est initialement faite. Pour rejeter une proposition ouverte, envoyez une requête DELETE à la ressource des propositions.
DELETE /api/metadata/proposals/<uid>
Le statut de la proposition devient alors REJECTED (rejetée). Aucune autre modification ne peut être apportée à cette proposition. Elle est conservée comme documentation des événements.
Toutes les propositions peuvent être listées :
GET /api/metadata/proposals/
La liste des résultats peut être filtrée à l'aide du paramètre filter. Par exemple, pour ne lister que les propositions acceptées, faites la requête suivante :
GET /api/metadata/proposals?filter=status:eq:ACCEPTED
De même, pour ne montrer que les propositions ouvertes, utilisez ceci :
GET /api/metadata/proposals?filter=status:eq:PROPOSED
Les filtres peuvent également être appliqués à n'importe quel champ, à l'exception du champ change. Les opérateurs de filtre pris en charge sont ceux décrits dans l'API Gist Metadata. Cela inclut également les transformateurs de propriétés décrits dans l'API Gist.
Voici une liste des champs disponibles :
| Champ | Description |
|---|---|
| id | identifiant unique de la proposition |
| type | ADD (ajouter un nouvel objet, UPDATE (mettre à jour) un objet existant, REMOVE (supprimer) un objet existant |
| status | PROPOSED (proposition ouverte), ACCEPTED (succès), NEEDS_UPDATE (l'acceptation à causé une erreur ou a été refusée), REJECTED (rejet) |
| cible | type d'objet de métadonnées à ajouter/mettre à jour/supprimer. Actuellement, seul ORGANISATION_UNIT peut être utilisé. |
| targetId (id de la cible) | UID de l'objet mis à jour ou supprimé. Il n'est pas défini pour la fonction ADD |
| createdBy (créé par) | l'utilisateur qui a créé la proposition |
| created | la date et l'heure de création de la proposition |
| finalisedBy | l'utilisateur qui a accepté ou rejeté la proposition |
| finalisé | la date et l'heure auxquelles la proposition a été acceptée ou rejetée. |
| commentaire | commentaire en texte simple facultatif donné pour la proposition initiale |
| raison | texte simple facultatif fourni lorsque la proposition a été refusée ou que des erreurs sont survenues lors de l'acceptation d'une proposition |
| change | Objet JSON pour la proposition ADD, tableau JSON pour la proposition UPDATE, rien pour la proposition REMOVE. |
Les propositions de modification d'objets individuels peuvent être consultées à l'aide de
GET /api/metadata/proposals/<uid>
Le paramètre fields peut être utilisé pour restreindre les champs inclus dans l'objet affiché. Par exemple :
GET /api/metadata/proposals/<uid>?fields=id,type,status,change
| Type | Validation |
|---|---|
| TEXT | Aucun |
| LONG_TEXT (texte long) | Aucun |
| LETTRE | Longueur de la valeur = 1 ET il s'agit d'une lettre |
| NUMÉRO_DE TÉLÉPHONE | La validation est basée sur cette expression rationnelle ^[0-9+\\N-(\N-)#\N.\Ns\N/ext-]{6,50}$. La longueur maximale est de 50. Exemples : +4733987937, (+47) 3398 7937, (47) 3398 7937.123 |
| Format général des email : abc@email.com | |
| BOOLEAN | vrai or faux |
| TRUE_ONLY (vrai uniquement) | N'accepte que true |
| DATE | Utiliser le format yyyy-MM-dd |
| DATETIME (date et heure) | Utiliser le format yyyy-MM-dd HH:mm:ssZ ou yyyy-MM-dd 'T'HH:mm:ss |
| TEMPS | Utiliser le format HH:mm |
| NUMBER | La valeur doit être numérique avec une longueur maximale = 250 |
| UNIT_INTERVAL | La valeur est numérique et comprise entre 0 et 1. |
| PERCENTAGE | La valeur est un nombre compris entre 0 et 100. |
| INTEGER | La valeur est un nombre entier |
| INTEGER_POSITIVE | La valeur est un nombre entier positif |
| INTEGER_NEGATIVE | La valeur est un nombre entier négatif |
| INTEGER_ZERO_OR_POSITIVE | La valeur est un entier positif ou nul |
| NOM D'UTILISATEUR | La valeur est un nom d'utilisateur pour un utilisateur existant |
| COORDONNÉE | Aucun |
| ORGANISATION_UNIT | La valeur est un UID valide d'une unité d'organisation existante |
| RÉFÉRENCE | Aucun |
| ÂGE | La valeur est une date de naissance. Utiliser le même format que pour le type DATE. |
| URL | La valeur est une URL valide |
| FILE_RESOURCE | La valeur est un UID valide d'une ressource de fichier existante |
| IMAGE | La valeur est un UID valide d'une ressource de fichier existante |
| GEOJSON | Suivre [Spécification GeoJson] (https://geojson.org) |
| MULTI_TEXT | Aucun |
Souvent, les utilisateurs veulent créer de nombreux Programmes qui partagent les mêmes caractéristiques. Au lieu de créer un nouveau Programme de A à Z, ils peuvent copier un Programme existant et lui apporter des modifications. En théorie, un Programme modèle peut être créé et être utilisé pour effectuer ces copies, ce qui peut également aider à rendre les Programmes cohérents.
POST /api/programs/{uid}/copy
Exemple avec un Programme dont l'UID est Program123a
POST /api/programs/Program123a/copy
En cas de succès, la réponse contiendra un nouveau UID de Programme et ressemblera à ceci :
{
    "httpStatus": "Created",
    "httpStatusCode": 201,
    "status": "OK",
    "message": "Program created: 'Program456b'"
}
La réponse contiendra également un en-tête Location (emplacement) avec un lien vers le Programme nouvellement créé. Par exemple, si le programme est exécuté localement, la valeur de Location sera http://localhost:9090/api/programs/Program456b.
L'API permet d'utiliser un préfixe personnalisé à titre facultatif, lequel sera ajouté aux propriétés suivantes.
| Objet | Propriété | Information |
|---|---|---|
| Programme | name | Aider à identifier le nouveau programme |
| ProgramIndicator | name | Contrainte de base de données - doit être unique |
| ProgramIndicator | Nom court | Contrainte de base de données - doit être unique |
Dans cet exemple, lorsqu'un préfixe personnalisé est fourni, un Programme original portant le nom Mon Programme Simple sera copié dans un nouveau Programme portant le nom mon préfixe Mon Programme Simple
Si aucune option de copie n'est envoyée dans l'appel API, alors le préfixe par défaut Copy of (copie de) sera utilisé pour les propriétés ci-dessus. Pour envoyer un préfixe personnalisé, il suffit d'ajouter un paramètre de requête HTTP prefix comme suit :
POST /api/programs/{uid}/copy?prefix=my prefix
Note
La base de données fixe des limites au nombre de caractères autorisés pour les propriétés. Au moment de la rédaction de ces propriétés, les limites seront indiquées dans le tableau ci-dessous. Gardez-les à l'esprit.
| Propriété | limite de caractères |
|---|---|
| name | 230 |
| Nom court | 50 |
Si une propriété a dépassé sa limite de caractères, une message d'erreur sera renvoyée comme suit :
{
    "httpStatus": "Conflict",
    "httpStatusCode": 409,
    "status": "ERROR",
    "message": "ERROR: value too long for type character varying(230)",
    "errorCode": "E1004"
}
Si l'utilisateur essaie de copier un programme qui n'est pas trouvé, une réponse de ce type sera renvoyée :
{
    "httpStatus": "Not Found",
    "httpStatusCode": 404,
    "status": "ERROR",
    "message": "Program with id {uid} could not be found.",
    "errorCode": "E1005"
}
Un Utilisateur aura besoin des autorisations suivantes pour pouvoir copier un Programme :
Un Programme doit avoir un des statuts suivants pour pouvoir être copié :
lecture et en écritureUtilisateur spécifique autorisé à partager les accès en lecture et en écriture.utilisateur faisant partie d'un groupe d'utilisateurs et qui est autorisé à partager les accès en lecture et en écriture.Si un utilisateur n'a pas les bonnes autorisations, une réponse Forbidden (d'interdiction) est renvoyée comme suit :
{
    "httpStatus": "Forbidden",
    "httpStatusCode": 403,
    "status": "ERROR",
    "message": "You don't have write permissions for Program Program123a",
    "errorCode": "E1006"
}
Lorsqu'un Programme est copié, certaines propriétés du Programme nécessitent des types de copie différents. Il est important de savoir ce qui a été copié en profondeur et ce qui a été copié superficiellement.
Tout d'abord, expliquons la différence entre la copie profonde et la copie superficielle dans ce contexte.
Dans ce contexte, une copie profonde signifie qu'une instance entièrement nouvelle d'un Programme ou d'une propriété de Programme a été créée avec ses propres identifiants uniques. Il s'agit entre autres de :
Les copies profondes des propriétés de programme feront toutes partie de la copie du programme nouvellement créée.
Dans ce contexte, une copie superficielle signifie qu'une propriété de programme existante sera réutilisée par le programme ou la propriété de programme nouvellement créé(e).
Toutes les propriétés ci-dessous ont été copiées en profondeur. Si une propriété ne figure pas dans ce tableau, cela signifie qu'elle a été copié superficiellement.
| Objet | Propriété de |
|---|---|
| Programme | |
| Section de programme | Programme |
| ProgramIndicator | Programme |
| Variable de règle de programme | Programme |
| Étape de programme | Programme |
| Section d'une étape de programme | Étape de programme |
| Élément de données d'une section d'étape de programme | Étape de programme |
| Inscription |
Remarque
Les propriétés suivantes ont été définies comme vides dans une première approche. Cette approche devrait permettre de simplifier les choses pour commencer.
| Objet | Propriété |
|---|---|
| ProgramIndicator | groupes |
| Section d'une étape de programme | Indicateurs de programme |
| Inscription | events |
L'API Gist des métadonnées est une API JSON RESTful en lecture uniquement qui permet de récupérer et de parcourir des métadonnées. Les éléments de cette API contiennent la gist du même élément dans l'API Métadonnées.
L'API est spécifiquement conçue pour éviter :
L'API standard des métadonnées est une API flexible et puissante, conçue pour répondre à tous les cas d'utilisation. L'inconvénient est que toutes les fonctionnalités et combinaisons ne peuvent pas être mises à l'échelle tout en conservant de bonnes performances en présence d'un grand nombre d'éléments. En particulier, les listes d'éléments où chaque élément possède une propriété qui est une grande collection d'objets complexes se sont avérées problématiques car elles font rapidement référence à une grande partie du graphe d'objets entier.
L'API /gist a été ajoutée pour fournir une API de métadonnées où la mise à l'échelle est notre première priorité. L'inconvénient est qu'il y a des limites plus distinctes à ce qui est techniquement raisonnable, ce qui signifie que toutes les fonctionnalités de l'API standard de métadonnées n'existent pas pour l'API Gist.
L'API Gist utilise une stratégie de division et de conquête pour éviter les réponses avec de grands graphes d'objets partiels. Au lieu d'inclure des objets ou des listes imbriqués, elle fournit un URI de point de terminaison /gist où cet objet ou cette liste peut être visualisé de manière isolée.
L'API /gist se réfère aux données imbriquées en utilisant les URI plutôt que de les inclure. Cela signifie que si un client est intéressé par ces informations imbriquées, il faudra plus de requêtes, mais chacune d'entre elles reste raisonnablement petite et s'adaptera bien dans le contexte d'un grand nombre d'éléments potentiels.
Les différences connues :
pagination) pagination mais à travers un point de terminaison API paginé pour la propriété particulière de la collection membre(<id>) et non-membre(<id>)peutLire et peuModifier au lieu de filtrer selon la propriété accèspageListNameLes limites connues :
depluck transformer limited to text properties (or simple properties for multi-pluck)Lorsque cela est possible, l'utilisation de l'API /gist doit être considérée comme la meilleure façon d'obtenir des informations sur les métadonnées.
L'API /gist a 3 types de points de terminaison :
/api/<object-type>/gist : liste paginée de tous les objets connus et visibles du type (implicite auto=S)/api/<object-type>/<object-id>/gist : affichage d'un seul objet par identifiant (implicite auto=L)/api/<object-type>/<object-id>/<field-name>/gist : liste paginée de tous les éléments connus et visibles dans la collection du champ de l'objet propriétaire (implicite auto=M ; dans le cas d'un champ simple, juste la valeur du champ).Ces points de terminaison correspondent aux points de terminaison de l'API standard de métadonnées sans le suffixe /gist et partagent la majorité des paramètres et de leurs options avec cette API.
Puisque l'API /gist évite les structures de données profondément intégrées dans la réponse, les détails des objets complexes ou des listes d'objets référencés sont plutôt fournis sous la forme d'un URI vers le point de terminaison gist qui renvoie uniquement l'objet complexe ou la liste d'objets. Ces URI sont fournies par le champ pointsdeterminaisonsdel'api d'un élément qui est automatiquement ajouté à un élément lorsque de telles références existent. La propriété item elle-même peut contenir un résultat de transformation sur l'objet ou la collection tel que sa taille, sa contenance, sa non contenance, son (ses) identifiant(s) ou une propriété extraite telle que son nom.
Pour parcourir manuellement les données, il peut être pratique d'utiliser le paramètre absoluteUrls=true. Les liens entre les parties de la liste peuvent maintenant être suivis directement dans les navigateurs qui affichent les réponses JSON.
Tous les points de terminaison de l'API /gist acceptent le même ensemble de paramètres. Les paramètres et leurs options qui n'ont pas de sens dans le contexte du point de terminaison sont ignorés.
Les paramètres par ordre alphabétique :
| Paramètre | Options | Par défaut | Description |
|---|---|---|---|
Urls absolus | vrai or faux | faux | vrai utilise les chemins relatifs dans les liens, faux utilise les URL absolues dans les liens |
automatique | XS, S, M, L, XL | (en fonction du contexte) | étendue des champs sélectionnés par * le sélecteur de champ |
champs | (en fonction du point de terminaison) | * | liste de champs ou de préréglages séparés par des virgules à inclure |
filtre | <field>:<operator> ou <field>:<operator>:<value> | liste de filtres de champs de requête séparés par des virgules (peut être utilisée plus d'une fois) | |
sans titre | vrai or faux | faux | true skip wrapping result in a pager (ignores total), false use a pager wrapper object around the result list |
inversé | vrai or faux | faux | La valeur vrai renvoie les éléments pas dans la liste, la valeur faux renvoie les éléments dans la liste. |
locale | (langue configurée du compte utilisateur) | remplacement de la langue de traduction | |
order | <field> or <field>:asc or <field>:desc | :asc | comma separated list of query order fields (can be used more than once) |
page | 1-n | 1 | numéro de page |
pageSize | 1-1000 | 50 | nombre d'éléments sur une page |
pageListName | <text> | (object type plural) | overrides the property name of the result entry list |
jonction de racines | ET or OU | ET | combinaison logique de filtres, ET= tous doivent correspondre, OU= au moins un doit correspondre |
total/totalPages | vrai or faux | faux | vrai ajoute le nombre total de correspondances à la pagination, faux ne compte pas le nombre total de correspondances |
traduire | vrai or faux | true | vrai traduit toutes les propriétés traduisibles, faux saute la traduction des propriétés traduisibles (pas d'effet sur les noms d'affichage synthétiques) |
absoluteUrlsPar défaut, les URIs dans les points de terminaison api, href et les membres précedent et suivant de lapagination sont relatifs, et commencent par le chemin /<object-type>/.
Les URI peuvent être changés en URL absolues en utilisant le paramètre absoluteUrls.
Par exemple, /api/users/rWLrZL8rP3K/gist?fields=id,href renvoie :
{
  "id": "rWLrZL8rP3K",
  "href": "/users/rWLrZL8rP3K/gist"
}
tandis que /api/users/rWLrZL8rP3K/gist?fields=id,href&absoluteUrls=true renvoie :
{
  "id": "rWLrZL8rP3K",
  "href": "http://localhost:8080/api/users/rWLrZL8rP3K/gist?absoluteUrls=true"
}
Comme le montre l'exemple, le paramètre absoluteUrls est également transmis ou reporté dans les URLs incluses, ce qui permet de parcourir les réponses en suivant les URLs fournies.
autoChaque point d'accès définit implicitement une valeur par défaut pour l'étendue des champs correspondant au sélecteur de champs* / :tout :
/api/<object-type>/gist : implique que auto=S/api/<object-type>/<object-id>/gist: implique que auto=L/api/<object-type>/<object-id>/<field-name>/gist: implique que auto=MLe paramètre auto est utilisé pour surcharger manuellement la valeur par défaut afin que les éléments de la liste incluent plus ou moins de champs. Ce paramètre agit à nouveau comme une valeur par défaut qui peut être modifiée pour chaque champ à l'aide d'une transformation explicite.
Les options possibles pour auto sont (" les tailles de t-shirt ") :
XS : inclut uniquement les identifiants et les propriétés textuellesS : exclut les propriétés complexes (objets), les collections sont uniquement liées (non comptabilisées)M : complexe inclus en tant qu'URL de référence, les références et les collections en tant qu'URL de comptage et de référenceL : comme M mais les références et les collections sont incluses en tant qu'identifiants (OBS ! non consolidé en taille)XL : comme L mais les références et les collections sont incluses en tant qu'objets de l'identifiant : { "id" : <id>}Par exemple, /api/users/gist listerait les éléments avec les champs identifiant, nom, prénom, numéro de téléphone, email, dernière mise à jour alors que /api/users/gist?auto=XS ne liste que l' identifiant, le nom, le prénom, le numéro de téléphone, l'email. L'utilisation de /api/users/gist?auto=L inclurait également unités d'organisation, unités d'organisation de visualisation des données, Unités d'organisation de recherche d'instances d'entités suivis et groupes d'utilisateurs, chacun avec la liste des identifiants des membres des listes/ensembles.
champsSpécifie la liste des champs à inclure pour chaque élément de la liste.
Les champs sont inclus dans les résultats des objets JSON pour un élément dans l'ordre indiqué. Un preset dans la liste des champs est étendu aux champs qu'il contient en fonction de la position qu'il occupe dans la liste fields. Les champs de la présélection sont classés de simple à complexe.
Si aucun paramètre fields n'est fourni, fields=* est pris en compte. Notez que les champs du *preset dépendent également du paramètre auto.
Pour supprimer un champ, utilisez !<name> ou -<name> dans la liste des champs. Par exemple, pour supprimer les groupes d'utilisateurs d'un utilisateur, utilisez :
/api/users/gist?fields=*,!groupes d'utilisateurs
Le même principe peut être utilisé pour spécifier le transformateur à utiliser pour un champ. Par exemple, pour inclure les identifiants des groupes d'utilisateurs de l'utilisateur, utilisez :
/api/users/gist?fields=*,groupes d'utilisateurs:identifiants
Le paramètre champs permet de lister les champs des objets imbriqués. Par exemple, pour ajouter références de l'utilisateur avec identifiant et nom d'un utilisateur, utilisez :
/api/users/gist?fields=*,références de l'utilisateur[identifiant,Nom d'utilisateur]
Cela crée des éléments du genre :
{
  ...
  "références de l'utilisateur": {
    "identifiant": "Z9oOHPi3FHB",
    "Nom d'utilisateur": "invité"
  }
}
Lors de l'inclusion de champs imbriqués de collections, le champ imbriqué doit être une propriété textuelle.
Par exemple pour inclure tous les noms des groupes d'utilisateurs d'un utilisateur par :
/api/users/gist?fields=*,groupes d'utilisateurs[nom]
La liste des groupes d'utilisateurs est la suivante:
{
  "groupes d'utilisateurs ": {
    "nom": [
      "_PROGRAMME_Programme pour les patients hospitalisés",
      "_PROGRAMME_Programme TB",
      "_ENSEMBLE DE DONNÉES_Superutilisateur",
      "_PROGRAMME_Superutilisateur",
      "_ENSEMBLE DE DONNÉES_Agent de saisie des données",
      "_ENSEMBLE DE DONNÉES_Agent M et E"
    ]
  }
}
/api/users/gist?fields=*,groupe d'utilisateurs::pluck( nom)~renommer(groupe d'utilisateurs.nom)
Lorsque l'on demande un seul champ, comme /api/users/gist?fields=nom, la réponse est une liste (toujours paginée) de valeurs simples :
{
  "pager": {
    "page": 1,
    "taille de la page": 50
  },
  "utilisateurs": [
    "Kamara",
    "Wakiki",
    "Nana",
    "Malai",
    ...
  ]
}
Lorsque l'on demande un champ unique de l'objet d'un propriétaire spécifique qui a une valeur simple (sans collection), comme par exemple /api/users/rWLrZL8rP3K/gist fields=surname, la réponse comprend uniquement la valeur JSON simple:
"Wakiki"
Pour plus de détails sur les préréglages de champs, voir la section Champs.
filtrePour filtrer la liste des éléments renvoyés, ajoutez un ou plusieurs paramètres filtre.
Plusieurs filtres peuvent être spécifiés sous la forme d'une liste séparée par des virgules d'un seul paramètre ou comme de multiples paramètres filtre, chacun avec un seul filtre.
Il existe deux types de filtres :
<field>:<operator><field>:<operator>:<value>Un champ peut être :
Les opérateurs unitaires disponibles sont les suivants :
| Opérateur unitaire | Description |
|---|---|
nul | le champ est nul (non défini) |
!nul | le champ est non nul (défini) |
vide | Le champ est une collection ou une chaîne vide |
!vide | le champ est une collection ou une chaîne de caractères non vide |
Les opérateurs binaires disponibles sont les suivants :
| Opérateur binaire | Description |
|---|---|
eq | champ égal valeur |
ieq | champ égal valeur (insensible à la casse) |
!eq, neq, ne | champ non égal valeur |
lt | champ inférieur à valeur |
le, lte | champ inférieur ou égal à valeur |
gt | champ supérieur à valeur |
ge, gte | champ supérieur ou égal à valeur |
in | le champ est une collection et la valeur est un élément contenu dans la collection |
!in | le champ est une collection et la valeur est un élément non contenu dans la collection |
Si la <value> d'un filtre in ou !in est une liste, il est donné sous la forme suivante [valeur1,valeur2,...], par exemple: groupes d'utilisateurs:dans:[fbfJHSPpUQD,cYeuwXTCPkU].
Toute comparaison >, >=, < <=, == ou != appliquée à un champ de collection avec une valeur numérique comparera la taille de la collection à la valeur, par exemple : groupes d'utilisateurs:gt:0.
Toute comparaison >, >=, < <=, == ou != appliquée à un champ de texte avec une valeur numérique entière comparera la longueur du texte à la valeur, par exemple : nom:eq:4 (nom a une longueur de 4).
Les opérateurs de recherche de motifs binaires disponibles sont les suivants :
| Opérateur binaire | Description |
|---|---|
like, ilike | le champ contient <value> ou le champ correspond au motif <value> (lorsque les caractères génériques * ou ? sont présents dans la valeur) |
!like, !ilike | le champ ne contient pas <value> ou le champ ne correspond pas au motif <value> (lorsque les caractères génériques * ou ? sont présents dans la valeur) |
$like, $ilike, commence avec | le champ commence avec <value> |
!$like, !$ilike, !commence avec | le champ ne_commence pas avec_ <value> |
like$, ilike$, se termine par | le champ se termine par <value> |
!like$, !ilike$, !se termine avec | le champ ne_se termine pas par_ <value> |
Les opérateurs like et !like peuvent être utilisés soit en fournissant un terme de recherche, et dans ce cas la correspondance est toute valeur où le terme apparaît à tout endroit, soit en fournissant le motif de recherche en utilisant * comme nombre quelconque de caractères et ? comme caractère unique.
Tous les opérateurs de recherche de motifs nommés like sont sensibles à la casse. Tous les autres sont insensibles à la casse.
Notez que les filtres sur les valeurs d'attributs utilisent une comparaison basée sur le texte, ce qui signifie que tous les filtres textuels sont pris en charge.
Par exemple, pour ne répertorier que les organisations de deuxième niveau, utilisez
/api/organisationUnits/gist?filter=level:eq:2
De même, lorsqu'il s'agit de lister les enfants d'une unité d'organisation particulière, la collection peut être filtrée. Pour ne lister que les enfants qui sont connectés à à un programme, on peut utiliser:
/api/organisationUnits/rZxk3S0qN63/children/gist?filter=programs:gt:0
Opérateurs binaires pour le filtrage basé sur l'accès (le partage) :
| Opérateur binaire | Description |
|---|---|
peutLire | L'utilisateur <value> de métadonnées a t'il le droit de consulter l'objet |
peutModifier | L'utilisateur <value> de métadonnées a t-il le droit de modifier l'objet ? |
peut Lire les données | L'utilisateur <value> des données a t'il le droit de consulter l'objet |
peutModifier les données | L'utilisateur <value> des données a t-il le droit de modifier l'objet ? |
peutAccéder | L'utilisateur a t'il la <value0> permission <value1> d'accéder à l'objet |
Lorsque l'identifiant de l'utilisateur <value> est omis, la vérification est effectuée pour l'utilisateur actuellement connecté. De même, si <value0> est omis pour le filtre peutAccéder, la vérification est effectuée pour l'utilisateur actuellement connecté.
Lorsqu'il est appliqué à une propriété de valeur simple, ici code, le filtre limite la réponse à ces éléments de données (propriétaire de l'objet) que l'utilisateur peut lire/modifier :
/api/dataElements/gist?filter=code:canWrite:OYLGMiazHtW
Lorsqu'il est appliqué à une propriété de référence, ici combinaison de catégories, le filtre limite la réponse à ces éléments de données ayant une combinaison de catégories que l'utilisateur peut lire/modifier:
/api/dataElements/gist?filter=categoryCombo:canWrite:OYLGMiazHtW
Lorsqu'il est appliqué à une propriété de collection de référence, ici groupe d'éléments de données, le filtre limite la réponse à ces éléments de données pour lesquels un groupe d'éléments de données existe dans la propriété de collection et que l'utilisateur peut lire/modifier :
/api/dataElements/gist?filter=dataElementGroups:canWrite:OYLGMiazHtW
La fonction peutAccéder demande deux arguments, le premier est l'identifiant de l'utilisateur, le second le modèle d'accès, par exemple, pour vérifier l'accès en lecture et en modification des métadonnées, le motif est rw% :
/api/dataElements/gist?filter=code:canAccess:[OYLGMiazHtW,rw%]
En outre, les filtres peuvent être regroupés pour permettre de combiner les filtres sélectionnés avec un OU logique lorsque le combinateur de filtre général est un ET logique, ou inversement avec un ET logique lorsque le combinateur général est un OU logique.
Pour les groupes, le modèle de filtre est élargi comme suit :
<group>:<field>:<operator><group>:<field>:<operator>:<value>Le groupe est un nombre arbitraire compris entre 0 et 9 (en cas d'omission, 0 est pris en compte).
La meilleure façon d'expliquer ce comportement est de donner un petit exemple pour un type d'objet imaginaire avec une propriété age et nom.
?filter=1:age:eq:50&filter=2:name:eq:foo&filter=2:name:eq:bar
Le filtre ci-dessus a deux groupes 1 et 2, et le groupe 2 a 2 membres. Ceci est équivalent au SQL (notez les et et ou ainsi que les accolades de regroupement) :
e.age = 50 and (e.name = 'foo' or e.name = 'bar')
Maintenant, si le même filtre est utilisé en combinaison avec rootJunction=OR
?filter=1:age:eq:50&filter=2:name:eq:foo&filter=2:name:eq:bar&rootJunction=OR
l'effet serait équivalent plutôt au code SQL suivant :
e.age = 50 or (e.name = 'foo' and e.name = 'bar')
sans titreLes points d'extrémité qui renvoient une liste enveloppent par défaut les éléments dans une enveloppe contenant le pager et la liste, qui est nommée en fonction du type d'objet listé.
Par exemple, l'option /api/organisationUnits/gist renvoie :
{
  "pager": {
    "page": 1,
    "taille de la page": 50,
    "page suivante": "/organisationUnits/gist?page=2"
  },
  "unités d'organisation": [
    ...
  ]
}
Avec headless=true, la réponse à /api/organisationUnits/gist?headless=true est juste la partie de la liste [...] de l'exemple ci-dessus.
inverseLe inverse peut être utilisé dans le contexte d'un champ de collection gist de la forme /api/<object-type>/<object-id>/<field-name>/gist pour ne pas lister tous les éléments qui sont contenus dans la collection membre mais tous les éléments qui ne sont pas contenus dans la collection membre.
Par exemple, alors que
/api/organisationUnits/rZxk3S0qN63/children/gist
listerait toutes les unités d'organisation qui sont des enfants de rZxk3S0qN63 l'inverse
/api/organisationUnits/rZxk3S0qN63/children/gist?inverse=true
listerait toutes les unités d'organisation qui ne sont pas des enfants de rZxk3S0qN63. Cela pourrait par exemple être utilisé pour composer une liste de toutes les unités qui peuvent devenir des enfants d'une unité particulière.
Les filtres et les commandes s'appliquent normalement, c'est-à-dire qu'ils filtrent ou commandent les éléments non contenus dans la collection de membres.
localLe paramètre locale est généralement utilisé à des fins de test pour changer de manière ad-hoc la langue de traduction des noms d'affichage.
Si elle n'est pas spécifiée, la langue de traduction est celle configurée dans les paramètres du compte de l'utilisateur.
Exemples:
/api/organisationUnits/gist?locale=en
/api/organisationUnits/gist?locale=en_GB
ordrePour trier la liste des éléments, une ou plusieurs expressions d'ordre peuvent être données.
Une expression d'ordre est soit un simple nom de champ persistant, soit un nom de champ suivi de :asc (ordre croissant - par défaut) ou de :desc (ordre décroissant).
Par exemple, pour trier les unités d'organisation par ordre alphabétique de nom, utilisez :
/api/organisationUnits/gist?order=name
L'ordre alphabétique inverse serait utilisé :
/api/organisationUnits/gist?order=name:desc
Pour trier les unités d'organisation en premier lieu par niveau, puis par nom, utilisez :
/api/organisationUnits/gist?order=level,name
On commencera par la (les) racine(s) au niveau 1. Pour commencer avec les unités foliaires, utilisez :
/api/organisationUnits/gist?order=level:desc,name
Si aucun ordre n'est spécifié, la liste des résultats aura un ordre stable basé sur l'organisation interne des données.
pageFait référence à la page consultée dans la liste des pages, en commençant par 1 pour la première page.
Si le paramètre page n'est pas présent, il est égal à page=1.
La page est toujours en relation avec la taille de la page. Si une page est indiquée au-delà du nombre de correspondances existantes, une liste d'éléments vide est renvoyée.
taille de la pageIndique le nombre d'éléments d'une page. Le maximum est de 1000 éléments.
Si le paramètre taille de la page n'est pas présent, il est égal à taille de la page=50.
jonction de racinesLe paramètre jonction de racines peut être utilisé pour définir explicitement la jonction logique utilisée entre les filtres. Les possibilités sont les suivantes :
ET : tous les filtres doivent correspondre à une donnée pour qu'elle soit incluse dans les résultatsOU : l'un des filtres correspond à une donnée pour qu'elle soit incluse dans les résultatsLa valeur par défaut est ET
pageListName ParameterThe array property in a paged response that contains the matching entry list is named after the object type contained in the list. For /api/organisationUnits/gist it would be named organisationUnits.
This default naming can be customized using the pageListName parameter. For example, /api/organisationUnits/gist?pageListName=matches returns a response root object with the format:
{
  "pager": {},
  "matches": []
}
total or totalPages ParameterPar défaut, une requête gist ne comptera pas le nombre total de correspondances si celles- ci dépassent la limite taille de la page. Au lieu de cela, nous acceptons les coûts supplémentaires que le comptage total implique.
Si l'on ne compte pas le nombre total de correspondances (Total=faux), la réponse pager suppose qu'il y a une page suivante dans le cas où des éléments taille de la page ont été trouvés. Ceci pourrait cependant s'avérer faux lorsque l'on navigue sur la page. De plus, le champ total indiquant le nombre de correspondances totales n'est pas inclus dans le pager.
Par exemple, /api/organisationUnits/gist renvoie un pager :
{
  "pager": {
    "page": 1,
    "taille de la page": 50,
    "page suivante": "/organisationUnits/gist?page=2"
  }
}
Lorsque l'on compte le nombre total de correspondances (Total=vrai), la réponse pager contiendra le champ total avec le nombre réel de correspondances totales au prix d'une opération supplémentaire sur la base de données.
La réponse à /api/organisationUnits/gist?total=true renvoie maintenant ce pager :
{
  "pager": {
    "page": 1,
    "taille de la page": 50,
    "total": 1332,
    "page suivante": "/organisationUnits/gist?total=true&page=2",
    "nombre de pages": 27
  }
}
traduireLes champs tels que nom ou Nomcourt peuvent être traduits (internationalisés).
Par défaut, tout champ traduisible ayant une traduction est renvoyé traduit à condition que la langue de l'interface soit configurée par l'utilisateur qui demande la gist.
Pour retourner le champ non traduit, utilisez traduit=faux.
Par exemple, /api/organisationUnits/gist renvoie des éléments comme suit :
{
  "nom": "Un nom traduit",
  ...
}
Alors que /api/organisationUnits/gist?translate=false renverrait des éléments comme :
{
  "nom"
  "Nom du champ brut",
  ...
}
Notez que les champs synthétiques Afficher le nom et Afficher le nom court renvoient toujours la valeur traduite, indépendamment du paramètre traduire.
Les champs inclus par défaut (sans le paramètre champs) correspondent à champs=*. Cela signifie que la liste des champs affichés dépend du type d'objet, du contexte du point d'extrémité ainsi que du paramètre auto.
Notez que l'API /gist exclut toujours certains champs qui ne sont généralement pas importants pour les clients, comme par exemple les champs traductions ou partage. Ceux-ci peuvent être ajoutés explicitement.
Lorsqu'elle n'est pas explicitement fournie par un nom dans les paramètres champs, la liste des champs est calculée à partir d'un préréglage. Un préréglage peut être utilisé dans la liste des champs comme un nom de champ. Il se développe en zéro, un ou plusieurs champs en fonction du type d'objet, du point d'extrémité utilisé et du sélecteur.
* / :tous: les champs par défaut dépendent du contexte et du paramètre auto:identifiable : tous les champs maintenus de l'interface Objet identifiable :propriétaire : tous les champs maintenus pour lesquels le type listé est le propriétaire:nommable : tous les champs maintenus de l'interface ObjetNommable:maintenus : littéralement tous les champs maintenus Un transformateur ou une transformation peut être appliqué à un champ en ajoutant l'un des indicateurs ::, ~ ou @ suivi de l'expression du transformateur.
Les expressions de transformateur disponibles sont les suivantes :
| Transformateur | Type de résultat JSON | Description |
|---|---|---|
renommer(<name>) | - | renomme le champ dans la réponse en <name> |
taille | nombre | nombre d'éléments dans le champ de collecte |
estVide | boolean | vide d'un champ de collecte |
n'estPasvide | boolean | non-emptiness of a collection field |
identifiants | chaîne ou [chaîne] | Identifiant d'un objet ou identifiant d'éléments d'une collecte |
Identifiant - Objets | [{ "identifiant": <id> }] | Identifiants des éléments de la collecte en tant qu'objet |
membre(<id>) | boolean | a un membre avec <id> pour le champ de collecte |
pas-membre(<id>) | boolean | n'a pas de membre avec <id> pour le champ de collecte |
pluck(<field>,...) | chaîne ou [chaîne] | extract single text property or multiple simple properties from the object or of each collection item |
de(<field>,...) | dépend du type de grain | extrait un champ non pérenne d'un ou plusieurs champs pérennes |
Un champ peut recevoir à la fois le transformateur renommer et l'un des autres transformateurs, par exemple :
/api/organisationUnits/gist?fields=*,children::size~rename(child-count)
Les éléments renvoyés n'ont plus de membre enfants mais un membre nombre-d'enfants à la place. Notez que renommer affecte aussi le nom du membre de la référence de l'URI donnée dans l'apidespointsd'Extrémités.
La transformation from peut être utilisée avec un ou plusieurs champs pérennes en paramètre. Ceux-ci seront chargés à partir de la base de données, définis dans une instance de l'objet élément listé avant que la propriété non pérenne transformée avec from ne soit extraite de cette instance en appelant le getter. Cela permet d'extraire des champs dérivés tout en utilisant la même logique que celle utilisée dans l'API de métadonnées habituelle.
Par exemple, le nom d'un utilisateur (propriété non pérenne) nom est composé des propriétés pérennes Prénom et nom. Il peut être obtenu de cette manière :
/api/users/gist?fields=id,name~from(firstName,surname)
Puisque le nom d'un utilisateur est un cas si commun, une auto-détection a été ajoutée pour que dans ce cas spécial, la transformation from soit ajoutée automatiquement à nom. Nous sommes autorisés à utiliser ce qui suit, qui ajoute en interne la transformation from :
/api/users/gist?fields=id,name
Bien que cela rende les propriétés non-perrennes accessibles en général, elles doivent toujours être incluses dans les champs de manière explicite. Pour un utilisateur, cela peut se faire de la manière suivante :
/api/users/gist?fields=*,name
L'API /gist est étroitement liée aux propriétés qui existent dans la base de données. Cela signifie que les propriétés qui ne sont pas stockées dans la base de données ne sont généralement pas disponibles. L'exception à cette règle sont les propriétés "synthétiques" qui sont dynamiquement calculées sur la base d'une ou plusieurs propriétés stockées dans la base de données.
Les propriétés synthétiques sont disponibles pour tous les points d'extrémité où existent les propriétés maintenues nécessaires au calcul de la propriété synthétique.
A l'exception de la propriété points d'extrémité de l'api qui est automatiquement ajoutée si nécessaire toutes les autres propriétés synthétiques ne sont pas incluses par défaut et doivent faire l'objet d'une demande explicite dans la liste des champs.
Champs synthétiques par ordre alphabétique :
| Champ | Description |
|---|---|
points d'extrémité de l'api | contient des liens permettant de parcourir des objets ou des collections complexes imbriqués |
href | lien vers l'élément de la liste elle-même ( affichage d'un seul élément) |
Nom d'affichage | nom traduit (toujours traduit) |
afficherNomCourt | NomCourt traduit (toujours traduit) |
accès | résumé sur la capacité de l'utilisateur actuel à lire/saisir/modifier les données |
hrefChaque élément d'une réponse /gist peut avoir un lien vers lui-même. Ce lien est donné dans la propriété href.
Pour ajouter le champ href, utilisez (par exemple) :
/api/<object-type>/gist?fields=*,href
afficherNom et afficherNomCourtPar définition, le afficherNom est le nom traduit et le afficherNomCourt est le nom court traduit.
Pour ajouter afficherNom ou afficherNomCourt à la liste, utilisez (par exemple) :
/api/<object-type>/gist?fields=*,afficherNom
/api/<object-type>/gist?fields=*,afficherNomCourt
Notez que par défaut, toutes les propriétés traduisibles comme nom et nomCourt seront également traduites. Lorsque traduire=faux est utilisé pour désactiver cela, afficherNom et afficherNomCourt restent traduits.
points d'extrémité de l'apiCette propriété permet de parcourir des objets complexes ou des listes d'éléments qui sont inclus dans la réponse /gist sous la forme d'une valeur simple transformée comme un nombre d'éléments.
L'objet points d'extrémité de l'api aura un membre du même nom pour chaque membre de l'élément qui a été transformé en valeur simple.
Par exemple,
/api/users/gist?fields=id,userGroups::size,organisationUnits::size
renvoie les éléments du formulaire :
{
  "identifiant": "rWLrZL8rP3K",
  "groupes d'utilisateurs": 0,
  "unités d'organisation": 1,
  "points d'extrémité de l'api": {
    "unités d'organisation": "/utilisateurs/rWLrZL8rP3K/unités d'organisation/gist",
    "groupes d'utilisateurs": "/utilisateurs/rWLrZL8rP3K/groupes d'utilisateurs/gist"
  }
}
La liste des groupes d'utilisateurs et des unités d'organisation est incluse dans leur taille. Chacun a un membre correspondant dans points d'extrémité de l'api avec un chemin pour parcourir la liste.
Les chemins peuvent être transformés en URL en utilisant le paramètre Urls absolus.
/api/users/gist?fields=id,userGroups::size,organisationUnits::size&absoluteUrls=true
renvoie les éléments du formulaire :
{
  "identifiant": "rWLrZL8rP3K",
  "groupes d'utilisateurs": 0,
  "unités d'organisation": 1,
  "points d'extrémité de l'api": {
    "unités d'organisation":"http://{host}/api/users/rWLrZL8rP3K/organisationUnits/gist?absoluteUrls=true",
    "groupes d'utilisateurs": http://{host}/api/users/rWLrZL8rP3K/userGroups/gist?absoluteUrls=true"
  }
}
accèsLe résumé accès est basé sur le partage et l'utilisateur actuel. Cela signifie qu'il n'est applicable qu'aux objets ayant une propriété partage.
Par exemple, lors de l'établissement d'une liste d'éléments de données avec le champ accès
/api/dataElements/gist?fields=*,access
les éléments de données renvoyés contiennent un membre "accès" comme ci-dessous :
"accès": {
  "gérer": faux,
  "externaliser": faux,
  "modifier": faux,
  "lire": vrai,
  "mettre à jour": faux,
  "supprimer": faux
}
DHIS2 permet de créer et d'ajouter des attributs personnalisés aux objets de métadonnées. Leurs valeurs sont contenues dans la propriété valeurs d'attributs d'un objet de métadonnées sous la forme d'une carte dont la clé est l'UID de l'attribut.
Pour lister directement une ou plusieurs valeurs d'attributs spécifiques de cette carte comme s'il s'agissait de champs habituels de l'objet de métadonnées, l'UID de l'attribut peut être utilisé comme s'il s'agissait du nom d'un champ habituel.
Par exemple, pour inclure la valeur de l'attribut avec l'UID Y1LUDU8sWBR en tant que la propriété unité de mesure dans la liste, utilisez :
/api/dataElements/gist?fields=id,name,Y1LUDU8sWBR::rename(unit-of-measure)
Il en résulte des éléments de liste du type:
{
  "identifiant": "qrur9Dvnyt5",
  "nom": "Âge en années",
  "unité de mesure" : "années"
}
Par défaut, les valeurs sont récupérées au format JSON et extraites de la carte des valeurs d'attributs. Cela signifie que la liste contiendra le type JSON approprié pour le type de valeur d'attribut. Cela implique un surcoût lié à la récupération de toutes les valeurs d'attributs. Pour isoler la valeur dans la base de données, la transformation PLUCK peut être utilisée.
/api/dataElements/gist?fields=id,name,Y1LUDU8sWBR::rename(unit-of-measure)~pluck
Le résultat sera le même, mais la valeur est désormais extraite sous forme de texte dans la base de données, ce qui transforme toute valeur JSON en une chaîne de caractères dans le résultat de la propriété.
Quelques exemples partant de simples listes et allant jusqu'à des cas d'utilisation très spécifiques.
Il est préférable de toujours fournir une liste explicite de champs pour que cette section le fasse.
Liste des unités d'organisation avec leur identifiant et leur nom :
/api/organisationUnits/gist?fields=id,name
Liste des unités d'organisation avec leur identifiant, leur nom et leur nombre total :
/api/organisationUnits/gist?fields=id,name&total=true
Liste des utilisateurs avec l'identifiant et le nom d'utilisateur :
/api/users/gist?fields=id,userCredentials.username
Liste des utilisateurs avec l'identifiant, le nom d'utilisateur et la date de la dernière connexion :
/api/users/gist?fields=id,userCredentials[username,lastLogin]
Ne listez que les unités d'organisation au deuxième niveau avec l'identifiant, le nom et le niveau :
/api/organisationUnits/gist?fields=id,name,level&filter=level:eq:2
Listez uniquement les unités d'organisation qui ont plus d'1 enfant avec l'identifiant, le nom et le nombre d'enfants :
/api/organisationUnits/gist?fields=id,name,children::size&filter=children:gt:1
Listez uniquement les unités d'organisation qui ne sont pas encore enfants d'une autre unité zFDYIgyGmXG :
/api/organisationUnits/zFDYIgyGmXG/children/gist?fields=id,name&inverse=true
Listez les utilisateurs et indiquez s'ils sont membres d'un groupe d'utilisateurs spécifique. NTC8Gj7p8P et nommer ce champ est-membre dans la réponse :
/api/users/gist?fields=id,userCredentials.username,userGroups::member(NTC8GjJ7p8P)~rename(is-member)
Listez les liens vers tous les utilisateurs dans des pages de 10 éléments :
/api/users/gist?fields=href&absoluteUrls&pageSize=10
Cette section traite de l'envoi et de la lecture des valeurs de données.
/api/dataValueSets
Pour envoyer des valeurs de données, vous pouvez lancer une requête POST à la ressource suivante.
POST /api/dataValueSets
Un cas d'utilisation courant pour l'intégration des systèmes est la nécessité d'envoyer un ensemble de valeurs de données d'un système tiers vers DHIS. Dans cet exemple, nous utiliserons la démonstration DHIS2 sur http://play.dhis2.org/demo. Supposons que nous avons collecté des données basées sur les cas à l'aide d'un simple logiciel client installé sur des téléphones portables pour l'ensemble de données Mortalité <5 ans dans la communauté du Ngelehun CHC (dans la chefferie Badjia, district Bo) pour le mois de janvier 2014. Nous avons maintenant agrégé nos données dans un rapport statistique et nous voulons envoyer ces données à l'instance DHIS2. L'URL de base de l'API de démonstration est http://play.dhis2.org/demo/api. Les liens suivants sont associés à l'URL de base.
La ressource la plus appropriée pour notre objectif d'envoi de valeurs de données est /api/dataValueSets. Un ensemble de valeurs de données représente des données qui ont une relation, généralement parce qu'elles ont été saisies dans le même formulaire. Le format ressemble à ceci :
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0" dataSet="dataSetID"
  completeDate="date" period="period" orgUnit="orgUnitID" attributeOptionCombo="aocID">
  <dataValue dataElement="dataElementID"
    categoryOptionCombo="cocID" value="1" comment="comment1"/>
  <dataValue dataElement="dataElementID"
    categoryOptionCombo="cocID" value="2" comment="comment2"/>
  <dataValue dataElement="dataElementID"
    categoryOptionCombo="cocID" value="3" comment="comment3"/>
</dataValueSet>
JSON est pris en charge dans ce format :
{
  "dataSet": "dataSetID",
  "completeDate": "date",
  "period": "period",
  "orgUnit": "orgUnitID",
  "attributeOptionCombo": "aocID",
  "dataValues": [
    {
      "dataElement": "dataElementID",
      "categoryOptionCombo": "cocID",
      "valeur": "1",
      "commentaire": "comment1"
    },
    {
      "dataElement": "dataElementID",
      "categoryOptionCombo": "cocID",
      "valeur": "2",
      "commentaire": "comment2"
    },
    {
      "dataElement": "dataElementID",
      "categoryOptionCombo": "cocID",
      "valeur": "3",
      "commentaire": "comment3"
    }
  ]
}
CSV est pris en charge dans ce format :
"dataelement","period","orgunit","catoptcombo","attroptcombo","value","strby","lstupd","cmt"
"dataElementID","period","orgUnitID","cocID","aocID","1","username","2015-04-01","comment1"
"dataElementID","period","orgUnitID","cocID","aocID","2","username","2015-04-01","comment2"
"dataElementID","period","orgUnitID","cocID","aocID","3","username","2015-04-01","comment3"
Note
Please refer to the date and period section above for time formats.
Note
Any imported data value which is seen as unchanged will be ignored and the import summary will reflect this. An unchanged data value is classed as one which has the same value for all 3 of these properties: - value - comment - followUp
À partir de l'exemple, nous l'importance d'identifier la période, l'ensemble de données, l'unité d'organisation (établissement) et les éléments de données qui nécessite des rapports.
Pour obtenir l'identifiant de l'ensemble de données, nous adressons une requête à la ressource /api/dataSets. De là, nous trouverons le lien vers l'ensemble de données Mortalité < 5 ans qui nous conduit à /api/dataSets/pBOMPrpg1QX. La ressource de l'ensemble de données Mortalité < 5 ans fournit des liens vers les éléments de données qu'elle abrite. D'ici nous pouvons suivre ces liens et obtenir les identifiants des données éléments. Par souci de concision, nous allons déclarer des données pour seulement trois éléments de données : Rougeole avec l'identifiant f7n9E0hX8qk, Dysenterie avec l'identifiant Ix2HsbDMLea et Choléra avec l'identifiant eY5ehpbEsB7.
Il ne nous reste que l'identifiant de l'organisation unité. L'ensemble de données fournit un lien vers les unités d'organisation qui produisent des rapports dessus. Nous recherchons donc Ngelehun CHC et suivons le lien vers la représentation HTML dans /api/organisationUnits/DiszpKrYNg8, qui nous indique que l'identifiant de cette unité d'organisation est DiszpKrYNg8.
À partir de nos données basées sur les cas, nous supposons que nous avons 12 cas de rougeole, 14 cas de dysenterie et 16 cas de choléra. Nous avons maintenant assez d'informations pour pouvoir composer le message XML de l'ensemble de valeurs des données :
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0" dataSet="pBOMPrpg1QX"
  completeDate="2014-02-03" period="201401" orgUnit="DiszpKrYNg8">
  <dataValue dataElement="f7n9E0hX8qk" value="12"/>
  <dataValue dataElement="Ix2HsbDMLea" value="14"/>
  <dataValue dataElement="eY5ehpbEsB7" value="16"/>
</dataValueSet>
Au format JSON :
{
  "dataSet": "pBOMPrpg1QX",
  "completeDate": "03/02/2014",
  "période": "201401",
  "orgUnit": "DiszpKrYNg8",
  "dataValues": [
    {
      "dataElement": "f7n9E0hX8qk",
      "valeur": "1"
    },
    {
      "dataElement": "Ix2HsbDMLea",
      "valeur": "2"
    },
    {
      "dataElement": "eY5ehpbEsB7",
      "valeur": "3"
    }
  ]
}
Pour effectuer des tests fonctionnels, nous utiliserons l'outil curl qui permet de transférer facilement des données à l'aide du protocole HTTP. Tout d'abord, nous sauvegardons le contenu XML de l'ensemble de données dans un fichier appelé datavalueset.xml. Dans le répertoire où se trouve ce fichier, nous invoquons ce qui suit à partir de la ligne de commande :
curl -d @datavalueset.xml "https://play.dhis2.org/demo/api/dataValueSets"
  -H "Content-Type:application/xml" -u admin:district
Pour envoyer du contenu JSON, vous devez définir l'en-tête "type de contenu" comme suit :
curl -d @datavalueset.json "https://play.dhis2.org/demo/api/dataValueSets"
  -H "Content-Type:application/json" -u admin:district
La commande enverra une requête à l'API Web de démonstration, définissez application/xml comme type de contenu et authentifiez-vous en utilisant admin/district comme nom d'utilisateur/mot de passe. Si tout se passe bien, le code d'état HTTP 200 OK sera renvoyé. Vous pouvez vérifier la réception des données en ouvrant le module de saisie de données dans DHIS2 et en sélectionnant l'unité d'organisation, l'ensemble de données et la période utilisés dans cet exemple.
L'API suit la sémantique normale pour la gestion des erreurs et les codes d'état HTTP. Si vous fournissez un nom d'utilisateur ou un mot de passe invalide, 401 Non autorisé est renvoyé. Si vous fournissez un type de contenu autre que application/xml, 415 Type de média non pris en charge est renvoyé. Si le contenu XML n'est pas valide selon l'espace de noms DXF, 400 Mauvaise requête est renvoyé. Si vous fournissez un identifiant invalide dans le contenu XML, 409 Conflit est renvoyé avec un message descriptif.
L'exemple précédent nous a montré comment envoyer un ensemble de données associées qui partagent la même période et la même unité d’organisation. L'exemple suivant nous montrera comment envoyer de grandes quantités de données qui ne sont pas nécessairement associés.
Encore une fois, nous interagirons avec la ressource /api/dataValueSets. Cette fois nous n'allons pas spécifier les attributs dataSet et completeDate. De plus, nous allons spécifiez les attributs period et orgUnit comme éléments de données individuelles et non élément d’ensemble de données externes. Cela nous permettra d'envoyer des données pour différentes périodes et unités d'organisation :
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0">
  <dataValue dataElement="f7n9E0hX8qk"
    period="201401" orgUnit="DiszpKrYNg8" value="12"/>
  <dataValue dataElement="f7n9E0hX8qk"
    period="201401" orgUnit="FNnj3jKGS7i" value="14"/>
  <dataValue dataElement="f7n9E0hX8qk"
    period="201402" orgUnit="DiszpKrYNg8" value="16"/>
  <dataValue dataElement="f7n9E0hX8qk"
    period="201402" orgUnit="Jkhdsf8sdf4" value="18"/>
</dataValueSet>
Au format JSON :
{
  "dataValues": [
    {
      "dataElement": "f7n9E0hX8qk",
      "période": "201401",
      "orgUnit": "DiszpKrYNg8",
      "valeur": "12"
    },
    {
      "dataElement": "f7n9E0hX8qk",
      "période": "201401",
      "orgUnit": "FNnj3jKGS7i",
      "valeur": "14"
    },
    {
      "dataElement": "f7n9E0hX8qk",
      "période": "201402",
      "orgUnit": "DiszpKrYNg8",
      "valeur": "16"
    },
    {
      "dataElement": "f7n9E0hX8qk",
      "période": "201402",
      "orgUnit": "Jkhdsf8sdf4",
      "valeur": "18"
    }
  ]
}
Au format CSV :
"dataelement","period","orgunit","categoryoptioncombo","attributeoptioncombo","value"
"f7n9E0hX8qk","201401","DiszpKrYNg8","bRowv6yZOF2","bRowv6yZOF2","1"
"Ix2HsbDMLea","201401","DiszpKrYNg8","bRowv6yZOF2","bRowv6yZOF2","2"
"eY5ehpbEsB7","201401","DiszpKrYNg8","bRowv6yZOF2","bRowv6yZOF2","3"
Nous effectuons les tests en utilisant "curl" pour envoyer les données au format XML :
curl -d @datavalueset.xml "https://play.dhis2.org/demo/api/dataValueSets"
  -H "Content-Type:application/xml" -u admin:district
Notez que lorsque vous utilisez le format CSV, vous devez utiliser l'option de données binaires pour conserver le retour-à-la-ligne dans le fichier CSV :
curl --data-binary @datavalueset.csv "https://play.dhis2.org/demo/24/api/dataValueSets"
  -H "Content-Type:application/csv" -u admin:district
La ressource ensemble de valeurs de données fournit une réponse XML qui est utile lorsque vous voulez vérifier l'impact de votre requête. La première fois que nous envoyons la requête " ensemble de données " ci-dessus, le serveur répondra avec le résumé d'importation suivant :
<importSummary>
  <dataValueCount imported="2" updated="1" ignored="1"/>
  <dataSetComplete>faux</dataSetComplete>
</importSummary>
Ce message nous indique que 3 données ont été importées, 1 donnée a été mise à jour et 0 donnée a été ignorée. La seule mise à jour résulte de l'envoi de cette donnée dans l'exemple précédent. Une donnée sera ignorée si elle fait référence à un élément de données, une période, une unité d'organisation ou un ensemble de données qui n'existent pas. Dans notre cas, cette valeur unique ignorée est due au fait que la dernière donnée faisait référence à une unité d'organisation non valide. L'élément complet de l'ensemble de données affichera la date à laquelle l'ensemble de données a été achevé, ou " faux " si aucun attribut d'élément de données n'a été fourni.
The import process can be customized using a set of import parameters.
Tableau : Paramètres d'importation
| Paramètre | Valeurs (par défaut en premier) | Description |
|---|---|---|
| dataElementIdScheme | uide | nom | code | attribut:ID | Propriété de l'objet d'élément de données à utiliser pour mapper les données. |
| orgUnitIdScheme | uide | nom | code | attribut:ID | Propriété de l'objet d'unité d'organisation à utiliser pour mapper les données. |
| attributOptionComboIdScheme (Schéma de l'identifiant de la combinaison d'options d'attribut) | uide | nom | code| attribut:ID | Propriété de l'objet de combinaison d'options d'attribut à utiliser pour faire correspondre les données. |
| categoryOptionComboIdScheme | uide | nom | code | attribut:ID | Propriété de l'objet de combinaison d'options de catégorie à utiliser pour faire correspondre les données. |
| dataSetIdScheme (Schéma de l'identifiant de l'ensemble de données) | uide | nom | code| attribut:ID | Propriété de l'objet d'ensemble de données à utiliser pour faire correspondre les données. |
| categoryIdScheme (Schéma de l'identifiant de catégorie) | uide | nom | code| attribut:ID | Propriété de l'objet de catégorie à utiliser pour faire correspondre les données (ADX uniquement). |
| categoryOptionIdScheme (Schéma d'identification des options de catégorie) | uide | nom | code| attribut:ID | Propriété de l'objet d'option catégorie à utiliser pour faire correspondre les données (ADX uniquement). |
| idScheme | uide | nom | code| attribut:ID | Propriété de l'un des objets ci-dessus, s'ils ne sont pas spécifiés, à utiliser pour faire correspondre les données. |
| preheatCache | false | true |
| dryRun | false | true |
| importStrategy (stratégie d'importation) | CREATE (créer) | UPDATE (mettre à jour) |
| skipExistingCheck (ignorer les contrôles) | false | true |
| skipAudit (ignorer l'audit) | false | true |
| async | false | true |
| force | false | true |
| dataSet (ensemble de données) | uid | Fournissez l'ID de l'ensemble de données pour l'importation CSV lorsque l'ID ne peut pas être fourni dans le fichier lui-même |
Tous les paramètres sont facultatifs et peuvent être fournis en tant que paramètres de requête dans l'URL de la requête comme suit :
/api/dataValueSets?dataElementIdScheme=code&orgUnitIdScheme=name
  &dryRun=true&importStrategy=CREER
Ils peuvent également être fournis en tant qu'attributs XML sur l'élément " ensemble de valeurs de données ", tel qu'indiqué ci-dessous. Les attributs XML remplacent les paramètres de la chaîne de requête.
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0" dataElementIdScheme="code"
  orgUnitIdScheme="name" dryRun="true" importStrategy="CREATE">
</dataValueSet>
Notez que le paramètre preheatCache peut avoir un impact considérable sur les performances. Pour les petits fichiers d'importation, maintenir "faux" permettra de gagner en rapidité. Pour les gros fichiers d'importation qui contiennent un grand nombre d'éléments de données et d'unités d'organisation distincts, le définir sur "vrai" permettra de gagner en rapidité en termes d'ordre de grandeur.
L’importation de valeurs de données prend en charge un ensemble de types de valeurs. Chaque type de valeur a une exigence particulière. Le tableau suivant répertorie les cas extrêmes pour les types valeur.
Tableau : Exigences relatives au type de valeur
| Type de valeur | Conditions requises | Commentaire |
|---|---|---|
| BOOLEAN | vrai | C'est vrai | VRAI | faux | Faux | FAUX | 1 | 0 | t | f | | Utilisé lorsque la valeur est booléenne, vraie ou fausse. Le service d'importation ne prête pas attention au fait que l'entrée commence par une lettre majuscule ou minuscule, ou qu'elle soit entièrement en lettres majuscules. |
En ce qui concerne les schémas d'identification, les identifiants utilisés dans les messages XML utilisent par défaut les identifiants d'objets stables de DHIS2 appelés UID. Dans certaines situations d'interopérabilité, il se peut qu'un système externe détermine les identifiants des objets. Dans ce cas, nous pouvons utiliser la propriété code des unités d'organisation et d'autres objets pour définir des identifiants fixes. Lors de l'importation des valeurs de données, nous devons donc référencer la propriété "code" et non la propriété "identifiant" de ces objets de métadonnées. Les schémas d'identification peuvent être spécifiés dans le message XML ainsi que dans la requête en tant que paramètres de requête. Pour les spécifier dans la charge utile XML, vous pouvez procéder comme suit :
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0"
  dataElementIdScheme="CODE" orgUnitIdScheme="UID" idScheme="CODE">
</dataValueSet>
Le tableau des paramètres ci-dessus explique comment les schémas d'identification peuvent être spécifiés comme paramètres de requête. Les règles suivantes déterminent l'ordre de priorité :
Les schémas d'identification définis dans la charge utile XML ou JSON ont priorité sur les schémas d'identification définis comme paramètres de requête URL.
Les schémas d'identification spécifiques tels que dataElementIdScheme ou orgUnitIdScheme ont priorité sur le schéma d'identification général.
Si aucun schéma d'identification explicite n'est défini, le schéma d'identification par défaut est code pour le format ADX et uid pour tous les autres formats.
Les schémas d'identification suivants sont disponibles.
uid
code
name
attribut (suivi de l'UID de l'attribut)
L'option d'attribut est spéciale et fait référence aux attributs de métadonnées qui ont été marqués comme uniques. En utilisant cette option, l'attribut doit être immédiatement suivi de l'identifiant de l'attribut, par exemple "attribut : DnrLSdo4hMl".
Les valeurs de données peuvent être envoyées et importées de manière asynchrone à travers un paramètre de requête async défini sur vrai :
/api/dataValueSets?async=vrai
Cela lancera une tâche d'importation asynchrone dont vous pourrez surveiller l'état grâce à l'API de résumés des tâches. La réponse de l'API indique l'identifiant unique de la tâche, du type de tâche et de l'URL que vous pouvez utiliser pour surveiller l’état de l'importation. La réponse ressemblera à ceci :
{
  "httpStatus": "OK",
  "httpStatusCode": 200,
  "status": "OK",
  "message": "Initiated dataValueImport",
  "response": {
    "name": "dataValueImport",
    "id": "YR1UxOUXmzT",
    "created": "2018-08-20T14:17:28.429",
    "jobType": "DATAVALUE_IMPORT",
    "relativeNotifierEndpoint": "/api/system/tasks/DATAVALUE_IMPORT/YR1UxOUXmzT"
  }
}
Veuillez lire la section sur l'état des tâches asynchrones pour en savoir plus.
La section suivante décrit le format CSV utilisé dans DHIS2. La première ligne est supposée être une ligne d'en-tête et sera ignorée lors de l'importation.
Tableau : format CSV de DHIS2
| Colonne | Obligatoire | Description |
| Élément de données | Oui | Fait référence à l'ID par défaut, peut également être un nom et un code basés sur le schéma d'identification sélectionné |
| Période | Oui | Au format ISO |
| Unité d'organisation | Oui | Fait référence à l'ID par défaut, peut également être un nom et un code basés sur le schéma d'identification sélectionné |
| Combinaison d'options de catégorie | Non | Fait référence à l'ID |
| Combinaison d'options d'attribut | Non | Fait référence à l'ID (à partir de la version 2.16) |
| Valeur | Non | Valeur de données |
| Stocké par | Non | Fait référence au nom d'utilisateur de l'utilisateur qui a saisi la valeur |
| Dernière mise à jour | Non | Date au format ISO |
| Commentaire | Non | Commentaire en texte libre |
| Suivi | Non | vrai ou faux |
Ci-dessous un exemple de fichier CSV pouvant être importé dans DHIS2 :
"dataelement","period","orgunit","catoptcombo","attroptcombo","value","storedby","timestamp"
"DUSpd8Jq3M7","201202","gP6hn503KUX","Prlt0C1RF0s",,"7","bombali","2010-04-17"
"DUSpd8Jq3M7","201202","gP6hn503KUX","V6L425pT3A0",,"10","bombali","2010-04-17"
"DUSpd8Jq3M7","201202","OjTS752GbZE","V6L425pT3A0",,"9","bombali","2010-04-06"
Pour générer un modèle d'ensemble de valeurs de données pour un ensemble de données spécifique, vous pouvez utiliser la ressource /api/dataSets/<id>/dataValueSet. les formats de réponse XML et JSON sont pris en charge. Exemple:
/api/dataSets/BfMAe6Itzgt/dataValueSet
Ci-dessous les paramètres que vous pouvez utiliser pour ajuster davantage la sortie :
Tableau : Paramètres de requête de valeurs de données
| Paramètre de requête | Obligatoire | Description |
|---|---|---|
| period | Non | La période d'utilisation ; elle sera incluse sans aucun contrôle. |
| orgUnit | Non | L'unité d'organisation à utiliser ; prend en charge plusieurs unités d'organisation ; l'identifiant et le code peuvent être utilisés. |
| commentaire | Non | Sur la prise en compte des commentaires, par défaut : Oui. |
| orgUnitIdScheme | Non | Schéma d'unité d'organisation à utiliser ; prend en charge l'identifiant | code. |
| dataElementIdScheme | Non | Schéma d'élément de données à utiliser ; prend en charge l'identifiant | code. |
Pour lire les valeurs de données, vous pouvez effectuer une requête GET à la ressource suivante.
GET /api/dataValueSets
Data values can be retrieved in XML, JSON, CSV, and ADX format. Since we want to read data we will use the GET HTTP verb. We will also specify that we are interested in the XML resource representation by including an Accept HTTP header with our request. The following query parameters are available.
Tableau : Paramètres de requête d'ensemble de valeurs de données
| Paramètre | Description |
|---|---|
| dataSet (ensemble de données) | Identifiant de l'ensemble de données. Peut être répété plusieurs fois. |
| dataElementGroup (groupe d'éléments de données) | Identifiant du groupe d'éléments de données. Peut être répété autant de fois que vous le voulez (pas pris en charge pour le format ADX). |
| dataElement | Identifiant de l'élément de données. Peut être répété plusieurs fois. |
| period | Identifiant de période au format ISO. Peut être répété plusieurs fois. |
| startDate | Date de début pour la période des valeurs à exporter. |
| endDate | Date de fin pour la période des valeurs à exporter. |
| orgUnit | Identifiant de l’unité d’organisation. Peut être répété plusieurs fois. |
| subordonnées | Whether to include the children in the hierarchy of the organisation units. Boolean value (default false) |
| orgUnitGroup (groupe d'unités d'organisation) | Identifiant du groupe d’unités d’organisation. Peut être répété plusieurs fois. |
| attributeOptionCombo (combinaison d'options d'attribut) | Identifiant de la combinaison d’options d’attribut. Peut être répété plusieurs fois. |
| includeDeleted | Permet de spécifier s'il faut inclure les valeurs de données supprimées. |
| lastUpdated (dernière mise à jour) | Inclut uniquement les valeurs de données mises à jour depuis l'horodatage donné. |
| lastUpdatedDuration | Inclut uniquement les valeurs de données mises à jour pendant la durée spécifique. Le format est <value><time-unit>, où les unités de temps prises en charge sont "j" (jours), "h" (heures), "m" (minutes) et "s" (secondes). |
| limite | Le nombre maximum de résultats dans la réponse. |
| dataElementIdScheme | Propriété de l'objet d'élément de données à utiliser pour les valeurs de données dans la réponse. |
| orgUnitIdScheme | Propriété de l'objet d'unité d'organisation à utiliser pour les valeurs de données dans la réponse. |
| categoryOptionComboIdScheme | Propriété de la combinaison d'options de catégorie à utiliser pour les valeurs de données dans la réponse. |
| attributOptionComboIdScheme (Schéma de l'identifiant de la combinaison d'options d'attribut) | Propriété des objets de combinaison d'options d'attribut à utiliser pour les valeurs de données dans la réponse. |
| dataSetIdScheme (Schéma de l'identifiant de l'ensemble de données) | Propriété de l'objet d'ensemble de données à utiliser dans la réponse. |
| categoryIdScheme (Schéma de l'identifiant de catégorie) | Propriété de l'objet catégorie à utiliser dans la réponse (ADX uniquement). |
| categoryOptionIdScheme (Schéma d'identification des options de catégorie) | Propriété de l'objet d'options de catégorie à utiliser dans la réponse (ADX uniquement). |
| idScheme | Propriété de l'un des objets ci-dessus, s'ils ne sont pas spécifiés, à utiliser dans la réponse. S’il n’est pas spécifié, l’idScheme par défaut pour le format ADX est "code" et pour tous les autres formats, c'est "uid". |
| inputOrgUnitIdScheme | Identifier property used for the provided orgUnit parameter values; id or code |
| inputDataSetIdScheme | Identifier property used for the provided dataSet parameter values; id or code |
| inputDataElementGroupIdScheme | Identifier property used for the provided dataElementGroup parameter values; id or code |
| inputDataElementIdScheme | Identifier property used for the provided dataElement parameter values; id or code |
| inputIdScheme | General identifier property used for all object types, specific identifier schemes will override the general scheme; id or code |
| compression | Whether to compress the response payload; none, gzip or zip |
| attachment | File name to use for the response, a non-blank value indicates rendering the response as an attachment. |
Les paramètres suivants provenant de la liste ci-dessus sont requis : - dataSet ou dataElementGroup (pour le format ADX, cela doit être dataSet) - period, (startDate et endDate), lastUpdated, ou lastUpdatedDuration - orgUnit ou orgUnitGroup
Les formats de réponse suivants sont pris en charge :
xml (application/xml)
json (application/json)
csv (application/csv)
adx (application/adx+xml)
En supposant que nous avons publié les valeurs de données dans DHIS2 conformément à la section précédente intitulée Envoi de valeurs de données, nous pouvons maintenant constituer notre requête pour un ensemble de valeurs de données unique et l'exécuter en utilisant cURL :
curl "https://play.dhis2.org/demo/api/dataValueSets?dataSet=pBOMPrpg1QX&period=201401&orgUnit=DiszpKrYNg8"
  -H "Accept:application/xml" -u admin:district
Nous pouvons également utiliser les paramètres de requête "date de début" et "date de fin" pour demander un plus grand nombre de valeurs de données. En d'autres termes, vous pouvez également solliciter des valeurs de données pour plusieurs ensembles de données, unités d'organisation et périodes afin d'exporter de plus grandes quantités de données. Notez que le paramètre de requête "période" est prioritaire sur les paramètres "date de début" et "date de fin". Voici un exemple :
curl "https://play.dhis2.org/demo/api/dataValueSets?dataSet=pBOMPrpg1QX&dataSet=BfMAe6Itzgt
  &startDate=2013-01-01&endDate=2013-01-31&orgUnit=YuQRtpLP10I&orgUnit=vWbkYPRmKyS&children=true"
  -H "Accept:application/xml" -u admin:district
Pour récupérer les valeurs de données qui ont été créées ou mises à jour au cours des 10 derniers jours, vous pouvez effectuer la requête suivante :
/api/dataValueSets?dataSet=pBOMPrpg1QX&orgUnit=DiszpKrYNg8&lastUpdatedDuration=10d
La réponse ressemblera à ceci :
<?xml version='1.0' encoding='UTF-8'?>
<dataValueSet xmlns="http://dhis2.org/schema/dxf/2.0" dataSet="pBOMPrpg1QX"
  completeDate="2014-01-02" period="201401" orgUnit="DiszpKrYNg8">
<dataValue dataElement="eY5ehpbEsB7" period="201401" orgUnit="DiszpKrYNg8"
  categoryOptionCombo="bRowv6yZOF2" value="10003"/>
<dataValue dataElement="Ix2HsbDMLea" period="201401" orgUnit="DiszpKrYNg8"
  categoryOptionCombo="bRowv6yZOF2" value="10002"/>
<dataValue dataElement="f7n9E0hX8qk" period="201401" orgUnit="DiszpKrYNg8"
  categoryOptionCombo="bRowv6yZOF2" value="10001"/>
</dataValueSet>
Vous pouvez demander à ce que les données soient rendues au format JSON de la manière suivante :
/api/dataValueSets.json?dataSet=pBOMPrpg1QX&period=201401&orgUnit=DiszpKrYNg8
La réponse ressemblera à ceci :
{
  "dataSet": "pBOMPrpg1QX",
  "completeDate": "2014-02-03",
  "period": "201401",
  "orgUnit": "DiszpKrYNg8",
  "dataValues": [
    {
      "dataElement": "eY5ehpbEsB7",
      "categoryOptionCombo": "bRowv6yZOF2",
      "period": "201401",
      "orgUnit": "DiszpKrYNg8",
      "value": "10003"
    },
    {
      "dataElement": "Ix2HsbDMLea",
      "categoryOptionCombo": "bRowv6yZOF2",
      "period": "201401",
      "orgUnit": "DiszpKrYNg8",
      "value": "10002"
    },
    {
      "dataElement": "f7n9E0hX8qk",
      "categoryOptionCombo": "bRowv6yZOF2",
      "period": "201401",
      "orgUnit": "DiszpKrYNg8",
      "value": "10001"
    }
  ]
}
Notez que les valeurs de données sont supprimées de manière réversive (soft delete), c'est-à-dire qu'une valeur supprimée a la propriété deleted définie sur "true" et n'est pas supprimée de façon permanente. Ceci est utile lors de l'intégration de plusieurs systèmes afin de signaler les suppressions. Vous pouvez inclure les valeurs supprimées dans la réponse comme suit :
/api/dataValueSets.json?dataSet=pBOMPrpg1QX&period=201401
  &orgUnit=DiszpKrYNg8&includeDeleted=true
Vous pouvez également demander à ce que les données soient rendues au format CSV de la manière suivante :
/api/dataValueSets.csv?dataSet=pBOMPrpg1QX&period=201401&orgUnit=DiszpKrYNg8
La réponse ressemblera à ceci :
dataelement,period,orgunit,catoptcombo,attroptcombo,value,storedby,lastupdated,comment,flwup
f7n9E0hX8qk,201401,DiszpKrYNg8,bRowv6yZOF2,bRowv6yZOF2,12,system,2015-04-05T19:58:12.000,comment1,false
Ix2HsbDMLea,201401,DiszpKrYNg8,bRowv6yZOF2,bRowv6yZOF2,14,system,2015-04-05T19:58:12.000,comment2,false
eY5ehpbEsB7,201401,DiszpKrYNg8,bRowv6yZOF2,bRowv6yZOF2,16,system,2015-04-05T19:58:12.000,comment3,false
FTRrcoaog83,201401,DiszpKrYNg8,bRowv6yZOF2,bRowv6yZOF2,12,system,2014-03-02T21:45:05.519,comment4,false
Request data values in CSV format compressed with gzip:
/api/dataValueSets.csv?dataSet=pBOMPrpg1QX&period=202401&orgUnit=DiszpKrYNg8&compression=gzip
The response will be in compressed CSV format. The content can be uncompressed with the gunzip tool.
Les contraintes suivantes s'appliquent à la ressource Ensembles de valeurs de données :
Au moins un ensemble de données doit être spécifié.
Soit au moins une période, soit une date de début et une date de fin doivent être spécifié.
Au moins une unité d'organisation doit être spécifiée.
Les unités d'organisation doivent faire partie de la hiérarchie des unités d'organisation de l’utilisateur authentifié.
La limite ne peut pas être inférieure à zéro.
Cet exemple montrera comment envoyer des valeurs de données individuelles à enregistrer dans une requête. Ceci peut être réalisé par l'envoi d'une requête POST à la ressource dataValues :
POST /api/dataValues
Les paramètres de requête suivants sont pris en charge pour cette ressource :
Tableau : Paramètres de requête de valeurs de données
| Paramètre de requête | Obligatoire | Description |
|---|---|---|
| de | Oui | Identifiant de l'élément de données |
| pe | Oui | Identifiant de période |
| ou | Oui | Identifiant de l'unité d'organisation |
| co | Non | Identifiant de la combinaison d'options de catégorie, la valeur par défaut sera utilisée en cas d'omission |
| cc | Non (doit être combiné avec cp) | Identifiant de la combinaison de catégories d'attribut |
| cp | Non (doit être combiné avec cc) | Identifiants d'options de catégories d'attribut, séparés par ; pour plusieurs valeurs |
| ds | Non | Ensemble de données permettant de vérifier si la fonction POST or DELETE (publier ou supprimer) est autorisée pour la période et l'unité d'organisation. S'il est spécifié, l'élément de données doit être affecté à cet ensemble de données. Dans le cas contraire, un ensemble de données contenant l'élément de données sera sélectionné pour vérifier si l'opération est autorisée. |
| value | Non | Valeur de données. Pour les valeurs booléennes, les éléments suivants seront acceptés : vrai | Vrai | VRAI | faux | Faux | FAUX | 1 | 0 | t | f | |
| commentaire | Non | Commentaire sur les données |
| followUp | Non | Le suivi de la valeur de données permet de faire basculer la valeur booléenne actuelle |
Si l'un des identifiants fournis n'est pas valide, si la valeur de données ou le commentaire n'est pas valide ou si les données sont verrouillées, la réponse contiendra le code d'état 409 Conflict et un message texte descriptif. Si l'opération conduit à une valeur enregistrée ou mise à jour, 200 OK sera renvoyé. Ci-après, un exemple de requête :
curl "https://play.dhis2.org/demo/api/dataValues?de=s46m5MS0hxu
  &pe=201301&ou=DiszpKrYNg8&co=Prlt0C1RF0s&value=12"
  -X POST -u admin:district
Cette ressource permet également une syntaxe spéciale pour associer la valeur à une combinaison d'options d'attribut. Pour ce faire, il suffit d'envoyer l'identifiant de la combinaison de catégories d'attribut, ainsi que les identifiants des options de catégories d'attribut que la valeur représente au sein de la combinaison. La combinaison de catégories est spécifiée avec le paramètre cc, tandis que les options de catégorie sont spécifiées sous la forme d'une chaîne de caractères séparés par des points-virgules avec le paramètre cp. Il faut s'assurer que les options de catégorie font toutes partie de la combinaison de catégories. Voici un exemple :
curl "https://play.dhis2.org/demo/api/dataValues?de=s46m5MS0hxu&ou=DiszpKrYNg8
  &pe=201308&cc=dzjKKQq0cSO&cp=wbrDrL2aYEc;btOyqprQ9e8&value=26"
  -X POST -u admin:district
Vous pouvez récupérer une valeur de données avec une requête en utilisant la méthode GET. Les paramètres de valeur, de commentaire et de suivi ne sont pas applicables ici :
curl "https://play.dhis2.org/demo/api/dataValues?de=s46m5MS0hxu
  &pe=201301&ou=DiszpKrYNg8&co=Prlt0C1RF0s"
  -u admin:district
Vous pouvez supprimer une valeur de données avec une requête en utilisant la méthode DELETE.
Vous pouvez envoyer des valeurs de données individuelles sous forme de charge utile JSON en utilisant la ressource suivante avec Content-Type : application/json.
POST /api/dataValues
La ressource créera une nouvelle valeur de données ou mettra à jour une valeur de données si elle existe déjà. Le format de charge utile JSON est défini ci-dessous.
{
  "dataElement": "fbfJHSPpUQD",
  "categoryOptionCombo": "PT59n8BQbqM",
  "period": "202201",
  "orgUnit": "DiszpKrYNg8",
  "value": "10",
  "comment": "OK"
}
Le point d'extrémité prend en charge la spécification de combinaisons d’options d’attribut dans une structure imbriquée.
{
  "dataElement": "BOSZApCrBni",
  "categoryOptionCombo": "TkDhg29x18A",
  "attribute": {
    "combo": "O4VaNks6tta",
    "options": [
      "C6nZpLKjEJr", "i4Nbp8S2G6A"
    ]
  },
  "dataSet": "lyLU2wR22tC",
  "period": "202201",
  "orgUnit": "DiszpKrYNg8",
  "value": "15",
  "comment": "Good"
}
Le code d'état sera 201 Créé si la valeur de données a été enregistrée ou mise à jour avec succès, ou 409 Conflit en cas d'erreur de validation.
Lorsqu'il s'agit de valeurs de données dont l'élément de données est de type fichier, la méthode décrite ci-dessus ne s'applique plus. Ces valeurs de données sont spéciales dans la mesure où le contenu de la valeur est une référence UID à un objet FileResource et non une constante autonome. Ces valeurs de données se comportent comme les autres valeurs de données qui stockent du contenu textuel, mais elles doivent être traitées différemment afin de produire des entrées et des sorties pertinentes.
Il existe deux méthodes pour stocker les valeurs de données des ressources de fichiers.
Téléchargez le fichier sur le point d'extrémité /api/dataValues/file tel que décrit dans la section des ressources de fichiers. Cela fonctionne avec les versions 2.36 et supérieures.
Si vous écrivez un code qui doit être compatible avec les versions DHIS2 inférieures à la 2.36, alors le processus est le suivant :
Télécharger le fichier sur le endpoint /api/fileResources tel que décrit dans la section des ressources de fichiers.
Récupérez la propriété id de la ressource de fichier renvoyée.
Stockez l'identifiant récupéré avec la propriété valeur de la valeur de données et en utilisant l'une des méthodes décrites ci-dessus.
Seules les relations un à un entre les valeurs de données et les ressources de fichiers sont autorisées. Cette règle est appliquée en interne, de sorte que l'enregistrement de l'identifiant d'une ressource de fichier dans plusieurs valeurs de données ne soit pas possible et entraîne une erreur. La suppression de la valeur de données entraîne la suppression de la ressource de fichier référencée. La suppression directe des ressources de fichiers n'est pas possible.
La valeur de données peut maintenant être récupérée normalement, mais c'est l'UID de la ressource du fichier qui sera renvoyé. Afin de récupérer le vrai contenu (c'est-à-dire le fichier stocké dans la ressource associée à la valeur de données), vous devez effectuer une requête GET à /api/dataValues/files en reproduisant les paramètres de la requête comme pour la valeur de données elle-même. Le endpoint /api/dataValues/files ne prend en charge que les requêtes GET.
Il convient de noter qu'en raison du fonctionnement asynchrone du mécanisme de stockage sous-jacent, le contenu du fichier peut ne pas être immédiatement téléchargeable à partir du endpoint /api/dataValues/files. Ceci est particulièrement valable pour les fichiers volumineux qui peuvent nécessiter des téléchargements en arrière-plan vers un entrepôt de fichiers externe (en fonction de la configuration du système). Récupérer les métadonnées de la ressource du fichier à partir du endpoint /api/fileResources/<id> permet de vérifier le storageStatus (état du stockage) du contenu avant d'essayer de le télécharger.
Depuis la version 2.20, nous prenons en charge une norme internationale d'échange de données agrégées appelée ADX. ADX est développé et maintenu par le comité Quality, Research and Public Health (Qualité, Recherche et Santé Publique) de l'IHE (Integrating the HealthCare Enterprise). La page wiki décrivant les activités du comité QRPH se trouve à l'adresse wiki.ihe.net. ADX fait toujours l'objet d'un développement actif et a maintenant été publié pour une implémentation à titre expérimental. Notez qu'actuellement, c'est la fonctionnalité de lecture et d'écriture des données formatées ADX qui est implémentée dans DHIS2, c'est-à-dire ce qui est décrit comme acteurs Consommateur de Contenu et Producteur de Contenu dans le profil ADX.
La structure d'un message de données ADX est assez similaire à celle des données DXF 2 décrites précédemment et que vous connaissez probablement. Il existe quelques différences importantes. Nous les décrirons à l'aide d'un petit exemple :
<adx xmlns="urn:ihe:qrph:adx:2015" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
  xsi:schemaLocation="urn:ihe:qrph:adx:2015 ../schema/adx_loose.xsd"
  exported="2015-02-08T19:30:00Z">
  <group orgUnit="OU_559" period="2015-06-01/P1M"
    completeDate="2015-07-01" dataSet="(TB/HIV)VCCT">
    <dataValue dataElement="VCCT_0" GENDER="FMLE" HIV_AGE="AGE0-14" value="32"/>
    <dataValue dataElement="VCCT_1" GENDER="FMLE" HIV_AGE="AGE0-14" value="20"/>
    <dataValue dataElement="VCCT_2" GENDER="FMLE" HIV_AGE="AGE0-14" value="10"/>
    <dataValue dataElement="PLHIV_TB_0" GENDER="FMLE" HIV_AGE="AGE0-14" value="10"/>
    <dataValue dataElement="PLHIV_TB_1" GENDER="FMLE" HIV_AGE="AGE0-14" value="10"/>

    <dataValue dataElement="VCCT_0" GENDER="MLE" HIV_AGE="AGE0-14" value="32"/>
    <dataValue dataElement="VCCT_1" GENDER="MLE" HIV_AGE="AGE0-14" value="20"/>
    <dataValue dataElement="VCCT_2" GENDER="MLE" HIV_AGE="AGE0-14" value="10"/>
    <dataValue dataElement="PLHIV_TB_0" GENDER="MLE" HIV_AGE="AGE0-14" value="10"/>
    <dataValue dataElement="PLHIV_TB_1" GENDER="MLE" HIV_AGE="AGE0-14" value="10"/>

    <dataValue dataElement="VCCT_0" GENDER="FMLE" HIV_AGE="AGE15-24" value="32"/>
    <dataValue dataElement="VCCT_1" GENDER="FMLE" HIV_AGE="AGE15-24" value="20"/>
    <dataValue dataElement="VCCT_2" GENDER="FMLE" HIV_AGE="AGE15-24" value="10"/>
    <dataValue dataElement="PLHIV_TB_0" GENDER="FMLE" HIV_AGE="AGE15-24" value="10"/>
    <dataValue dataElement="PLHIV_TB_1" GENDER="FMLE" HIV_AGE="AGE15-24" value="10"/>

    <dataValue dataElement="VCCT_0" GENDER="MLE" HIV_AGE="AGE15-24" value="32"/>
    <dataValue dataElement="VCCT_1" GENDER="MLE" HIV_AGE="AGE15-24" value="20"/>
    <dataValue dataElement="VCCT_2" GENDER="MLE" HIV_AGE="AGE15-24" value="10"/>
    <dataValue dataElement="PLHIV_TB_0" GENDER="MLE" HIV_AGE="AGE15-24" value="10"/>
    <dataValue dataElement="PLHIV_TB_1" GENDER="MLE" HIV_AGE="AGE15-24" value="10"/>
  </group>
</adx>
L'élément racine ADX n'a qu'un seul attribut obligatoire, qui est l'horodatage exporté. Comme d'autres éléments ADX, le schéma est extensible dans le sens où il ne restreint pas les attributs spécifiques d'applications supplémentaires.
Contrairement à dxf2, ADX exige que les valeurs de données soient regroupées par unité d'organisation, période et ensemble de données. L'exemple ci-dessus montre un rapport de données pour l'ensemble de données "( TB/VIH) VCCT" de la base de données de démonstration en ligne. Cet exemple utilise des codes comme identifiants et non des uids dhis2. Le code est la forme d'identifiant recommandée lors de l'utilisation d'ADX.
Les attributs d'unité d'organisation, de période et d'ensemble de données sont obligatoires dans ADX. L'élément de groupe peut contenir des attributs supplémentaires. Dans notre implémentation de DHIS2, tout attribut supplémentaire est simplement transmis à l'importateur sous-jacent. Cela signifie que tous les attributs qui ont actuellement une signification dans dxf2 (comme completeDate dans l'exemple ci-dessus) peuvent continuer à être utilisés dans ADX et seront traités de la même manière.
Une différence importante entre ADX et dxf2 réside dans la manière dont les périodes sont encodées. ADX utilise strictement la norme ISO8601 et encode la période de déclaration sous la forme (date|heure) / (durée). Dans l'exemple ci-dessus, la période est donc une période d'un mois (P1M) qui commence le 01-06-2015. Il s'agit donc des données de juin 2015. La notation est un peu plus longue, mais elle est très souple et nous permet de prendre en charge tous les types de période existants dans DHIS2.
Les périodes commencent par la date à laquelle la durée commence, suivie d'un "/" et de la notation de la durée, comme indiqué dans le tableau. Le tableau suivant détaille tous les types de période dans DHIS2 et la manière dont ils sont représentés en ADX, ainsi que des exemples.
Tableau : Périodes ADX
| Type de période | Notation de durée | Exemple(s) | Durée(s) |
|---|---|---|---|
| Quotidien | P1D | 01-10-2017/P1M | 01 octobre 2017 |
| Hebdomadaire | P7D | 02-10-2017/P7D | 02 octobre 2017-08 octobre 2017 |
| Hebdomadaire Mercredi | P7D | 04-10-2017/P7D | 04 octobre 2017-10 octobre 2017 |
| Hebdomadaire Jeudi | P7D | 05-10-2017/P7D | 05 octobre 2017-11 octobre 2017 |
| Hebdomadaire Samedi | P7D | 07-10-2017/P7D | 07 octobre 2017-13 octobre 2017 |
| Hebdomadaire Dimanche | P7D | 01-10-2017/P7D | 01 octobre 2017-07 octobre 2017 |
| Bihebdomadaire | P14D | 02-10-2017/P14D | 02 octobre 2017-15 octobre 2017 |
| Mensuelle | P1M | 01-10-2017/P1M | 01 octobre 2017-31 octobre 2017 |
| Bimensuel | P2M | 01-11-2017/P2M | 01 novembre 2017-31 décembre 2017 |
| Trimestriel | P3M | 01-09-2017/P3M | 01 septembre 2017-31 décembre 2017 |
| Semestriel | P6M | 01-01-2017/P6M 01-07-2017/P6M | 1er janvier 2017-30 juin 2017 1er juillet 2017-31 décembre 2017 |
| Semestriel Avril | P6M | 01-04-2017/P6M 01-10-2017/P6M | 1er avril 2017-30 septembre 2017 1er octobre 2017-31 mars 2018 |
| Semestriel Novembre | P6M | 01-10-2017/P6M 01-05-2018/P6M | 1er novembre 2017-30 avril 2018 1er mai 2018-31 octobre 2018 |
| Annuel | P1Y | 01-01-2017/P1Y | 01 janvier 2017-31 décembre 2017 |
| Financière Avril | P1Y | 01-04-2017/P1Y | 1er avril 2017-31 mars 2018 |
| Financière Juillet | P1Y | 01-07-2017/P1Y | 1er juillet 2017-30 juin 2018 |
| Financière Octobre | P1Y | 01-10-2017/P1Y | 01 octobre 2017-30 septembre 2018 |
| Financière Novembre | P1Y | 01-11-2017/P1Y | 01 novembre 2017-31 octobre 2018 |
L'élément "valeur de données" dans ADX est très similaire à son équivalent dans DXF. Les attributs obligatoires sont élément de données et valeur. Les attributs unité d'organisation et période n'apparaissent pas dans l'élément "valeur de données" car ils sont requis au niveau groupe.
La différence la plus significative est la manière dont la désagrégation est représentée. DXF utilise la combinaison d'options de catégorie pour représenter la désagrégation des données. Dans ADX, les désagrégations (par exemple GROUPE_D'ÂGE et SEXE) sont exprimées explicitement en tant qu'attributs. Si vous utilisez code comme schéma d'identification pour catégorie, vous devez attribuer un code à toutes les catégories utilisées pour les éléments de données de l'ensemble de données et, de plus, ce code doit pouvoir être utilisé en tant qu'attribut XML. La contrainte concernant un nom d'attribut XML est décrite dans la norme XML du W3C. En pratique, cela signifie qu'il n'y a pas d'espaces, pas de caractères non alphanumériques autres que "_" et que le nom ne peut pas commencer par une lettre. L'exemple ci-dessus montre des exemples de "bons" codes de catégorie ("GENRE" et "ÂGE_VIH"). Les mêmes restrictions s'appliquent si vous utilisez nom ou attribut comme schémas d'identification.
Dans ADX, seuls les identifiants de catégorie sont utilisés comme attributs XML ; les identifiants d'autres types de métadonnées ne doivent pas être utilisés comme attributs XML. Notez que cette syntaxe n'est pas appliquée par DHIS2 lorsque vous attribuez des noms, des codes ou des attributs DHIS2, mais vous obtiendrez un message d'erreur avec une explication si vous essayez d'importer des données ADX et que les identifiants de catégorie ne sont pas attribués ou ne conviennent pas.
Les principaux avantages de l’utilisation de dimensions explicites de données désagrégées sont les suivants :
Le système qui produit les données n'a pas besoin d'être synchronisé avec la combinaison d'options de catégorie dans DHIS2.
Le producteur et le consommateur peuvent faire correspondre leurs codes à une source tierce qui fait autorité, telle qu'un service de terminologie. Notez que dans l'exemple ci-dessus, les codes de genre et de groupe d'âge utilisent des listes de codes de l'Observatoire mondial de la santé de l'OMS.
Cette fonction peut être très utile, par exemple pour produire des données désagrégées à partir d'un système de DME, mais il peut arriver qu'un mapping de combinaison d'options de catégorie soit plus facile ou plus souhaitable. L'implémentation d'ADX dans DHIS2 permettra de vérifier l'existence d'un attribut de combinaison d'options de catégorie et, s'il existe, de l'utiliser au lieu des attributs de dimension ventilés. De même, un attribut de combinaison d'options d'attributs sur l'élément groupe sera traité de la même manière que les attributs existants. Sinon, la combinaison d'options d'attributs peut être utilisée comme catégories ventilées, comme pour la valeur de données.
Dans l'exemple simple ci-dessus, tous les éléments de données de l'ensemble de données ont la même dimensionnalité (combinaison de catégories), ce qui rend les données parfaitement rectangulaires. Les ensembles de données peuvent contenir des éléments de données ayant des combinaisons de catégories différentes, ce qui donne un message de données ADX décalé vers la droite (c'est-à-dire que les valeurs des différents éléments de données peuvent avoir des nombres de catégories différents).
DHIS2 expose un point d'extrémité pour les données POST ADX à /api/dataValueSets en utilisant application/xml+adx comme type de contenu. Ainsi, par exemple, la commande curl suivante peut être utilisée pour POST (envoyer) les données de l'exemple ci-dessus au serveur de démonstration DHIS2 :
curl -u admin:district -X POST -H "Content-Type: application/adx+xml"
  -d @data.xml "https://play.dhis2.org/demo/api/dataValueSets?dataElementIdScheme=code&orgUnitIdScheme=code"
Notez que les paramètres de requête sont les mêmes que ceux utilisés avec les données DXF. Le point d'extrémité ADX doit interpréter tous les paramètres DXF existants avec la même sémantique que DXF.
DHIS2 expose un point d'extrémité pour les ensembles de données GET ADX dans /api/dataValueSets en utilisant application/xml+adx comme type de contenu. Ainsi, par exemple, la commande curl suivante peut être utilisée pour récupérer les données ADX :
curl -u admin:district -H "Accept: application/adx+xml"
 "https://play.dhis2.org/demo/api/dataValueSets?dataValueSets?orgUnit=M_CLINIC&dataSet=MALARIA&period=201501"
Notez que les paramètres de requête sont les mêmes que ceux utilisés avec les données DXF. Une différence importante est que les identifiants d'ensemble de données et d'unité d'organisation peuvent être soit des uids, soit des codes.
Cette section traite du marquage des données pour le suivi.
Le endpoint de suivi des valeurs de données permet de marquer les valeurs de données pour le suivi.
PUT /api/36/dataValues/followup
La charge au format JSON ressemble à ceci :
{
  "dataElement": "s46m5MS0hxu",
  "period": "202005",
  "orgUnit": "DiszpKrYNg8",
  "categoryOptionCombo": "psbwp3CQEhs",
  "attributeOptionCombo": "HllvX50cXC0",
  "followup": true
}
Les champs categoryOptionCombo et attributeOptionCombo sont facultatifs. Une charge JSON minimale ressemble à ceci :
{
  "dataElement": "s46m5MS0hxu",
  "period": "202005",
  "orgUnit": "DiszpKrYNg8",
  "followup": false
}
Le champ followup doit être défini sur true pour marquer une valeur de données pour le suivi, et sur false pour retirer le marquage.
Le code d'état de la réponse sera 200 OK si l'opération réussit, et 409 Conflict en cas d'erreur avec la requête.
Pour mettre à jour plusieurs valeurs de données à la fois pour le suivi :
PUT /api/dataValues/followups
avec la charge utile JSON :
{
  "values": [
    {
      "dataElement": "s46m5MS0hxu",
      "period": "202005",
      "orgUnit": "DiszpKrYNg8",
      "categoryOptionCombo": "psbwp3CQEhs",
      "attributeOptionCombo": "HllvX50cXC0",
      "followup": true
    }
  ]
}
Chaque élément de cette mise à jour comporte les mêmes champs et exigences que le point d'extrémité de la mise à jour unique.
La mise à jour groupée renvoie également 200 OK en cas de succès ou 409 Conflit en cas d'erreurs dans la requête.
Pour générer un résumé de validation des données, vous pouvez interagir avec la ressource de validation. La ressource "ensemble de données" est optimisée pour les clients chargés de la saisie des données et de la validation d'un ensemble de données ou d'un formulaire. Elle est accessible de la manière suivante :
GET /api/33/validation/dataSet/QX4ZTUbOt3a.json?pe=201501&ou=DiszpKrYNg8
En plus de la validation des règles basées sur un ensemble de données, il existe deux méthodes supplémentaires de validation : validation personnalisée et validation programmée.
La première variable de chemin d'accès est un identifiant qui fait référence à l'ensemble de données à valider. Les représentations XML et JSON des ressources sont prises en charge. La réponse contient les violations des règles de validation. Cette fonction sera étendue à d'autres types de validation dans les versions à venir.
Pour récupérer les règles de validation relatives à un ensemble de données spécifique, c'est-à-dire les règles de validation avec des formules où tous les éléments de données font partie de l'ensemble de données en question, vous pouvez effectuer une requête GET à la ressource validationRules de la manière suivante :
GET /api/validationRules?dataSet=<dataset-id>
Les règles de validation ont un côté gauche et un côté droit, dont la validité est comparée en fonction d'un opérateur. Les valeurs valides de l'opérateur sont indiquées dans le tableau ci-dessous.
Tableau : Opérateurs
| Valeur | Description |
|---|---|
| égale_à | Egal à |
| pas_égale_à | Pas égal à |
| supérieure_à | Supérieur à |
| supérieure_ou_égale_à_ | Supérieur ou égal à |
| inférieure_à | Inférieur à |
| inférieur_ou_égal_à_ | inférieur ou égal à |
| paire_obligatoire | Si l’un des côtés est présent, l’autre doit également l’être. |
| paire_exclusive | Si l’un des côtés est présent, l’autre ne doit pas être |
Les expressions du côté gauche et du côté droit sont des expressions mathématiques qui peuvent contenir des références à des éléments de données et à des combinaisons d'options de catégorie au format suivant :
${<dataelement-id>.<catoptcombo-id>}
Les expressions du côté gauche et du côté droit ont une stratégie de valeur manquante. Cette stratégie indique comment le système doit traiter les valeurs de données manquantes pour les références d'éléments de données ou de combinaisons d'options de catégorie dans la formule, en déterminant si la règle de validation doit être vérifiée ou ignorée. Les stratégies de valeurs manquantes valides sont présentées dans le tableau ci-dessous.
Tableau : Stratégies de valeur manquante
| Valeur | Description |
|---|---|
| IGNORER_SI_UNE_VALEUR_MANQUE | Ignore la règle de validation si une valeur de données est manquante |
| IGNORER_SI_TOUTES-LES_VALEURS_MANQUENT | Ignore la règle de validation si toutes les valeurs de données sont manquantes |
| NE-JAMAIS_IGNORER | N'ignore jamais la règle de validation, quelles que soient les valeurs de données manquantes |
Les résultats de validation sont les résultats des violations constatées lors d'une analyse de validation. Si vous choisissez "conserver les résultats" lorsque vous lancez ou programmez une analyse de validation, toutes les violations constatées seront stockées dans la base de données. Lorsqu'un résultat est stocké dans la base de données, il est utilisé à trois fins :
Générer des analyses basées sur les résultats stockés.
Les résultats qui n'ont pas généré de notification le feront, une fois.
Garder la trace des résultats qui ont généré ou non une notification.
Ignorer les règles déjà vérifiées lors de l'analyse de validation.
Cela signifie que si vous ne conservez pas vos résultats, vous ne pourrez pas générer d'analyses pour les résultats de validation. Si cette option est sélectionnée, les résultats généreront des notifications à chaque fois qu'il y en aura et l'analyse de validation pourrait être plus lente.
Les résultats de validation conservés peuvent être consultés au point d'extrémité suivant :
GET /api/33/validationResults
Vous pouvez également inspecter un résultat individuel à l'aide de l'identifiant du résultat de validation dans ce endpoint :
GET /api/33/validationResults/<id>
Les résultats de validation peuvent également être filtrés par les propriétés suivantes :
ou=<UID>vr=<UID>pe=<ISO-expression>Chacune des propriétés de filtre ci-dessus peut apparaître plusieurs fois, par exemple :
GET /api/36/validationResults?ou=jNb63DIHuwU&ou=RzgSFJ9E46G
Si plusieurs valeurs pour le même filtre sont combinées avec OR, les résultats devront correspondre à l'une des valeurs données.
Si plusieurs propriétés de filtre sont utilisées et qu'elles sont combinées avec AND, les résultats devront correspondre à l'une des valeurs de chacune des propriétés.
Pour le filtre de période, les résultats doivent se superposer à l'une des périodes spécifiées.
De plus, les résultats de validation peuvent également être filtrés en fonction de leur date de création :
GET /api/36/validationResults?createdDate=<date>
Ce filtre peut être combiné avec n’importe quel autre filtre.
Les résultats de la validation sont envoyés aux utilisateurs concernés une fois par jour. Ils peuvent également être déclenchés manuellement pour être exécutés sur demande, via le point d'extrémité de l'API suivant :
POST /api/33/validation/sendNotifications
Seuls les résultats non envoyés sont envoyés via ce endpoint.
Les résultats de validation peuvent être supprimés manuellement en utilisant l'ID,
DELETE /api/36/validationResults/<id>
ou les filtres
DELETE /api/36/validationResults?<filters>
Les paramètres de filtre pris en charge sont :
ou=<UID> pour faire correspondre tous les résultats de validation d'une unité d'organisation. Plusieurs unités utilisent 'OU' lorsque le paramètre est fourni plus d'une foisvr=<UID> pour faire correspondre tous les résultats de validation d'une règle de validation. Plusieurs règles utilisent 'OU' lorsque le paramètre est fourni plus d'une foispe=<ISO-expression> pour faire correspondre tous les résultats de validation liés à une période qui se superpose à la période spécifiéecreated=<ISO-expression> pour faire correspondre tous les résultats de validation créés au cours de la période fournienotificationSent=<boolean> pour faire correspondre uniquement les résultats de validation pour lesquels une notification a été ou n'a pas été envoyéeIf filters are combined, all conditions have to be true (AND logic).
Quelques exemples:
Pour supprimer tous les résultats de validation liés à l'unité d'organisation avec l'UID NqwvaQC1ni4 pour le premier trimestre (Q1) 2020, utilisez :
DELETE /api/36/validationResults?ou=NqwvaQC1ni4&pe=2020Q1
Pour supprimer tous les résultats de validation créés au cours de la semaine 1 de 2019 et pour lesquels une notification a été envoyée, utilisez :
DELETE /api/36/validationResults?created=2019W1¬ificationSent=true
Toute opération de suppression nécessitera l'autorité Effectuer des tâches de maintenance.
Le point d'extrémité de détection des valeurs atypiques permet de détecter les valeurs atypiques parmi les valeurs de données agrégées.
GET /api/36/outlierDetection
Ce endpoint prend en charge deux algorithmes pour détecter les valeurs atypiques :
Les valeurs atypiques seront classées selon leur importance, par défaut selon l'écart absolu par rapport à la moyenne, avec la valeur la plus importante en premier. Ceci permet d'identifier rapidement les valeurs atypiques qui ont le plus grand impact sur la qualité et l’analyse des données.
Les paramètres de requête suivants sont pris en charge.
| Paramètre de requête | Description | Obligatoire | Options (par défaut en premier) |
|---|---|---|---|
| ds | Ensemble de données, peut être spécifié plusieurs fois. | Non [*] | Identifiant de l'ensemble de données. |
| de | Élément de données, peut être spécifié plusieurs fois. | Non [*] | Identifiant de l'élément de données. |
| startDate | Date en début de l'intervalle pour contrôler les valeurs atypiques. | Oui | Date (aaaa-MM-jj). |
| endDate | Date en fin de l'intervalle pour vérifier les valeurs atypiques. | Oui | Date (aaaa-MM-jj). |
| ou | Unité d'organisation, peut être spécifiée plusieurs fois. | Oui | Identifiant de l’unité d’organisation. |
| algorithm | Algorithme à utiliser pour la détection des valeurs atypiques. | Non | Z_SCORE, MIN_MAX, MOD_Z_SCORE, INVALID_NUMERIC |
| threshold | Seuil pour les valeurs atypiques. Algorithmes Z_SCORE et MOD_Z_SCORE uniquement. | Non | Numérique, supérieur à zéro. Par défaut : 3,0. |
| dataStartDate | Date en début de l'intervalle pour le calcul de la moyenne et de l'écart type. Algorithmes Z_SCORE et MOD_Z_SCORE uniquement. | Non | Date (aaaa-MM-jj). |
| dataEndDate | Date en fin de l'intervalle pour le calcul de la moyenne et de l'écart type. Algorithmes Z_SCORE et MOD_Z_SCORE uniquement. | Non | Date (aaaa-MM-jj). |
| orderBy | Field to order by. Z_SCORE and MOD_Z_SCOREalgorithm only. | Non | MEAN_ABS_DEV, Z_SCORE |
| maxResults | Limite maximale pour la sortie. | Non | Integer, greater than zero and less than system setting keyDataQualityMaxLimit Default: 500. |
[*] Vous devez spécifier soit des ensembles de données avec le paramètre ds, qui intégrera tous les éléments de données dans les ensembles de données, ou spécifier des éléments de données avec le paramètre de.
Au moins un ensemble de données ou élément de données, une date de début et une date de fin, et au moins une unité d'organisation doivent être définis.
Les paramètres startDate et endDate sont obligatoires et font référence à l'intervalle de temps dans lequel vous voulez détecter les valeurs atypiques. Les paramètres dataStartDate et dataEndDate sont facultatifs et font référence à l'intervalle de temps à utiliser pour les données lors du calcul de la moyenne et de l'écart type. Ils sont utilisés pour calculer éventuellement le z-score.
Obtenez les valeurs atypiques à l'aide de l'algorithme z-score par défaut :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt&ds=QX4ZTUbOt3a
  &ou=O6uvpzGd5pu&ou=fdc6uOvgoji&startDate=2020-01-01&endDate=2020-12-31
Pour obtenir des valeurs atypiques à l'aide d'un algorithme et d'un seuil spécifiques :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt&ds=QX4ZTUbOt3a
  &ou=O6uvpzGd5pu&startDate=2020-01-01&endDate=2020-12-31
  &algorithm=Z_SCORE&threshold=2.5
Pour obtenir les valeurs atypiques classées par z-score :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt
  &ou=O6uvpzGd5pu&startDate=2020-01-01&endDate=2020-12-31
  &orderBy=Z_SCORE
Pour obtenir les 10 principales valeurs atypiques :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt
  &ou=O6uvpzGd5pu&startDate=2020-01-01&endDate=2020-12-31
  &maxResults=10
Obtenez des valeurs atypiques avec un intervalle défini pour les données à utiliser lors du calcul de la moyenne et de l'écart type :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt
  &ou=O6uvpzGd5pu&startDate=2020-01-01&endDate=2020-12-31
  &dataStartDate=2018-01-01&dataEndDate=2020-12-31
Pour obtenir les valeurs atypiques à l'aide de l'algorithme min-max :
GET /api/36/outlierDetection?ds=BfMAe6Itzgt&ds=QX4ZTUbOt3a
  &ou=O6uvpzGd5pu&ou=fdc6uOvgoji&startDate=2020-01-01&endDate=2020-12-31
  &algorithm=MIN_MAX
Les formats de réponse suivants sont pris en charge.
| Format | Format API |
|---|---|
| JSON | /api/36/outlierDetection.json or Accept: application/json (default format) |
| CSV | /api/36/outlierDetection.csv or Accept: application/csv |
La réponse contient les champs suivants :
| Champ | Description |
|---|---|
| de | Identifiant de l'élément de données. |
| deName | Nom de l'élément de données. |
| pe | Identifiant ISO de la période. |
| ou | Identifiant de l’unité d’organisation. |
| ouName | Nom de l'unité d'organisation. |
| coc | Identifiant de la combinaison d’options de catégorie. |
| cocName | Nom de la combinaison d’options de catégorie. |
| aoc | Identifiant de la combinaison d’options d’attribut. |
| aocName | Nom de la combinaison d’options d’attribut. |
| value | Valeur de données. |
| moyenne | Moyenne des valeurs de données dans la dimension temporelle. |
| stdDev | Écart type. |
| absDev | Pour le z-score, il s'agit de l'écart absolu par rapport à la moyenne. Pour min-max, il s'agit de l'écart absolu par rapport à la limite minimale ou maximale. |
| zScore | Le z-score. Algorithme du z-score uniquement. |
| lowerBound | La limite inférieure. |
| upperBound | La limite supérieure. |
| followUp | Si la valeur de données est marquée pour le suivi. |
Les champs mean, stdDev et z-score ne sont présents que lorsque algorithm est Z_SCORE.
La réponse ressemblera à ceci. La section metadata contient des métadonnées de requête et de réponse. La section outlierValues contient les valeurs atypiques.
{
  "metadata": {
    "algorithm": "Z_SCORE",
    "threshold": 2.5,
    "orderBy": "MEAN_ABS_DEV",
    "maxResults": 10,
    "count": 10
  },
  "outlierValues": [
    {
      "de": "rbkr8PL0rwM",
      "deName": "Iron Folate given at ANC 3rd",
      "pe": "202011",
      "ou": "Pae8DR7VmcL",
      "ouName": "MCH (Kakua) Static",
      "coc": "pq2XI5kz2BY",
      "cocName": "Fixed",
      "aoc": "HllvX50cXC0",
      "aocName": "default",
      "value": 9000.0,
      "mean": 1524.5555,
      "stdDev": 2654.4661,
      "absDev": 7475.4444,
      "zScore": 2.8161,
      "lowerBound": -5111.6097,
      "upperBound": 8160.7208,
      "followUp": false
    },
    {
      "de": "rbkr8PL0rwM",
      "deName": "Iron Folate given at ANC 3rd",
      "pe": "202010",
      "ou": "vELbGdEphPd",
      "ouName": "Jimmi CHC",
      "coc": "pq2XI5kz2BY",
      "cocName": "Fixed",
      "aoc": "HllvX50cXC0",
      "aocName": "default",
      "value": 8764.0,
      "mean": 1448.0833,
      "stdDev": 2502.3031,
      "absDev": 7315.9166,
      "zScore": 2.9236,
      "lowerBound": -4807.6745,
      "upperBound": 7703.8412,
      "followUp": false
    }
  ]
}
Les contraintes suivantes s'appliquent lors de la validation de la requête. Chaque erreur de validation a un code d'erreur correspondant.
| Code d'erreur | Message |
|---|---|
| E2200 | Au moins un élément de données doit être spécifié |
| E2201 | La date de début et la date de fin doivent être précisées |
| E2202 | La date de début doit être antérieure à la date de fin |
| E2203 | Au moins une unité d'organisation doit être spécifiée |
| E2204 | Le seuil doit être un nombre positif |
| E2205 | Les résultats maximum doivent être exprimés en nombres positifs |
| E2206 | Le nombre de résultats maximum dépasse la limite autorisée : {d} |
| E2207 | La date de début des données doit être antérieure à la date de fin des données |
| E2208 | Valeurs de données non numériques rencontrées lors de la détection des valeurs atypiques |
Plusieurs ressources permettant d'effectuer des analyses de données et de détecter les problèmes de qualité et de validation des données sont fournies.
Remarque : Ce endpoint est obsolète et sera supprimé dans la version 2.38. Utilisez plutôt le endpoint outlierAnalysis.
Pour exécuter des règles de validation et extraire les violations :
GET /api/dataAnalysis/validationRules
Les paramètres de requête suivants sont pris en charge :
Tableau : Paramètres de requête d'analyse des règles de validation
| Paramètre de requête | Description | Option | Obligatoire | Par défaut | |---|---|---|---| | vrg | Groupe de règles de validation | Identifiant | false | If omitted, all validation rule groups will be used | | ou | Unité d’organisation | Identifiant |true | | | startDate | Start date for the time span | Date (aaaa-MM-jj) | false | Aujourd'hui | | endDate | End date for the time span | Date (aaaa-MM-jj) | false | Aujourd'hui | | conserver | S'il faut conserver les violations dans le système | false | true | false | false | | notification | S'il faut envoyer des notifications sur les violations | false | true | false | false | | maxResults | Max limit for the output | Integer, greater than zero. Maximum as specified by system setting keyDataQualityMaxLimit| false | 500 |
Sample POST body request:
{
    "startDate":"2024-01-01",
    "endDate":"2025-04-10",
    "ou":"ImspTQPwCqd",
    "notification":false,
    "persist":false,
    "vrg":"UP1lctvalPn",
    "maxResults": 500
}

Sample output:
```json
[{
    "validationRuleId": "kgh54Xb9LSE",
    "validationRuleDescription": "Malaria outbreak",
    "organisationUnitId": "DiszpKrYNg8",
    "organisationUnitDisplayName": "Ngelehun CHC",
    "organisationUnitPath": "/ImspTQPwCqd/O6uvpzGd5pu/YuQRtpLP10I/DiszpKrYNg8",
    "organisationUnitAncestorNames": "Sierra Leone / Bo / Badjia / ",
    "periodId": "201901",
    "periodDisplayName": "January 2019",
    "attributeOptionComboId": "HllvX50cXC0",
    "attributeOptionComboDisplayName": "default",
    "importance": "MEDIUM",
    "leftSideValue": 10.0,
    "operator": ">",
    "rightSideValue": 14.0
}, {
    "validationRuleId": "ZoG4yXZi3c3",
    "validationRuleDescription": "ANC 2 cannot be higher than ANC 1",
    "organisationUnitId": "DiszpKrYNg8",
    "organisationUnitDisplayName": "Ngelehun CHC",
    "organisationUnitPath": "/ImspTQPwCqd/O6uvpzGd5pu/YuQRtpLP10I/DiszpKrYNg8",
    "organisationUnitAncestorNames": "Sierra Leone / Bo / Badjia / ",
    "periodId": "201901",
    "periodDisplayName": "January 2019",
    "attributeOptionComboId": "HllvX50cXC0",
    "attributeOptionComboDisplayName": "default",
    "importance": "MEDIUM",
    "leftSideValue": 22.0,
    "operator": "<=",
    "rightSideValue": 19.0
}]
Pour identifier les valeurs atypiques parmi les données en fonction des écarts types de la valeur moyenne :
GET /api/dataAnalysis/stdDevOutlier
Les paramètres de requête suivants sont pris en charge :
Tableau : Paramètres de requête d'analyse des valeurs atypiques de l'écart type
| Paramètre de requête | Description | Option |
|---|---|---|
| ou | Unité d’organisation | Identifiant |
| startDate | Date de début de la période | Date |
| endDate | Date de fin de la période | Date |
| ds | Ensembles de données, le paramètre peut être répété | Identifiant |
| écart type | Nombre d'écarts types par rapport à la moyenne | Valeur numérique |
Pour identifier les valeurs atypiques sur la base des valeurs minimales et maximales :
GET /api/dataAnalysis/minMaxOutlier
Les paramètres de requête pris en charge équivalent à la ressource analyse des valeurs atypiques en fonction de l'écart type décrite ci-dessus.
Pour identifier les données marquées pour le suivi :
GET /api/dataAnalysis/followup
Au moins un ensemble de données ou élément de données, une date ou période de début et de fin, et au moins une unité d'organisation doivent être définis.
Les paramètres de requête suivants sont pris en charge.
| Paramètre | Description | Obligatoire | Options (par défaut en premier) |
|---|---|---|---|
| ou | Unité d'organisation, peut être spécifiée plusieurs fois. | Oui | Identifiant de l’unité d’organisation. |
| ds | Ensemble de données, peut être spécifié plusieurs fois. | Non [*] | Identifiant de l'ensemble de données. |
| de | Élément de données, peut être spécifié plusieurs fois. | Non [*] | Identifiant de l'élément de données. |
| startDate | Date en début de l'intervalle pour contrôler les valeurs atypiques. | Non [*] | Date (aaaa-MM-jj). |
| endDate | Date en fin de l'intervalle pour vérifier les valeurs atypiques. | Non [*] | Date (aaaa-MM-jj). |
| pe | ID de la période ISO. | Non [*] | Identifiant ISO de la période. |
| Type de période | Période ISO. | Non [*] | Chaîne ISO de la période. |
| coc | Les combinaisons d’options de catégorie peuvent être spécifiées plusieurs fois. | Non | Identifiant de la combinaison d’options de catégorie. |
| maxResults | Limite maximale pour la sortie. | Non | Entier, supérieur à zéro. Par défaut : 50. |
[*] Vous devez spécifier soit des ensembles de données avec le paramètre ds, qui intégrera tous les éléments de données dans les ensembles de données, ou spécifier des éléments de données avec le paramètre de. De même, Date de début et date de fin ou période doivent être spécifiés.
Les paramètres Date de début et Date de fin font référence à l'intervalle de temps au cours duquel vous voulez détecter les valeurs atypiques. Si une période pe est fournie à la place, le début et la fin de l'intervalle sont également ceux de la période.
Si aucune combinaison d'options coc n'est fournie, tous les éléments de données de type valeur numérique seront pris en compte.
Les fonctionnalités d'intégrité des données du module d'administration des données sont disponibles via l'API web. Cette section décrit comment exécuter le processus d'intégrité des données et récupérer les résultats. Les informations spécifiques concernant chaque contrôle sont décrites dans le manuel de l'utilisateur.
Une description des contrôles disponibles est renvoyée après qu'une requête soit envoyé à :
GET /api/dataIntegrity
[
    {
        "name": "data_elements_without_groups",
        "displayName": "Data elements lacking groups",
        "section": "Data Elements",
        "severity": "WARNING",
        "description": "Lists all data elements that have no data element groups",
        "issuesIdType": "dataElements",
        "isSlow": false
    }
]
L'élément name (nom) parmi les éléments de contrôle renvoyés est l'identifiant utilisé par le paramètre contrôles pour déclarer les contrôles à exécuter.
Remarque
Chaque contrôle indiquera si la saisie dans le champ
isSlow(est lent) peut nécessiter beaucoup de temps et de ressources. Les utilisateurs doivent être prudents lorsqu'ils exécutent ces contrôles sur les systèmes de production car cela pourrait entraîner une baisse de performance du système. Ces contrôles peuvent être exécutés individuellement, mais seulement sur requête expresse.
Les contrôles sont regroupés sémantiquement par l'élément section et classés dans l'un des quatre niveaux de sévérité :
| Sévérité | Description |
|---|---|
| INFO | Indique qu'il s'agit uniquement d'une information. |
| AVERTISSEMENT | Un avertissement indique qu'il peut s'agir d'un problème, mais pas nécessairement d'une erreur. Il est cependant recommandé de trier ces problèmes. |
| SEVERE | Une erreur qui devrait être corrigée mais qui ne provoque pas nécessairement un dysfonctionnement du système. |
| CRITIQUE | Une erreur qui doit être corrigée et qui peut induire l'utilisateur final en erreur ou provoquer des pannes de système. |
Les contrôles disponibles peuvent être filtrés à l'aide du paramètre contrôles.
GET /api/dataIntegrity?checks=<pattern1>,<pattern2>
Un ou plusieurs noms ou modèles exacts utilisant * comme caractère générique peuvent être fournis.
Des résultats supplémentaires peuvent être filtrés à l'aide d'un paramètre section.
GET /api/dataIntegrity?section=Categories
Le filtre section renverra toutes les correspondances exactes qui ont la section spécifiée.
Furthermore, to filter (select) only checks marked as isSlow use slow=true,
GET /api/dataIntegrity?slow=true
or to filter (select) only checks that are not performed via database query (programmed checks) use programmatic=true:
GET /api/dataIntegrity?programmatic=true
The slow, programmatic and section filters can be combined in which case all conditions must be met.
Depuis la version 2.38, les contrôles d'intégrité des données ont deux niveaux de spécificité :
résumé qui donne un aperçu du nombre de problèmesdétails qui fournit une liste de problèmes indiquant des violations individuelles de l'intégrité des données.Pour lancer une analyse qui résume les contrôles exécutés :
POST /api/dataIntegrity/summary?checks=<name1>,<name2>
Cela déclenche l'exécution du ou des contrôle(s) de manière asynchrone. Les résultats des contrôles individuels seront renvoyés dans le cache de l'application dès que le contrôle sera terminé.
Alternativement, la liste des contrôles peut également être fournie comme le CORPS de la requête POST. Cela peut être utile si la liste devient trop longue pour être utilisée dans l'URL.
Pour récupérer le résumé sur l'intégrité des données du ou des contrôle(s) déclenchés, utilisez :
GET /api/dataIntegrity/summary?checks=<name1>,<name2>
Lorsque le paramètre contrôles est omis, tous les contrôles seront récupérées depuis le cache du serveur.
La réponse est une "carte" des résultats de contrôle, un pour chaque contrôle déjà terminé. Ces informations sont mises en cache pendant une heure ou jusqu'à ce que le contrôle soit exécuté à nouveau.
Pour attendre que le résumé soit disponible dans le cache, un timeout (délai d'attente) en millisecondes peut être ajouté :
GET /api/dataIntegrity/summary?checks=<name1>,<name2>&timeout=500
Une réponse de résumé pourrait ressembler à ceci :
{
  "<name1>": {
    "name": "<name1>",
    "displayName": "<displayName1>",
    "startTime": "2023-01-11T06:12:56.436",
    "finishedTime": "2023-01-11T06:12:57.021",
    "section": "...",
    "severity": "WARNING",
    "description": "...",
    "count": 12,
    "percentage": 2.3
  },
  "<name2>": {
    "name": "<name2>",
    "displayName": "<displayName2>",
    "startTime": "2023-01-11T06:12:57.345",
    "finishedTime": "2023-01-11T06:12:58.007",
    "section": "...",
    "severity": "WARNING",
    "description": "...",
    "count": 4,
    "percentage": 5.1
  }
}
Chaque réponse de résumé contient le nom, la section, la sévérité, la description et éventuellement une introduction et une recommandation. Chaque résumé contient le nombre de problèmes trouvés dans le champ nombre. Si possible, un champ optionnel pourcentage fournit le pourcentage d'objets présentant des problèmes d'intégrité des données par rapport à l'ensemble des objets du même type. Le champ Heure de début indique le moment où le contrôle a été initié. Le champ Heure de fin permet de calculer la durée nécessaire à l'exécution du contrôle.
Si une analyse de contrôle échoue en raison d'une erreur de programmation ou d'une incohérence imprévue des données, le résumé et les détails comporteront un champ erreur qui décrit l'erreur qui s'est produite. Le nombre de contrôles qui ont échoué sera fixé à -1. Aucun pourcentage ne sera renvoyé dans ce cas.
{
  "<name1>": {
    "name": "<name1>",
    "displayName": "<displayName1>",
    "finishedTime": "2022-02-15 14:55",
    "section": "...",
    "severity": "WARNING",
    "description": "...",
    "error": "what has happened",
    "issues": []
  }
}
Remarque
Chaque contrôle de métadonnée est exécuté de manière asynchrone sur le serveur. Les résultats seront restitués dès que chaque contrôle sera terminé. Le moyen le plus sûr de vous assurer que vous avez récupéré le dernier ensemble de résultats demandé est de comparer l'horodatage de la requête avec
finishedTime(heure de fin) dans la réponse.
Pour obtenir une liste des noms des contrôles actuellement effectués par l'utilisation du serveur :
GET /api/dataIntegrity/summary/running
Pour obtenir une liste des noms des contrôles pour lesquels les résultats sont disponibles, utilisez :
GET /api/dataIntegrity/summary/completed
Metadata integrity checks which are present in the cache, can be retrieved in the Prometheus metrics format by making a request to : GET /api/dataIntegrity/metrics
The response should return a plain text format in the Prometheus plain text exposition format. Several metrics are available for each data integrity check. - Count: A count of the number of issues identified by the metadata check. - Percentage: When available, provides a percentage of the objects which have been identified by the check relative to a baseline. For instance, if check "Organisation units with trailing spaces" has a percent of 2.13, the percentage is calculated by dividing the number of organisation units with trailing spaces by the total number of organisation units. Note that this percentage may not be available for all metadata integrity checks. - Duration: Number of milliseconds that the check took to execute the last time it was run.
An example of the output of this endpoint is provided below:
# HELP dhis_data_integrity_check_count Data integrity check counts { #help-dhis_data_integrity_check_count-data-integrity-check-counts }
# TYPE dhis_data_integrity_check_count gauge { #type-dhis_data_integrity_check_count-gauge }
dhis_data_integrity_check_count{check="orgunits_invalid_geometry"} 1
dhis_data_integrity_check_count{check="user_groups_scarce"} 0
dhis_data_integrity_check_count{check="indicator_no_analysis"} 13
# HELP dhis_data_integrity_check_percentage Data integrity check percentages { #help-dhis_data_integrity_check_percentage-data-integrity-check-percentages }
# TYPE dhis_data_integrity_check_percentage gauge { #type-dhis_data_integrity_check_percentage-gauge }
dhis_data_integrity_check_percentage{check="orgunits_invalid_geometry"} 0.13054830287206268
dhis_data_integrity_check_percentage{check="user_groups_scarce"} 0.0
dhis_data_integrity_check_percentage{check="indicator_no_analysis"} 16.0
# HELP dhis_data_integrity_check_duration Data integrity check durations { #help-dhis_data_integrity_check_duration-data-integrity-check-durations }
# TYPE dhis_data_integrity_check_duration gauge { #type-dhis_data_integrity_check_duration-gauge }
dhis_data_integrity_check_duration{check="orgunits_invalid_geometry"} 11
dhis_data_integrity_check_duration{check="user_groups_scarce"} 1
dhis_data_integrity_check_duration{check="indicator_no_analysis"} 0
Data integrity checks which are not currently in the cache will not be returned by this endpoint. A request would need to be made to the /summary endpoint to trigger the checks to be run or alternatively through a scheduled job.
Pour lancer une sélection de contrôles de détails, déclenchez-les d'abord à l'aide d'une requête POST :
POST /api/dataIntegrity/details?checks=<name1>,<name2>
Tout comme avec le résumé, la liste des contrôles peut également être fournie en tant que corps de la requête POST.
Récupérez ensuite les résultats du cache en utilisant :
GET /api/dataIntegrity/details?checks=<name1>,<name2>&timeout=500
Lorsque le paramètre contrôles n'est pas fourni, tous les contrôles qui n'ont pas été marqués isSlow (est lent) seront programmés pour être exécutés sur le serveur.
Si vous omettez l'élément timeout (délai d'attente), la requête n'attendra que les résultats soient trouvés dans le cache, au contraire vous ne recevrez pas le résultat du contrôle demandé.
La réponse /détails renvoie une carte similaire à celle du résumé, mais ne contient pas de nombre ou de pourcentage. En lieu et place, une liste de problèmes est renvoyée.
{
  "<name1>": {
    "name": "<name1>",
    "displayName": "<displayName1>",
    "startTime": "2023-01-11T06:12:56.436",
    "finishedTime": "2023-01-11T06:12:57.021",
    "section": "...",
    "severity": "WARNING",
    "description": "...",
    "issuesIdType": "<object-type-plural>",
    "isSlow": false,
    "issues": [{
      "id": "<id-or-other-identifier>",
      "name": "<name-of-the-id-obj>",
      "comment": "optional plain text description or hint of the issue",
      "refs": ["<id1>", "<id2>"]
    }]
  },
  "<name2>": {
    "name": "<name2>",
    "displayName": "<displayName2>",
    "startTime": "2023-01-11T06:12:57.345",
    "finishedTime": "2023-01-11T06:12:58.007",
    "section": "...",
    "severity": "WARNING",
    "description": "...",
    "issuesIdType": "<object-type-plural>",
    "isSlow": false,
    "issues": []
  }
}
id et nom. Souvent, l'élément issuesIdType (type d'identifiant des problèmes) est disponible pour indiquer le type d'objet auquel l'élément id se réfère. Si issuesIdType n'est pas disponible, l'id ne l'est souvent pas non plus et le nom est utilisé comme clé agrégée pour un problème qui n'a pas d'équivalent objet. Les champs commentaire et références sont optionnels pour chaque problème. Un commentaire peut donner plus de précisions sur le contexte ou la raison pour laquelle ce problème est considéré comme un problème d'intégrité des données. La liste références peut également fournir les identifiants d'autres objets qui ont contribué à la violation. Le champ Heure de fin indique le moment où le contrôle a fini d'être traité sur le serveur. Le cache stocke le résultat de chaque contrôle terminé pendant une heure.
Tip
Un ensemble de contrôles peut également être spécifié à l'aide de wild-cards (caractères génériques). Pour inclure tous les contrôles avec élément dans le nom, utilisez
contrôles=*élément*. Tout comme avec les noms complets, ces motifs peuvent être utilisés dans une liste de caractères séparés par des virgules et être combinés avec les noms complets. Les doublons seront éliminés. Un contrôle peut également être spécifié par son code. Un code est constitué des premières lettres de chaque mot du nom en majuscules. Par exemple,orgunits_invalid_geometrya le codeOIG.
Tout comme avec le résumé, il est possible d'obtenir les noms des contrôles de détails en cours d'exécution et de ceux déjà effectués avec la requête suivante :
GET /api/dataIntegrity/details/running
GET /api/dataIntegrity/details/completed
Users of DHIS2 can now create and supply their own Data Integrity Checks. This can be useful if users want to avail of this functionality and extend upon the supplied set of core data integrity checks.
Tip
Users are also encouraged to share their custom checks with others by opening a pull request in the dhis2-core repository containing their
.yamlfile(s). Please selectplatform-backendas reviewer to put the PR on our radar early on. The team will take care of checking and linking the check correctly, so it becomes part of the provided suite of checks with the next release.
An example of a custom check could be for determining if certain users are members of specific user groups. This type of check would be very specific to an implementation, and not generally applicable across all installs. These types of metadata checks can be used to extend the default checks which are included with DHIS2.
Custom checks can be implemented by satisfying the following requirements, each of which we will go into detail: - Supplying your own list of custom data integrity checks in a list file named custom-data-integrity-checks.yaml in your DHIS2_HOME directory - Having a directory named custom-data-integrity-checks in your DHIS2_HOME directory - Supplying your valid custom data integrity check yaml files
DHIS2 will only try to load data integrity files when they are needed. e.g. when making a call to view all data integrity checks:
GET /api/dataIntegrity
DHIS2 will look for a file named custom-data-integrity-checks.yaml in your DHIS2_HOME directory when loading data integrity files. If you are not using custom checks and the file is not present, a warning log like this will be present:
08:29:57.729 WARN o.h.d.d.DataIntegrityYamlReader: Failed to load data integrity check from YAML. Error message `{DHIS2_HOME}/custom-data-integrity-checks.yaml (No such file or directory)
If you are implementing custom data integrity checks then this file must be present. To see what the core data integrity checks file looks like as an example, check out this file.
The custom-data-integrity-checks.yaml file should list all of your custom data integrity checks. As an example, it could look something like this:
checks:
  - categories/my_custom_check.yaml
  - users/my_user_group_check.yaml
  - base_check.yaml
Check names in this file can be preceded with a directory name for logical grouping. From the 3 example checks listed above, the directory structure should look like this:
├── DHIS2_HOME
│   ├── dhis.conf
│   ├── custom-data-integrity-checks.yaml
│   ├── custom-data-integrity-checks
│   │   ├── categories
│   │   │   ├── my_custom_check.yaml
│   │   ├── users
│   │   │   ├── my_user_group_check.yaml
│   │   ├── base_check.yaml
Each data integrity check name and code must be unique. If there are any clashes then the violating custom check will not be loaded.
Note
System data integrity checks are always loaded first. Any name or code clashes resulting from custom checks will not affect these core system checks.
An example data integrity check yaml file is located here for reference. Note the name property.
The data integrity code is calculated dynamically by using the first letter of each word in the name. Some examples:
| Nom | Code |
|---|---|
| my_custom_check | MCC |
| my_second_custom_check | MSCC |
| another_custom_check | ACC |
If there is a name clash, a warning log like this will be present:
09:48:43.138 WARN o.h.d.d.DefaultDataIntegrityService: Data Integrity Check `my_custom_check` not added as a check with that name already exists
If there is a code clash, a warning log like this will be present:
09:48:43.138 WARN o.h.d.d.DefaultDataIntegrityService: Data Integrity Check `my_custom_check` not added as a check with the code `MCC` already exists
A data integrity check file must comply with this JSON schema. If a check does not comply with the schema then a warning like this will be present:
09:48:43.136 WARN o.h.d.d.DataIntegrityYamlReader: JsonSchema validation errors found for Data Integrity Check `categories/my_custom_check.yaml`. Errors: [$.name: is missing but it is required]
Any schema violations must be fixed before that check can be loaded and used.
If a data integrity check file contains invalid yaml then a warning log like this could be present:
10:30:37.858 WARN o.h.d.d.DataIntegrityYamlReader: JsonSchema validation errors found for Data Integrity Check `my_custom_check.yaml`. Errors: [$: string found, object expected]
To view and use the custom checks please refer to the main Data Integrity section
Note
It is recommended to follow any naming and format conventions seen in the provided examples above when implementing your own custom checks to help avoid any issues
Details of the data integrity check yaml file, taken from the JSON schema file
| propriété | requis | info |
|---|---|---|
| name | yes | unique name of the check |
| description | yes | description |
| section | yes | used for logical grouping of checks e.g. categories, users |
| section_order | yes | the order of the check when displayed in the UI |
| summary_sql | yes | an SQL query which should return a single result which represents the total count of issues |
| details_sql | yes | an SQL query which should return a list of identified objects from this particular issue. Should return at least uid and name |
| details_id_type | yes | a short string which identifies the section of the details SQL |
| severity | yes | level of severity of the issue. One of [INFO, WARNING, SEVERE, CRITICAL] |
| introduction | yes | outlining the objective of the check |
| recommendation | yes | outlining how to resolve identified issues |
An example of a custom check could be for determining if users have an email. Emails are useful to be able to communicate with users and sent them notifications, as well as password recovery. So, in some instllations of DHIS2, it could be a policy that all users should have emails. An example of this type of custom check is shown below.
---
name: users_should_have_emails
description: Users should have emails.
section: Users
section_order: 6
summary_sql: >-
  WITH users_no_email as (
  SELECT uid,username from
  userinfo where email IS NULL)
  SELECT COUNT(*) as value,
  100*COUNT(*) / NULLIF( ( select COUNT(*) from userinfo), 0) as percent
  from users_no_email;
details_sql: >-
  WITH users_no_email as (
  SELECT uid,username from
  userinfo where email IS NULL)
  SELECT uid,username as from users_no_email;
severity: WARNING
introduction: >
  Users should have defined emails. This is important for password recovery and to be able
  to send notifications to users.
recommendation: >
  Make sure that all users have defined emails.
details_id_type: users
More examples of different types of metadata integrity checks can be found in the DHIS2 source code here.
Cette section traite de l'enregistrement d'ensembles de données complétés en tant qu'ensembles de données. Un enregistrement marque un ensemble de données comme étant complètement capturé.
Cette section explique comment enregistrer des ensembles de données comme étant complets. Cela s'obtient en interagissant avec la ressource completeDataSetRegistrations (Enregistrements d'ensembles de données complets):
GET /api/33/completeDataSetRegistrations
Le point d'extrémité utilise la méthode POST pour enregistrer les ensembles de données complets. De façon pratique, ce point d'extrémité est très similaire à celui de dataValueSets (ensembles de valeurs de données), avec la possibilité d'importer des enregistrements complets en bloc.
L'importation de charges utiles au format XML et JSON est prise en charge. Le format de base de cette charge utile, donné en XML dans cet exemple, ressemble à ceci :
<completeDataSetRegistrations xmlns="http://dhis2.org/schema/dxf/2.0">
  <completeDataSetRegistration period="200810" dataSet="eZDhcZi6FLP"
    organisationUnit="qhqAxPSTUXp" attributeOptionCombo="bRowv6yZOF2" storedBy="imported"/>
  <completeDataSetRegistration period="200811" dataSet="eZDhcZi6FLP"
    organisationUnit="qhqAxPSTUXp" attributeOptionCombo="bRowv6yZOF2" storedBy="imported"/>
</completeDataSetRegistrations>
L'attribut storedBy (stocké par) est facultatif (car il peut être retiré de l'objet d'enregistrement complet). Vous pouvez également définir la propriété date (heure de l'enregistrement) en tant qu'attribut. Si l'heure n'est pas définie, l'heure actuelle sera utilisée.
Le processus d'importation prend en charge les paramètres de requête suivants :
Tableau : Paramètres de requête d'enregistrement d'ensembles de données complets
| Paramètre | Valeurs | Description |
|---|---|---|
| dataSetIdScheme (Schéma de l'identifiant de l'ensemble de données) | id | name |
| orgUnitIdScheme | id | name |
| attributOptionComboIdScheme (Schéma de l'identifiant de la combinaison d'options d'attribut) | id | name |
| idScheme | id | name |
| preheatCache | false | true |
| dryRun | false | true |
| importStrategy (stratégie d'importation) | CREATE (créer) | UPDATE (mettre à jour) |
| skipExistingCheck (ignorer les contrôles) | false | true |
| async | false | true |
Les éléments idScheme (schéma de l'identifiant), dataSetIdScheme (schéma de l'identifiant de l'ensemble de données), orgUnitIdScheme (schéma de l'identifiant de l'unité d'organisation), attributeOptionComboIdScheme (schéma de l'identifiant de la combinaison d'options d'attribut), dryRun (essai) et strategy (stratégie) (notez la dénomination différente du paramètre importStrategy (stratégie d'importation)) peuvent également être définis dans le cadre de la charge utile. Avec XML, ce sont des attributs ; avec JSON, ce sont des éléments du nœud completeDataSetRegistrations (enregistrements des ensembles de données complets).
Par exemple :
<completeDataSetRegistrations xmlns="http://dhis2.org/schema/dxf/2.0"
      orgUnitIdScheme="CODE">
    <completeDataSetRegistration period="200810" dataSet="eZDhcZi6FLP"
    organisationUnit="OU_559" attributeOptionCombo="bRowv6yZOF2" storedBy="imported"/>
</completeDataSetRegistrations>
Si le paramètre URL et la charge utile définissent un schéma, la charge utile est prioritaire.
Cette section explique comment récupérer les enregistrements d'ensembles de données terminés. Nous utiliserons la ressource completeDataSetRegistrations. Les paramètres de requête à utiliser sont les suivants :
Tableau : Paramètres de requête d'ensemble de valeurs de données
| Paramètre | Description |
|---|---|
| dataSet (ensemble de données) | Identifiant de l'ensemble de données, plusieurs ensembles de données sont autorisés |
| period | Identifiant de période au format ISO. Plusieurs périodes sont autorisées. |
| startDate | Date de début de la période des valeurs à exporter |
| endDate | Date de fin de la période des valeurs à exporter |
| created | Inclut uniquement les enregistrements créés depuis l'horodatage donné |
| Durée de la création | Inclut uniquement les enregistrements créés pendant la durée indiquée. Le format est <value><unité-de-temps>, où les unités de temps prises en charge sont "d", "h", "m", "s " (jours, heures, minutes, secondes). L'unité de temps est liée à l'heure actuelle. |
| orgUnit | Identifiant de l'unité d'organisation ; peut être spécifié plusieurs fois. Non applicable si un groupe d'unités d'organisation est fourni. |
| orgUnitGroup (groupe d'unités d'organisation) | Identifiant du groupe d’unités d’organisation ; peut être spécifié plusieurs fois. Non applicable si une unité d'organisation est fournie. |
| subordonnées | Permet de spécifier s'il faut inclure les unités d’organisation subordonnées dans la hiérarchie des unités d'organisation |
| limite | Le nombre maximum d'enregistrements à inclure dans la réponse. |
| idScheme | Propriété d'identifiant utilisée pour les objets de métadonnées dans la réponse. |
| dataSetIdScheme (Schéma de l'identifiant de l'ensemble de données) | Propriété d'identifiant utilisée pour les ensembles de données dans la réponse. Elle remplace le schéma de l'identifiant. |
| orgUnitIdScheme | Propriété d'identifiant utilisée pour les unités d'organisation dans la réponse. Elle remplace le schéma de l'identifiant. |
| attributOptionComboIdScheme (Schéma de l'identifiant de la combinaison d'options d'attribut) | Propriété d'identifiant utilisée pour les combinaisons d'options d'attribut dans la réponse. Elle remplace le schéma de l'identifiant. |
Les paramètres ensemble de données et unité d'organisation peuvent être répétés afin d'inclure plusieurs ensembles de données et unités d'organisation. |
Les paramètres période, date de début, date de fin, créé et durée de création fournissent plusieurs façons de définir la dimension temporelle de la requête, donc un seul peut être utilisé. Par exemple, cela n'a pas de sens de définir à la fois la date de début/fin et les périodes.
Voici donc un exemple de requête :
GET /api/33/completeDataSetRegistrations?dataSet=pBOMPrpg1QX
  &startDate=2014-01-01&endDate=2014-01-31&orgUnit=YuQRtpLP10I
  &orgUnit=vWbkYPRmKyS&children=true
Vous pouvez obtenir la réponse au format xml et json. Vous pouvez indiquer le format de réponse que vous préférez via l'en-tête HTTP Accepter comme dans l'exemple ci-dessus. Pour xml, utilisez application/xml ; pour json, utilisez application/json.
Cette section explique comment annuler l'enregistrement de la complétude d'un ensemble de données. Pour annuler la finalisation d'un ensemble de données, vous interagirez avec la ressource completeDataSetRegistrations :
GET /api/33/completeDataSetRegistrations
Cette ressource prend en charge la fonction DELETE pour annuler l'inscription. Les paramètres de requête suivants sont pris en charge :
Tableau : Paramètres de requête d'enregistrement d'ensembles de données complets
| Paramètre de requête | Obligatoire | Description |
|---|---|---|
| ds | Oui | Identifiant de l'ensemble de données |
| pe | Oui | Identifiant de période |
| ou | Oui | Identifiant de l'unité d'organisation |
| cc | Non (doit combiner avec cp) | Identifiant de la combinaison d'attributs (pour le contrôle du verrouillage) |
| cp | Non (doit combiner avec cp) | Identifiants d'options d'attribut, séparés par ; pour plusieurs valeurs (pour le contrôle du verrouillage) |
| multiOu (unités d'organisation multiples) | Non (faux par défaut) | Si l'enregistrement s'applique aux sous-unités |
Cette section explique comment approuver, désapprouver et vérifier le statut d'approbation en utilisant la ressource dataApprovals. L'approbation se fait par flux d'approbation des données, par période, par unité d'organisation et par combinaison d'options d'attribut.
/api/33/dataApprovals
Un processus d'approbation des données est associé à plusieurs entités :
Pour obtenir des informations sur l'approbation d'un ensemble de données, vous pouvez envoyer une requête GET :
/api/dataApprovals?wf=rIUL3hYOjJc&pe=201801&ou=YuQRtpLP10I
Tableau : Paramètres de requête pour l'approbation des données
| Paramètre de requête | Obligatoire | Description |
|---|---|---|
| wf | Oui | Identifiant du flux d'approbation des données |
| pe | Oui | Identifiant de période |
| ou | Oui | Identifiant de l'unité d'organisation |
| aoc | Non | Identifiant de combinaison d'options d'attributs |
Remarque
Pour des raisons de compatibilité en amont, le paramètre
dspour l'ensemble de données peut être donné à la place dewfpour le flux de travail dans cette requête d'approbation de données et dans d'autres, comme décrit ci-dessous. Si l'ensemble de données est donné, le flux de travail associé à cet ensemble de données sera utilisé.
Vous obtiendrez une réponse similaire à celle-ci :
{
" peutApprouver " : faux,
" peutDésapprouver " : faux,
" peutAccepter " : faux,
" peutRefuser " : faux,
" status " : " APPROUVÉ_ICI ",
" approuvéPar " : "Utilisateur A",
" approuvéÀ " : "2022-01-13T12:56:07.005",
" acceptéPar " : "Utilisateur A",
" AcceptéÀ " : "2022-01-13T12:56:07.005"
}
Les paramètres renvoyés sont les suivants :
Tableau : Paramètres obtenus pour l'approbation des données
| Paramètre de retour | Description |
|---|---|
| peutApprouver | Si l'utilisateur actuel peut approuver cette sélection de données. |
| peutDésapprouver | Si l'utilisateur actuel peut désapprouver cette sélection de données. |
| peutAccepter | Si l'utilisateur actuel peut accepter cette sélection de données. |
| peutRefuser | Si l'utilisateur actuel peut refuser cette sélection de données. |
| state | L'un des états d'approbation des données est indiqué dans le tableau ci-dessous. |
| approuvéPar | Si la sélection est approuvée, et si disponible (pas toujours nécessaire), le nom de l'utilisateur qui a approuvé la sélection. |
| approuvéÀ | Si la sélection est approuvée, et si disponible (pas toujours nécessaire), la date et l'heure à laquelle le niveau d'approbation le plus élevé a été créé. |
| acceptéPar | Si la sélection est approuvée, et si disponible (pas toujours nécessaire), le nom de l'utilisateur qui a effectué la dernière mise à jour. |
| acceptéÀ | Si la sélection est approuvée, et si disponible (pas toujours nécessaire), la date et l'heure de la dernière mise à jour du niveau d'approbation le plus élevé. |
Tableau : États d'approbation des données
| État | Description |
|---|---|
| NON APPROUVÉ | L'approbation des données ne s'applique pas à cette sélection. (Les données ne sont ni approuvées ni non approuvées). |
| NON APPROUVÉ_EN ATTENTE | Les données pourraient être approuvées pour cette sélection, mais elles attendent une approbation de niveau inférieur avant d'être prêtes à être approuvées. |
| NON APPROUVÉ_AUTRE PART | Les données ne sont pas approuvées et attendent d'être approuvées à un autre endroit (elles ne peuvent pas être approuvées ici). |
| NON APPROUVÉ_ PRÊT | Les données ne sont pas approuvées et sont prêtes à être approuvées pour cette sélection. |
| APPROUVÉ_ICI | Les données sont approuvées et ont été approuvées ici (elles pourraient donc être non approuvées ici). |
| APPROUVÉ_AUTRE PART | Les données sont approuvées, mais n'ont pas été approuvées ici (et ne peuvent donc pas être non approuvées ici) : * Les données sont approuvées à un niveau supérieur. * Les données sont approuvées pour un plus grand nombre d'options de catégories. * Les données sont approuvées pour toutes les sous-périodes de la période sélectionnée. Dans les deux premiers cas, il existe un seul objet d'approbation des données qui couvre la sélection. Dans le troisième cas, il n'y en a pas. |
| ACCEPTÉ_ICI | Les données sont approuvées et acceptées ici (elles pourraient donc être non approuvées ici). |
| ACCEPTÉ_AUTRE PART | Les données sont approuvées et acceptées, mais à un autre endroit. |
Notez que lorsque vous demandez l'état de l'approbation des données, vous pouvez spécifier toute combinaison de paramètres de requête. La combinaison que vous spécifiez ne doit pas nécessairement décrire l'emplacement où les données doivent être approuvées à l'un des niveaux d'approbation. Par exemple :
L'unité d'organisation peut ne pas être à un niveau d'approbation. Le statut d'approbation est déterminé par le fait que les données sont approuvées à un niveau d'approbation pour un ascendant de l'unité d'organisation.
Vous pouvez spécifier des options de catégories d'attribut individuelles. Le statut d'approbation est déterminé par le fait que les données sont approuvées pour une combinaison d'options de catégorie d'attributs qui comprend une ou plusieurs de ces options.
Vous pouvez spécifier une période plus longue que celle de l'ensemble de données, au cours de laquelle les données sont saisies et approuvées. Le statut d'approbation est déterminé par l'approbation des données pour toutes les périodes de l'ensemble de données au cours de la période spécifiée.
Pour les ensembles de données associés à une combinaison de catégories, il est possible de récupérer les enregistrements d'approbation des données pour les combinaisons d'options d'attributs individuels à partir de la ressource suivante, au moyen d'une requête GET :
/api/dataApprovals/categoryOptionCombos?wf=rIUL3hYOjJc&pe=201801&ou=YuQRtpLP10I
Pour obtenir une liste de plusieurs statuts d'approbation, vous pouvez envoyer une requête GET similaire à celle-ci :
/api/dataApprovals/approvals?wf=rIUL3hYOjJc&pe=201801,201802&ou=YuQRtpLP10I
Les paramètres wf, pe, ou, et aoc sont les mêmes que pour obtenir un statut d'approbation unique, sauf que vous pouvez fournir une liste séparée par des virgules d'une ou plusieurs valeurs pour chaque paramètre.
Vous obtiendrez une réponse contenant une liste de paramètres d'approbation et de statuts, comme suit :
[
  {
    "aoc": "HllvX50cXC0",
    "pe": "201801",
    "niveau": "KaTJLhGmU95",
    "ou": "YuQRtpLP10I",
    "permissions": {
      "peutApprouver": faux,
      "peutDésapprouver": vrai,
      "peutAccepter": vrai,
      "peutRefuser": faux,
      "peutLirelesdonnées": vrai,
      "approuvéPar": "Utilisateur A",
      "approuvéÀ": "2022-01-13T12:56:07.005",
      "acceptéPar": "Utilisateur A",
      "acceptéPar": "2022-01-13T12:56:07.005"
    },
    "statut": "APPROUVÉ_ICI",
    "wf": "rIUL3hYOjJc"
  },
  {
    "aoc": "HllvX50cXC0",
    "pe": "201802",
    "ou": "YuQRtpLP10I",
    "permissions": {
      "peutApprouver": vrai,
      "peutDésapprouver": faux,
      "peutAccepter": faux,
      "peutRefuser": faux,
      "peutLirelesdonnées":  vrai
    },
    "statut": "DÉSAPPROUVÉ_PRÊT",
    "wf": "rIUL3hYOjJc"
  }
]
Les champs obtenus sont décrits dans le tableau ci-dessous.
| Champ | Description |
|---|---|
| aoc | Identifiant de combinaison d'options d'attributs |
| pe | Identifiant de période |
| ou | Identifiant d'unité d'organisation |
| autorisations | Les autorisations : mêmes définitions que pour l'obtention d'un statut d'approbation unique (voir le tableau Paramètres d'approbation des données renvoyés). |
| state | Un des états d'approbation des données (comme pour obtenir un statut d'approbation unique.) |
| wf | Identifiant du flux d'approbation des données |
Pour approuver des données, vous pouvez envoyer une requête POST à la ressource dataApprovals. Pour annuler l'approbation des données, vous pouvez envoyer une requête DELETE à la ressource dataApprovals.
POST DELETE /api/33/dataApprovals
Pour accepter des données déjà approuvées, vous pouvez envoyer une requête POST à la ressource Acceptationdesdonnées. Pour annuler l'acceptation de données, vous pouvez envoyer une requête DELETE à la ressource Acceptationdesdonnées.
POST DELETE /api/33/dataAcceptances
Ces requête contiennent les paramètres suivants :
Tableau : Paramètres d'action pour l'approbation des données
| Paramètres d'action | Obligatoire | Description |
|---|---|---|
| wf | Oui | Identifiant du flux d'approbation des données |
| pe | Oui | Identifiant de période |
| ou | Oui | Identifiant de l'unité d'organisation |
| aoc | Non | Identifiant de combinaison d'options d'attributs |
Notez que, contrairement à la requête sur le statut d'approbation des données, vous devez spécifier des paramètres qui correspondent à une sélection de données susceptibles d'être approuvées. Plus précisément, les deux éléments suivants doivent être définis sur "true" :
Le niveau de l'unité d'organisation doit être spécifié par un niveau d'approbation dans le flux de travail.
La période spécifiée doit correspondre au type de période du flux de travail.
Vous pouvez approuver un ensemble d'enregistrements de données en envoyant une requête POST à la ressource /api/dataApprovals/approvals.
POST /api/33/dataApprovals/approvals
Vous pouvez approuver un ensemble d'enregistrements de données en envoyant une requête POST à la ressource /api/dataApprovals/approvals.
POST /api/33/dataApprovals/unapprovals
Vous pouvez accepter un grand nombre d'enregistrements en envoyant une requête POST à la ressource /api/dataAcceptances/acceptances.
POST /api/33/dataAcceptances/acceptances
Vous pouvez refuser un ensemble d'enregistrements en envoyant une requête POST à la ressource /api/dataAcceptances/acceptances.
POST /api/33/dataAcceptances/unacceptances
La charge d'approbation est utilisée au format JSON et ressemble à ceci :
{
  "wf": [
    "pBOMPrpg1QX", "lyLU2wR22tC"
  ],
  "pe": [
    "201601", "201602"
  ],
  "approvals": [
    {
      "ou": "cDw53Ej8rju",
      "aoc": "ranftQIH5M9"
    },
    {
      "ou": "cDw53Ej8rju",
      "aoc": "fC3z1lcAW5x"
    }
  ]
}
Pour récupérer les flux de travail d'approbation des données et leurs niveaux d'approbation, vous pouvez effectuer une requête GET similaire à celle-ci :
/api/dataApprovalWorkflows ?
  fields=id,name,periodType,dataApprovalLevels[id,name,level,orgUnitLevel]
F_FLUX DE TRAVAIL_ DE L' APPROBATION_DES DONNÉES : permet à l'utilisateur d'ajouter/mettre à jour le flux de travail relatif à l'approbation des données.F_NIVEAU_D'APPROBATION DES_DONNÉES : permet à l'utilisateur d'ajouter/mettre à jour le niveau d'approbation des données.La solution de partage vous permet de partager la plupart des objets du système avec des groupes d'utilisateurs spécifiques et de définir si les objets doivent être accessibles au public ou privés. Pour obtenir et définir le statut de partage des objets, vous pouvez interagir avec la ressource de partage.
/api/33/sharing
Pour demander le statut de partage d'un objet, faites une requête GET à :
/api/33/sharing?type=dataElement&id=fbfJHSPpUQD
La réponse se présente comme suit.
{
  "meta": {
    "autoriserl'accèspublic": vrai,
    "autoriserl'accèsexterne": faux
  },
  "objet": {
    "id": "fbfJHSPpUQD",
    "nom": "CPN 1ère visite",
    "accèspublic": "rw------",
    "accèsexterne": faux,
    "utilisateur": {},
    "accès au groupe d'utilisateurs": [
      {
        "id": "hj0nnsVsPLU",
        "accès": "rw------"
      },
      {
        "id": "qMjBflJMOfB",
        "accès": "r-------"
      }
    ]
  }
}
Vous pouvez définir le statut de partage d'un objet en utilisant la même URL avec une requête POST, où la charge utile au format JSON ressemble à ceci :
{
  "objet": {
    "accèspublic": "rw------",
    "accèsexterne": faux,
    "utilisateur": {},
    "accès au groupe d'utilisateurs": [
      {
        "id": "hj0nnsVsPLU",
        "accès": "rw------"
      },
      {
        "id": "qMjBflJMOfB",
        "accès": "r-------"
      }
    ]
  }
}
Dans cet exemple, la charge utile définit l'objet comme ayant un accès public en lecture et en modification, aucun accès externe (sans connexion), un accès en lecture et en modification à un groupe d'utilisateurs et un accès en lecture uniquement à un autre groupe d'utilisateurs. Vous pouvez soumettre ceci à la ressource de partage en utilisant curl :
curl -d @sharing.json "localhost/api/33/sharing?type=dataElement&id=fbfJHSPpUQD"
-H "Content-Type:application/json" -u admin:district
Il est possible de créer des combinaisons de partage surprenantes. Par exemple, si
accèsexterneest défini àvraimais queaccèspublicest défini à--------, les utilisateurs n'auront accès à l'objet que lorsqu'ils seront déconnectés.
Depuis la version 2.36, une nouvelle propriété partage a été introduite afin de remplacer les anciennes propriétés de partage accès utilisateur, accès groupe utilisateur, accès public, accès externe dans toutes les classes de métadonnées pour lesquelles le partage est activé. Cet objet Partage est sauvegardé en tant que colonne JSONB dans la base de données. Cependant, afin de rendre le système compatible avec les anciennes versions, les anciens objets de partage continuent de fonctionner normalement, à la fois pour l'importation et l'exportation. Dans le backend, les données de partage seront sauvegardées dans la nouvelle colonne JSONb Partage au lieu des anciennes tables *Accès.
Le format est le suivant :
{
"nom": "CPN 1ère visite",
"accès public": "rw------",
"accès externe": faux,
"accès aux groupes d'utilisateurs": [
{
"accès": "r-r-----",
"groupe d'utilisateur Uid": "Rg8wusV7QYi",
"nom d'affichage": "Coordinateurs du programme VIH",
"id": "Rg8wusV7QYi"
}
],
"accès utilisateur": [],
"utilisateur": {
"nom d'affichage": "Tom Wakiki",
"nom": "Tom Wakiki",
"id": "GOLswS44mh8",
"Nom d'utilisateur": "système"
},
"partage": {
"propriétaire": "GOLswS44mh8",
"externe": faux,
"utilisateurs": {},
"groupes d'utilisateurs": {
"Rg8wusV7QYi": {
"accès": "r-r-----",
"id": "Rg8wusV7QYi"
}
},
"public": "rw------"
}
}
Vous pouvez utiliser JSON Patch API pour mettre à jour le partage d'un objet en envoyant une requête PATCH à ce point de terminaison avec l'en-tête Type de contenu : application/json-patch+json
api/dataElements/fbfJHSPpUQD
partage. La charge utile au format JSON ressemble à ceci : [
{
"op": "remplacer",
"chemin d'accès": "/partage/utilisateurs",
"valeur": {
"NOOF56dveaZ": {
"accès": "rw------",
"id": "NOOF56dveaZ"
},
"Kh68cDMwZsg": {
"accès": "rw------",
"id": "Kh68cDMwZsg"
}
}
}
]
partage d'un objet comme suit [
{
"op": "ajouter",
"chemin d'accès": "/partage/utilisateurs",
"valeur": {
"NOOF56dveaZ": {
"accès": "rw------",
"id": "NOOF56dveaZ"
},
"Kh68cDMwZsg": {
"accès": "rw------",
"id": "Kh68cDMwZsg"
}
}
}
]
partage comme ceci [
{
"op": "ajouter",
"chemin d'accès": "/partage/utilisateurs/NOOF56dveaZ",
"valeur": {
"accès": "rw------",
"id": "NOOF56dveaZ"
}
}
]
partage comme suit [
{
"op": "supprimer",
"chemin d'accès": "/partage/utilisateurs/N3PZBUlN8vq"
}
]
partage en cascade est disponible pour les tableaux de bord. Cette fonction copie les Accès utilisateur et Accès groupe d'utilisateurs d'un tableau de bord vers tous les objets de ses Éléments de tableau de bord, y compris une Carte, un Rapport d'événement, un Graphique d'événement, une Visualisation. MODIFIER_LES METADONNEES. Les accès d'utilisateur et accès de groupe d'utilisateur copiés recevront uniquement la permission LECTURE_DES METADONNEES. Accèspublic du tableau de bord n'est pas copié.Accès public activée, alors il sera ignoré et ne recevra pas les Accès utilisateur ou les Accès groupe d'utilisateurs du tableau de bord.LECTURE_DE METADONNEES sur tous les objets cibles. Si ce n'est pas le cas, l'erreur E5001 est déclenchée.MODIFIER_LES METADONNEES pour mettre à jour n'importe quel objet cible. Si un objet cible doit être mis à jour et que l'utilisateur n'a pas cette permission, l'erreur E3001 est déclenchée.METADONNEES_LECTURE_MODIFIER. accès public désactivé et ne sont pas partagés avec l'utilisateur A.LECTURE_DE METADONNEES à la Visualisation A et à l'Élément de Données A.POST au point de terminaison api/dashboards/cascadeSharing/{dashboardUID}
| Nom | Par défaut | Description |
|---|---|---|
| dryRun | false | Si ce paramètre est fixé à vrai, la fonction de partage en cascade sera exécutée sans mettre à jour aucun objet. La réponse comprendra les erreurs éventuelles et tous les objets qui seront mis à jour. Cela permet à l'utilisateur de connaître le résultat avant d'exécuter la fonction de partage en cascade. |
| atomic | false | Si ce paramètre est fixé à vrai, alors la fonction de partage en cascade s'arrêtera et ne mettra à jour aucun objet s'il y a une erreur. Sinon, si cette valeur est fausse, la fonction essaiera de procéder avec le mode du best effort (meilleur effort). |
Exemple de réponse :
{
"rapports d'erreur": [
{
"message": "Pas d'objet correspondant à la référence. L'identificateur était s46m5MS0hxu, et l'objet était l'élément de données .",
"mainKlass": "org.hisp.dhis.dataelement.DataElement",
"code d'erreur": "E5001",
"Propriétés de l'erreur": [
"s46m5MS0hxu",
"élément de données "
]
}
],
"countUpdatedDashBoardItems": 1,
"mettre à jour les objets": {
"élément de données ": [
{
"id": "YtbsuPPo010",
"nom": "Dose de rougeole administrée"
},
{
"id": "l6byfWFUGaP",
"nom": "Doses de fièvre jaune administrées"
}
]
}
}
Rapports d'erreurs : inclut toutes les erreurs survenues au cours du processus de partage en cascade.countUpdatedDashBoardItems : Nombre d'éléments du tableau de bord qui seront ou ont été mis à jour, en fonction du mode dryRun.updateObjects (Mise à jour des objets): Liste de tous les objets qui seront ou ont été mis à jour en fonction du mode dryRun.PATCH doivent utiliser l'en-tête Content-type:application/json-patch+json/api/{object-type}/sharing avec une requête PATCHapi/{object-type}/{uid}. Par exemple, vous pouvez toujours mettre à jour le partage d'un Élément de Données en envoyant une requête PATCH à api/dataElements/cYeuwXTCPkU/sharingExemple:
curl -X PATCH -d @payload.json -H "Content-Type: application/json-patch+json" "https://play.dhis2.org/dev/api/dataElements/sharing"
/api/metadata/sharing with PATCH requestExemple:
curl -X PATCH -d @payload.json -H "Content-Type: application/json-patch+json" "https://play.dhis2.org/dev/api/metadata/sharing"
| Nom | Par défaut | Description |
|---|---|---|
| atomic | false | Si ce paramètre est fixé sur vrai, la fonction de traitement par lots s'arrête et ne met à jour aucun objet en cas d'erreur. Sinon, si ce paramètre est fixé sur faux, la fonction essaye de procéder en mode " best effort " (meilleur effort). |
/api/metadata.La charge utile pour un seul type d'objet utilisant /api/{type objet}/partage se présente comme suit
{
"dataSets":[
"cYeuwXTCPkU",
"aYeuwXTCPkU"
],
"patch":[
{
"op":"add",
"path":"/sharing/users/DXyJmlo9rge",
"value":{
"access":"rw------",
"id":"DXyJmlo9rge"
}
},
{
"op":"remove",
"path":"/sharing/users/N3PZBUlN8vq"
}
]
}
La charge utile pour plusieurs types d'objets en une seule charge utile en utilisant api/métadonnée/partage
{
"dataElements": {
"fbfJHSPpUQD": [
{
"op": "replace",
"path": "/sharing/users",
"value": {
"NOOF56dveaZ": {
"access": "rw------",
"id": "CotVI2NX0rI"
},
"Kh68cDMwZsg": {
"access": "rw------",
"id": "DLjZWMsVsq2"
}
}
}
]
},
"dataSets": {
"cYeuwXTCPkA": [
{
"op": "remove",
"path": "/sharing/users/N3PZBUlN8vq"
}
],
"cYeuwXTCPkU": [
{
"op": "add",
"path": "/sharing/users/DXyJmlo9rge",
"value": {
"access": "rw------",
"id": "DXyJmlo9rge"
}
}
]
},
"programs": {
"GOLswS44mh8": [
{
"op": "add",
"path": "/sharing/userGroups",
"value": {
"NOOF56dveaZ": {
"access": "rw------",
"id": "NOOF56dveaZ"
},
"Kh68cDMwZsg": {
"access": "rw------",
"id": "Kh68cDMwZsg"
}
}
}
]
}
}
Pour obtenir une liste de tous les types de tâches disponibles, vous pouvez utiliser le endpoint suivant :
GET /api/jobConfigurations/jobTypes
La réponse contient des informations sur chaque type de tâche, notamment le nom, le type de tâche, la clé, le type de planification et les paramètres disponibles. Le type de planification peut être soit CRON, ce qui signifie que les tâches peuvent être planifiées à l'aide d'une expression cron avec le champ cronExpression, soit FIXED_DELAY, ce qui signifie que les tâches peuvent être planifiées pour s'exécuter avec un délai fixe entre les deux avec le champ delay. Le champ delay est exprimé en secondes.
Une réponse ressemblera à ceci :
{
"jobTypes": [
{
"name": "Data integrity",
"jobType": "DATA_INTEGRITY",
"key": "dataIntegrityJob",
"schedulingType": "CRON"
}, {
"name": "Resource table",
"jobType": "RESOURCE_TABLE",
"key": "resourceTableJob",
"schedulingType": "CRON"
}, {
"name": "Continuous analytics table",
"jobType": "CONTINUOUS_ANALYTICS_TABLE",
"key": "continuousAnalyticsTableJob",
"schedulingType": "FIXED_DELAY"
}
]
}
DHIS2 permet de planifier des tâches de différents types. Chaque type de tâche possède des propriétés de configuration différentes, ce qui vous permet de contrôler plus finement la façon dont les tâches sont exécutées. En outre, vous pouvez configurer une même tâche de manière à ce qu'elle s'exécute avec différentes configurations et à différents intervalles, si nécessaire.
Tableau : Principales propriétés
| Propriété | Description | Type |
|---|---|---|
| name | Nom de la tâche. | Chaîne |
| expression cron | L'expression cron qui définit l'intervalle d'exécution de la tâche. | Chaîne (expression Cron) |
| type de tâches | Le type de tâche représente la tâche qui est exécutée. Le tableau suivant donne un aperçu des types de tâches existants. Chaque type de tâche peut avoir un ensemble spécifique de paramètres pour la configuration de la tâche. | Chaîne (Enum) |
| paramètres de tâches | Paramètres de tâches, le cas échéant pour le type de tâche. | (Voir la liste des types de tâches) |
| activé | Une tâche peut être ajoutée au système sans être programmée en mettant enabled à false dans la charge utile JSON. Utilisez ceci si vous voulez arrêter temporairement la programmation d'une tâche, ou si la configuration d'une tâche n'est pas encore terminée. | Booléen |
Tableau : Paramètres des tâches de DATA_INTEGRITY.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
contrôles | tableau de chaînes | [] = tous | noms des contrôles à effectuer dans l'ordre d'exécution |
type | énumération | RAPPORT | RAPPORT, RÉSUMÉ ou DÉTAILS |
Tableau : Paramètres des tâches de ANALYTICS_TABLE.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
années précédentes | int | vide | Number of years back to include. No value means all years. |
Ignorer les types de tableau | tableau de enum | [] | Omettre la génération de tableaux ; Valeurs possibles : VALEUR_DONNÉE, COMPLÉTUDE, COMPLÉTUDE_CIBLE, UNITÉ_D'ORGANISATION_CIBLE, ÉVÉNEMENT, INSCRIPTION, RÉSULTAT DE_VALIDATION |
Ignorer les tableaux ressources | booléen | faux | Ignorer la génération des tableaux de ressources |
Ignorer les Programmes | tableau de chaînes | [] | Liste facultative de programmes (d'identifiants) à ignorer |
Tableau : Paramètres des tâches de CONTINUOUS_ANALYTICS_TABLE.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
années précédentes | int | vide | Number of years back to include. No value means all years. |
Ignorer les types de tableau | tableau de enum | [] | Omettre la génération de tableaux ; Valeurs possibles : VALEUR_DONNÉE, COMPLÉTUDE, COMPLÉTUDE_CIBLE, UNITÉ_D'ORGANISATION_CIBLE, ÉVÉNEMENT, INSCRIPTION, RÉSULTAT DE_VALIDATION |
Mise à jour complète de l'heure de la journée | int | 0 | Heure de la journée pour la mise à jour complète des tableaux d'analyse (0-23) |
Tableau : Paramètres des tâches de DATA_SYNC.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
pageSize | int | 10000 | nombre de valeurs de données traitées en tant qu'unité |
| Nom | Type | Par défaut | Description |
|---|---|---|---|
pageSize | int | 60 | number of events processed as a unit. Minimum 5, maximum 200. |
| Nom | Type | Par défaut | Description |
|---|---|---|---|
pageSize | int | 60 | number of tracked entities processed as a unit. Minimum 5, maximum 200. |
Tableau : Paramètres des tâches de META_DATA_SYNC.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
Taille de la page des données | int | 10000 | nombre de valeurs de données traitées en tant qu'unité |
Tableau : Paramètres des tâches MONITORING (Analyse des règles de validation)
| Nom | Type | Par défaut | Description |
|---|---|---|---|
début relatif | int | 0 | Un nombre lié à la date d'exécution qui correspond au début de la période à suivre. |
fin relative | int | 0 | Un nombre lié à la date d'exécution qui correspond à la fin de la période à suivre. |
groupes de règles de validation | tableau de chaînes | [] | Groupes de règles de validation (UID) à inclure dans la tâche |
envoyer une notification | booléen | faux | Définir sur true si la tâche doit envoyer des notifications basées sur les groupes de règles de validation |
persiste les résultats | booléen | faux | Définir sur true si la tâche doit persister les résultats de la validation. |
Tableau : Paramètres des tâches de PUSH_ANALYSIS.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
analyse push | tableau de chaînes | [] | Les UID des analyses push que vous souhaitez exécuter |
Tableau : Paramètres des tâches de PREDICTOR.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
début relatif | int | 0 | Un nombre lié à la date d'exécution qui correspond au début de la période à suivre. |
fin relative | int | 0 | Un nombre lié à la date d'exécution qui correspond au début de la période à suivre. |
Les prédicteurs | tableau de chaînes | [] | Prédicteurs (UID) à inclure dans la tâche |
groupes de prédicteurs | tableau de chaînes | [] | Groupes de prédicteurs (UID) à inclure dans la tâche |
Tableau : Paramètres des tâches de MATERIALIZED_SQL_VIEW_UPDATE.
| Nom | Type | Par défaut | Description |
|---|---|---|---|
vues sql | tableau de chaînes | [] | Les UID des vues SQL mises à jour par la tâche. |
Pour configurer les tâches, vous pouvez envoyer une requête POST à la ressource suivante :
/api/jobConfigurations
Une tâche sans paramètres au format JSON ressemble à ceci :
{
"name": "",
"jobType": "JOBTYPE",
"cronExpression": "0 * * ? * *",
}
Exemple d'un tableau d'analyse de tâches avec des paramètres au format JSON :
{
"name": "Analytics tables last two years",
"jobType": "ANALYTICS_TABLE",
"cronExpression": "0 * * ? * *",
"jobParameters": {
"lastYears": "2",
"skipTableTypes": [],
"skipResourceTables": false
}
}
Exemple d'une tâche d'analyse push avec des paramètres au format JSON :
{
"name": "Push anlysis charts",
"jobType": "PUSH_ANALYSIS",
"cronExpression": "0 * * ? * *",
"jobParameters": {
"pushAnalysis": [
"jtcMAKhWwnc"
]
}
}
Exemple de tâche avec le type de planification FIXED_DELAY et un délai de 120 secondes :
{
"name": "Continuous analytics table",
"jobType": "CONTINUOUS_ANALYTICS_TABLE",
"delay": "120",
"jobParameters": {
"fullUpdateHourOfDay": 4
}
}
Liste de toutes les configurations de tâches :
GET /api/jobConfigurations
Récupérer une tâche :
GET /api/jobConfigurations/{id}
Le contenu de la réponse se présente comme suit :
{
"lastUpdated": "2018-02-22T15:15:34.067",
"id": "KBcP6Qw37gT",
"href": "http://localhost:8080/api/jobConfigurations/KBcP6Qw37gT",
"created": "2018-02-22T15:15:34.067",
"name": "analytics last two years",
"jobStatus": "SCHEDULED",
"displayName": "analytics last two years",
"enabled": true,
"externalAccess": false,
"jobType": "ANALYTICS_TABLE",
"nextExecutionTime": "2018-02-26T03:00:00.000",
"cronExpression": "0 0 3 ? * MON",
"jobParameters": {
"lastYears": 2,
"skipTableTypes": [],
"skipResourceTables": false
},
"favorite": false,
"configurable": true,
"access": {
"read": true,
"update": true,
"externalize": true,
"delete": true,
"write": true,
"manage": true
},
"lastUpdatedBy": {
"id": "GOLswS44mh8"
},
"favorites": [],
"translations": [],
"userGroupAccesses": [],
"attributeValues": [],
"userAccesses": []
}
Mettre à jour une tâche avec des paramètres en utilisant le endpoint et le format de charge JSON suivants :
PUT /api/jobConfigurations/{id}
{
"name": "analytics last two years",
"enabled": true,
"cronExpression": "0 0 3 ? * MON",
"jobType": "ANALYTICS_TABLE",
"jobParameters": {
"lastYears": "3",
"skipTableTypes": [],
"skipResourceTables": false
}
}
Supprimer une tâche en utilisant :
DELETE /api/jobConfigurations/{id}
Notez que certaines tâches avec des paramètres de configuration personnalisés peuvent ne pas être ajoutées si les paramètres système requis ne sont pas configurés. C'est le cas par exemple de la synchronisation des données, qui nécessite la configuration d'un serveur distant.
Les tâches peuvent être exécutées manuellement à l'aide de :
POST /api/jobConfigurations/{id}/execute
Since version 2.41 jobs can store errors of the job run to allow inspection at a later point in time.
Note This feature is only accessible for administrator with the
F_JOB_LOG_READauthority and superusers.
To view the errors associated with a specific job use:
GET /api/jobConfigurations/{id}/errors
To search for jobs that match user specified search criteria use:
GET /api/jobConfigurations/errors
with one or more of the following search parameters
user: include jobs ran by this userfrom: include jobs that started after this point in timeto: include jobs that did not start later than this point in timecode: include jobs that have errors with one of the given error codesobject: include jobs that have errors linked to one of the given object IDstype: include job with errors of the specified type(s)When multiple criteria are used all have to be met (AND logic). If multiple code, object or type parameters are given just one has to match (OR logic).
For example, to find tracker import errors for the 1. of January 2024 with error code E1002 (tracked entity already exists) the following search is made:
GET /api/jobConfigurations/errors?type=TRACKER_IMPORT_JOB&code=E1002&from=2024-01-01&to=2024-01-02
The results show the job run error details. By default, the input (the payload of the impport) is excluded from the results. To include it add includeInput=true:
GET /api/jobConfigurations/errors?includeInput=true
Note Not all job types do store their errors. Currently, this feature is mostly supported by import jobs.
Alors que /api/jobConfigurations est centré sur les objets de configuration des tâches l'API /api/scheduler reflète l'état du programmateur et l'API /api/scheduling fournit des informations sur la progression des tâches.
Les étapes et l'état d'exécution peuvent être observés pendant que la tâche est en cours. Une liste de tous les types de tâches en cours d'exécution est fournie par :
GET /api/scheduling/running/types
Pour obtenir un aperçu de toutes les tâches en cours d'exécution par type de tâche, utilisez :
GET /api/scheduling/running
Comme il ne peut y avoir qu'une seule tâche en cours pour chaque type à la fois, l'état d'une tâche en cours peut être visualisé en détail à l'aide de la commande suivante:
GET /api/scheduling/running/{type}
Par exemple, pour voir l'état d'une tâche ANALYTICS_TABLE en cours d'exécution, utilisez
GET /api/scheduling/running/ANALYTICS_TABLE
Une tâche est une séquence de processus. Chaque processus comporte une séquence d'étapes Dans chaque étape, il peut y avoir zéro, un ou plusieurs éléments. Les éléments peuvent être traités de manière strictement séquentielle ou parallèle, n éléments à la fois. Souvent, le nombre d'éléments total est souvent connu à l'avance.
En général, les étapes d'un processus et les éléments d'une étape sont « découverts » en tant qu'« effet secondaire » du traitement des données. Alors que la plupart des processus ont une séquence fixe d'étapes, certains processus peuvent avoir des étapes variables en fonction des données traitées. Les éléments dépendent généralement des données. La plupart des travaux ne comprennent qu'un seul processus.
Chacun des nœuds de l'arbre processus-étape-élément a un statut qui est soit * RUNNING (en cours de traitement) : le traitement est en cours (pas encore terminé) * SUCCESS (succès) : lorsque le traitement est terminé avec succès * ERROR (erreur) : lorsque le traitement est terminé avec des erreurs ou lorsqu'une exception s'est produite * CANCELLED (annulé) : lorsque l'annulation a été demandée et que l'élément ne sera pas terminé.
Une fois qu'une tâche s'est achevée avec succès ou avec un échec à la suite d'une exception ou d'une annulation, l'état passe de l'ensemble des états d'exécution aux états des tâches achevées. Cet ensemble ne conserve que l'état d'exécution le plus récent pour chaque type de tâche. L'aperçu est disponible à l'adresse suivante :
GET /api/scheduling/completed
Des détails sur un type de tâche particulier sont donc fournis à l'adresse suivante :
GET /api/scheduling/completed/{type}
Dans le cas de la tâche ANALYTICS_TABLE, ce serait :
GET /api/scheduling/completed/ANALYTICS_TABLE
Une fois qu'une tâche est lancée, elle se déroule selon une séquence d'étapes. Chaque étape peut à son tour comporter des collections d'éléments à traiter. Bien que les tâches ne puissent généralement pas être arrêtées à tout moment, nous pouvons demander une annulation et le processus s'arrête de manière coopérative une fois qu'il a terminé un élément ou une étape et qu'il reconnaît qu'une annulation a été demandée. Cela signifie que les tâches ne s'arrêtent pas immédiatement et ne partent pas à un moment inconnu en plein milieu d'un traitement. Au contraire, elles s'arrêtent lorsqu'il est possible de passer à la fin. Cela signifie toujours que le processus global est inachevé et qu'il n'est pas annulé. Il se peut qu'il ait simplement effectué un certain nombre d'étapes et en ait sauté d'autres à la fin.
Pour annuler une tâche en cours, utilisez :
POST /api/scheduling/cancel/{type}
Par exemple, pour annuler l'exécution de la tâche ANALYTICS_TABLE :
POST /api/scheduling/cancel/ANALYTICS_TABLE
En fonction de l'étape en cours et de l'élément exécuté, l'annulation peut prendre de quelques millisecondes à quelques minutes avant d'être effective. Cependant, le statut de l'ensemble du processus sera affiché comme ANNULÉ immédiatement après avoir été vérifié à l'aide de
GET /api/scheduling/running/ANALYTICS_TABLE
Seuls les tâches qui ont été scindées en processus, étapes et éléments peuvent être annulées de manière efficace. Toutes les tâches n'ont pas encore été scindées. Celles-ci seront exécutées jusqu'à leur terme, même si l'annulation a été demandée.
When a server shuts down while a job is in RUNNING state the job needs to be reverted back to its initial state manually.
To revert a job that has RUNNING state but is not running use:
POST /api/jobConfigurations/{uid}/revert
Des séquences de tâches (configurations) peuvent être créées à l'aide de files d'attente. La file d'attente utilise toujours un nom unique et un déclencheur d'expression CRON. Une fois qu'une file d'attente est lancée, toutes les tâches qu'elle contient sont exécutées dans l'ordre indiqué. La deuxième file d'attente démarre lorsque la première est terminée, et ainsi de suite.
Pour répertorier les noms uniques des files d'attente existantes, utilisez :
GET /api/scheduler/queues
La réponse est un tableau de noms :
["queue_a", "queue_b"]
Pour obtenir tous les détails d'une file d'attente spécifique, utilisez :
GET /api/scheduler/queues/{name}
Les détails comprennent son nom, l'expression CRON et la séquence de la tâche :
{
"name": "myQ",
"cronExpression": "0 0 1 ? * *",
"sequence": ["FgAxa6eRSzQ", "BeclVERfWbg" ]
}
Pour créer une nouvelle file d'attente, envoyez une requête POST avec un objet de charge utile portant le nom, l'expression CRON et la séquence de tâches :
POST /api/scheduler/queues/{name}
Pour créer une file d'attente avec le nom myQ, utilisez un POST vers /api/scheduler/queues/myQ :
{
"cronExpression": "0 0 1 ? * *",
"sequence": ["FgAxa6eRSzQ", "BeclVERfWbg" ]
}
nom peut également être présent dans la charge utile, mais le nom spécifié dans le chemin d'accès à l'URL est prioritaire. REMARQUE
L'expression cron de toutes les configurations de tâches, sauf la première dans une file d'attente, est effacée car elles n'ont plus de déclencheur propre. Elle doit être restaurée manuellement lorsqu'une tâche est supprimée d'une file d'attente.
Pour mettre à jour une expression ou une séquence CRON existante, utilisez une requête PUT.
PUT /api/scheduler/queues/{name}
La charge utile doit contenir à la fois une nouvelle expression CRON et une séquence de tâches, comme dans l'exemple ci-dessus pour créer une nouvelle file d'attente.
To rename a queue the new name can be stated in the payload, while the old name is used in the URL path.
Pour supprimer une file d'attente, envoyez une demande de suppression (DELETE) à l'URL de sa ressource :
DELETE /api/scheduler/queues/{name}
REMARQUE
La suppression d'une file d'attente n'entraîne pas la suppression des configurations de tâches référencées. Toute configuration de tâches supprimée d'une file d'attente, soit en modifiant la séquence, soit en supprimant la file d'attente, est désactivée. Pour l'utiliser individuellement, il faut fournir une expression CRON et réactiver la configuration.
La planification au sein du programmateur est une liste basée sur les configurations et les files d'attente de tâches. Une saisie dans le calendrier est soit une simple configuration de tâches, soit une file d'attente de tâches. Les deux sont représentés par le même format de saisie.
Pour obtenir la liste du programmateur, utilisez :
GET /api/scheduler
Une configuration de tâche dans cette liste se présente comme suit :
{
"name": "User account expiry alert",
"type": "ACCOUNT_EXPIRY_ALERT",
"cronExpression": "0 0 2 ? * *",
"nextExecutionTime": "2023-03-15T02:00:00.000",
"status": "SCHEDULED",
"enabled": true,
"configurable": false,
"sequence": [
{
"id": "fUWM1At1TUx",
"name": "User account expiry alert",
"type": "ACCOUNT_EXPIRY_ALERT",
"cronExpression": "0 0 2 ? * *",
"nextExecutionTime": "2023-03-15T02:00:00.000",
"status": "SCHEDULED"
}
]
}
séquence ne comporte qu'un seul élément. Les informations sur l'objet de premier niveau et l'objet de la séquence proviennent toutes deux de la configuration de la tâche. Une file d'attente dans la liste se présente comme suit :
{
"name": "myQ",
"type": "Sequence",
"cronExpression": "0 0 1 ? * *",
"nextExecutionTime": "2023-03-15T01:00:00.000",
"status": "SCHEDULED",
"enabled": true,
"configurable": true,
"sequence": [
{
"id": "FgAxa6eRSzQ",
"name": "test Q1",
"type": "ANALYTICS_TABLE",
"cronExpression": "0 0 1 ? * *",
"nextExecutionTime": "2023-03-15T01:00:00.000",
"status": "SCHEDULED"
},
{
"id": "BeclVERfWbg",
"name": "est Q2",
"type": "DATA_INTEGRITY",
"status": "SCHEDULED"
}
]
}
Toutes les configurations de tâches ne peuvent pas être ajoutées à une file d'attente. Les tâches système et les tâches qui font déjà partie d'une file d'attente ne peuvent pas être utilisées dans une autre file d'attente. Pour répertorier les configurations de tâches qui peuvent faire partie de n'importe quelle file d'attente, utilisez :
GET /api/scheduler/queueable
Pour dresser la liste des configurations de tâches qui peuvent faire partie d'une file d'attente particulière, utilisez :
GET /api/scheduler/queueable?name={queue}
Cela exclura également toutes les tâches qui font déjà partie de la file d'attente nommée.
Cette section traite des opérations 'pull' et 'push' sur les données et les métadonnées.
Pour lancer une opération push (envoi) d'une valeur de données vers un serveur distant, il faut d'abord configurer l'URL et les informations d'identification du serveur concerné dans Paramètres du système > Synchronisation, puis envoyer une requête POST à la ressource suivante :
/api/33/synchronization/dataPush
Pour lancer une opération pull (extraction) de métadonnées à partir d'un document JSON distant, vous pouvez effectuer une requête POST avec un url comme charge à la ressource suivante :
/api/33/synchronization/metadataPull
Note
The supplied URL will be checked against the config property
metadata.sync.remote_servers_allowedin thedhis.conffile. If the base URL is not one of the configured servers allowed then the operation will not be allowed. See failure example below.
Some examples where the config set ismetadata.sync.remote_servers_allowed=https://server1.org/,https://server2.org/- supplyhttps://server1.org/path/to/resource-> this will be accepted - supplyhttps://server2.org/resource/path-> this will be accepted - supplyhttps://oldserver.org/resource/path-> this will be rejectedSample failure response
{
"httpStatus": "Conflict",
"httpStatusCode": 409,
"status": "ERROR",
"message": "Provided URL is not in the remote servers allowed list",
"errorCode": "E1004"
}
Pour vérifier la disponibilité du serveur de données distant et les informations d'identification de l'utilisateur, vous pouvez envoyer une requête GET à la ressource suivante :
/api/33/synchronization/availability
DHIS2 audite les mises à jour et les suppressions de valeurs de données agrégées, de valeurs de données d'entités suivies, de valeurs d'attributs d'entités suivies et d'enregistrements d'approbation de données. Cette section explique comment récupérer les enregistrements d'audit pour les entités mentionnées. Plusieurs paramètres de requête peuvent être répétés autant de fois que nécessaire.
Le point d'extrémité des audits de valeurs de données agrégées se trouve ici :
/api/audits/dataValue
Tableau : Paramètres de requête pour les valeurs de données agrégées
| Paramètre | Option | Description |
|---|---|---|
| ds | ID de l'ensemble de données | Un ou plusieurs identifiants d'ensembles de données pour obtenir des éléments de données |
| de | ID de l'élément de données | Un ou plusieurs identifiants d'éléments de données |
| pe | Période ISO | Un ou plusieurs identifiants ISO de période |
| ou | Identifiant de l'unité d'organisation | Un ou plusieurs identifiants d'unité d'organisation |
| auditType | UPDATE | DELETE |
| skipPaging | false | true |
| pagination | false | true | Activer ou désactiver la pagination |
| page | Numéro | Numéro de page (par défaut 1) |
| pageSize | Numéro | Taille de la page (par défaut 50) |
Exemple : Obtenir les audits pour un ensemble de données lyLU2wR22tC et un type d'audit CREATE ou UPDATE :
/api/33/audits/dataValue?ds=lyLU2wR22tC&auditType=CREATE,UPDATE
Exemple : Obtenir les audits pour l'élément de données BOSZApCrBni, l'unité d'organisation DiszpKrYNg8 et la combinaison d'options de catégorie TkDhg29x18A :
/api/33/audits/dataValue?de=BOSZApCrBni&ou=DiszpKrYNg8&co=TkDhg29x18A
Une fois que l'audit est activé pour les entités suivies (en réglant allowAuditLog des types d'entités suivies sur true), toutes les opérations de lecture et de recherche sont enregistrées. Le point d'extrémité pour accéder aux journaux d'audit se trouve ici :
/api/audits/trackedEntity
Tableau : Paramètres de requête pour les audits d'entités suivies
| Paramètre | Option | Description |
|---|---|---|
| trackedEntities | Uid d'entités suivies | Un ou plusieurs identifiants d'entités suivies (séparés par des virgules) |
| user | Utilisateur | Un ou plusieurs identifiants d'utilisateur |
| auditType | SEARCH | READ |
| startDate | Date de début | Date de début des audits au format aaaa-mm-jj. |
| endDate | Date de fin | Date de fin des audits au format aaaa-mm-jj. |
| skipPaging | false | true |
| pagination | false | true | Détermine s'il faut activer ou désactiver la pagination |
| page | Numéro | Numéro de page (par défaut 1) |
| pageSize | Numéro | Taille de la page (par défaut 50) |
Exemple : Obtenir les audits de type READ avec startDate 2018-03-01 et endDate 2018-04-24 avec une taille de page de 5 :
/api/33/audits/trackedEntity.json?startDate=2021-03-01&endDate=2022-04-24&auditType=READ&pageSize=5
Exemple : Obtenir les audits de l'entité suivie wNiQ2coVZ39 :
/api/33/audits/trackedEntity.json?trackedEntities=wNiQ2coVZ39
Une fois que l'audit est activé pour les instances d'entités suivies (en réglant allowAuditLog des types d'entités suivies sur true), toutes les opérations de lecture et de recherche sont enregistrées. Le point d'extrémité pour accéder aux journaux d'audit se trouve ici :
/api/audits/trackedEntityInstance
Tableau : Paramètres de requête pour les instances d'audit d'entités suivies
| Paramètre | Option | Description |
|---|---|---|
| trackedEntities | Uid d'entités suivies | Un ou plusieurs identifiants d'entités suivies (séparés par des virgules) |
| user | Utilisateur | Un ou plusieurs identifiants d'utilisateur |
| auditType | SEARCH | READ |
| startDate | Date de début | Date de début des audits au format aaaa-mm-jj. |
| endDate | Date de fin | Date de fin des audits au format aaaa-mm-jj. |
| skipPaging | false | true |
| pagination | false | true | Détermine s'il faut activer ou désactiver la pagination |
| page | Numéro | Numéro de page (par défaut 1) |
| pageSize | Numéro | Taille de la page (par défaut 50) |
Exemple : Obtenir les audits de type READ avec startDate 2018-03-01 et endDate 2018-04-24 avec une taille de page de 5 :
/api/33/audits/trackedEntityInstance.json?startDate=2021-03-01&endDate=2022-04-24&auditType=READ&pageSize=5
Exemple : Obtenir les audits de l'entité suivie wNiQ2coVZ39 :
/api/33/audits/trackedEntityInstance.json?trackedEntities=wNiQ2coVZ39
Le point d'extrémité des audits d'approbation de données se trouve ici :
/api/audits/dataApproval
Tableau : Paramètres de requête pour l'approbation des données
| Paramètre | Option | Description |
|---|---|---|
| dal | ID du niveau d'approbation des données | Un ou plusieurs identifiants de niveau d'approbation des données |
| wf | ID du flux d'approbation des données | Un ou plusieurs identifiants de flux d'approbation des données |
| ou | Identifiant de l'unité d'organisation | Un ou plusieurs identifiants d'unité d'organisation |
| aoc | ID de la combinaison d'options d'attribut | Un ou plusieurs identifiants de combinaison d'options d'attribut |
| startDate | Date de début | Date de début des approbations au format aaaa-mm-jj. |
| endDate | Date de fin | Date de fin des approbations au format aaaa-mm-jj. |
| skipPaging | false | true |
| page | Numéro | Numéro de page (par défaut 1) |
| pageSize | Numéro | Taille de la page (par défaut 50) |
Exemple : Obtenir les audits pour le flux d'approbation des données i5m0JPw4DQi :
/api/33/audits/dataApproval?wf=i5m0JPw4DQi
Exemple : Obtenir les audits entre 2021-01-01 et 2022-01-01 pour l'unité d'organisation DiszpKrYNg8 :
/api/33/audits/dataApproval?ou=DiszpKrYNg8&startDate=2021-01-01&endDate=2022-01-01
DHIS2 dispose d'un mécanisme permettant d'envoyer des messages à des fins tels que le retour d'information des utilisateurs, les notifications et les informations générales à l'intention des utilisateurs. Les messages sont regroupés en conversations. Pour interagir avec les conversations de messages, vous pouvez envoyer des requêtes POST et GET à la ressource messageConversations.
/api/33/messageConversations
Les messages sont transmis à la boîte de réception DHIS2, mais ils peuvent également être envoyés aux adresses électroniques et aux téléphones portables de l'utilisateur sous forme de SMS. Dans cet exemple, nous verrons comment utiliser l'API Web pour envoyer, lire et gérer des messages. Nous allons nous faire passer pour l'utilisateur Administrateur DHIS2 et envoyer un message à l'utilisateur Mobile. Nous allons ensuite nous faire passer pour l'utilisateur mobile et lire notre nouveau message. Ensuite, nous allons gérer la boîte de réception de l'utilisateur administrateur en marquant et en supprimant des messages.
La ressource avec laquelle nous devons interagir pour envoyer et lire des messages est la ressource messageConversations. Nous commençons par visiter le point d'entrée de l'API Web à l'adresse http://play.dhis2.org/demo/api, où nous trouvons et suivons le lien vers la ressource messageConversations à l'adresse http://play.dhis2.org/demo/api messageConversations. La description nous indique que nous pouvons utiliser une requête POST pour créer un nouveau message en utilisant le format XML suivant pour l'envoyer à plusieurs utilisateurs :
<message xmlns="http://dhis2.org/schema/dxf/2.0">
<subject>Voici le sujet</subject>
<text>Voici le texte</text>
<users>
<user id="user1ID" />
<user id="user2ID" />
<user id="user3ID" />
</users>
</message>
Pour l'envoi à tous les utilisateurs appartenant à un ou plusieurs groupes d'utilisateurs, nous pouvons utiliser :
<message xmlns="http://dhis2.org/schema/dxf/2.0">
<subject>Voici le sujet</subject>
<text>Voici le texte</text>
<userGroups>
<userGroup id="userGroup1ID" />
<userGroup id="userGroup2ID" />
<userGroup id="userGroup3ID" />
</userGroups>
</message>
Pour l'envoi à tous les utilisateurs connectés à une ou plusieurs unités d'organisation, nous pouvons utiliser :
<message xmlns="http://dhis2.org/schema/dxf/2.0">
<subject>Voici le sujet</subject>
<text>Voici le texte</text>
<organisationUnits>
<organisationUnit id="ou1ID" />
<organisationUnit id="ou2ID" />
<organisationUnit id="ou3ID" />
</organisationUnits>
</message>
Puisque nous voulons envoyer un message à notre ami l'utilisateur mobile, nous devons rechercher son identifiant. Nous le faisons en allant au point d'entrée de l'API Web et en suivant le lien vers la ressource utilisateurs à /api/users. Nous continuons en suivant le lien vers l'utilisateur mobile à /api/users/PhzytPW3g2J où nous apprenons que son identifiant est PhzytPW3g2J. Nous sommes maintenant prêts à rassembler nos messages XML pour former un message dans lequel nous voulons demander à l'utilisateur mobile s'il a déclaré des données pour janvier 2014 :
<message xmlns="http://dhis2.org/schema/dxf/2.0">
<subject>Rapport sur les données de mortalité</subject>
<text>Avez-vous déclaré des données pour l'ensemble de données sur la mortalité pour janvier 2014 ?</text>
<users>
<user id="PhzytPW3g2J" />
</users>
</message>
Pour le tester, nous enregistrons le contenu XML dans un fichier appelé message.xml. Nous utilisons cURL pour envoyer le message à l'instance de démonstration DHIS2 où nous indiquons que le type de contenu est XML et où nous nous authentifions en tant qu'utilisateur admin :
curl -d @message.xml "https://play.dhis2.org/demo/api/messageConversations"
-H "Content-Type:application/xml" -u admin:district -X POST
La charge correspondante en JSON et la commande POST ressemblent à ceci :
{
"subject": "Hey",
"text": "How are you?",
"users": [
{
"id": "OYLGMiazHtW"
},
{
"id": "N3PZBUlN8vq"
}
],
"userGroups": [
{
"id": "ZoHNWQajIoe"
}
],
"organisationUnits": [
{
"id": "DiszpKrYNg8"
}
]
}
curl -d @message.json "https://play.dhis2.org/demo/api/33/messageConversations"
-H "Content-Type:application/json" -u admin:district -X POST
Si tout se passe bien, nous recevons un code de statut HTTP 201 Créé. Notez également que nous recevons un en-tête HTTP Localisation qui nous informe de l'URL de la ressource de conversation de messages nouvellement créée - celle-ci peut être utilisée par un utilisateur pour effectuer d'autres actions.
Nous allons maintenant nous faire passer pour l'utilisateur mobile et lire le message qui vient d'être envoyé en envoyant une requête GET à la ressource messageConversations. Nous fournissons un en-tête Accepter avec l'application/xml comme valeur pour indiquer que nous sommes intéressés par la représentation de la ressource XML et nous nous authentifions en tant qu'utilisateur mobile :
curl "https://play.dhis2.org/demo/api/33/messageConversations"
-H "Accept:application/xml" -u mobile:district
En réponse, nous obtenons le fichier XML suivant :
<messageConversations xmlns="http://dhis2.org/schema/dxf/2.0"
link="https://play.dhis2.org/demo/api/messageConversations">
<messageConversation name="Mortality data reporting" id="ZjHHSjyyeJ2"
link="https://play.dhis2.org/demo/api/messageConversations/ZjHHSjyyeJ2"/>
<messageConversation name="DHIS2 version 2.7 is deployed" id="GDBqVfkmnp2"
link="https://play.dhis2.org/demo/api/messageConversations/GDBqVfkmnp2"/>
</messageConversations>
Dans la réponse, nous pouvons lire l'identifiant du nouveau message envoyé, qui est ZjHHSjyyeJ2. Notez que le lien vers la ressource spécifique est intégré et peut être suivi pour lire le message complet. Une fois que nous connaissons l'URL, nous pouvons répondre directement à une conversation sur un message existant en incluant le texte du message dans la charge de la requête. Nous sommes maintenant en mesure de créer une URL pour envoyer notre réponse :
curl -d "Oui, l'ensemble des données sur la mortalité a été déclaré"
"https://play.dhis2.org/demo/api/messageConversations/ZjHHSjyyeJ2"
-H "Content-Type:text/plain" -u mobile:district -X POST
Si tout s'est déroulé comme prévu, vous recevrez un code de statut 200 OK.
Dans la version 2.30, nous avons ajouté un paramètre de recherche d'URL :
queryString=?&queryOperator=?
Le filtre recherche des correspondances dans l'objet, le texte et les expéditeurs pour les conversations de messages. L'opérateur de requête par défaut est token (jeton), mais d'autres opérateurs peuvent être définis dans la requête.
Au fur et à mesure que les utilisateurs reçoivent et envoient des messages, les conversations commencent à s'empiler dans leur boîte de réception, ce qui devient éventuellement difficile à suivre. Nous allons maintenant voir comment gérer la boîte de réception des messages d'un utilisateur en supprimant et en marquant des conversations par l'intermédiaire de la Web-API. Pour ce faire, nous allons effectuer quelques opérations de maintenance dans la boîte de réception de l'utilisateur « Administrateur DHIS ».
Commençons par supprimer quelques messages de la boîte de réception. Notez bien que toutes les opérations de suppression décrites ici ne suppriment que la relation entre un utilisateur et une conversation de messages. En termes pratiques, cela signifie que nous ne supprimons pas les messages eux-mêmes (ni aucun contenu d'ailleurs) mais que nous supprimons simplement le fil de messages de l'utilisateur de sorte qu'il ne soit plus listé dans la ressource /api/messageConversations.
Pour supprimer une conversation de messages de la boîte de réception d'un utilisateur, nous devons envoyer une requête DELETE à la ressource identifiée par l'identifiant de la conversation de messages et l'utilisateur participant. Par exemple, pour supprimer l'utilisateur avec l'identifiant xE7jOejl9FI de la conversation avec l'identifiant jMe43trzrdi :
curl "https://play.dhis2.org/demo/api/33/messageConversations/jMe43trzrdi
Si la demande a abouti, le serveur répondra par un 200 OK. Le corps de la réponse contient un objet XML ou JSON (selon l'en-tête "accepter" de la demande) contenant l'identifiant de l'utilisateur supprimé.
{
"removed" : ["xE7jOejl9FI"]
}
En cas d'échec, l'objet renvoyé contiendra un message qui décrit l'erreur.
{
"message" : "No user with uid: dMV6G0tPAEa"
}
Le lecteur observateur aura déjà remarqué que l'objet renvoyé en cas de succès dans notre exemple est en fait une liste d'identifiants (contenant une seule entrée). Ceci est dû au fait que le endpoint prend également en charge les suppressions par lots. La requête est faite à la même ressource messageConversations mais suit une sémantique légèrement différente. Pour les opérations par lots, les identifiants de conversation sont donnés en tant que paramètres de la chaîne de requête. L'exemple suivant supprime deux conversations de messages distinctes pour l'utilisateur actuel :
curl "https://play.dhis2.org/demo/api/messageConversations?mc=WzMRrCosqc0&mc=lxCjiigqrJm"
-X DELETE -u admin:district
Si vous disposez d'autorisations suffisantes, vous pouvez supprimer des conversations au nom d'un autre utilisateur en indiquant un paramètre facultatif, l'identifiant de l'utilisateur.
curl "https://play.dhis2.org/demo/api/messageConversations?mc=WzMRrCosqc0&mc=lxCjiigqrJm&user=PhzytPW3g2J"
-X DELETE -u admin:district
Comme indiqué, les suppressions par lots renvoient le même format de message que pour les opérations individuelles. La liste des objets supprimés reflétera les suppressions effectuées avec succès. Les demandes partiellement erronées (c'est-à-dire les identifiants inexistants) n'annuleront donc pas l'ensemble de l'opération par lots.
Les messages comportent une propriété booléenne read (lire). Cette propriété permet de savoir si un utilisateur a vu (ouvert) un message ou non. Dans un scénario d'application typique (par exemple, le portail web DHIS2), un message est marqué comme lu dès que l'utilisateur l'ouvre pour la première fois. Cependant, les utilisateurs peuvent vouloir gérer le statut « lu » ou « non lu » de leurs messages afin de garder une trace de certaines conversations.
Le marquage des messages comme lus ou non lus suit une sémantique similaire à celle des suppressions de lots, et supporte également les opérations par lots. Pour marquer des messages comme lus, nous envoyons un POST à la ressource messageConversations/read avec un corps de requête contenant un ou plusieurs identifiants de message. Pour marquer des messages comme non lus, nous envoyons une requête identique à la ressource messageConversations/unread. Comme pour les suppressions, un paramètre de requête optionnel utilisateur peut être fourni.
Marquons quelques messages comme lus par l'utilisateur actuel :
curl "https://play.dhis2.org/dev/api/messageConversations/read"
-d '["ZrKML5WiyFm","Gc03smoTm6q"]' -X POST
-H "Content-Type: application/json" -u admin:district
La réponse est un 200 OK avec le contenu JSON suivant :
{
"markedRead": ["ZrKML5WiyFm", "Gc03smoTm6q"]
}
Vous pouvez ajouter des destinataires à une conversation de messages existante. La ressource est située à l'adresse suivante :
/api/33/messageConversations/id/recipients
Les options de cette ressource sont une liste d'utilisateurs, de groupes d'utilisateurs et d'unités d'organisation. La requête doit ressembler à ceci :
{
"users": [
{
"id": "OYLGMiazHtW"
},
{
"id": "N3PZBUlN8vq"
}
],
"userGroups": [
{
"id": "DiszpKrYNg8"
}
],
"organisationUnits": [
{
"id": "DiszpKrYNg8"
}
]
}
La création de messages avec des pièces jointes se fait en deux étapes : le téléchargement du fichier dans la ressource attachments (pièces jointes), puis inclure un ou plusieurs pièces jointes lors de la création d'un nouveau message.
Une requête POST à la ressource attachments téléchargera le fichier sur le serveur.
curl -F file=@attachment.png "https://play.dhis2.org/demo/api/messageConversations/attachments"
-u admin:district
La demande renvoie un objet qui représente la pièce jointe. L'identifiant de cet objet doit être utilisé lors de la création d'un message afin de lier la pièce jointe au message.
{
"created": "2018-07-20T16:54:18.210",
"lastUpdated": "2018-07-20T16:54:18.212",
"externalAccess": false,
"publicAccess": "--------",
"user": {
"name": "John Traore",
"created": "2013-04-18T17:15:08.407",
"lastUpdated": "2018-03-09T23:06:54.512",
"externalAccess": false,
"displayName": "John Traore",
"favorite": false,
"id": "xE7jOejl9FI"
},
"lastUpdatedBy": {
"id": "xE7jOejl9FI",
"name": "John Traore"
},
"favorite": false,
"id": "fTpI4GOmujz"
}
Lors de la création d'un nouveau message, les identifiants peuvent être transmis dans le contenu de la requête pour lier les fichiers téléchargés au message en cours de création.
{
"subject": "Hey",
"text": "How are you?",
"users": [
{
"id": "OYLGMiazHtW"
},
{
"id": "N3PZBUlN8vq"
}
],
"userGroups": [
{
"id": "ZoHNWQajIoe"
}
],
"organisationUnits": [
{
"id": "DiszpKrYNg8"
}
],
"attachments": [
"fTpI4GOmujz",
"h2ZsOxMFMfq"
]
}
Lorsque vous répondez à un message, les identifiants peuvent être transmis en tant que paramètre de la requête.
curl -d "Oui, l'ensemble des données sur la mortalité a été déclaré"
"https://play.dhis2.org/demo/api/33/messageConversations/ZjHHSjyyeJ2?attachments=fTpI4GOmujz,h2ZsOxMFMfq"
-H "Content-Type:text/plain" -u mobile:district -X POST
Une fois qu'un message avec une pièce jointe a été créé, il est possible d'accéder à la pièce jointe à l'aide d'une requête GET à l'URL suivante :
/api/messageConversations/<mcv-id>/<msg-id>/attachments/<attachment-id>
Où
Vous pouvez utiliser l'outil « écrire un feedback » pour créer des tickets et des messages. La seule différence entre un ticket et un message est que vous pouvez donner un statut et une priorité à un ticket. Pour définir le statut :
POST /api/messageConversations/<uid>/status
Pour définir la priorité :
POST /api/messageConversations/<uid>/priority
Dans la version 2.29, les messages générés par l'analyse de validation peuvent désormais être utilisés dans les propriétés de statut et de priorité. Par défaut, les messages générés par l'analyse de validation héritent de la priorité de la règle de validation en question, ou de la plus grande importance si le message contient plusieurs règles.
Dans la version 2.30, les règles de validation peuvent être affectées à n'importe quel utilisateur, alors que les tickets doivent toujours être affectés à un utilisateur appartenant au groupe des destinataires du retour d'information du système.
Tableau : Liste des valeurs de statut et de priorité valides
| Statut | Priorité |
|---|---|
| OUVRIR | BAS |
| EN ATTENTE | MOYEN |
| INVALIDE | ÉLEVÉ |
| RÉSOLU |
Vous pouvez également ajouter un message interne à un ticket, qui ne peut être vu que par les utilisateurs ayant les permissions « Gérer les tickets ». Pour créer une réponse interne, vous devez inclure le paramètre « interne » et le définir sur:
curl -d "Ceci est un message interne"
"https://play.dhis2.org/demo/api/33/messageConversations/ZjHHSjyyeJ2?internal=true"
-H "Content-Type:text/plain" -u admin:district -X POST
Le tableau de bord est conçu pour vous donner un aperçu de plusieurs éléments analytiques tels que des cartes, des graphiques, des tableaux croisés dynamiques et des rapports qui, ensemble, peuvent fournir un aperçu complet de vos données. Les tableaux de bord sont disponibles dans l'API Web via la ressource tableaux de bord. Un tableau de bord contient une liste d'éléments de tableau de bord. Un élément peut représenter une ressource unique, comme un graphique, une carte ou un tableau de rapport, ou représenter une liste de liens vers des ressources analytiques, comme des rapports, des ressources, des rapports tabulaires et des utilisateurs. Un élément de tableau de bord peut contenir jusqu'à huit liens. En règle générale, un client de tableau de bord peut choisir de visualiser les éléments à objet unique directement dans une interface utilisateur, tout en rendant les éléments à objets multiples sous forme de liens cliquables.
/api/tableau de bord
Pour obtenir une liste de vos tableaux de bord avec des informations de base telles que l'identifiant, le nom et le lien au format JSON, vous pouvez envoyer une requête GET à l'URL suivante :
/api/dashboards.json
La ressource Tableaux de bord fournit une liste de tableaux de bord. N'oubliez pas que l'objet tableau de bord est partagé et que la liste sera donc affectée par l'utilisateur actuellement authentifié. Vous pouvez obtenir plus d'informations sur un tableau de bord spécifique en suivant son lien, comme suit :
/api/dashboards/vQFhmLJU5sK.json
Un tableau de bord contient des informations telles que le nom et la date de création, ainsi qu'un tableau d'éléments du tableau de bord. La réponse au format JSON ressemblera à cette réponse (certaines informations ont été supprimées par souci de concision).
{
"lastUpdated" : "2013-10-15T18:17:34.084+0000",
"id": "vQFhmLJU5sK",
"created": "2013-09-08T20:55:58.060+0000",
"name": "Mother and Child Health",
"href": "https://play.dhis2.org/demo/api/dashboards/vQFhmLJU5sK",
"publicAccess": "--------",
"restrictFilters": false,
"externalAccess": false,
"itemCount": 17,
"displayName": "Mother and Child Health",
"access": {
"update": true,
"externalize": true,
"delete": true,
"write": true,
"read": true,
"manage": true
},
"user": {
"id": "xE7jOejl9FI",
"name": "John Traore",
"created": "2013-04-18T15:15:08.407+0000",
"lastUpdated": "2014-12-05T03:50:04.148+0000",
"href": "https://play.dhis2.org/demo/api/users/xE7jOejl9FI"
},
"dashboardItems": [{
"id": "bu1IAnPFa9H",
"created": "2013-09-09T12:12:58.095+0000",
"lastUpdated": "2013-09-09T12:12:58.095+0000"
}, {
"id": "ppFEJmWWDa1",
"created": "2013-09-10T13:57:02.480+0000",
"lastUpdated": "2013-09-10T13:57:02.480+0000"
}],
"layout": {
"spacing": {
"column": 5,
"row": 5
},
"columns": [{
"index": 0,
"span": 2
}, {
"index": 1,
"span": 1
}]
},
"userGroupAccesses": []
}
Il est possible d'obtenir une réponse plus personnalisée en spécifiant des champs particuliers dans la demande. Un exemple est fourni ci-dessous, qui renverrait des informations plus détaillées sur chaque objet du tableau de bord d'un utilisateur.
/api/dashboards/vQFhmLJU5sK/?fields=:all,dashboardItems[:all]
Lorsqu'un utilisateur crée un tableau de bord, il est pratique de pouvoir rechercher diverses ressources analytiques à l'aide des ressources /dashboards/q ou /dashboards/search. Ces ressources vous permettent de rechercher des correspondances sur la propriété de nom des objets suivants : visualisations, cartes de visualisations d'événements, utilisateurs, rapports et ressources. Vous pouvez effectuer une recherche en effectuant une requête GET sur le modèle d'URL de ressource suivant, où « my-query » doit être remplacé par la requête de recherche préférée :
/api/dashboards/q/my-query.json
/api/dashboards/search?q=my-query
Par exemple, cette requête :
/api/dashboards/q/ma?count=6&maxCount=20&max=REPORT&max=MAP
/api/dashboards/search?q=ma?count=6&maxCount=20&max=REPORT&max=MAP
La recherche portera sur les éléments suivants :
Tableau : tableaux de bord/q et tableaux de bord/paramètres de requête de recherche
| Paramètre de requête | Description | Type | Par défaut |
|---|---|---|---|
| count | Le nombre d'éléments de chaque type à renvoyer | Entier positif | 6 |
| Nombre max. | Le nombre d'éléments de type max à renvoyer | Entier positif | 25 |
| max | Le type pour lequel il faut renvoyer le nombre maximal | Chaîne [CARTE|UTILISATEUR|RAPPORT|RESSOURCE|VISUALISATION#124;VISUALISATION_D'ÉVÉNEMENT,GRAPHIQUE_D'ÉVÉNEMENT,RAPPORT_D'ÉVÉNEMENT] | N/A |
Les formats de réponse JSON et XML sont pris en charge. La réponse au format JSON contiendra les références aux ressources correspondantes et le nombre de correspondances trouvées au total et pour chaque type de ressource. Elle ressemblera à ceci :
{
"visualizations": [{
"name": "ANC: ANC 3 Visits Cumulative Numbers",
"id": "arf9OiyV7df",
"type": "LINE"
}, {
"name": "ANC: 1st and 2rd trends Monthly",
"id": "jkf6OiyV7el",
"type": "PIVOT_TABLE"
}],
"eventVisualizations": [{
"name": "Inpatient: Cases 5 to 15 years this year (case)",
"id": "TIuOzZ0ID0V",
"type": "LINE_LIST"
}, {
"name": "Inpatient: Cases last quarter (case)",
"id": "R4wAb2yMLik",
"type": "LINE_LIST"
}],
"maps": [{
"name": "ANC: 1st visit at facility (fixed) 2013",
"id": "YOEGBvxjAY0"
}, {
"name": "ANC: 3rd visit coverage 2014 by district",
"id": "ytkZY3ChM6J"
}],
"reports": [{
"name": "ANC: 1st Visit Cumulative Chart",
"id": "Kvg1AhYHM8Q"
}, {
"name": "ANC: Coverages This Year",
"id": "qYVNH1wkZR0"
}],
"searchCount": 8,
"visualizationCount": 2,
"eventVisualizationCount": 2,
"mapCount": 2,
"reportCount": 2,
"userCount": 0,
"eventReports": 0,
"eventCharts" :0,
"resourceCount": 0
}
La création, la mise à jour et la suppression des tableaux de bord suivent la sémantique REST standard. Pour créer un nouveau tableau de bord, vous pouvez faire une requête POST à la ressource /api/dashboards. Du point de vue du consommateur, il peut être pratique de créer d'abord un tableau de bord et d'y ajouter ensuite des éléments. Les formats JSON et XML sont supportés pour la charge de la requête. Pour créer un tableau de bord avec le nom « Mon tableau de bord », vous pouvez utiliser une charge JSON comme celle-ci :
{
"nom": "Mon tableau de bord"
}
Pour mettre à jour, par exemple renommer, un tableau de bord, vous pouvez faire une demande PUT avec une charge similaire à la même ressource api/dashboards.
To remove a dashboard, you can make a DELETE (supprimer) request to the specific dashboard resource similar to this:
/api/dashboards/vQFhmLJU5sK
As DashboardItem is an embedded object of Dashboard, all operations must be performed through the /api/dashboards/{uid} endpoint.
To add a visualization to a specific dashboard, send a PUT request to:
/api/dashboards/ChZ236jPgXs
The request payload must include the full Dashboard object, including all existing and new DashboardItems.
{
"name": "test",
"layout": {
"columns": []
},
"itemConfig": {
"insertPosition": "END"
},
"restrictFilters": false,
"allowedFilters": [],
"favorites": [],
"displayName": "test",
"user": {
"id": "xE7jOejl9FI",
"code": null,
"name": "John Traore",
"username": "admin"
},
"id": "ChZ236jPgXs",
"dashboardItems": [
{
"x": 0,
"y": 0,
"w": 20,
"h": 29,
"id": "cKd9PKBuHv6",
"type": "VISUALIZATION",
"position": null,
"visualization": {
"id": "LW0O27b7TdD",
"name": "ANC: 1-3 dropout rate Yearly"
},
"i": "cKd9PKBuHv6",
"minH": 4,
"firstOfType": true,
"width": 20,
"height": 29
}
],
"starred": false
}
To update properties of any item inside a dashboard, send a PUT request to:
/api/dashboards/ChZ236jPgXs
The payload must be the latest Dashboard object, including all its items with the updated property value.
To remove an item from a dashboard, remove it from the Dashboard payload and send a PUT request to:
/api/dashboards/ChZ236jPgXs
Vous pouvez définir et enregistrer une présentation pour chaque tableau de bord. L'objet suivant est chargé de gérer ce paramètre.
{
"layout": {
"spacing": {
"column": 5,
"row": 5
},
"columns": [{
"index": 0,
"span": 2
}, {
"index": 1,
"span": 1
}]
}
}
La définition de la présentation sera appliquée à tous les éléments du tableau de bord liés au tableau de bord donné, en respectant les attributs de présentation tels que l'espacement, les colonnes, la portée, etc. Vous trouverez ci-dessous une brève description de chaque attribut.
Tableau : Attributs de la présentation
| Attribut | Description | Type |
|---|---|---|
| présentation | Ceci est l'objet racine | Objet |
| l'espacement | Il définit l'espacement de certains composants de la présentation. Pour l'instant, il prend en charge les colonnes et les lignes. | Objet |
| colonnes | Il stocke des paramètres spécifiques liés aux colonnes ( pour l'instant, l'index et la portée) | Tableau d'objets |
L'API de visualisation est conçue pour aider les clients à interagir avec les graphiques et les tableaux croisés dynamiques/rapports. Les endpoints de cette API sont utilisés par l'application de visualisation des données qui permet la création, la configuration et la gestion des graphiques et des tableaux croisés dynamiques sur la base des définitions du client. L'idée principale est de permettre aux clients et aux utilisateurs de disposer d'une API unique et centralisée fournissant tous les types de graphiques et de tableaux croisés dynamiques ainsi que des paramètres et une configuration spécifiques pour chaque type de visualisation.
Cette API a été introduite pour unifier les API charts (graphiques) et reportTables (tableaux de rapports) et les remplacer entièrement par l'API visualizations (visualisations).
Un objet de visualisation est composé de nombreux attributs (certains sont liés aux graphiques et d'autres aux tableaux croisés dynamiques), mais les plus importants d'entre eux, qui reflètent les informations essentielles de l'objet, sont les suivants :* "id" (identifiant) , "name" (nom) , "type" (type) , "dataDimensionItems" (éléments de données de dimensions) , "columns" (colonnes) , "rows" (lignes) et "filters" (filtres) .*
Le endpoint racine de l'API est /api/visualizations, et la liste des attributs et éléments actuels est décrite dans le tableau ci-dessous.
Tableau : Attributs de visualisation
| Champ | Description |
|---|---|
| id | L'identifiant unique. |
| code | Un code personnalisé pour identifier la visualisation. |
| name | Le nom de la visualisation |
| type | Le type de visualisation. Les types valides sont les suivants COLONNE, COLONNE_EMPILÉE, BARRE, BARRE_EMPILÉE, LIGNE, ZONE, CIRCULAIRE, RADAR, JAUGE, LIGNE_ANNÉE_SUR_ANNÉE, COLONNE_ANNÉE_SUR_ANNÉE, VALEUR_UNIQUE, TABLEAU_CROISÉ DYNAMIQUE. |
| titre | Un titre personnalisé. |
| sous-titre | Un sous-titre personnalisé. |
| description | Définit une description personnalisée pour la visualisation. |
| created | La date/heure de création de la visualisation. |
| startDate | La date de début utilisée lors du filtrage. |
| endDate | La date de fin utilisée lors du filtrage. |
| sortOrder | L'ordre de tri de cette visualisation. Valeur entière. |
| user | Un objet représentant le créateur de la visualisation. |
| publicAccess (accès public) | Définit les autorisations pour l'accès public. |
| displayDensity (afficher la densité) | La densité du texte affiché. |
| fontSize (taille de la police) | La taille de la police du texte. |
| fontStyle (style de police) | Styles de police personnalisés pour : visualizationTitle (titre de la visualisation), visualizationSubtitle (sous-titre de la visualisation), horizontalAxisTitle (titre de l'axe horizontal), verticalAxisTitle (titre de l'axe vertical), targetLineLabel (étiquette de la ligne cible), baseLineLabel (étiquette de la ligne de base), seriesAxisLabel (étiquette de l'axe de la série), categoryAxisLabel (étiquette de l'axe de la catégorie), légende. |
| périodes relatives | Un objet représentant les périodes relatives utilisées dans la requête analytique. |
| legendSet (ensemble de légende) | Un objet représentant les définitions de la légende. |
| legendDisplayStyle (style d'affichage de légende) | Le style d'affichage de la légende. Il peut être : FILL ( remplit) ou TEXT ( texte). |
| legendDisplayStrategy (stratégie d'affichage de la légende) | Le style d'affichage de la légende. Il peut être : FIXE ou BY_DATA_ITEM (par élément de données). |
| Type d'agrégation | Détermine la manière dont les valeurs du tableau croisé dynamique sont agrégées. Options valides : SUM (somme), AVERAGE (moyenne), AVERAGE_SUM_ORG_UNIT ( somme moyenne des unités d'organisation), LAST (dernier), LAST_AVERAGE_ORG_UNIT (dernière moyenne des unités d'organisation), FIRST (premier), FIRST_AVERAGE_ORG_UNIT (première moyenne des unités d'organisation), COUNT (nombre), STDDEV (écart type), VARIANCE (écart), MIN (minimum), MAX (maximum), NONE (aucun), CUSTOM (personnalisé) ou DEFAULT (par défaut). |
| regressionType (type de régression) | Un type de régression valide : NONE (aucun), LINEAR (linéaire), POLYNOMIAL (polynomial) ou LOESS. |
| targetLineValue (valeur de la ligne cible) | La ligne cible du graphique. Accepte un type Double. |
| targetLineLabel (étiquette de la ligne cible) | L'étiquette de la ligne cible du graphique. |
| rangeAxisLabel (Étiquette de l'axe de la plage ) | L'étiquette/titre de l'axe vertical (y) du graphique. |
| domainAxisLabel (étiquette de l'axe du domaine) | L'étiquette/titre de l'axe horizontal (x) du graphique. |
| rangeAxisMaxValue (Plage de l'axe de la valeur maximale) | La valeur maximale de l'axe du graphique. Les valeurs en dehors de la plage ne seront pas affichées. |
| rangeAxisMinValue (Plage de l'axe de la Valeur minimale) | La valeur minimale de l'axe du graphique. Les valeurs en dehors de la plage ne seront pas affichées. |
| rangeAxisSteps (Étapes de l'axe de la plage) | Le nombre de pas d'axe entre les valeurs minimale et maximale. |
| rangeAxisDecimals (Décimales de l'axe de la plage) | Le nombre de décimales pour les valeurs des axes. |
| baseLineValue (Valeur de la ligne de base) | Une valeur de référence du graphique. |
| baseLineLabel (étiquette de la ligne de base) | Une étiquette de ligne de base du graphique. |
| digitGroupSeparator (Séparateur de groupes de chiffres) | Séparateur de groupes de chiffres. Valeurs valides : VIRGULE, ESPACE ou AUCUN. |
| topLimit (Limite maximale) | La limite maximale fixée pour le tableau croisé dynamique. |
| Critères de mesure | Décrit les critères appliqués à cette mesure. |
| percentStackedValues (Pourcentage des valeurs empilées) | Utilise ou non des valeurs empilées. Plus susceptible d'être utilisé pour les graphiques. Valeur booléenne. |
| noSpaceBetweenColumns (Aucun espace entre les colonnes) | Afficher/masquer l'espace entre les colonnes. Valeur booléenne. |
| régression | Indique si la visualisation contient des colonnes de régression. Plus susceptible de s'appliquer aux rapports/croisés dynamiques. Valeur booléenne. |
| externalAccess (accès externe) | Indique si la visualisation est disponible en lecture seule externe. Ne s'applique que si aucun utilisateur n'est connecté. Valeur booléenne. |
| userOrganisationUnit (Unité d'organisation de l'utilisateur) | Indique si l'utilisateur dispose d'une unité d'organisation. Valeur booléenne. |
| userOrganisationUnitChildren (Unité d'organisation subordonnées de l'utilisateur ) | Indique si l'utilisateur a des unités d'organisation subordonnées. Valeur booléenne. |
| userOrganisationUnitGrandChildren (Unité d'organisation subordonnées de l'utilisateur ) | Indique si l'utilisateur a une unité d'organisation subordonnées. Valeur booléenne. |
| reportingParams (Paramètres de déclaration) | Objet utilisé pour définir des attributs booléens liés à la déclaration. |
| rowTotals (totaux des lignes) | Affiche (ou non) les totaux des lignes. Valeur booléenne. |
| colTotals (totaux des colonnes) | Affiche (ou non) les totaux des colonnes. Valeur booléenne. |
| rowSubTotals (Sous-totaux des lignes) | Affiche (ou non) les sous-totaux des lignes. Valeur booléenne. |
| colSubTotals (Sous-totaux des colonnes) | Affiche (ou non) les sous-totaux des colonnes. Valeur booléenne. |
| cumulativeValues (Valeurs cumulées) | Indique si la visualisation utilise des valeurs cumulées. Valeur booléenne. |
| hideEmptyColumns (cacher les colonnes vides) | Indique s'il faut masquer les colonnes sans données. Valeur booléenne. |
| hideEmptyRows (cacher les lignes vides) | Indique s'il faut masquer les lignes qui ne contiennent pas de données. Valeur booléenne. |
| fixColumnHeaders (fixer les en-têtes de colonne) | Maintient les en-têtes des colonnes fixes (ou non) dans un tableau croisé dynamique. Valeur booléenne. |
| fixRowHeaders (En-tête de ligne fixe) | Conserve les en-têtes des lignes fixes (ou non) dans un tableau croisé dynamique. Valeur booléenne. |
| completedOnly (Terminé uniquement) | Indicateur utilisé dans les requêtes d'analyse. S'il est vrai, seuls les événements/inscriptions terminés seront considérés. Valeur booléenne. |
| skipRounding (ignorer l'arrondissement des valeurs) | Appliquer ou non l'arrondi. Valeur booléenne. |
| showDimensionLabels (afficher les étiquettes de dimension) | Affiche ou non les étiquettes des dimensions. Valeur booléenne. |
| hideTitle (masquer le titre) | Masque ou non le titre. Valeur booléenne. |
| hideSubtitle (masquer le sous-titre) | Masque ou non les sous-titres. Valeur booléenne. |
| hideLegend (masquer la légende) | Affiche/masque la légende. Très probablement utilisé pour les graphiques. Valeur booléenne. |
| showHierarchy (afficher la hiérarchie) | Affiche (ou non) les noms de la hiérarchie des unités d'organisation. Valeur booléenne. |
| showData (afficher les données) | Utilisé par les graphiques pour masquer ou non les données/valeurs dans le modèle présenté. Valeur booléenne. |
| lastUpdatedBy (Dernière mise à jour par) | L'objet qui représente l'utilisateur qui a appliqué les dernières modifications à la visualisation. |
| lastUpdated (dernière mise à jour) | Date/heure de la dernière modification de la visualisation. |
| favoris | Liste des utilisateurs qui ont marqué cet objet comme favori. |
| abonnés | Liste des utilisateurs ayant souscrit à cette visualisation. |
| traductions | Ensemble des traductions d'objets disponibles, normalement filtrées par le paramètre locale. |
| outlierAnalysis (Analyse des valeurs atypiques) | Objet chargé de conserver les paramètres relatifs à l'analyse des valeurs atypiques. L'attribut interne 'outlierMethod' (méthode des valeurs atypiques) prend en charge : IQR, STANDARD_Z_SCORE (SCORE Z STANDARD), MODIFIED_Z_SCORE (SCORE Z MODIFIÉ). L'attribut 'normalizationMethod' (méthode de normalisation) n'accepte pour l'instant que Y_RESIDUALS_LINEAR (RESIDUS LINEAIRE Y). |
| seriesKey (Clé de série) | Options de style pour l'affichage ou non de la clé de série. |
| légende | Options permettant d'appliquer ou non des couleurs de légende à la série de graphiques. |
Pour récupérer une liste de toutes les visualisations existantes, au format JSON, avec quelques informations de base (y compris l'identifiant, le nom et la pagination), vous pouvez faire une requête GET à l'URL ci-dessous. Vous devriez voir une liste de toutes les visualisations publiques/partagées ainsi que vos visualisations privées.
GET /api/visualizations.json
Si vous souhaitez extraire la définition JSON d'une visualisation spécifique, vous pouvez ajouter son identifiant respectif à l'URL :
GET /api/visualizations/hQxZGXqnLS9.json
La représentation suivante est un exemple de réponse au format JSON (par souci de concision, certaines informations ont été supprimées). Pour obtenir le schéma complet, veuillez utiliser GET /api/schemas/visualization.
{
"lastUpdated": "2020-02-06T11:57:09.678",
"href": "http://my-domain/dhis/api/visualizations/hQxZGXqnLS9",
"id": "hQxZGXqnLS9",
"created": "2017-05-19T17:22:00.785",
"name": "ANC: ANC 1st visits last 12 months cumulative values",
"publicAccess": "rw------",
"userOrganisationUnitChildren": false,
"type": "LINE",
"access": {},
"reportingParams": {
"parentOrganisationUnit": false,
"reportingPeriod": false,
"organisationUnit": false,
"grandParentOrganisationUnit": false
},
"dataElementGroupSetDimensions": [],
"attributeDimensions": [],
"yearlySeries": [],
"axes": [
{
"index": 0,
"type": "RANGE",
"title": {
"textMode": "CUSTOM",
"text": "Any Title"
}
}
],
"filterDimensions": [
"dx"
],
"columns": [
{
"id": "ou"
}
],
"dataElementDimensions": [],
"categoryDimensions": [],
"rowDimensions": [
"pe"
],
"columnDimensions": [
"ou"
],
"dataDimensionItems": [
{
"dataDimensionItemType": "DATA_ELEMENT",
"dataElement": {
"id": "fbfJHSPpUQD"
}
}
],
"filters": [
{
"id": "dx"
}
],
"rows": [
{
"id": "pe"
}
]
}
GET /api/visualizations/hQxZGXqnLS9.json?fields=interpretations
renvoie
{
"interpretations": [
{
"id": "Lfr8I2RPU0C"
},
{
"id": "JuwgdJlJPGb"
},
{
"id": "WAoU2rSpyZp"
}
]
}
Comme on peut le voir, le GET ci-dessus ne renverra que les interprétations liées à l'identifiant donné (dans ce cas hQxZGXqnLS9).
Ces opérations suivent la sémantique standard REST. Une nouvelle visualisation peut être créée par une requête POST à la ressource /api/visualisations avec une charge JSON valide. Un exemple de charge pourrait être :
{
"columns": [
{
"dimension": "J5jldMd8OHv",
"items": [
{
"name": "CHP",
"id": "uYxK4wmcPqA",
"displayName": "CHP",
"displayShortName": "CHP",
"dimensionItemType": "ORGANISATION_UNIT_GROUP"
},
{
"name": "Hospital",
"id": "tDZVQ1WtwpA",
"displayName": "Hospital",
"displayShortName": "Hospital",
"dimensionItemType": "ORGANISATION_UNIT_GROUP"
}
]
}
],
"rows": [
{
"dimension": "SooXFOUnciJ",
"items": [
{
"name": "DOD",
"id": "B0bjKC0szQX",
"displayName": "DOD",
"displayShortName": "DOD",
"dimensionItemType": "CATEGORY_OPTION_GROUP"
},
{
"name": "CDC",
"id": "OK2Nr4wdfrZ",
"displayName": "CDC",
"displayShortName": "CDC",
"dimensionItemType": "CATEGORY_OPTION_GROUP"
}
]
}
],
"filters": [
{
"dimension": "ou",
"items": [
{
"name": "Sierra Leone",
"id": "ImspTQPwCqd",
"displayName": "Sierra Leone",
"displayShortName": "Sierra Leone",
"dimensionItemType": "ORGANISATION_UNIT"
},
{
"name": "LEVEL-1",
"id": "LEVEL-H1KlN4QIauv",
"displayName": "LEVEL-1"
}
]
}
],
"name": "HIV Cases Monthly",
"description": "Cases of HIV across the months",
"category": "XY1vwCQskjX",
"showDimensionLabels": true,
"hideEmptyRows": true,
"hideEmptyColumns": true,
"skipRounding": true,
"aggregationType": "SUM",
"regressionType": "LINEAR",
"type": "PIVOT_TABLE",
"numberType": "VALUE",
"measureCriteria": "Some criteria",
"showHierarchy": true,
"completedOnly": true,
"displayDensity": "NORMAL",
"fontSize": "NORMAL",
"digitGroupSeparator": "SPACE",
"legendDisplayStyle": "FILL",
"legendDisplayStrategy": "FIXED",
"hideEmptyRowItems": "BEFORE_FIRST_AFTER_LAST",
"fixColumnHeaders": true,
"fixRowHeaders": false,
"regression": false,
"cumulative": true,
"sortOrder": 1,
"topLimit": 2,
"rowTotals": true,
"colTotals": true,
"hideTitle": true,
"hideSubtitle": true,
"hideLegend": true,
"showData": true,
"percentStackedValues": true,
"noSpaceBetweenColumns": true,
"rowSubTotals": true,
"colSubTotals": true,
"userOrgUnitType": "TEI_SEARCH",
"externalAccess": false,
"publicAccess": "--------",
"reportingParams": {
"reportingPeriod": true,
"organisationUnit": true,
"parentOrganisationUnit": true,
"grandParentOrganisationUnit": true
},
"parentGraphMap": {
"ImspTQPwCqd": ""
},
"access": {
"read": true,
"update": true,
"externalize": true,
"delete": false,
"write": true,
"manage": false
},
"optionalAxes": [
{
"dimensionalItem": "fbfJHSPpUQD",
"axis": 1
},
{
"dimensionalItem": "cYeuwXTCPkU",
"axis": 2
}
],
"relativePeriods": {
"thisYear": false,
"quartersLastYear": true,
"last52Weeks": false,
"thisWeek": false,
"lastMonth": false,
"last14Days": false,
"biMonthsThisYear": false,
"monthsThisYear": false,
"last2SixMonths": false,
"yesterday": false,
"thisQuarter": false,
"last12Months": false,
"last5FinancialYears": false,
"thisSixMonth": false,
"lastQuarter": false,
"thisFinancialYear": false,
"last4Weeks": false,
"last3Months": false,
"thisDay": false,
"thisMonth": false,
"last5Years": false,
"last6BiMonths": false,
"last4BiWeeks": false,
"lastFinancialYear": false,
"lastBiWeek": false,
"weeksThisYear": false,
"last6Months": false,
"last3Days": false,
"quartersThisYear": false,
"monthsLastYear": false,
"lastWeek": false,
"last7Days": false,
"thisBimonth": false,
"lastBimonth": false,
"lastSixMonth": false,
"thisBiWeek": false,
"lastYear": false,
"last12Weeks": false,
"last4Quarters": false
},
"user": {},
"yearlySeries": [
"THIS_YEAR"
],
"userGroupAccesses": [
{
"access": "rwx-----",
"userGroupUid": "ZoHNWQajIoe",
"displayName": "Bo District M&E officers",
"id": "ZoHNWQajIoe"
}
],
"userAccesses": [
{
"access": "--------",
"displayName": "John Barnes",
"id": "DXyJmlo9rge",
"userUid": "DXyJmlo9rge"
}
],
"legendSet": {
"name": "Death rate up",
"id": "ham2eIDJ9k6",
"legends": [
{
"startValue": 1,
"endValue": 2,
"color": "red",
"image": "some-image"
},
{
"startValue": 2,
"endValue": 3,
"color": "blue",
"image": "other-image"
}
]
},
"outlierAnalysis": {
"enabled": true,
"outlierMethod": "IQR",
"thresholdFactor": 1.5,
"normalizationMethod": "Y_RESIDUALS_LINEAR",
"extremeLines": {
"enabled": true,
"value": 3.5
}
},
"legend": {
"strategy": "FIXED",
"style": "FILL",
"set": {
"id": "fqs276KXCXi",
"displayName": "ANC Coverage"
},
"showKey": false
},
"seriesKey": {
"hidden": true,
"label": {
"fontStyle": {
"textColor": "#cccddd"
}
}
},
"axes": [
{
"index": 0,
"type": "RANGE",
"label": {
"fontStyle": {
"textColor": "#cccddd"
}
},
"title": {
"text": "Range axis title",
"textMode": "CUSTOM",
"fontStyle": {
"textColor": "#000000"
}
},
"decimals": 1,
"maxValue": 100,
"minValue": 20,
"steps": 5,
"baseLine": {
"value": 50,
"title": {
"text": "My baseline",
"fontStyle": {
"textColor": "#000000"
}
}
},
"targetLine": {
"value": 80,
"title": {
"text": "My targetline",
"fontStyle": {
"textColor": "#cccddd"
}
}
}
},
{
"index": 1,
"type": "DOMAIN",
"label": {
"fontStyle": {
"textColor": "#000000"
}
},
"title": {
"text": "Domain axis title",
"textMode": "CUSTOM",
"fontStyle": {
"textColor": "#cccddd"
}
}
}
],
"axes": [
{
"index": 0,
"type": "RANGE",
"label": {
"fontStyle": {
"textColor": "#cccddd"
}
},
"title": {
"text": "Range axis title",
"fontStyle": {
"textColor": "#000000"
}
},
"decimals": 1,
"maxValue": 100,
"minValue": 20,
"steps": 5,
"baseLine": {
"value": 50,
"title": {
"text": "My baseline",
"fontStyle": {
"textColor": "#000000"
}
}
},
"targetLine": {
"value": 80,
"title": {
"text": "My targetline",
"fontStyle": {
"textColor": "#cccddd"
}
}
}
},
{
"index": 1,
"type": "DOMAIN",
"label": {
"fontStyle": {
"textColor": "#000000"
}
},
"title": {
"text": "Domain axis title",
"fontStyle": {
"textColor": "#cccddd"
}
}
}
]
}
Pour mettre à jour une visualisation spécifique, vous pouvez envoyer une requête PUT à la même ressource /api/visualisations avec une charge similaire PLUS l'identifiant de la visualisation respective, par exemple :
PUT /api/visualizations/hQxZGXqnLS9
Enfin, pour supprimer une visualisation existante, vous pouvez faire une requête DELETE en spécifiant l'identifiant de la visualisation à supprimer, comme indiqué :
DELETE /api/visualizations/hQxZGXqnLS9
L'API EventVisualization (visualisation d'événements) est conçue pour aider les clients à interagir avec les graphiques et les rapports d'événements. Les endpoints de cette API sont utilisés par l'application Event Visualization qui permet la création, la configuration et la gestion de graphiques et de rapports basés sur les paramètres définis par le client. L'idée principale est de permettre aux clients et aux utilisateurs de disposer d'une API unique et centralisée fournissant tous les types de graphiques et de rapports d'événements ainsi que des paramètres et une configuration spécifiques pour chaque type de visualisation d'événement. Cette API a été introduite dans le but d'unifier les API eventCharts (graphiques d'événements) et eventReports (rapports d'événements) et de les remplacer entièrement en faveur de l'API eventVisualizations (ce qui signifie que l'utilisation des API eventCharts (graphiques d'événements) et eventReports (rapports d'événements) devrait être évitée). En résumé, les ressources/API suivantes : /api/eventCharts, /api/eventReports sont remplacées par /api/eventVisualizations
Remarque
Les nouvelles applications et les nouveaux clients doivent éviter d'utiliser les API
eventCharts(graphiques d'événements) eteventReports(rapports d'événements) car elles sont obsolètes. Utilisez plutôt l'APIeventVisualizations(visualisations d'événements).
Un objet EventVisualization (visualisation d'événements) est composé de nombreux attributs (certains liés à la création de graphiques et d'autres à la création de rapports), mais les plus importants, qui reflètent les informations essentielles de l'objet, sont les suivants : * "identifiant", "nom", "type", "éléments de données de dimension ", " colonnes ", " lignes " et " filtres ".* Le endpoint racine de l'API est /api/eventVisualizations, et la liste des attributs et éléments actuels est décrite dans le tableau ci-dessous.
Tableau : Attributs de la visualisation d'événements
| Champ | Description |
|---|---|
| id | L'identifiant unique. |
| code | Un code personnalisé pour identifier la visualisation d'événement. |
| name | Le nom de la visualisation d'événement |
| type | Le type de visualisation d'événement. Les types valides sont les suivants COLONNE, COLONNE_EMPILÉE, BARRE, BARRE_EMPILÉE, LIGNE, LISTE_DE LIGNES, ZONE, ZONE_EMPILÉE, CIRCULAIRE, RADAR, JAUGE, LIGNE_ANNÉE_SUR_ANNÉE, COLONNE_ANNÉE_SUR_ANNÉE, VALEUR_UNIQUE, TABLEAU_CROISÉ DYNAMIQUE, NUAGE DE POINTS, BULLE. |
| titre | Un titre personnalisé. |
| sous-titre | Un sous-titre personnalisé. |
| description | Définit une description personnalisée pour la visualisation d'événement. |
| created | Date/heure de création de la visualisation d'événement. |
| startDate | La date de début utilisée lors du filtrage. |
| endDate | La date de fin utilisée lors du filtrage. |
| sortOrder | Ordre de tri de cette visualisation d'événement. Valeur entière. |
| user | Un objet représentant le créateur de la visualisation. |
| publicAccess (accès public) | Définit les autorisations pour l'accès public. |
| displayDensity (afficher la densité) | La densité du texte affiché. |
| fontSize (taille de la police) | La taille de la police du texte. |
| périodes relatives | Un objet représentant les périodes relatives utilisées dans la requête analytique. |
| légende | Objet représentant les définitions de la légende et de l'ensemble de légendes, du style d'affichage (FILL (Remplir) ou TEXT (Texte)) et de la stratégie d'affichage (FIXED (Fixé) ou BY_DATA_ITEM (Par élément de données)). |
| Type d'agrégation | Détermine la manière dont les valeurs sont agrégées (le cas échéant). Options valides : SUM (somme), AVERAGE (moyenne), AVERAGE_SUM_ORG_UNIT ( somme moyenne des unités d'organisation ), LAST (dernier), LAST_AVERAGE_ORG_UNIT ( dernière moyenne des unités d'organisation ), FIRST (premier), FIRST_AVERAGE_ORG_UNIT ( première moyenne des unités d'organisation ), COUNT (nombre), STDDEV (valeur de référence), VARIANCE (écart type), MIN (minimum), MAX (maximum), NONE (aucun), CUSTOM (personnalisé) ou DEFAULT ( par défaut). |
| regressionType (type de régression) | Un type de régression valide : NONE (aucun), LINEAR (linéaire), POLYNOMIAL (polynomial) ou LOESS. |
| targetLineValue (valeur de la ligne cible) | La ligne cible du graphique. Accepte un type Double. |
| targetLineLabel (étiquette de la ligne cible) | L'étiquette de la ligne cible du graphique. |
| rangeAxisLabel (Étiquette de l'axe de la plage ) | L'étiquette/titre de l'axe vertical (y) du graphique. |
| domainAxisLabel (étiquette de l'axe du domaine) | L'étiquette/titre de l'axe horizontal (x) du graphique. |
| rangeAxisMaxValue (Plage de l'axe de la valeur maximale) | La valeur maximale de l'axe du graphique. Les valeurs en dehors de la plage ne seront pas affichées. |
| rangeAxisMinValue (Plage de l'axe de la Valeur minimale) | La valeur minimale de l'axe du graphique. Les valeurs en dehors de la plage ne seront pas affichées. |
| rangeAxisSteps (Étapes de l'axe de la plage) | Le nombre de pas d'axe entre les valeurs minimale et maximale. |
| rangeAxisDecimals (Décimales de l'axe de la plage) | Le nombre de décimales pour les valeurs des axes. |
| baseLineValue (Valeur de la ligne de base) | Une valeur de référence du graphique. |
| baseLineLabel (étiquette de la ligne de base) | Une étiquette de ligne de base du graphique. |
| digitGroupSeparator (Séparateur de groupes de chiffres) | Séparateur de groupes de chiffres. Valeurs valides : VIRGULE, ESPACE ou AUCUN. |
| topLimit (Limite maximale) | La limite maximale fixée pour le tableau croisé dynamique. |
| Critères de mesure | Décrit les critères appliqués à cette mesure. |
| percentStackedValues (Pourcentage des valeurs empilées) | Utilise ou non des valeurs empilées. Plus susceptible d'être utilisé pour les graphiques. Valeur booléenne. |
| noSpaceBetweenColumns (Aucun espace entre les colonnes) | Afficher/masquer l'espace entre les colonnes. Valeur booléenne. |
| externalAccess (accès externe) | Indique si la visualisation d'événement est disponible en lecture externe uniquement. Valeur booléenne. |
| userOrganisationUnit (Unité d'organisation de l'utilisateur) | Indique si l'utilisateur dispose d'une unité d'organisation. Valeur booléenne. |
| userOrganisationUnitChildren (Unité d'organisation subordonnées de l'utilisateur ) | Indique si l'utilisateur a des unités d'organisation subordonnées. Valeur booléenne. |
| userOrganisationUnitGrandChildren (Unité d'organisation subordonnées de l'utilisateur ) | Indique si l'utilisateur a une unité d'organisation subordonnées. Valeur booléenne. |
| rowTotals (totaux des lignes) | Affiche (ou non) les totaux des lignes. Valeur booléenne. |
| colTotals (totaux des colonnes) | Affiche (ou non) les totaux des colonnes. Valeur booléenne. |
| rowSubTotals (Sous-totaux des lignes) | Affiche (ou non) les sous-totaux des lignes. Valeur booléenne. |
| colSubTotals (Sous-totaux des colonnes) | Affiche (ou non) les sous-totaux des colonnes. Valeur booléenne. |
| cumulativeValues (Valeurs cumulées) | Indique si la visualisation d'événements utilise des valeurs cumulées. Valeur booléenne. |
| hideEmptyRows (cacher les lignes vides) | Indique s'il faut masquer les lignes qui ne contiennent pas de données. Valeur booléenne. |
| completedOnly (Terminé uniquement) | Indicateur utilisé dans les requêtes d'analyse. S'il est vrai, seuls les événements/inscriptions terminés seront considérés. Valeur booléenne. |
| showDimensionLabels (afficher les étiquettes de dimension) | Affiche ou non les étiquettes des dimensions. Valeur booléenne. |
| hideTitle (masquer le titre) | Masque ou non le titre. Valeur booléenne. |
| hideSubtitle (masquer le sous-titre) | Masque ou non les sous-titres. Valeur booléenne. |
| showHierarchy (afficher la hiérarchie) | Affiche (ou non) les noms de la hiérarchie des unités d'organisation. Valeur booléenne. |
| showData (afficher les données) | Utilisé par les graphiques pour masquer ou non les données/valeurs dans le modèle présenté. Valeur booléenne. |
| lastUpdatedBy (Dernière mise à jour par) | L'objet qui représente l'utilisateur qui a appliqué les dernières modifications à la visualisation d'événements. |
| lastUpdated (dernière mise à jour) | Date/heure de la dernière modification de la visualisation d'événements. |
| favoris | Liste des utilisateurs qui ont marqué cet objet comme favori. |
| abonnés | Liste des utilisateurs ayant souscrit à cette visualisation d'événements. |
| traductions | Ensemble des traductions d'objets disponibles, normalement filtrées par le paramètre locale. |
| program | Le programme associé. |
| programStage | L'étape du programme associée. |
| programStatus | Le statut du programme. Il peut être ACTIF, TERMINÉ, ANNULÉ. |
| eventStatus | Le statut de l'événement. Il peut s'agir de ACTIF, TERMINÉ, VISITÉ, PROGRAMMÉ, EN RETARD, SAUTÉ. |
| dataType (type de données) | Le type de données d'événement. Il peut s'agir de VALEURS_AGRÉGÉES ou d'ÉVÉNEMENTS. |
| columnDimensions (dimensions de la colonne) | Les dimensions définies pour les colonnes. |
| rowDimensions (dimensions de la ligne) | Les dimensions définies pour les lignes. |
| filterDimensions (dimensions du filtre) | Les dimensions définies pour les filtres. |
| outputType (type de sortie) | Indique le type de sortie de la visualisation d'événement. Il peut s'agir d'ÉVÉNEMENT, d'ENROLLEMENT ou d'INSTANCE_D'ENTITÉ_SUIVIE. |
| collapseDataDimensions (Dimensions des données regroupées) | Indique si toutes les dimensions des données doivent être regroupées en une seule dimension. Valeur booléenne. |
| hideNaData (masquer les données Na) | Indique s'il faut masquer les données N/A. Valeur booléenne. |
| hideEmptyColumns (cacher les colonnes vides) | Indique s'il faut masquer les colonnes sans données. Valeur booléenne. |
| fixColumnHeaders (fixer les en-têtes de colonne) | Fixes (or not) the pivot table column headers. Boolean value. |
| fixRowHeaders (En-tête de ligne fixe) | Fixes (or not) the pivot table row headers. Boolean value. |
Pour récupérer une liste de toutes les visualisations d'événements existantes, au format JSON, avec quelques informations de base (y compris l'identifiant, le nom et la pagination), vous pouvez faire une requête GET à l'URL ci-dessous. Vous devriez voir une liste de toutes les visualisations d'événements publiques/partagées ainsi que vos visualisations privées. GET /api/eventVisualizations.json Si vous souhaitez extraire la définition JSON d'une visualisation d'événement spécifique, vous pouvez ajouter son identifiant respectif à l'URL : GET /api/eventVisualizations/hQxZGXqnLS9.json La représentation suivante est un exemple de réponse au format JSON (par souci de concision, certaines informations ont été supprimées). Pour obtenir le schéma complet, veuillez utiliser GET /api/schemas/eventVisualization.
{
"lastUpdated": "2021-11-25T17:18:03.834",
"href": "http://localhost:8080/dhis/api/eventVisualizations/EZ5jbRTxRGh",
"id": "EZ5jbRTxRGh",
"created": "2021-11-25T17:18:03.834",
"name": "Inpatient: Mode of discharge by facility type this year",
"publicAccess": "rw------",
"userOrganisationUnitChildren": false,
"type": "STACKED_COLUMN",
"subscribed": false,
"userOrganisationUnit": false,
"rowSubTotals": false,
"cumulativeValues": false,
"showDimensionLabels": false,
"sortOrder": 0,
"favorite": false,
"topLimit": 0,
"collapseDataDimensions": false,
"userOrganisationUnitGrandChildren": false,
"displayName": "Inpatient: Mode of discharge by facility type this year",
"percentStackedValues": false,
"noSpaceBetweenColumns": false,
"showHierarchy": false,
"hideTitle": false,
"showData": true,
"hideEmptyRows": false,
"hideNaData": false,
"regressionType": "NONE",
"completedOnly": false,
"colTotals": false,
"sharing": {
"owner": "GOLswS44mh8",
"external": false,
"users": {},
"userGroups": {},
"public": "rw------"
},
"programStatus": "CANCELLED",
"hideEmptyRowItems": "NONE",
"hideSubtitle": false,
"outputType": "EVENT",
"hideLegend": false,
"externalAccess": false,
"colSubTotals": false,
"rowTotals": false,
"digitGroupSeparator": "SPACE",
"program": {
"id": "IpHINAT79UW"
},
"access": {
"read": true,
"update": true,
"externalize": true,
"delete": true,
"write": true,
"manage": true
},
"lastUpdatedBy": {
"displayName": "John Traore",
"name": "John Traore",
"id": "xE7jOejl9FI",
"username": "admin"
},
"relativePeriods": {
"thisYear": false,
...
},
"programStage": {
"id": "A03MvHHogjR"
},
"createdBy": {
"displayName": "Tom Wakiki",
"name": "Tom Wakiki",
"id": "GOLswS44mh8",
"username": "system"
},
"user": {
"displayName": "Tom Wakiki",
"name": "Tom Wakiki",
"id": "GOLswS44mh8",
"username": "system"
},
"attributeDimensions": [],
"translations": [],
"legend": {
"set": {
"id": "gFJUXah1uRH"
},
"showKey": false,
"style": "FILL",
"strategy": "FIXED"
},
"filterDimensions": [
"ou",
"H6uSAMO5WLD"
],
"interpretations": [],
"userGroupAccesses": [],
"subscribers": [],
"columns": [
{
"id": "X8zyunlgUfM"
}
]
"periods": [],
"categoryDimensions": [],
"rowDimensions": [
"pe"
],
"itemOrganisationUnitGroups": [],
"programIndicatorDimensions": [],
"attributeValues": [],
"columnDimensions": [
"X8zyunlgUfM"
],
"userAccesses": [],
"favorites": [],
"dataDimensionItems": [],
"categoryOptionGroupSetDimensions": [],
"organisationUnitGroupSetDimensions": [],
"organisationUnitLevels": [],
"organisationUnits": [
{
"id": "ImspTQPwCqd"
}
],
"filters": [
{
"id": "ou"
},
{
"id": "H6uSAMO5WLD"
}
],
"rows": [
{
"id": "pe"
}
]
}
Une réponse plus personnalisée peut être obtenue en spécifiant, dans l'URL, les champs que vous souhaitez extraire. Par exemple: GET /api/eventVisualizations/hQxZGXqnLS9.json?fields=interpretations renverra
{
"interpretations": [
{
"id": "Lfr8I2RPU0C"
},
{
"id": "JuwgdJlJPGb"
},
{
"id": "WAoU2rSpyZp"
}
]
}
Comme on peut le voir, le GET ci-dessus ne renverra que les interprétations liées à l'identifiant donné (dans ce cas hQxZGXqnLS9).
Ces opérations suivent la sémantique REST standard. Une nouvelle visualisation d'événement peut être créée par une requête POST à la ressource /api/eventVisualizations avec une charge JSON valide. Un exemple de charge pourrait être :
{
"name": "Inpatient: Cases under 10 years last 4 quarters",
"publicAccess": "rw------",
"userOrganisationUnitChildren": false,
"type": "STACKED_COLUMN",
"subscribed": false,
"userOrganisationUnit": false,
"rowSubTotals": false,
"cumulativeValues": false,
"showDimensionLabels": false,
"sortOrder": 0,
"favorite": false,
"topLimit": 0,
"collapseDataDimensions": false,
"userOrganisationUnitGrandChildren": false,
"displayName": "Inpatient: Cases under 10 years last 4 quarters",
"percentStackedValues": false,
"noSpaceBetweenColumns": false,
"showHierarchy": false,
"hideTitle": false,
"showData": true,
"hideEmptyRows": false,
"userAccesses": [],
"userGroupAccesses": [],
"hideNaData": false,
"regressionType": "NONE",
"completedOnly": false,
"colTotals": false,
"programStatus": "CANCELLED",
"sharing": {
"owner": "GOLswS44mh8",
"external": false,
"users": {},
"userGroups": {},
"public": "rw------"
},
"displayFormName": "Inpatient: Cases under 10 years last 4 quarters",
"hideEmptyRowItems": "NONE",
"hideSubtitle": false,
"outputType": "EVENT",
"hideLegend": false,
"externalAccess": false,
"colSubTotals": false,
"rowTotals": false,
"digitGroupSeparator": "SPACE",
"access": {
"read": true,
"update": true,
"externalize": false,
"delete": true,
"write": true,
"manage": true
},
"lastUpdatedBy": {
"displayName": "Tom Wakiki",
"name": "Tom Wakiki",
"id": "GOLswS44mh8",
"username": "system"
},
"legend": {
"set": {
"id": "gFJUXah1uRH"
},
"showKey": false,
"style": "FILL",
"strategy": "FIXED"
},
"relativePeriods": {
"thisYear": false,
...
},
"program": {
"id": "IpHINAT79UW",
"enrollmentDateLabel": "Date of enrollment",
"incidentDateLabel": "Date of birth",
"name": "Child Programme"
},
"programStage": {
"id": "A03MvHHogjR",
"executionDateLabel": "Report date",
"name": "Birth"
},
"createdBy": {
"displayName": "Tom Wakiki",
"name": "Tom Wakiki",
"id": "GOLswS44mh8",
"username": "system"
},
"user": {
"displayName": "Tom Wakiki",
"name": "Tom Wakiki",
"id": "GOLswS44mh8",
"username": "system"
},
"translations": [],
"filterDimensions": [
"ou"
],
"interpretations": [],
"dataElementDimensions": [
{
"filter": "LE:10",
"dataElement": {
"id": "qrur9Dvnyt5"
}
}
],
"periods": [],
"categoryDimensions": [],
"rowDimensions": [
"pe"
],
"columnDimensions": [
"qrur9Dvnyt5"
],
"organisationUnits": [
{
"id": "ImspTQPwCqd"
}
],
"filters": [
{
"dimension": "ou",
"items": [
{
"id": "ImspTQPwCqd"
}
]
},
{
"dimension": "H6uSAMO5WLD",
"items": []
}
],
"columns": [
{
"dimension": "X8zyunlgUfM",
"items": [],
"repetition": {
"indexes": [1, 2, 3, -2, -1, 0]
}
},
{
"dimension": "eventDate",
"items": [
{
"id": "2021-07-21_2021-08-01"
},
{
"id": "2021-01-21_2021-02-01"
}
]
},
{
"dimension": "incidentDate",
"items": [
{
"id": "2021-10-01_2021-10-30"
}
]
},
{
"dimension": "eventStatus",
"items": [
{
"id": "ACTIVE"
},
{
"id": "COMPLETED"
}
]
},
{
"dimension": "createdBy",
"items": [
{
"id": "userA"
}
]
},
{
"dimension": "lastUpdatedBy",
"items": [
{
"id": "userB"
}
]
}
],
"rows": [
{
"dimension": "pe",
"items": [
{
"id": "LAST_12_MONTHS"
}
]
}
]
}
Pour le maintien du multi-programme, la racine programme ne doit pas être spécifiée. Cela transformera la visualisation d'événement en un multi-programme. Par conséquent, nous devons spécifier le programme et l' étape du programme (le cas échéant) pour chaque dimension dans les lignes, les colonnes et les filtres.
Exemple:
"program": null,
"columns": [
{
"dimension": "ou",
"items": [
{
"id": "O6uvpzGd5pu"
}
],
"program": {
"id": "IpHINAT79UW"
}
},
{
"dimensionType": "CATEGORY_OPTION_GROUP_SET",
"items": [
{
"id": "JLGV7lRQRAg"
},
{
"id": "p916ZCVGNyq"
}
],
"dimension": "C31vHZqu0qU",
"program": {
"id": "kla3mAPgvCH"
},
"programStage": {
"id": "aNLq9ZYoy9W"
}
}
]
Remarque
L'attribut
répétition(danslignes,colonnesoufiltres) indique les index d'événements à récupérer. En reprenant l'exemple ci-dessus (dans la chargejsonprécédente), on peut le lire comme suit:1 = Premier événement 2 = Deuxième événement 3 = Troisième événement ... -2 = Troisième événement le plus récent -1 = Deuxième événement le plus récent 0 = Dernier événement (par défaut)
Pour mettre à jour une visualisation d'événement spécifique, vous pouvez envoyer une requête PUT à la même ressource /api/eventVisualizations avec une charge similaire PLUS l'identifiant de la visualisation d'événement respective, par exemple : PUT /api/eventVisualizations/hQxZGXqnLS9 Enfin, pour supprimer une visualisation d'événement existante, vous pouvez effectuer une requête DELETE en spécifiant l'identifiant de la visualisation d'événement à supprimer, comme indiqué ci-dessous : DELETE /api/eventVisualizations/hQxZGXqnLS9
Pour les ressources liées à l'analyse des données dans DHIS2, telles que les visualisations, les cartes, les rapports d'événements, les graphiques d'événements et même les visualisations, vous pouvez écrire et partager des interprétations de données. Une interprétation peut être un commentaire, une question, une observation ou une interprétation concernant un rapport de données ou une visualisation.
/api/interpretations
Pour lire les interprétations, nous allons interagir avec la ressource /api/interpretations. Une requête GET typique utilisant le filtrage des champs peut ressembler à ceci :
GET /api/interpretations?fields=*,comments[id,text,user,mentions]
La réponse au format JSON pourrait ressembler à ce qui suit (les champs supplémentaires ont été omis par souci de concision) :
{
"interpretations": [
{
"id": "XSHiFlHAhhh",
"created": "2013-05-30T10:24:06.181+0000",
"text": "Data looks suspicious, could be a data entry mistake.",
"type": "MAP",
"likes": 2,
"user": {
"id": "uk7diLujYif"
},
"reportTable": {
"id": "LcSxnfeBxyi"
},
"visualization": {
"id": "LcSxnfeBxyi"
}
}, {
"id": "kr4AnZmYL43",
"created": "2013-05-29T14:47:13.081+0000",
"text": "Delivery rates in Bo looks high.",
"type": "VISUALIZATION",
"likes": 3,
"user": {
"id": "uk7diLujYif"
},
"visualization": {
"id": "HDEDqV3yv3H"
},
"mentions": [
{
"created": "2018-06-25T10:25:54.498",
"username": "boateng"
}
],
"comments": [
{
"id": "iB4Etq8yTE6",
"text": "This report indicates a surge.",
"user": {
"id": "B4XIfwOcGyI"
}
},
{
"id": "iB4Etq8yTE6",
"text": "Likely caused by heavy rainfall.",
"user": {
"id": "B4XIfwOcGyI"
}
},
{
"id": "SIjkdENan8p",
"text": "Have a look at this @boateng.",
"user": {
"id": "xE7jOejl9FI"
},
"mentions": [
{
"created": "2018-06-25T10:03:52.316",
"username": "boateng"
}
]
}
]
}
]
}
Tableau : Champs d'interprétation
| Champ | Description |
|---|---|
| id | L'identifiant de l'interprétation. |
| created | L'heure de création de l'interprétation. |
| type | Le type d'objet analytique interprété. Options valides : VISUALISATION, CARTE, RAPPORT_D'ÉVÉNEMENT, GRAPHIQUE_D'ÉVÉNEMENT, VISUALISATION_D'ÉVÉNEMENT, RAPPORT_D'ENSEMBLE DE DONNÉES. |
| user | Associer à l'utilisateur qui a créé l'interprétation. |
| visualisation | Associer à la visualisation si le type est VISUALISATION |
| visualisation d'événements | Associer à la visualisation d'événements si le type est VISUALISATION_D'ÉVÉNEMENT |
| carte | Associer à la carte si le type est CARTE. |
| eventReport (rapport d'événement) | Associer au rapport d'événement le type RAPPORT_D'ÉVÉNEMENT. |
| eventChart (graphique d'événements) | Associer au graphique de l'événement si le type est GRAPHIQUE_D'ÉVÉNEMENT. |
| dataSet (ensemble de données) | Associer à l'ensemble de données si le type est RAPPORT_D'ENSEMBLE DE DONNÉES. |
| commentaires | Tableau de commentaires pour l'interprétation. Le champ texte contient le commentaire proprement dit. |
| mentions | Tableau des mentions pour l'interprétation. Une liste d'identifiants d'utilisateurs. |
Pour tous les objets analytiques, vous pouvez ajouter / données à l'URL pour récupérer les données associées à la ressource (par opposition aux métadonnées). Par exemple, en suivant le lien de la carte et en ajoutant / données, on peut récupérer une représentation PNG (image) de la carte thématique par l'intermédiaire de l'URL suivante :
https://play.dhis2.org/demo/api/maps/bhmHJ4ZCdCd/data
Pour tous les objets analytiques, vous pouvez filtrer par mentions. Pour récupérer toutes les interprétations/commentaires où un utilisateur a été mentionné, vous avez trois options. Vous pouvez filtrer par les mentions d'interprétation (mentions dans la description de l'interprétation) :
GET /api/interpretations?fields=*,comments[*]&filter=mentions.username:in:[boateng]
Vous pouvez filtrer les commentaires d'interprétation en fonction des mentions (mentions dans n'importe quel commentaire) :
GET /api/interpretations?fields=*,comments[*]
&filter=comments.mentions.username:in:[boateng]
Vous pouvez filtrer les interprétations qui contiennent les mentions soit dans l'interprétation ou dans un commentaire ( OU jonction) :
GET /api/interpretations?fields=*,comments[*]&filter=mentions:in:[boateng]
Lorsque vous écrivez des interprétations, vous fournissez le texte de l'interprétation dans le corps de la requête en utilisant une requête POST avec un contenu de type « text/plain ». Le modèle d'URL ressemble à ce qui suit, où {object-type} fait référence au type de l'objet interprété et {object-id} fait référence à l'identifiant de l'objet interprété.
/api/interpretations/{object-type}/{object-id}
Les options valides pour le type d'objet sont visualisation, carte, rapport d'événement, graphique d'événement, visualisation d'événement et rapport d'ensemble de données.
Quelques exemples pertinents d'interprétations sont énumérés ci-dessous.
Remarque
Les API
eventCharts(graphiques d'événements) eteventReports(rapports d'événements) sont obsolètes. Nous recommandons d'utiliser l'APIeventVisualizations(visualisations d'événements) à la place.
/api/interpretations/visualization/hQxZGXqnLS9
/api/interpretations/map/FwLHSMCejFu
/api/interpretations/eventReport/xJmPLGP3Cde
/api/interpretations/eventChart/nEzXB2M9YBz
/api/interpretations/eventVisualization/nEzXB2M9YBz
/api/interpretations/dataSetReport/tL7eCjmDIgM
A titre d'exemple, nous commencerons par écrire une interprétation pour la visualisation avec l'identifiant EbRN2VIbPdV. Pour écrire des interprétations de visualisation, nous allons interagir avec la ressource /api/interpretations/visualization/{visualizationId}. L'interprétation sera le corps de la requête. Sur cette base, nous pouvons formuler la requête suivante en utilisant cURL :
curl -d "Cette visualisation montre un abandon important de la CPN 1-3" -X POST
"https://play.dhis2.org/demo/api/interpretations/visualization/EbRN2VIbPdV" -H "Content-Type:text/plain" -u admin:district
Notez que la réponse fournit un en-tête de Localisation avec une valeur indiquant l'emplacement de l'interprétation créée. Ceci est utile du point de vue du client lorsque vous souhaitez ajouter un commentaire à interprétation.
Pour mettre à jour une interprétation existante, vous pouvez utiliser une requête PUT dont le texte de l'interprétation est le corps de la requête, qui utilise le modèle d'URL suivant, dans lequel {id} fait référence à l'identifiant de l'interprétation :
/api/interpretations/{id}
Sur cette base, nous pouvons utiliser curl pour mettre à jour l'interprétation :
curl -d "Cette visualisation montre un taux d'abandon élevé" -X PUT
"https://play.dhis2.org/demo/api/interpretations/visualization/EV08iI1cJRA" -H "Content-Type:text/plain" -u admin:district
Vous pouvez utiliser le même modèle d'URL que ci-dessus en utilisant une requête DELETE pour supprimer l'interprétation.
Lorsque vous écrivez des commentaires sur les interprétations, vous fournissez le texte du commentaire dans le corps de la requête en utilisant une requête POST avec le type de contenu « text/plain ». Le modèle d'URL ressemble à ce qui suit, où {interpretation-id} fait référence à l'identifiant de l'interprétation.
/api/interpretations/{interpretation-id}/comments
Deuxièmement, nous allons rédiger un commentaire à l'interprétation que nous avons écrite dans l'exemple ci-dessus. En regardant la réponse de l'interprétation, vous verrez qu'un en-tête Localisation est renvoyé. Cet en-tête nous indique l'URL de l'interprétation nouvellement créée et, à partir de là, nous pouvons lire son identifiant. Cet identifiant est généré de manière aléatoire, vous devrez donc remplacer celui de la commande ci-dessous par le vôtre. Pour écrire un commentaire, nous pouvons interagir avec la ressource /api/interpretations/{id}/comments comme ceci :
curl -d "Une intervention est nécessaire" -X POST
"https://play.dhis2.org/demo/api/interpretations/j8sjHLkK8uY/comments"
-H "Content-Type:text/plain" -u admin:district
Pour mettre à jour un commentaire d'interprétation, vous pouvez utiliser une requête PUT où le texte du commentaire est le corps de la requête en utilisant le modèle d'URL suivant :
/api/interpretations/{interpretation-id}/comments/{comment-id}
Sur cette base, nous pouvons utiliser curl pour mettre à jour le commentaire :
curl "https://play.dhis2.org/demo/api/interpretations/j8sjHLkK8uY/comments/idAzzhVWvh2"
-d "Je suis d'accord." -X PUT -H "Content-Type:text/plain" -u admin:district
Vous pouvez utiliser le même modèle d'URL que ci-dessus en utilisant une requête DELETE pour supprimer le commentaire d'interprétation.
Pour aimer une interprétation, vous pouvez utiliser une requête POST vide vers la ressource like :
POST /api/interpretations/{id}/like
Un like sera ajouté pour l'utilisateur actuellement authentifié. Un utilisateur ne peut aimer une interprétation qu'une seule fois.
Pour supprimer un « like » pour une interprétation, vous pouvez utiliser une requête DELETE à la même ressource que pour l'opération « like ».
Le statut d'une interprétation peut être visualisé en regardant la représentation ordinaire de l'API Web :
GET /api/interpretations/{id}
Les informations relatives aux appréciations se trouvent dans le champ likes (aimé), qui représente le nombre d'appréciations, et dans le tableau likedBy (aimé par), qui énumère les utilisateurs qui ont aimé l'interprétation.
{
"id": "XSHiFlHAhhh",
"text": "Data looks suspicious, could be a data entry mistake.",
"type": "VISUALIZATION",
"likes": 2,
"likedBy": [
{
"id": "k7Hg12fJ2f1"
},
{
"id": "gYhf26fFkjFS"
}
]
}
La ressource des vues SQL vous permet de créer et d'extraire l'ensemble des résultats de vues SQL. Les vues SQL peuvent être exécutées directement dans la base de données et restituer l'ensemble des résultats par l'intermédiaire de la ressource Web API.
/api/sqlViews
Les vues SQL sont utiles dans la création de vues de données qui peuvent être plus facilement construites avec SQL qu'en combinant les multiples objets de l'API Web. Par exemple, supposons qu'il nous a été demandé de fournir une vue de toutes les unités d'organisation avec leur noms, les noms des parents, le niveau et le nom de l'unité d'organisation, ainsi que les coordonnées répertoriées dans la base de données. La vue pourrait ressembler à ceci :
select ou.name as orgunit, par.name as parent, ou.coordinates, ous.level, oul.name
from organisationunit ou
inner join _orgunitstructure ous on ou.organisationunitid = ous.organisationunitid
inner join organisationunit par on ou.parentid = par.organisationunitid
inner join orgunitlevel oul on ous.level = oul.level
where ou.coordinates is not null
order by oul.level, par.name, ou.name;
Nous allons utiliser curl pour exécuter d'abord la vue sur le serveur de DHIS2. Il s'agit essentiellement d'un processus de matérialisation, qui garantit que les données les plus récentes sont disponibles dans la vue SQL lorsqu'elles sont récupérées sur le serveur. Vous pouvez d'abord rechercher la vue SQL dans la ressource api/sqlViews, puis faire un POST à l'aide de la commande suivante :
curl "https://play.dhis2.org/demo/api/sqlViews/dI68mLkP1wN/execute" -X POST -u admin:district
L'étape suivante du processus est la récupération des données. Le endpoint est disponible à l'adresse suivante:
/api/sqlViews/{id}/data(.csv)
Le chemin id représente l'identifiant de la vue SQL. L'extension du chemin fait référence au format de téléchargement des données. Ajoutez soit data pour les données JSON, soit data.csv pour les valeurs séparées par des virgules. Les formats de réponse supportés sont json, xml, csv, xls, html et html+css.
Par exemple, la commande suivante permet de récupérer des données CSV pour la vue SQL définie ci-dessus.
curl "https://play.dhis2.org/demo/api/sqlViews/dI68mLkP1wN/data.csv" -u admin:district
Il existe trois types de vues SQL :
Vues SQL: Vues SQL standard.
Vue SQL matérialisée: Les vues SQL matérialisées, c'est-à-dire écrites sur le disque, doivent être mises à jour pour refléter les modifications apportées aux tables sous-jacentes. Elles prennent en charge les critères permettant de filtrer l'ensemble des résultats.
Requêtes SQL: Les requêtes SQL simples. Elles prennent en charge les variables en ligne pour les requêtes personnalisées.
Vous pouvez effectuer un filtrage simple sur les colonnes de l'ensemble de résultats en ajoutant des paramètres de requête critère à l'URL, en utilisant les noms de colonnes et les valeurs de filtrage séparées par les colonnes en tant que valeurs de paramètre, au format suivant :
/api/sqlViews/{id}/data?criteria=col1:value1&criteria=col2:value2
Par exemple, pour filtrer les résultats de la vue SQL ci-dessus afin de ne renvoyer que les unités d'organisation de niveau 4, vous pouvez utiliser l'URL suivante :
https://play.dhis2.org/demo/api/sqlViews/dI68mLkP1wN/data.csv?criteria=level:4
Les vues SQL prennent en charge la substitution de variables. La substitution de variables n'est disponible que pour les vues SQL de type requête, c'est-à-dire les vues SQL qui ne sont pas créées dans la base de données mais simplement exécutées comme des requêtes SQL normales. Les variables peuvent être insérées directement dans la requête SQL et doivent être dans ce format :
${variable-key}
Par exemple, une requête SQL qui récupère tous les éléments de données d'un type de valeur donné, où le type de valeur est défini par une variable, peut ressembler à ceci :
select * from dataelement where valuetype = '${valueType}';
Ces variables peuvent ensuite être fournies dans l'URL lorsqu'elles sont demandées par l'intermédiaire de la ressource API Web sqlViews. Les variables peuvent être fournies dans le format suivant :
/api/sqlViews/{id}/data?var=key1:value1&var=key2:value2
Un exemple de requête correspondant à l'exemple ci-dessus peut se présenter comme suit :
/api/sqlViews/dI68mLkP1wN/data.json?var=valueType:int
La variable valueType sera remplacée par la valeur int et la requête renverra des éléments de données de type int.
Le paramètre variable ne doit contenir que des caractères alphanumériques. Les variables doivent contenir uniquement des caractères alphanumériques, des tirets, des traits de soulignement et des espaces.
Les vues SQL de type query prennent également en charge deux variables définies par le système qui permettent à la requête d'accéder à des informations sur l'utilisateur qui exécute la vue :
| variable | signifie |
|---|---|
| ${_current_user_id} | l'identifiant de l'utilisateur dans la base de données |
| ${_current_username} | le nom d'utilisateur de l'utilisateur |
Les valeurs de ces variables ne peuvent pas être fournies dans le cadre de l'URL. Elles sont toujours remplies d'informations sur l'utilisateur.
Par exemple, la vue SQL suivante de type requête affiche toutes les unités d'organisation affectées à l'utilisateur :
select ou.path, ou.name
from organisationunit ou_user
join organisationunit ou on ou.path like ou_user.path || '%'
join usermembership um on um.organisationunitid = ou_user.organisationunitid
where um.userinfoid = ${_current_user_id}
order by ou.path;
L'API de vue SQL prend en charge le filtrage des données, au même titre que filtre_d'objet de métadonnées. Pour une liste complète des opérateurs de filtrage, vous pouvez consulter la documentation de filtre_d'objet de métadonnées.
Pour utiliser les filtres, il suffit de les ajouter en tant que paramètres à la fin de l'URL de demande de votre vue SQL, comme ceci. Cette requête renverra un résultat comprenant les unités d'organisation dont le nom contient « bo » au niveau 2 de la hiérarchie des unités d'organisation :
/api/sqlViews/w3UxFykyHFy/data.json?filter=orgunit_level:eq:2&filter=orgunit_name:ilike:bo
L'exemple suivant renverra toutes les unités d'org avec niveau_de l'unité d'organisation 2 ou 4 :
/api/sqlViews/w3UxFykyHFy/data.json?filter=orgunit_level:in:[2,4]
Et enfin, un exemple pour retourner toutes les unités d'organisation qui ne commencent pas par "Bo" :
/api/sqlViews/w3UxFykyHFy/data.json?filter=orgunit_name:!like:Bo
This endpoint allows the user to query data related to a few different dimensional items. These items are: INDICATOR, DATA_ELEMENT, DATA_SET, PROGRAM_INDICATOR, PROGRAM_DATA_ELEMENT, PROGRAM_ATTRIBUTE, OPTION_SET. The endpoint supports only GET requests and, as other endpoints, can return responses in JSON or XML format.
L'URL est /api/dataItems et comme vous pouvez l'imaginer, il est possible de récupérer différents objets à travers le même endpoint dans la même requête GET. Pour cette raison, certains attributs disponibles pour les requêtes seront différents en fonction du ou des éléments dimensionnels interrogés.
Pour comprendre la déclaration ci-dessus, examinons les exemples de requête suivants :
1) GET /api/dataItems?filter=dimensionItemType:eq:DATA_ELEMENT&filter=valueType:eq:TEXT Dans cet exemple, le type d'élément ELEMENT_DE DONNÉES possède un attribut Type de valeur qui peut être utilisé dans la requête.
2) GET /api/dataItems?pageSize=50&order=displayName:asc&filter=dimensionItemType:eq:PROGRAM_INDICATOR&filter=displayName:ilike:someName&filter=programId:eq:WSGAb5XwJ3Y
Ici, le L'INDICATEUR DE_PROGRAMME permet de filtrer par identifiant de programme.
Ainsi, en se basant sur les exemples 1) et 2), si vous essayez de filtrer un ELEMENT DE_DONNEES par identifiant de programme ou de filtrer un INDICATEUR_DE PROGRAMME par type de valeur, vous n'obtiendrez aucun résultat. En d'autres termes, le filtre ne sera appliqué que si l'attribut existe réellement pour l'élément de données concerné.
Un autre aspect important à souligner est que ce endpoint ne suit PAS les mêmes normes de requête que d'autres endpoints existants, comme Filtre d'objet de métadonnées par exemple. En conséquence, il supporte un ensemble plus restreint de fonctionnalités et de requêtes. La raison principale en est la nécessité d'interroger plusieurs éléments différents ayant des relations différentes, ce qui n'est pas possible en utilisant les composants de filtrage existants (utilisés par les autres endpoints).
En fonction de la requête GET, les codes d'état et les réponses suivants peuvent être renvoyés.
{
"pager": {
"page": 1,
"pageCount": 27,
"total": 1339,
"pageSize": 50
},
"dataItems": [
{
"simplifiedValueType": "TEXT",
"displayName": "TB program Gender",
"displayShortName": "TB prog. Gen.",
"valueType": "TEXT",
"name": "TB program Gender",
"shortName": "TB prog Gen",
"id": "ur1Edk5Oe2n.cejWyOfXge6",
"programId": "ur1Edk5Oe2n",
"dimensionItemType": "PROGRAM_ATTRIBUTE"
}
]
}
{
"pager": {
"page": 1,
"pageCount": 1,
"total": 0,
"pageSize": 50
},
"dataItems": [
]
}
{
"httpStatus": "Conflict",
"httpStatusCode": 409,
"status": "ERROR",
"message": "Unable to parse element `INVALID_TYPE` on filter dimensionItemType`. The values available are: [INDICATOR, DATA_ELEMENT, DATA_ELEMENT_OPERAND, DATA_SET, PROGRAM_INDICATOR, PROGRAM_DATA_ELEMENT, PROGRAM_ATTRIBUTE]",
"errorCode": "E2016"
}
Ce endpoint supporte également la pagination en tant qu'option par défaut. Si nécessaire, vous pouvez désactiver la pagination en ajoutant paging=false à la requête GET, c'est-à-dire : /api/dataItems?filter=dimensionItemType:in :[INDICATOR]&paging=false.
Voici un exemple de charge lorsque la pagination est activée. N'oubliez pas que la pagination est l'option par défaut et qu'il n'est pas nécessaire de la définir explicitement.
{
"pager": {
"page": 1,
"pageCount": 20,
"total": 969,
"pageSize": 50
},
"dataItems": [...]
}
Remarque
Pour les éléments auxquels un programme est associé, le nom du programme doit également être renvoyé en tant que partie du nom de l'élément (en tant que préfixe). La seule exception concerne les
Indicateurs de programme. Nous ne préfixerons pas le nom de l'élément dans ce cas, afin de conserver le même comportement que les endpoints existants.Le endpoint /dataItems n'apportera que des éléments de données qui sont définis comme étant de type agrégable. La liste actuelle des types agrégeables valides est la suivante :
TEXTE, TEXTE_LONG,LETTRE,BOLÉEN,VRAI_UNIQUEMENT,NOMBRE,INTERVALLE_UNITAIRE,POURCENTAGE,ENTIER,ENTIER_POSITIF,ENTIER_NÉGATIF,ENTIER_ZÉRO_OU_POSITIF,COORDONNÉE.Même si la réponse renvoie plusieurs attributs différents, le filtrage ne peut être appliqué qu'à certains d'entre eux :
afficher le nom,le nom,le type de valeur,l'id,le type d'élément de dimension,l'id de programme.L'
ordresera considéré comme invalide s'il est placé au-dessus denom(ie. : ordre=nom:asc) et qu'unfiltreest placé surafficher le nom(ie. : filter=afficher le nom:ilike:aNom), et vice-versa.
Maintenant que nous avons une bonne idée des principales caractéristiques et de l'utilisation de ce endpoint , examinons la liste des attributs renvoyés dans la réponse.
Tableau : Attributs des éléments de données
| Champ | Description |
|---|---|
| id | L'identifiant unique. |
| code | Un code personnalisé pour identifier l'élément dimensionnel. |
| name | Le nom donné à l'élément. |
| Nom d'affichage | Le nom d'affichage défini. |
| Nom court | Le nom court donné à l'élément. |
| displayShortName (afficher le Nom Court) | Le nom court d'affichage défini. |
| dimensionItemType (type de dimension de l'élément) | Type de dimension. Les types possibles sont les suivants : INDICATEUR, ÉLÉMENT DE_DONNÉES, TAUX DE_DÉCLARATION, INDICATEUR DE_PROGRAMME, ÉLÉMENT DE_DONNÉES_DU PROGRAMME, ATTRIBUT DE_PROGRAMME. |
| Type de valeur | Le type de valeur de l'élément (définition plus précise). Types possibles : TEXTE, TEXTE_LONG, LETTRE, BOOLÉEN, VRAI_UNIQUEMENT, UNITÉ_INTERVALLE, POURCENTAGE, ENTIER, ENTIER_POSITIF, ENTIER_NÉGATIF, ENTIER_ZÉRO_OU_POSITIF, COORDONNÉES. |
| simplifiedValueType (type de valeur simplifiée) | Représentation générique d'un type de valeur. Valeurs valides : NOMBRE, BOOLÉEN, DATE, RESSOURCE DE_FICHIER, COORDONNÉES, TEXTE |
| programId (Id du programme) | L'identifiant de programme associé. |
DHIS2 dispose de plusieurs ressources pour l'analyse des données. Ces ressources comprennent les cartes, les visualisations, les visualisations d'événements, les rapports et les documents. En visitant ces ressources, vous obtiendrez des informations à leur sujet. Par exemple, en naviguant vers /api/visualisations/R0DVGvXDUNP, la réponse contiendra le nom, la dernière date de modification et ainsi de suite pour le graphique. Pour récupérer la représentation analytique, par exemple une représentation PNG de la visualisation, vous pouvez ajouter / données à toutes ces ressources. Par exemple, en visitant /api/visualisations/R0DVGvXDUNP/data, le système renverra une image PNG de la visualisation.
Tableau : Ressources analytiques
| Ressource | Description | URL des données | Représentations des ressources |
|---|---|---|---|
| graphiques d'événements | Graphiques d'évènements | /api/eventCharts/<identifier>/data | png |
| cartes | Cartes | /api/maps/<identifier>/data | png |
| visualisations | Tableaux croisés dynamiques et graphiques | /api/visualizations/<identifier>/data | json | jsonp | html | xml | pdf | xls | csv |
| visualisations d'événements | Graphiques d'évènements | /api/eventVisualizations/<identifier>/data | png |
| png | |||
| rapports | **SIG:**Le SIG intégré à DHIS 2 permet de présenter et d'analyser vos | ||
| données à l'aide de cartes géographiques à thèmes. Vous pouvez y | |||
| visualiser aussi bien les éléments de données que les indicateurs ; et | |||
| en supposant que vous disposiez des coordonnées de toutes vos unités | |||
| d’organisation, vous pouvez parcourir votre hiérarchie | |||
| organisationnelle et faire apparaitre des cartes pour tous les niveaux à | |||
| l’aide de polygones ou de points. Toutes les informations affichées sur | |||
| les cartes sont générées par DHIS 2 ; tout ce que vous devez faire est | |||
| de procéder à l’enregistrement des coordonnées de vos unités | |||
| d'organisation pour que les cartes deviennent disponibles. Voir le | |||
| chapitre spécifique qui traite du SIG pour obtenir plus de détails. | /api/reports/<identifier>/data | pdf | xls | html | |
| documents | Ressources | /api/documents/<identifier>/data | <follows document> |
Le contenu des données des représentations analytiques peut être modifié en fournissant un paramètre de requête date. Pour cela, il faut que la ressource analytique soit configurée en périodes relatives pour la dimension période.
Tableau : Paramètres de requête de données
| Paramètre de requête | Valeur | Description |
|---|---|---|
| date | Les dates doivent être au format aaaa-MM-jj | Base pour les périodes relatives dans le rapport (exige des périodes relatives) |
Tableau : Paramètres de requête pour les pngs / types d'images (visualisations, cartes)
| Paramètre de requête | Description |
|---|---|
| largeur | Largeur de l'image en pixels |
| taille | Taille de l'image en pixels |
Quelques exemples d'URL valides pour la récupération de diverses représentations analytiques sont énumérés ci-dessous.
/api/visualizations/R0DVGvXDUNP/data
/api/visualizations/R0DVGvXDUNP/data?date=2013-06-01
/api/visualizations/jIISuEWxmoI/data.html
/api/visualizations/jIISuEWxmoI/data.html?date=2013-01-01
/api/visualizations/FPmvWs7bn2P/data.xls
/api/visualizations/FPmvWs7bn2P/data.pdf
/api/eventVisualizations/x5FVFVt5CDI/data
/api/eventVisualizations/x5FVFVt5CDI/data.png
/api/maps/DHE98Gsynpr/data
/api/maps/DHE98Gsynpr/data?date=2013-07-01
/api/reports/OeJsA6K1Otx/data.pdf
/api/reports/OeJsA6K1Otx/data.pdf?date=2014-01-01
Pour accéder aux données analytiques et agrégées dans DHIS2, vous pouvez utiliser la ressource analyse. L'importance de la ressource "analyse" réside dans le fait qu'elle vous permet d'interroger et d'extraire des données agrégées pour toutes les dimensions de données disponibles. Par exemple, vous pouvez demander à la ressource "analyse" de vous fournir des valeurs agrégées pour un ensemble d'éléments de données, de périodes et d'unités d'organisation. Vous pouvez également récupérer les données agrégées d'une combinaison de dimensions en vous basant sur des éléments de données et des groupes d'unités d'organisation.
/api/analytics
La ressource "analyse" vous permet de définir un ensemble de paramètres de requête :
Tableau : Paramètres de requête
| Paramètre de requête | Obligatoire | Description | Options (par défaut en premier) |
|---|---|---|---|
| dimension | Oui | Dimensions et éléments de dimension à extraire. Ils sont répétés pour chaque paramètre. | N'importe quelle dimension |
| filter | Non | Filtres et éléments de filtre à appliquer à la requête. Ils sont répétés pour chaque paramètre. | N'importe quelle dimension |
| Type d'agrégation | Non | Type d'agrégation à utiliser dans le processus d'agrégation. | SUM | AVERAGE | AVERAGE_SUM_ORG_UNIT | LAST | LAST_AVERAGE_ORG_UNIT | COUNT | STDDEV | VARIANCE | MIN | MAX |
| Critères de mesure | Non | Filtres pour les données/mesures. | EQ | GT | GE | LT | LE |
| preAggregationMeasureCriteria | Non | Filtres pour les données/mesures, appliqués avant l'agrégation. | EQ | GT | GE | LT | LE |
| startDate | Non | Date de début d’une plage de dates. Elle sera appliquée comme filtre, mais ne peut pas être utilisée avec une dimension ou un filtre de période. | Date |
| endDate | Non | Date de fin d’une plage de dates. Elle sera appliquée comme filtre, mais ne peut pas être utilisée avec une dimension ou un filtre de période. | Date |
| skipMeta | Non | Exclut la partie métadonnées de la réponse (améliore les performances) | false |
| skipData (ignorer les données) | Non | Excluez la partie données de la réponse. | false |
| skipRounding (ignorer l'arrondissement des valeurs) | Non | Évite l'arrondissement des valeurs de données, c'est-à-dire que les valeurs fournies sont très précise. | false |
| hierarchyMeta (métadonnées de la hiérarchie) | Non | Inclut les noms des unités d'organisation racines et le parcours hiérarchique des unités d'organisation dans les métadonnées. | false |
| ignoreLimit (Ignorer la limite) | Non | Ignore limit on max 50 000 records in response, use with care. | false |
| tableLayout (présentation du tableau) | Non | Utilise une source de données simples ou une présentation de tableau pour générer la réponse. | false |
| hideEmptyRows (cacher les lignes vides) | Non | Masque les lignes vides dans la réponse ; applicable lorsque la présentation du tableau est définie sur "vrai". | false |
| hideEmptyColumns (cacher les colonnes vides) | Non | Masque les colonnes vides dans la réponse ; applicable lorsque la présentation du tableau est définie sur "vrai". | false |
| showHierarchy (afficher la hiérarchie) | Non | Affiche le parcours hiérarchique complet de l'unité d'organisation ainsi que le nom de l'unité d'organisation. | false |
| includeNumDen (inclure le numérateur et le dénominateur) | Non | Inclut dans la réponse, le numérateur et le dénominateur utilisés pour calculer la valeur. | false |
| includeMetadataDetails (inclure les détails des métadonnées) | Non | Inclut les détails des métadonnées dans la réponse générée pour les données brutes. | false |
| displayProperty (afficher la propriété) | Non | Affiche la propriété des métadonnées. | NAME | SHORTNAME |
| outputIdScheme (schéma d'identification de la sortie) | Non | Schéma d'identification utilisé pour les éléments de métadonnées dans la réponse à la requête. Il accepte des identifiants, des codes ou des attributs. | UID | UUID | CODE | NAME | ATTRIBUTE:<ID> |
| outputOrgUnitIdScheme (schéma d'identification de l'unité d'organisation de sortie) | Non | Identifier scheme used for metadata items in the query response. Overrides "outputIdScheme" specifically for for Org Units. It accepts identifier, code or attributes. | UUID | CODE | NAME | ATTRIBUTE:<ID> |
| outputDataElementIdScheme (schéma d'identification de l'élément de données de sortie) | Non | Identifier scheme used for metadata items in the query response. Overrides "outputIdScheme" specifically for Data Elements. It accepts identifier, code or attributes. | UUID | CODE | NAME | ATTRIBUTE:<ID> |
| inputIdScheme | Non | Schéma d'identification à utiliser pour les éléments de métadonnées dans la requête. Il peut être un identifiant, un code ou constitué d'attributs. | UID | CODE | ATTRIBUTE:<ID> |
| approvalLevel (niveau d'approbation) | Non | Inclut les données qui ont été approuvées au moins jusqu'au niveau d'approbation spécifié. Il fait référence à l'identifiant du niveau d'approbation. | Identifiant du niveau d'approbation |
| relativePeriodDate (Date de la période relative) | Non | Date utilisée comme base pour les périodes relatives. | Date |
| userOrgUnit (unité d'organisation d'utilisateur) | Non | Définit explicitement les unités d'organisation d'utilisateur à utiliser. Elle remplace les unités d'organisation associées à l'utilisateur actuel. Plusieurs identifiants peuvent être séparés par un point-virgule. | Organisation unit identifiers |
| colonnes | Non | Dimensions to use as columns for table layout, separated by semi-colon. | N'importe quelle dimension (doit être une dimension de requête) |
| lignes | Non | Dimensions to use as rows for table layout, separated by semi-colon. | N'importe quelle dimension (doit être une dimension de requête) |
| order | Non | Spécifie l'ordre des lignes en fonction de la valeur. | ASC | DESC |
| timeField (champ de temps) | Non | Le champ de temps sur lequel baser l'agrégation des événements. Ceci s'applique uniquement aux éléments de données d'événements. Il peut s'agir d'une option prédéfinie ou de l'ID d'un attribut ou d'un élément de données ayant une valeur temporelle. | EVENT_DATE | ENROLLMENT_DATE | INCIDENT_DATE | DUE_DATE | COMPLETED_DATE | CREATED | LAST_UPDATED | <Attribute ID> | <Data element ID> |
| orgUnitField | Non | Le champ d’unité d’organisation sur lequel baser l’agrégation des événements. ceci s'applique uniquement aux éléments de données d'événements. Il peut s'agir de l’ID d’un attribut ou d’un élément de données avec le type de valeur "Unité d’organisation". L'option par défaut consiste à omettre le paramètre de requête. | <Attribute ID> | <Data element ID> | REGISTRATION | ENROLLMENT | OWNER_AT_START | OWNER_AT_END |
| enhancedConditions (conditions améliorées) | Non | Enable enhanced conditions for dimensions and filters. | false |
Le paramètre de requête dimension définit les dimensions à inclure dans la requête d'analyse. Un nombre quelconque de dimensions peut être spécifié. Le paramètre "dimension" doit être répété pour chaque dimension à inclure dans la réponse à la requête. La réponse à la requête peut éventuellement contenir des valeurs agrégées pour toutes les combinaisons des éléments de dimension spécifiés.
Le paramètre filtre définit les dimensions à utiliser comme filtres pour les données extraites de la requête d'analyse. Un nombre quelconque de filtres peut être spécifié. Le paramètre "filtre" doit être répété pour chaque filtre à utiliser dans la requête. La différence entre un filtre et une dimension réside dans le fait que les dimensions du filtre ne font pas partie du contenu de la réponse à la requête et que les valeurs agrégées dans la réponse sont regroupées en fonction des dimensions du filtre. En d'autres termes, les données de la réponse seront agrégées selon les dimensions du filtre, mais les filtres ne seront pas inclus en tant que dimensions dans la réponse proprement dite. Par exemple, pour lancer une requête pour certains éléments de données filtrés par les périodes et les unités d'organisation, vous pouvez utiliser l'URL suivante :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU&filter=pe:2014Q1;2014Q2
&filter=ou:O6uvpzGd5pu;lc3eMKXaEfw
Le paramètre de requête aggregationType (type d'agrégation) vous permet de définir l'opérateur d'agrégation à utiliser pour la requête. Par défaut, l'opérateur d'agrégation défini pour les éléments de données inclus dans la requête sera utilisé. Si votre requête ne contient aucun élément de données mais des groupes d'éléments de données, l'opérateur d'agrégation du premier élément de données du premier groupe sera utilisé. L'ordre des groupes et des éléments de données n'est pas défini. Ce paramètre de requête vous permet de remplacer l'opérateur d'agrégation par défaut et de définir un opérateur spécifique. Par exemple, vous pouvez le définir sur "count" (compter) avec l'URL suivante :
/api/analytics?dimension=dx:fbfJHSPpUQD&dimension=pe:2014Q1&dimension=ou:O6uvpzGd5pu
&aggregationType=COUNT
Le paramètre de requête measureCriteria (critères de mesure) vous permet de filtrer les plages d'enregistrements de données à renvoyer. Vous pouvez demander au système de ne renvoyer que les enregistrements dont les valeurs agrégées sont égales, supérieures, supérieures ou égales, inférieures ou inférieures ou égales à certaines valeurs. Vous pouvez spécifier un nombre quelconque de critères dans le format suivant, où criteria et value doivent être remplacés par des valeurs réelles :
/api/analytics?measureCriteria=criteria:value;criteria:value
À titre d'exemple, la requête suivante renverra uniquement les enregistrements pour lesquels la valeur est supérieure ou égale à 6 500 et inférieure à 33 000 :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU&dimension=pe:2014
&dimension=ou:O6uvpzGd5pu;lc3eMKXaEfw&measureCriteria=GE:6500;LT:33000
Comme pour measureCriteria, le paramètre de requête preAggregationMeasureCriteria vous permet de filtrer les données avant que l'agrégation ne soit effectuée. Par exemple, la requête suivante n'agrège que les données dont la valeur initiale correspond aux critères définis :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU&dimension=pe:2014
&dimension=ou:O6uvpzGd5pu;lc3eMKXaEfw&preAggregationMeasureCriteria=GE:10;LT:100
Les paramètres startDate (date de début) et endDate (date de fin) peuvent être utilisés pour définir une plage de dates personnalisée pour l'agrégation. Lorsque vous définissez une plage de dates, vous ne pouvez pas définir de périodes relatives ou fixes en tant que dimension ou filtre. La plage de dates va filtrer la réponse de l'outil d'analyse. Vous pouvez l'utiliser comme ceci :
/api/analytics.json?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&dimension=ou:ImspTQPwCqd&startDate=2018-01-01&endDate=2018-06-01
Pour que la ressource analytique génère les données sous forme d'un tableau tout fait, vous pouvez définir le paramètre tableLayout (présentation du tableau) en lui attribuant la valeur "true" (vrai). Au lieu de générer une source de données normalisée, la ressource analytique va maintenant générer les données dans un tableau. Vous pouvez utiliser les paramètres columns (colonnes) et rows (lignes) avec des identifiants de dimension séparés par des points-virgules en guise de valeurs pour indiquer ceux qui doivent apparaître dans les colonnes et ceux qui doivent apparaître dans les lignes du tableau. Les dimensions des colonnes et des lignes doivent être utilisées comme dimension de données dans la requête (et non comme filtre). Une telle requête peut ressembler à ceci :
/api/analytics.html?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU&dimension=pe:2014Q1;2014Q2
&dimension=ou:O6uvpzGd5pu&tableLayout=true&columns=dx;ou&rows=pe
Le paramètre order peut être utilisé pour les ressources analytiques afin de générer des données ordonnées. Les données seront classées dans l'ordre croissant (ou décroissant) des valeurs. Voici un exemple de requête permettant de classer les valeurs par ordre décroissant :
/api/analytics?dimension=dx:fbfJHSPpUQD&dimension=pe:LAST_12_MONTHS
&dimension=ou:O6uvpzGd5pu&order=DESC
DHIS2 dispose d'un modèle de données multidimensionnel avec plusieurs dimensions de données fixes et dynamiques. Les dimensions fixes sont l'élément de données, la période (temps) et l'unité d'organisation. Vous pouvez ajouter des dimensions de manière dynamique à travers des catégories, des groupes d'options de catégories, des groupes d'unités d'organisation, des groupes d'éléments de données et des groupes d'unités d'organisation. Le tableau ci-dessous présente les dimensions de données disponibles dans DHIS2. Chaque dimension de données a un identifiant de dimension correspondant, et chaque dimension peut avoir un ensemble d'éléments de dimension :
Tableau : Dimensions et éléments de dimension
| Dimension | Identifiant de la dimension | Éléments de la dimension |
|---|---|---|
| Éléments de données, indicateurs, mesures du taux de déclaration des ensembles de données, opérandes d'éléments de données, indicateurs de programme, éléments de données de programme, attributs de programme, règles de validation | dx | Élément de données, indicateur, mesures du taux de déclaration de l'ensemble de données, opérande d'élément de données, indicateur de programme, identifiants d'attribut de programme, mot clé DE_GROUP-<group-id>, IN_GROUP-<group-id> , utilisez <dataelement-id>.<optioncombo-id> pour les opérandes d'éléments de données, <program-id>.<dataelement-id> pour les éléments de données du programme, <program-id>.<attribute-id> pour les attributs du programme, <validationrule-id> pour les résultats de validation. |
| Périodes (temps) | pe | Périodes ISO et périodes relatives, voir "format de date et de période" |
| la hiérarchie d'unités d'organisation ; | ou | Identifiants d'unité d'organisation et mots-clés USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> et OU_GROUP-<group-id> |
| Combinaisons d'options de catégories | co | Identifiants des combinaisons d'options de catégorie (omettre pour obtenir tous les éléments) |
| Combinaisons d'options d'attribut | ao | Identifiants des combinaisons d'options de catégorie (omettre pour obtenir tous les éléments) |
| Catégories | <category id> | Identifiants des options de catégorie (omettre pour obtenir tous les éléments) |
| Des ensembles de groupes d'éléments de données | <group set id> | Identifiants des groupes d'éléments de données (omettre pour obtenir tous les éléments) |
| les ensembles de groupes d'unités d'organisation. | <group set id> | Identifiants des groupes d'unités d'organisation (omettre pour obtenir tous les éléments) |
| Ensembles de groupes d'options de catégorie | <group set id> | Identifiants des combinaisons d'options de catégorie (ignorer pour obtenir tous les éléments) |
Il n'est pas nécessaire de savoir quels objets sont utilisés pour les différentes dimensions dynamiques lors de la conception des requêtes analytiques. Vous pouvez obtenir une liste complète des dimensions dynamiques en visitant cette URL dans l'API Web :
/api/dimensions
Si vous souhaitez extraire uniquement les éléments dimensionnels d'une dimension dynamique donnée, vous pouvez utiliser l'exemple ci-dessous. La pagination est désactivée par défaut. Elle peut être activée si le paramètre de pagination paging=true est ajouté à l'URL.
/api/dimensions/J5jldMd8OHv/items?paging=true
L'API /dimensions fournit également un point d'extrémité où les clients peuvent obtenir les recommandations pour un ensemble de dimensions spécifique. Par exemple :
/api/33/dimensions/recommendations?fields=id&dimension=dx:fbfJHSPpUQD
In the example above, the response will contain the categories which are configured as data dimensions and associated, through data sets and category combos, with the data element fbfJHSPpUQD. In addition, all org unit group sets which are configured as data dimensions will be returned.
Le point d'extrémité peut accepter plusieurs éléments de données. Si l'on souhaite envoyer plusieurs éléments de données, ils doivent être séparés par un point virgule;. Par exemple :
/api/33/dimensions/recommendations?fields=id&dimension=dx:fbfJHSPpUQD;JuTpJ2Ywq5b
Remarque
Ce point d'extrémité renvoie uniquement les dimensions qui peuvent être lues par l'utilisateur actuellement connecté. Il vérifiera si cet utilisateur peut lire les données ou les métadonnées de la dimension recommandée. Les dimensions non autorisées ne sont pas incluses dans la liste.
L'URL de base de la ressource analytique est /api/analytics. Pour demander des dimensions et des éléments de dimension spécifiques, vous pouvez utiliser une chaîne de requête au format suivant, où dim-id (identifiant de la dimension) et dim-item (élément de dimension) doivent être remplacés par des valeurs réelles :
/api/analytics?dimension=dim-id:dim-item;dim-item&dimension=dim-id:dim-item;dim-item
Comme illustré ci-dessus, l'identifiant de la dimension est suivi de deux points, tandis que les éléments de la dimension sont séparés par des points-virgules. Par exemple, une requête portant sur deux éléments de données, deux périodes et deux unités d'organisation peut être effectuée à l'aide de l'URL suivante :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&dimension=pe:2016Q1;2016Q2&dimension=ou:O6uvpzGd5pu;lc3eMKXaEfw
Pour obtenir des données ventilées par combinaisons d'options de catégorie au lieu des totaux des éléments de données, vous pouvez inclure la dimension de catégorie dans la chaîne de requête. Voici une exemple :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&dimension=co&dimension=pe:201601&dimension=ou:O6uvpzGd5pu;lc3eMKXaEfw
Au moment de sélectionner des éléments de données, vous pouvez également sélectionner tous les éléments de données d'un groupe en tant qu'éléments en utilisant la syntaxe DE_GROUP-<id> :
/api/analytics?dimension=dx:DE_GROUP-h9cuJOkOwY2
&dimension=pe:201601&dimension=ou:O6uvpzGd5pu
Au moment de sélectionner les taux de déclaration des ensembles de données, la syntaxe contient un identifiant d'ensemble de données suivi d'une mesure de taux de déclaration :
/api/analytics?dimension=dx:BfMAe6Itzgt.REPORTING_RATE;BfMAe6Itzgt.ACTUAL_REPORTS
&dimension=pe:201601&dimension=ou:O6uvpzGd5pu
Pour obtenir des éléments de données de programme (de type Tracker), vous pouvez spécifier le programme pour chaque élément de données à l'aide de la syntaxe <program-id>.<dataelement-id> :
/api/analytics.json?dimension=dx:eBAyeGv0exc.qrur9Dvnyt5;eBAyeGv0exc.GieVkTxp4HH
&dimension=pe:LAST_12_MONTHS&filter=ou:ImspTQPwCqd
Pour obtenir des attributs de programme (attributs d'entités suivies), vous pouvez spécifier le programme pour chaque attribut à l'aide de la syntaxe <program.id>.<attribute-id> :
/api/analytics.json?dimension=dx:IpHINAT79UW.a3kGcGDCuk6;IpHINAT79UW.UXz7xuGCEhU
&dimension=pe:LAST_4_QUARTERS&dimension=ou:ImspTQPwCqd
Pour obtenir des ensembles de groupes d'unités d'organisation et des éléments de données, vous pouvez utiliser l'URL ci-dessous. Remarquez que l'identifiant de l'ensemble de groupes est utilisé comme identifiant de dimension et les groupes comme éléments de dimension :
/api/analytics?dimension=Bpx0589u8y0:oRVt7g429ZO;MAs88nJc9nL
&dimension=pe:2016&dimension=ou:ImspTQPwCqd
Pour obtenir des éléments de données et des catégories, vous pouvez utiliser l'URL suivante. Utilisez l'identifiant de la catégorie comme identifiant de dimension et les options de la catégorie comme éléments de dimension :
/api/analytics?dimension=dx:s46m5MS0hxu;fClA2Erf6IO&dimension=pe:2016
&dimension=YNZyaJHiHYq:btOyqprQ9e8;GEqzEKCHoGA&filter=ou:ImspTQPwCqd
Pour effectuer une requête en utilisant des périodes relatives et des unités d'organisation associées à l'utilisateur actuellement connecté, vous pouvez utiliser l'URL suivante :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&dimension=pe:LAST_12_MONTHS&dimension=ou:USER_ORGUNIT
Lorsque vous sélectionnez des unités d'organisation pour une dimension, vous pouvez utiliser la syntaxe LEVEL-<level> pour sélectionner un niveau entier, éventuellement limité par un nombre quelconque d'unités d'organisation limites. La limite renvoie à un nœud supérieur dans une sous-hiérarchie, ce qui signifie que toutes les unités d'organisation au niveau indiqué sous l'unité d'organisation limite indiquée dans la hiérarchie seront incluses dans la réponse et sont fournies en tant qu'éléments de dimension d'unité d'organisation ordinaires. La valeur du niveau peut être un niveau numérique ou faire référence à l'identifiant de l'entité du niveau de l'unité d'organisation. Voici une requête simple pour toutes les unités d'organisation de niveau trois :
/api/analytics?dimension=dx:fbfJHSPpUQD&dimension=pe:2016&dimension=ou:LEVEL-3
Une requête pour les niveaux trois et quatre avec deux unités d'organisation limites peut se présenté comme suit :
/api/analytics?dimension=dx:fbfJHSPpUQD&dimension=pe:2016
&dimension=ou:LEVEL-3;LEVEL-4;O6uvpzGd5pu;lc3eMKXaEf
Lors de la sélection des unités d'organisation, vous pouvez également sélectionner toutes les unités d'organisation d'un groupe d'unités d'organisation, lesquelles seront incluses en tant qu'éléments de dimension. Vous pouvez le faire en utilisant la syntaxe OU_GROUP-<id>. Les unités d'organisation qui se trouvent dans les groupes peuvent éventuellement être limitées par un nombre quelconque d'unités d'organisation limites. Les éléments de niveau et de groupe peuvent être répétés autant de fois que nécessaire :
/api/analytics?dimension=dx:fbfJHSPpUQD&dimension=pe:2016
&dimension=ou:OU_GROUP-w0gFTTmsUcF;OU_GROUP-EYbopBOJWsW;O6uvpzGd5pu;lc3eMKXaEf
Vous pouvez utiliser des schémas d'identification pour la partie métadonnées de la réponse analytique avec la propriété outputIdScheme (schéma d'identification de la sortie). Vous pouvez utiliser l'identifiant, le code ou les attributs comme schéma d'identification. Voici un exemple :
/api/analytics?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&dimension=pe:2017Q1;2017Q2&dimension=ou:O6uvpzGd5pu&outputIdScheme=CODE
Quelques éléments à prendre en compte lors de l'utilisation de la ressource analytique sont répertoriés ci-dessous.
Les éléments de données, les indicateurs, les taux de déclaration des ensembles de données, les éléments de données de programme et les indicateurs de programme font partie d’une dimension de données commune, identifié comme "dx". Cela signifie que vous pouvez utiliser n'importe quelle élément de données, indicateur et identifiant d'ensemble de données avec l'identifiant de dimension "dx" dans la requête.
Pour les dimensions "catégorie", "ensemble de groupes d'éléments de données" et "ensemble de groupes d'unités d'organisation", tous les éléments de dimension seront utilisés dans la requête si des éléments de dimension ne sont pas spécifiés.
Pour la dimension de période, les éléments de dimension sont des identifiants de période ISO et/ou des périodes relatives. Consultez la section "Format de date et de période" plus haut, pour mieux comprendre le format des périodes et les périodes relatives disponibles.
For the organization unit dimension, you can specify items as either the organization unit or its sub-units associated with the currently authenticated user. Use the keys USER_ORGUNIT for the organization unit itself or USER_ORGUNIT_CHILDREN for its sub-units. You may also specify organization unit identifiers directly or use a combination of both. The authenticated user must have permission to export and analyze data for the designated organization units.
Pour la dimension d'unité d'organisation, vous pouvez spécifier le niveau hiérarchique et l'unité d'organisation limite à utiliser pour la requête en utilisant le format LEVEL-<level>-<boundary-id>. Par exemple, LEVEL-3-ImspTQPwCqd prend en compte toutes les unités d'organisation inférieures à l'unité d'organisation limite au niveau 3 de la hiérarchie.
Pour la dimension d'unité d'organisation, les éléments de dimension sont les unités d'organisation et leur sous-hiérarchie - les données seront agrégées pour toutes les unités d'organisation situées en dessous de l'unité d'organisation spécifiée dans la hiérarchie.
Vous ne pouvez pas spécifier d'éléments de dimension pour la dimension de combinaison d'options de catégorie. En lieu et place de cela, la réponse contiendra les éléments associés aux valeurs de données.
La dimension dx est une dimension spéciale qui peut contenir tous les types de données suivants.
Tableau : Types de dimensions de données dx
| Type | Syntaxe | Description | Source des données |
|---|---|---|---|
| Indicateur | <indicator-id> | Identifiant d'indicateur. | Données agrégées |
| Groupe indicateur | IN_GROUP-<indicatorgroup-id> | Mot clé suivi d'un identifiant de groupe d'indicateurs. Inclura tous les indicateurs du groupe dans la réponse. | Données agrégées |
| Élément de données | <dataelement-id> | Identifiant de l'élément de données. | Données agrégées |
| Groupe d'éléments de données | DE_GROUP-<dataelementgroup-id> | Mot clé suivi d'un identifiant de groupe d'éléments de données. Inclura tous les éléments de données du groupe dans la réponse. | Données agrégées |
| Opérande de l'élément de données | <dataelement-id>.<categoryoptcombo-id>.<attributeoptcombo-id> | Identifiant de l'élément de données suivi d'une combinaison d'options de catégorie et d'un identifiant de combinaison d'options d'attributs, ou des deux. Le caractère générique « * » peut être utilisé pour indiquer n'importe quelle valeur de combinaison d'options. L'identifiant de la combinaison d'options d'attributs peut être ignoré complètement. | Données agrégées |
| Ensemble de données | <dataset-id>.<reporting-rate-metric> | Identifiant de l’ensemble de données suivi de la mesure du taux de déclaration. Peut être REPORTING_RATE | REPORTING_RATE_ON_TIME | ACTUAL_REPORTS | ACTUAL_REPORTS_ON_TIME | EXPECTED_REPORTS. | Enregistrements de la complétude des ensembles de données |
| Élément de données de programme | <program-id>.<dataelement-id> | Identifiant du programme suivi de l'identifiant de l'élément de données. Lit les événements du programme spécifié. | Événements du programme en question |
| Indicateur de programme | <programindicator-id> | Identifiant de l’indicateur du programme. Lit les événements du programme associés à l'identifiant du programme. | Événements du programme de l'indicateur |
| Résultat de validation | <validationrule-id> | Identifiant de la règle de validation. Inclura les violations à la règle de validation et requiert que les résultats de la validation soient générés et conservés. | Résultats de validation |
Les éléments de tous les différents types dx peuvent être combinés dans une requête d'analyse. Voici un exemple :
/api/analytics.json
?dimension=dx:Uvn6LCg7dVU;BfMAe6Itzgt.REPORTING_RATE;IpHINAT79UW.a3kGcGDCuk6
&dimension=pe:LAST_12_MONTHS&filter=ou:ImspTQPwCqd
La syntaxe de groupe peut également être utilisée avec n’importe quel autre élément. Voici un exemple :
/api/analytics.json
?dimension=dx:DE_GROUP-qfxEYY9xAl6;IN_GROUP-oehv9EO3vP7;BfMAe6Itzgt.REPORTING_RATE
&dimension=pe:LAST_12_MONTHS&filter=ou:ImspTQPwCqd
Les opérandes d'élément de données peuvent éventuellement spécifier des combinaisons d'options d'attribut et utiliser des caractères génériques, par exemple pour spécifier toutes les valeurs des combinaisons d'options de catégorie :
/api/analytics.json
?dimension=dx:Uvn6LCg7dVU.*.j8vBiBqGf6O;Uvn6LCg7dVU.Z4oQs46iTeR
&dimension=pe:LAST_12_MONTHS&filter=ou:ImspTQPwCqd
Conseil
Pour apprendre à utiliser l'API d'analyse, vous pouvez utiliser l'application web DHIS2 Visualiseur de Données et créer un tableau croisé dynamique. Vous pouvez vous amuser avec des tableaux croisés dynamiques en utilisant les différentes dimensions et éléments et cliquer sur Télécharger > Source de données simples > JSON pour voir les appels de l'API analytique qui en résultent dans la barre d'adresse de votre navigateur web. >>>>
La réponse analytique contenant les données agrégées peut être renvoyée sous différents formats. Comme toujours, vous pouvez définir un format spécifique en ajoutant une extension de fichier à l'URL, via l'en-tête HTTP Accept ou via le paramètre de requête format. Le format par défaut est JSON. Les formats et types de contenu disponibles sont listés ci-dessous.
json (application/json)
jsonp (application/javascript)
xml (application/xml)
csv (application/csv)
html (texte/html)
html+css (texte/html)
xls (application/vnd.ms-excel)
À titre d'exemple, vous pouvez demander une réponse analytique au format XML, en utilisant l'URL suivante :
/api/analytics.xml?dimension=dx:fbfJHSPpUQD
&dimension=pe:2016&dimension=ou:O6uvpzGd5pu;lc3eMKXaEfw
La réponse JSON ressemblera à ceci :
{
"headers": [
{
"name": "dx",
"column": "Data",
"valueType": "TEXT",
"meta": true
},
{
"name": "pe",
"column": "Period",
"valueType": "TEXT",
"meta": true
},
{
"name": "value",
"column": "Value",
"valueType": "NUMBER",
"meta": false
}
],
"height": 4,
"metaData": {
"pe": [
"2016Q1",
"2016Q2"
],
"ou": [
"ImspTQPwCqd"
],
"names": {
"2016Q1": "Jan to Mar 2016",
"2016Q2": "Apr to Jun 2016",
"FbKK4ofIv5R": "Measles Coverage <1 y",
"ImspTQPwCqd": "Sierra Leone",
"eTDtyyaSA7f": "Fully Immunized Coverage"
}
},
"rows": [
[
"eTDtyyaSA7f",
"2016Q2",
"81.1"
],
[
"eTDtyyaSA7f",
"2016Q1",
"74.7"
],
[
"FbKK4ofIv5R",
"2016Q2",
"88.9"
],
[
"FbKK4ofIv5R",
"2016Q1",
"84.0"
]
],
"width": 3
}
La réponse représente un tableau de données dimensionnelles. L'en-tête donne un aperçu des colonnes du tableau et de leur contenu. La propriété colonne indique l'identifiant de la dimension de la colonne ou, si la colonne contient des mesures, le mot "Value". La propriété métadonnées est définie sur vrai si la colonne contient des éléments de dimension ou faux si la colonne contient une mesure (valeurs de données agrégées). La propriété nom est similaire à la propriété "colonne", à la différence qu'elle affiche "valeur" lorsque la colonne contient une mesure. La propriété type indique le type de classe Java des valeurs de la colonne.
Les propriétés hauteur et largeur indiquent respectivement le nombre de colonnes et de lignes de données contenues dans la réponse.
La propriété périodes de métadonnées contient un tableau unique et ordonné des périodes contenues dans la réponse. La propriété unité d'organisation de métadonnées contient un tableau d'identifiants d'unités d'organisation contenues dans la réponse. La propriété noms de métadonnées permet d'obtenir une correspondance entre les identifiants utilisés dans la réponse et les noms des objets qu'ils représentent. Les clients peuvent utiliser cette propriété pour remplacer les identifiants de la réponse par des noms afin d'obtenir une représentation plus claire du tableau de données.
La rubrique lignes contient le tableau des données dimensionnelles. Ce dernier est fait de colonnes dans lesquelles figurent des éléments de dimension (identifiants d'objets ou de périodes) et une colonne dans laquelle figurent des valeurs de données agrégées. L'exemple de réponse ci-dessus comporte une colonne pour les données et les indicateurs, une colonne pour les périodes et une colonne pour les valeurs. La première colonne contient les identifiants d'indicateur, la deuxième contient les identifiants de période ISO et la troisième contient les valeurs de données agrégées.
Les paramètres d'entrée que vous pouvez fournir à la ressource analytique sont soumis à plusieurs contraintes. Si l'une de ces contraintes n'est pas respectée, l'API renvoie une réponse 409 Conflict avec un message semblable à celui-ci :
{
"httpStatus": "Conflict",
"httpStatusCode": 409,
"status": "ERROR",
"message": "Only a single indicator can be specified as filter",
"errorCode": "E7108"
}
Les champs httpStatus et httpStatusCode indiquent le statut HTTP et le code de statut conformément à la spécification HTTP. Le champ message fournit une description de l'erreur de validation lisible par l'homme. Le champ errorCode fournit un code lisible par une machine que les clients peuvent utiliser pour gérer les erreurs de validation. Les erreurs de validation potentielles pour l'API d'analyse des données agrégées sont décrites dans le tableau ci-dessous.
| Code d'erreur | Message |
|---|---|
| E7100 | Les paramètres de requête ne peuvent pas être nuls |
| E7101 | Au moins une dimension doit être spécifiée |
| E7102 | Au moins un élément de dimension de données ou un élément de dimension d'ensemble de groupes d'éléments de données doit être spécifié. |
| E7103 | Les dimensions ne peuvent pas être spécifiées à la fois comme dimension et comme filtre |
| E7104 | Au moins une période doit être spécifiée comme dimension ou filtre, ou dates de début et de fin |
| E7105 | Les périodes et les dates de début et de fin ne peuvent pas être spécifiées simultanément |
| E7106 | La date de début ne peut pas être postérieure à la date de fin |
| E7107 | Des dates de début et de fin ne peuvent pas être spécifiées pour les taux de déclaration |
| E7108 | Un seul indicateur peut être spécifié comme filtre |
| E7109 | Un seul taux de déclaration peut être spécifié comme filtre |
| E7110 | Les combinaisons d'options de catégorie ne peuvent pas être spécifiées comme filtre |
| E7111 | Les dimensions ne peuvent pas être spécifiées plus d'une fois |
| E7112 | Les taux de déclaration ne peuvent être spécifiés qu'avec les dimensions de type |
| E7113 | Les catégories attribuées ne peuvent pas être spécifiées si les éléments de données ne sont pas spécifiés |
| E7114 | Les catégories attribuées ne peuvent être spécifiées qu'avec des éléments de données, et non avec des indicateurs ou des taux de déclaration. |
| E7115 | Les éléments de données doivent être d'un type de valeur et d'agrégation qui permette l'agrégation |
| E7116 | Les expressions d'indicateur ne peuvent pas contenir de références cycliques |
| E7117 | Une dimension de données 'dx' doit être spécifiée lorsque le format de sortie est DATA_VALUE_SET (ensemble de valeurs de données). |
| E7118 | Une dimension de période 'pe' doit être spécifiée lorsque le format de sortie est DATA_VALUE_SET. |
| E7119 | Une dimension d'unité d'organisation 'ou' doit être spécifiée lorsque le format de sortie est DATA_VALUE_SET. |
| E7120 | L'utilisateur n'est pas autorisé à visualiser l'unité d'organisation |
| E7121 | L'utilisateur n'est pas autorisé à lire les données de l'objet |
| E7122 | Le niveau d'approbation des données n'existe pas |
| E7123 | L'utilisateur actuel est limité par une dimension mais n'a accès à aucun élément de dimension |
| E7124 | La dimension est présente dans la requête sans aucune option de dimension valide |
| E7125 | L'identifiant de dimension ne fait référence à aucune dimension |
| E7126 | La colonne doit être présente dans la requête en tant que dimension |
| E7127 | La ligne doit être présente dans la requête en tant que dimension |
| E7128 | Les résultats de la requête ont dépassé la limite maximale |
| E7129 | Le programme est spécifié mais n'existe pas |
| E7130 | L'étape de programme est spécifiée mais n'existe pas |
| E7131 | La requête a échoué, probablement parce que la requête a expiré |
La ressource analytique dataValueSet permet de renvoyer des données agrégées dans le format "ensemble de valeurs de données". Ce format représente des valeurs de données brutes, par opposition aux données qui ont été agrégées en fonction des différentes dimensions. L'exportation de données agrégées sous la forme de valeurs de données régulières permet d'échanger des données entre systèmes lorsque le système cible contient des données d'une granularité plus fine que celles stockées par le système de destination.
Par exemple, il est possible de spécifier un indicateur dans le système cible qui va récapituler les données de plusieurs éléments de données, et d'importer ces données pour le compte d'un seul élément de données dans le système de destination. Autre exemple, l'on peut agréger les données collectées au niveau 4 de l'unité d'organisation dans le système cible au niveau 2 et importer ces données dans le système de destination.
Vous pouvez récupérer des données au format d'ensemble de valeurs de données brutes à partir de la ressource dataValueSet :
/api/analytics/dataValueSet
Les représentations de ressources suivantes sont prises en charge :
json (application/json)
xml (application/xml)
Lorsque vous utilisez le format d'ensemble de valeurs de données, exactement trois dimensions doivent être spécifiées en tant que dimensions analytiques avec au moins un élément de dimension pour chacune d'entre elles :
Données (dx)
Période (pe)
Unité d'organisation (ou)
Toute autre dimension sera ignorée. Les filtres seront appliqués de la même manière que pour les demandes d'analyse ordinaires. Notez que tout type de dimension de données peut être spécifié, notamment les indicateurs, les éléments de données, les opérandes d'éléments de données, les ensembles de données et les indicateurs de programme.
Voici un exemple de requête qui agrège des données pour des indicateurs, des périodes et des unités d'organisation spécifiques et les renvoie sous forme de valeurs de données régulières au format XML :
api/analytics/dataValueSet.xml?dimension=dx:Uvn6LCg7dVU;OdiHJayrsKo
&dimension=pe:LAST_4_QUARTERS&dimension=ou:lc3eMKXaEfw;PMa2VCrupOd
A request which aggregates data for data element operands and uses CODE as output identifier scheme looks like the below. When defining the output identifier scheme, all metadata objects part of the response are affected:
api/analytics/dataValueSet.json?dimension=dx:fbfJHSPpUQD.pq2XI5kz2BY;fbfJHSPpUQD.PT59n8BQbqM
&dimension=pe:LAST_12_MONTHS&dimension=ou:ImspTQPwCqd&outputIdScheme=CODE
When using attribute-based identifier schemes for export there is a risk of producing duplicate data values. The boolean query parameter duplicatesOnly can be used for debugging purposes to return only duplicates data values. This response can be used to clean up the duplicates:
api/analytics/dataValueSet.xml?dimension=dx:Uvn6LCg7dVU;OdiHJayrsKo
&dimension=pe:LAST_4_QUARTERS&dimension=ou:lc3eMKXaEfw&duplicatesOnly=true
La ressource analytique rawData permet de renvoyer les données stockées dans les tableaux de données analytiques sans qu'aucune agrégation ne soit effectuée. Cette ressource permet aux clients qui le souhaitent d'effectuer eux-mêmes des agrégations et des filtrages sans avoir à dénormaliser eux-mêmes les données existant dans les dimensions disponibles.
/api/analytics/rawData
Les représentations de ressources suivantes sont prises en charge :
json (application/json)
csv (application/csv)
Cette ressource respecte la syntaxe d'une ressource analytique ordinaire. Seul un sous-ensemble de paramètres de requête est pris en charge. En outre, les paramètres startDate et endDate sont disponibles. Les paramètres pris en charge sont énumérés dans le tableau ci-dessous.
Tableau : Paramètres de requête
| Paramètre de requête | Obligatoire / Remarques |
|---|---|
| dimension | Oui |
| startDate | No / aaaa-MM-jj |
| endDate | No / aaaa-MM-jj |
| skipMeta | Non |
| skipData (ignorer les données) | Non |
| hierarchyMeta (métadonnées de la hiérarchie) | Non |
| showHierarchy (afficher la hiérarchie) | Non |
| displayProperty (afficher la propriété) | Non |
| outputIdScheme (schéma d'identification de la sortie) | Non |
| outputOrgUnitIdScheme (schéma d'identification de l'unité d'organisation de sortie) | Non |
| outputDataElementIdScheme (schéma d'identification de l'élément de données de sortie) | Non |
| inputIdScheme | Non |
| userOrgUnit (unité d'organisation d'utilisateur) | Non |
Le paramètre de requête dimension définit les dimensions (colonnes du tableau) à inclure dans la réponse. Il peut éventuellement être limité par des éléments. Le paramètre de requête filter (filtre) définit les éléments et les dimensions (colonnes du tableau) qui doivent être utilisés pour filtrer la réponse.
Pour la dimension "unité d'organisation", la réponse contiendra les données associées à l'unité d'organisation et à toutes les unités d'organisation qui lui sont inférieures dans la hiérarchie (c'est-à-dire ses subordonnées). Ceci est différent de la ressource analytique ordinaire, où seules les unités d'organisation explicitement sélectionnées sont incluses dans la réponse.
Pour obtenir une réponse contenant des éléments de données, périodes et unités d'organisation spécifiques, ainsi que toutes les données relatives à deux dimensions personnalisées, vous pouvez lancer une requête de ce type :
/api/analytics/rawData.json?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU;Jtf34kNZhzP
&dimension=J5jldMd8OHv&dimension=Bpx0589u8y0
&dimension=pe:LAST_12_MONTHS
&dimension=ou:O6uvpzGd5pu;fdc6uOvgoji
Les paramètres startDate et endDate permettent de récupérer des données associées à toute période comprise entre ces dates. Avec cette méthode, nul besoin de définir explicitement toutes les périodes dans la requête :
/api/analytics/rawData.json?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU;Jtf34kNZhzP
&dimension=J5jldMd8OHv&dimension=Bpx0589u8y0
&startDate=2015-01-01&endDate=2015-12-31
&dimension=ou:O6uvpzGd5pu;fdc6uOvgoji
Le paramètre filter peut être utilisé pour filtrer une réponse sans inclure cette dimension dans la réponse, cette fois au format CSV :
/api/analytics/rawData.csv?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU;Jtf34kNZhzP
&filter=J5jldMd8OHv:uYxK4wmcPqA;tDZVQ1WtwpA
&startDate=2015-01-01&endDate=2015-12-31
&dimension=ou:O6uvpzGd5pu
Vous pouvez utiliser le paramètre outputIdScheme (schéma d'identification de la sortie) pour obtenir des données lisibles par l'homme, car il peut être défini sur NOM comme dans l'exemple suivant :
/api/analytics/rawData.csv?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&filter=J5jldMd8OHv:uYxK4wmcPqA;tDZVQ1WtwpA
&startDate=2017-01-01&endDate=2017-12-31
&dimension=ou:O6uvpzGd5pu
&outputIdScheme=NAME
La réponse de la ressource rawData est identique à celle de la ressource analytique ordinaire, à la différence qu'elle contient des données brutes et non agrégées qui peuvent être agrégées ultérieurement par des systèmes tiers.
Lors du débogage des requêtes analytiques, il peut être utile d'examiner la source des valeurs de données de la réponse analytique agrégée. La ressource analytics/debug/sql fournira une instruction SQL qui renvoie le contenu recherché du tableau des valeurs de données. Vous pouvez produire cette instruction SQL en effectuant une requête GET avec le type de contenu "text/html" ou "text/plain" comme ci-dessous. La syntaxe des dimensions et des filtres est identique à celle des requêtes analytiques ordinaires :
/api/analytics/debug/sql?dimension=dx:fbfJHSPpUQD;cYeuwXTCPkU
&filter=pe:2016Q1;2016Q2&filter=ou:O6uvpzGd5pu
L'API d'analyse d'événements vous permet d'accéder à des données d'événements agrégées et d'interroger des événements capturés dans DHIS2. Cette ressource vous permet d'extraire des événements à partir d'un programme et éventuellement d'une étape de programme. Elle vous permet également d'extraire et de filtrer des événements en fonction des différentes dimensions d'événements.
/api/analytics/events
Les dimensions d'événements comprennent les éléments de données, les attributs, les unités d'organisation et les périodes. La ressource analytique des événements agrégés renvoie des informations agrégées telles que des chiffres issus de comptages ou des moyennes. La ressource analytique de requête renvoie simplement les événements correspondant à un ensemble de critères et n'effectue aucune agrégation. Vous pouvez spécifier des éléments de dimension sous la forme d'options à partir d'ensembles d'options et de légendes à partir d'ensembles de légendes, pour les éléments de données et les attributs qui y sont associés. Les dimensions des événements sont répertoriées dans le tableau ci-dessous.
Tableau : Dimensions d'événement
| Dimension | Identifiant de la dimension | Description |
|---|---|---|
| Éléments de données | <id> | Identifiants d'élément de données |
| Attributs | <id> | Identifiants d'attribut |
| Périodes | pe | Périodes ISO et périodes relatives, voir "format de date et de période" |
| Unités d’organisation | ou | Organisation unit identifiers and keywords USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> and OU_GROUP-<group-id>. It can be staged, ie: A03MvHHogjR.ou |
| les ensembles de groupes d'unités d'organisation. | <org unit group set id> | Identifiants d'ensemble de groupes d'unités d'organisation |
| Catégories | <category id> | Identifiants de catégorie (catégories d'attributs de programme uniquement) |
L'API d'événement analytique vous permet de définir un ensemble de paramètres de requête.
Tableau : Paramètres de requête pour la requête d'événement et l'analyse d'agrégation
| Paramètre de requête | Obligatoire | Description | Options (par défaut en premier) |
|---|---|---|---|
| program | Oui | Identifiant du programme. | Tout identifiant de programme |
| étape | Non | Identifiant de l'étape de programme. | Tout identifiant d'étape de programme |
| startDate | Oui | Date de début des événements. | Les dates doivent être au format aaaa-MM-jj |
| endDate | Oui | Date de fin des événements. | Les dates doivent être au format aaaa-MM-jj |
| dimension | Oui | L'identifiant de dimension comprend les éléments de données, les attributs, les indicateurs de programme, les périodes, les unités d'organisation et les ensembles de groupes d'unités d'organisation. Le paramètre peut être répété autant de fois que nécessaire. Des filtres d'éléments peuvent être appliqués à une dimension selon le format <item-id>:<operator>:<filter>. Les valeurs des filtres ne sont pas sensibles à la casse. | Les opérateurs peuvent être EQ | GT| GE| LT| LE| NE | COMME | DANS |
| filter | Non | L'identifiant de dimension comprend les éléments de données, les attributs, les périodes, les unités d'organisation et les ensembles de groupes d'unités d'organisation. Le paramètre peut être répété autant de fois que nécessaire. Des filtres d'éléments peuvent être appliqués à une dimension selon le format <item-id>:<operator>:<filter>. Les valeurs des filtres ne sont pas sensibles à la casse. | |
| hierarchyMeta (métadonnées de la hiérarchie) | Non | Inclut les noms des unités d'organisation racines et le parcours hiérarchique des unités d'organisation dans les métadonnées. | false |
| eventStatus | Non | Spécifie le statut des événements à inclure. | ACTIVE | COMPLETED | SCHEDULE | OVERDUE | SKIPPED. La séparation peut se faire par des virgules (pour la requête uniquement). |
| programStatus | Non | Spécifie le statut d’inscription des événements à inclure. | ACTIVE | COMPLETED | CANCELLED. La séparation peut se faire par des virgules (pour la requête uniquement). |
| relativePeriodDate (Date de la période relative) | chaîne | Non | Identifiant de date, par exemple : "2016-01-01". Il remplace la date de début de la période relative |
| colonnes | Non | Dimensions à utiliser comme colonnes dans la présentation du tableau. | N'importe quelle dimension (doit être une dimension de requête) |
| lignes | Non | Dimensions à utiliser comme lignes dans la présentation du tableau. | N'importe quelle dimension (doit être une dimension de requête) |
| timeField (champ de temps) | Non | Il s'agit du champ de temps utilisé dans le cadre des agrégations/requêtes sur les événements. Il s'applique uniquement aux éléments de données d'événements. Il peut s'agir d'une option prédéfinie ou de l'identifiant d'un attribut ou d'un élément de données dont le type de valeur est temporel. Pour les points d'extrémité "/analytics/events/", le champ de temps par défaut est EVENT_DATE. | EVENT_DATE | SCHEDULED_DATE | <Attribute ID> | <Data element ID> |
** There are some cases where it's possible to request specific fields through the dimension param. They are not true dimensions, but gives a better level of flexibility. They are:
EVENT_DATE)Filters by the date an event occurred. Can be used as a root-level dimension or scoped to a specific stage.
| Value form | Exemple | Signification |
|---|---|---|
{stageUid}.EVENT_DATE:{period} | dimension=A03MvHHogjR.EVENT_DATE:202205 | Events in stage A03MvHHogjR with an event date in May 2022. |
{stageUid}.EVENT_DATE:{start}_{end} | dimension=A03MvHHogjR.EVENT_DATE:2022-05-01_2022-05-10 | Events in that stage with an event date in the given inclusive date range. |
EVENT_DATE:{period} | dimension=EVENT_DATE:2022Sep | Root-level event date filter using a financial year period. |
SCHEDULED_DATE)Filters by the date an event was scheduled (as opposed to when it actually occurred). Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
SCHEDULED_DATE:{period} | dimension=SCHEDULED_DATE:202107 | Events in the given stage with a scheduled date in July 2021. |
CREATED)Filters by when the enrollment record was created in the system. Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
CREATED:{period} | dimension=CREATED:2016Sep | Enrollments created during the financial year starting September 2016. |
COMPLETED)Filters by when the enrollment was marked as completed. Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
COMPLETED:{period} | dimension=COMPLETED:2022Sep | Enrollments completed during the financial year starting September 2022. |
EVENT_STATUS)Filters by the status of an event within a stage.
| Value form | Exemple | Signification |
|---|---|---|
{stageUid}.EVENT_STATUS:{status} | dimension=A03MvHHogjR.EVENT_STATUS:ACTIVE | Events in the stage with status ACTIVE. |
{stageUid}.EVENT_STATUS:{s1};{s2} | dimension=edqlbukwRfQ.EVENT_STATUS:COMPLETED;ACTIVE | Events with status COMPLETED or ACTIVE (OR logic). |
Valid status values: ACTIVE, COMPLETED, SCHEDULED, OVERDUE, SKIPPED.
PROGRAM_STATUS)Filters by the status of the enrollment itself (as opposed to individual events).
| Value form | Exemple | Signification |
|---|---|---|
PROGRAM_STATUS:{status} | dimension=PROGRAM_STATUS:ACTIVE | Only enrollments with the specified program status. |
Valid status values: ACTIVE, COMPLETED, CANCELLED.
Tableau : Paramètres de requête pour l'analyse des requêtes d'événement uniquement
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| ouMode | Non | The mode of selecting organisation units. Default is DESCENDANTS, meaning all sub units in the hierarchy. CHILDREN refers to immediate children in the hierarchy; SELECTED refers to the selected organisation units only. More details here | DESCENDANTS, SUBORDONNÉES, SÉLECTIONNÉES |
| asc | Non | Permet de trier les dimensions dans l'ordre croissant; peut concerner la date de l'événement, le nom et le code de l'unité d'organisation et tout identifiant d'élément. | ouname | programstatus | eventstatus | createdbydisplayname | lastupdatedbydisplayname | eventdate | enrollmentdate | incidentdate | lastupdated | item identifier |
| desc | Non | Permet de trier les dimensions dans l'ordre décroissant ; peut concerner la date de l'événement, le nom et le code de l'unité d'organisation et tout identifiant d'élément. | ouname | programstatus | eventstatus | createdbydisplayname | lastupdatedbydisplayname | eventdate | enrollmentdate | incidentdate | lastupdated | item identifier |
| coordinatesOnly (coordonnées uniquement) | Non | Indique s'il faut uniquement renvoyer les événements qui ont des coordonnées. | false |
| coordinateOuFallback (Coordonner le repli de l'uo) | Non | La géométrie de l'instance de programme est appliquée chaque fois que la géométrie de l'unité d'organisation est manquante. | false |
| dataIdScheme (schéma d'identification des données) | Non | Schéma d'identification à utiliser pour les données, plus spécifiquement pour les éléments de données et les attributs qui disposent d'un ensemble d'options ou de légendes. Ceci permet par exemple de renvoyer le nom de l'option au lieu du code, ou le nom de la légende au lieu de son ID, dans la réponse. | NAME | CODE | UID |
| en-têtes | Non | Le nom des en-têtes à renvoyer dans la réponse. | Un ou plusieurs noms d'en-têtes séparés par une virgule |
| page | Non | Le numéro de page. La page par défaut est 1. | Valeur numérique positive |
| pageSize | Non | La taille de la page. La taille par défaut est de 50 éléments par page. | Zéro ou valeur positive |
| eventDate | no | Events resource only. Custom period on eventDate. See "custom date periods" section. | See "date and period format" section |
| enrollmentDate (date d'inscription) | no | Custom period on enrollmentDate. See "custom date periods" section. | See "date and period format" section |
| scheduledDate (date de programmation) | no | Events resource only. Custom period on scheduledDate. See "custom date periods" section. | See "date and period format" section |
| incidentDate (date d'incident) | no | Custom period on incidentDate. See "custom date periods" section. | See "date and period format" section |
| lastUpdated (dernière mise à jour) | no | Custom period on lastUpdated. See "custom date periods" section. | See "date and period format" section |
Tableau : Paramètres de requête pour l'analyse agrégée des événements uniquement
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| value | Non | Il s'agit de l'identifiant de la dimension de valeur ; peut être un élément de données ou un attribut qui doit être de type numérique. | Data element or attribute identifier. It can stage scoped, ie: value=stageId.dimensionid |
| Type d'agrégation | Non | Type d'agrégation pour la dimension de valeur. Par défaut, il est définit sur AVERAGE (moyenne). | SUM | AVERAGE | AVERAGE_SUM_ORG_UNIT | LAST | LAST_AVERAGE_ORG_UNIT | COUNT | STDDEV | VARIANCE | MIN | MAX |
| showHierarchy (afficher la hiérarchie) | Non | Affiche le parcours hiérarchique complet de l'unité d'organisation ainsi que le nom de l'unité d'organisation. | false |
| displayProperty (afficher la propriété) | Non | Affiche la propriété des métadonnées. | NAME | SHORTNAME |
| sortOrder | Non | Trie les enregistrements de la colonne de valeurs par ordre croissant ou décroissant. | ASC | DESC |
| limite | Non | Le nombre maximum d'enregistrements à renvoyer. Ne peut pas dépasser 10 000. | Valeur numérique positive |
| outputType (type de sortie) | Non | Spécifie le type de sortie pour les données d'analyse. Il peut s'agir d'événements, d'inscriptions ou d'instances d'entité suivie. Les deux dernières options s'appliquent aux programmes avec inscription uniquement. | EVENT | ENROLLMENT | TRACKED_ENTITY_INSTANCE |
| collapseDataDimensions (Dimensions des données regroupées) | Non | Réduit toutes les dimensions de données (éléments de données et attributs) en une seule dimension dans la réponse. | false |
| skipMeta | Non | Exclut la partie métadonnées de la réponse (améliore les performances). | false |
| skipData (ignorer les données) | Non | Excluez la partie données de la réponse. | false |
| skipRounding (ignorer l'arrondissement des valeurs) | Non | Évite d'arrondir les valeurs de données agrégées. | false |
| aggregateData (données agrégées) | Non | Produit des valeurs agrégées pour les dimensions de données (par opposition aux éléments de dimension). | false |
| orgUnitField | Non | Le champ d’unité d’organisation sur lequel baser l’agrégation des événements. ceci s'applique uniquement aux éléments de données d'événements. Il peut s'agir de l’ID d’un attribut ou d’un élément de données avec le type de valeur "Unité d’organisation". L'option par défaut consiste à omettre le paramètre de requête. | <Attribute ID> | <Data element ID> | REGISTRATION | ENROLLMENT | OWNER_AT_START | OWNER_AT_END |
Tableau : Paramètres de requête pour les analyses d'événements en grappes uniquement
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| clusterSize (taille des grappes) | Oui | Taille des grappes en mètres. | Valeur numérique positive |
| coordinateField (champs de coordonnées) | Non | Champ à partir duquel les analyses d'événements géospatiaux sont effectuées. La valeur par défaut est " événement ". Il peut être défini comme identifiant d'attributs et d'éléments de données de type coordonnées. | EVENT | <attribute-id> | <dataelement-id> |
| bbox | Oui | Zone de délimitation des événements à inclure dans la réponse au format "longitude minimale, latitude minimale, longitude maximale, latitude maximale". | Chaîne |
| includeClusterPoints (Inclure les points d'assemblage) | Non | Inclut des informations sur les points sous-jacents pour chaque grappe. Faites attention si la grappe représente un très grand nombre de points. | false |
La ressource analytics/events/query vous permet d'effectuer des requêtes sur des événements capturés. Cette ressource n'effectue pas d'agrégation ; elle vous permet plutôt de lancer des requêtes et de filtrer les informations sur les événements.
/api/analytics/events/query
Vous pouvez spécifier un nombre quelconque de dimensions et de filtres dans une requête. Les identifiants d'éléments de dimension peuvent faire référence à des éléments de données, des attributs de personnes, des identifiants de personnes, des périodes fixes et relatives et des unités d'organisation. Les dimensions peuvent éventuellement être accompagnées d'un opérateur de requête et d'un filtre. Les requêtes d'événements doivent respecter le format décrit ci-dessous.
/api/analytics/events/query/<program-id>?startDate=yyyy-MM-dd&endDate=yyyy-MM-dd
&dimension=ou:<ou-id>;<ou-id>&dimension=<item-id>&dimension=<item-id>:<operator>:<filter>
Par exemple, pour extraire des événements du programme "Morbidité et mortalité chez les patients hospitalisés" entre janvier et octobre 2016, où les éléments de données "Sexe" et "Âge" sont inclus et où la dimension "Âge" est filtrée sur "18 ans", vous pouvez utiliser la requête suivante :
/api/analytics/events/query/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:O6uvpzGd5pu;fdc6uOvgoji&dimension=oZg33kd9taw&dimension=qrur9Dvnyt5:EQ:18
Pour extraire les événements de l'étape "Naissance" du "Programme pour les enfants" entre mars et décembre 2016, où l'élément de données "Poids" est filtré pour les valeurs supérieures à 2000, vous pouvez utiliser ce qui suit :
/api/analytics/events/query/IpHINAT79UW?stage=A03MvHHogjR&startDate=2016-03-01
&endDate=2016-12-31&dimension=ou:O6uvpzGd5pu&dimension=UXz7xuGCEhU:GT:2000
Le tri peut être appliqué à la requête pour la date de l'événement et toutes les dimensions. Pour effectuer un tri par ordre décroissant sur la date de l'événement et par ordre croissant sur la dimension de l'élément de données "Âge", vous pouvez utiliser ceci :
/api/analytics/events/query/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:O6uvpzGd5pu&dimension=qrur9Dvnyt5&desc=EVENTDATE&asc=qrur9Dvnyt5
Vous pouvez appliquer la pagination à la requête à travers les paramètres de numéro de page et de taille de page. Si le numéro de page est spécifié mais que la taille de la page ne l'est pas, la taille de page "50" sera utilisée. Si la taille de la page est spécifiée mais que le numéro de page ne l'est pas, le numéro de page "1" sera utilisé. Pour obtenir la troisième page de la réponse avec une taille de page de 20, vous pouvez utiliser la requête suivante :
/api/analytics/events/query/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:O6uvpzGd5pu&dimension=qrur9Dvnyt5&page=3&pageSize=20
Des filtres peuvent être appliqués aux éléments de données, aux attributs de personnes et aux identifiants de personnes. Le filtrage est effectué par le biais de la valeur du paramètre de la requête dans le format suivant :
&dimension=<item-id>:<operator>:<filter-value>
À titre d'exemple, vous pouvez filtrer l'élément de données "Poids" pour les valeurs supérieures à 2000 et inférieures à 4000 comme suit :
&dimension=UXz7xuGCEhU:GT:2000&dimension=UXz7xuGCEhU:LT:4000
Vous pouvez filtrer l'élément de données "Âge" pour plusieurs âges spécifiques à l'aide de l'opérateur IN comme dans l'exemple suivant :
&dimension=qrur9Dvnyt5:IN:18;19;20
Vous pouvez spécifier plusieurs filtres pour un élément donné en répétant les composants de l'opérateur et du filtre, tous séparés par des points-virgules :
&dimension=qrur9Dvnyt5:GT:5:LT:15
Les opérateurs disponibles sont répertoriés ci-dessous.
Tableau : Opérateurs de filtre
| Opérateur | Description |
|---|---|
| EQ | Egal à |
| !EQ | Pas égal à |
| IEQ | Égal à, en ignorant la casse |
| !IEQ | Différent de, ignorant la casse |
| GT | Supérieur à |
| GE | Supérieur ou égal à |
| LT | Inférieur à |
| LE | inférieur ou égal à |
| NE | Pas égal à |
| LIKE | Pareil (correspondance textuelle) |
| !LIKE | Pas pareil (correspondance textuelle) |
| ILIKE | Pareil ; ignore la casse (correspondance textuelle) |
| !ILIKE | Pas pareil ; ignore la casse (correspondance textuelle) |
| IN | Égal à l'une des multiples valeurs séparées par ";" |
Par défaut, les points d'extrémité query (requête) filtrent les périodes sur la base de eventDate (date de l'événement). Il est également possible de filtrer les entrées en fonction de lastUpdated (dernière mise à jour) ou de schedule (programmation), en utilisant le paramètre de requête timeField (champ de temps). Par exemple :
&timeField=LAST_UPDATED
&timeField=SCHEDULED_DATE
Par défaut, enhancedConditions (conditions améliorées) est défini sur false. Cela signifie que toutes les conditions exprimées dans dimension et filtre sont considérées comme des conditions AND (et). Par exemple :
dimension=a:GT:20:LT:40&dimension=b:GT:1:LT:5
se traduit par la condition logique suivante :
a>20 and a<40 and b>1 and b<5
Cependant, dans certains cas, il peut être nécessaire d'avoir plus de contrôle sur les conditions. Vous pouvez activer ce contrôle en définissant le paramètre de requête enhancedConditions sur true. En procédant ainsi, un client peut utiliser un séparateur spécial _OR_ pour joindre des conditions en utilisant l'opérateur logique OR (ou).
Exemple:
dimension=a:GT:20:LT:40_OR_b:GT:1:LT:5&dimension=c:EQ:test
se traduit par la condition logique suivante :
((a>20 and a<40) or (b>1 and b<5)) and c = "test"
Le format de représentation de réponse par défaut est JSON. Les requêtes doivent utiliser la méthode HTTP GET. Les formats de réponse suivants sont pris en charge.
json (application/json)
jsonp (application/javascript)
xls (application/vnd.ms-excel)
À titre d'exemple, pour obtenir une réponse au format Excel, vous pouvez utiliser une extension de fichier dans l'URL de la requête comme ceci :
/api/analytics/events/query/eBAyeGv0exc.xls?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:O6uvpzGd5pu&dimension=oZg33kd9taw&dimension=qrur9Dvnyt5
Vous pouvez définir le paramètre de requête hierarchyMeta (hiérarchie de métadonnées) sur "true" pour inclure les noms de toutes les unités d'organisation ascendantes dans la section métadonnées de la réponse :
/api/analytics/events/query/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:YuQRtpLP10I&dimension=qrur9Dvnyt5:EQ:50&hierarchyMeta=true
Le format JSON de réponse par défaut ressemblera à ceci :
{
"headers": [
{
"name": "psi",
"column": "Event",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "ps",
"column": "Program stage",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "eventdate",
"column": "Event date",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "storedby",
"column": "Stored by",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "lastupdated",
"column": "Last Updated",
"valueType": "DATE",
"hidden": false,
"meta": true
},
{
"name": "createdbydisplayname",
"column": "Created by (display name)",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "lastupdatedbydisplayname",
"column": "Last updated by (display name)",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "coordinates",
"column": "Coordinates",
"valueType": "COORDINATE",
"hidden": false,
"meta": false
},
{
"name": "ouname",
"column": "Organisation unit name",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "oucode",
"column": "Organisation unit code",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "ou",
"column": "Organisation unit",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "oZg33kd9taw",
"column": "Gender",
"valueType": "TEXT",
"hidden": false,
"meta": false
},
{
"name": "qrur9Dvnyt5",
"column": "Age",
"valueType": "TEXT",
"hidden": false,
"meta": false
}
],
"metaData": {
"names": {
"qrur9Dvnyt5": "Age",
"eBAyeGv0exc": "Inpatient morbidity and mortality",
"ImspTQPwCqd": "Sierra Leone",
"O6uvpzGd5pu": "Bo",
"YuQRtpLP10I": "Badjia",
"oZg33kd9taw": "Gender"
},
"ouHierarchy": {
"YuQRtpLP10I": "/ImspTQPwCqd/O6uvpzGd5pu"
}
},
"width": 8,
"height": 4,
"rows": [
[
"yx9IDINf82o",
"Zj7UnCAulEk",
"2016-08-05",
"system",
"2018-08-07",
"[5.12, 1.23]",
"Ngelehun",
"OU_559",
"YuQRtpLP10I",
"Female",
"50"
],
[
"IPNa7AsCyFt",
"Zj7UnCAulEk",
"2016-06-12",
"system",
"2018-08-07",
"[5.22, 1.43]",
"Ngelehun",
"OU_559",
"YuQRtpLP10I",
"Female",
"50"
],
[
"ZY9JL9dkhD2",
"Zj7UnCAulEk",
"2016-06-15",
"system",
"2018-08-07",
"[5.42, 1.33]",
"Ngelehun",
"OU_559",
"YuQRtpLP10I",
"Female",
"50"
],
[
"MYvh4WAUdWt",
"Zj7UnCAulEk",
"2016-06-16",
"system",
"2018-08-07",
"[5.32, 1.53]",
"Ngelehun",
"OU_559",
"YuQRtpLP10I",
"Female",
"50"
]
]
}
La section en-têtes de la réponse décrit le contenu du résultat de la requête. L'identifiant unique de l'événement, l'identifiant de l'étape de programme, la date de l'événement, le nom de l'unité d'organisation, le code de l'unité d'organisation et l'identifiant de l'unité d'organisation apparaissent en tant que six premières dimensions dans la réponse et seront toujours présents. Viennent ensuite les éléments de données, les attributs et identifiants de personnes qui ont été définis comme dimensions dans la demande ; il s'agit dans ce cas précis des dimensions d'éléments de données "Sexe" et "Âge". L'identifiant de l'élément de dimension se trouve dans la propriété "nom" et une description lisible de la dimension dans la propriété "colonne" de la section d'en-têtes.
La section metaData, objet ou (unité d'organisation), contient les identifiants de toutes les unités d'organisation présentes dans la réponse, mis en correspondance avec une chaîne qui représente la hiérarchie. Cette chaîne hiérarchique énumère les identifiants des ascendants de l'unité d'organisation en commençant par la racine. L'objet noms contient les identifiants de tous les éléments de la réponse mis en correspondance avec leurs noms.
La section lignes contient les événements produits par la requête. Chaque ligne représente exactement un événement.
Pour que la ressource analytique des événements génère les données dans un tableau tout fait, vous pouvez renseigner les paramètres lignes et colonnes avec les identifiants des dimensions requises. Ces identifiants doivent être séparés par des points-virgules ; elles serviront de valeurs pour indiquer quelles dimensions doivent être utilisées comme colonnes ou lignes du tableau. Au lieu de générer une source de données simples et normalisées, la ressource analytique d'événements va maintenant générer les données dans un tableau. Dans la requête, les dimensions de colonnes et de lignes doivent figurer en tant que dimensions de données (et non en tant que filtre). Une telle requête peut ressembler à ceci :
/api/analytics.html+css?dimension=dx:cYeuwXTCPkU;fbfJHSPpUQD&dimension=pe:WEEKS_THIS_YEAR
&filter=ou:ImspTQPwCqd&displayProperty=SHORTNAME&columns=dx&rows=pe
La ressource /analytics/events/aggregate vous permet d'extraire des nombres agrégés d'événements capturés dans DHIS2. Cette ressource vous permet d'extraire des données agrégées liés à un programme spécifique ou éventuellement à une étape de programme. Elle vous permet également d'effectuer des filtrages en fonction de toute dimension d'événement.
/api/analytics/events/aggregate
La ressource d'agrégation des événements ne renvoie pas les informations relatives à l'événement lui-même, mais plutôt les nombres agrégés d'événements correspondant à la requête. Les dimensions d'événements comprennent les éléments de données, les attributs de personnes, les identifiants de personnes, les périodes et les unités d'organisation. Les requêtes d'agrégation des événements doivent respecter le format décrit ci-dessous.
/api/analytics/events/aggregate/<program-id>?startDate=yyyy-MM-dd&endDate=yyyy-MM-dd
&dimension=ou:<ou-id>;<ou-id>&dimension=<item-id>&dimension=<item-id>:<operator>:<filter>
Par exemple, pour extraire des nombres agrégés des événements du programme "Morbidité et mortalité chez les patients hospitalisés" entre janvier et octobre 2016, où les éléments de données "Sexe" et "Âge" sont inclus, avec l'élément de dimension "Âge" filtré sur "18 ans" et l'élément de dimension "Sexe" filtré sur "Femme", vous pouvez utiliser la requête suivante :
/api/analytics/events/aggregate/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:O6uvpzGd5pu&dimension=oZg33kd9taw:EQ:Female&dimension=qrur9Dvnyt5:GT:50
Pour extraire des données relatives à des périodes fixes et relatives au lieu des dates de début et de fin, dans ce cas, mai 2016 et les 12 derniers mois, et l'unité d'organisation associée à l'utilisateur actuel, vous pouvez utiliser la requête suivante :
/api/analytics/events/aggregate/eBAyeGv0exc?dimension=pe:201605;LAST_12_MONTHS
&dimension=ou:USER_ORGUNIT;fdc6uOvgo7ji&dimension=oZg33kd9taw
Afin de spécifier "Femme" comme filtre pour le "Sexe" dans la réponse, ce qui signifie que "Sexe" ne fera pas partie de la réponse mais filtrera les nombres agrégés qu'il contient, vous pouvez utiliser la syntaxe suivante :
/api/analytics/events/aggregate/eBAyeGv0exc?dimension=pe:2016;
&dimension=ou:O6uvpzGd5pu&filter=oZg33kd9taw:EQ:Female
Pour spécifier l'unité d'organisation "Bo" et la période "2016" comme filtres, et le "Mode de sortie" et le "Sexe" comme dimensions, où le "Sexe" est filtré en fonction de l'élément "Masculin", vous pouvez utiliser la requête suivante :
/api/analytics/events/aggregate/eBAyeGv0exc?filter=pe:2016&filter=ou:O6uvpzGd5pu
&dimension=fWIAEtYVEGk&dimension=oZg33kd9taw:EQ:Male
Pour créer un "rapport de Top 3" pour le Mode de sortie, vous pouvez utiliser les paramètres de requête "limit" (limite) et sortOrder (ordre de tri) de la manière suivante :
/api/analytics/events/aggregate/eBAyeGv0exc?filter=pe:2016&filter=ou:O6uvpzGd5pu
&dimension=fWIAEtYVEGk&limit=3&sortOrder=DESC
Pour spécifier une dimension de valeur avec un type d'agrégation correspondant, vous pouvez utiliser les paramètres de requête "value" (valeur) et "aggregationType" (type d'aggrégation). En spécifiant une dimension de valeur, le moteur d'analyse renverra des valeurs agrégées pour les valeurs de cette dimension dans la réponse, plutôt que des nombres d'événements.
/api/analytics/events/aggregate/eBAyeGv0exc.json?stage=Zj7UnCAulEk
&dimension=ou:ImspTQPwCqd&dimension=pe:LAST_12_MONTHS&dimension=fWIAEtYVEGk
&value=qrur9Dvnyt5&aggregationType=AVERAGE
Pour que l'agrégation des analyses d'événements se fasse en fonction d'un élément de données ou d'un attribut spécifique de type 'date' ou 'date et heure', vous pouvez utiliser le paramètre timeField (champ de temps) :
/api/analytics/events/aggregate/IpHINAT79UW.json?dimension=ou:ImspTQPwCqd
&dimension=pe:LAST_12_MONTHS&dimension=cejWyOfXge6&stage=A03MvHHogjR
&timeField=ENROLLMENT_DATE
Pour que l'agrégation des analyses d'événements se fasse en fonction d'un élément de données ou d'un attribut spécifique de type 'unité d'organisation', vous pouvez utiliser le paramètre orgUnitField (champ d'unité d'organisation) :
/api/analytics/events/aggregate/eBAyeGv0exc.json?dimension=ou:ImspTQPwCqd
&dimension=pe:THIS_YEAR&dimension=oZg33kd9taw&stage=Zj7UnCAulEk
&orgUnitField=S33cRBsnXPo
Voici quelques valeurs possibles pour le paramètre orgUnitField :
| orgUnitField | Description |
|---|---|
| <Attribute ID> | ID d'un attribut de type de valeur 'unité d'organisation' |
| <Data element ID> | ID d'un élément de données de type de valeur 'unité d'organisation' |
| ENREGISTREMENT | L'unité d'organisation dans laquelle l'instance d'entité suivie a été enregistrée (créée) |
| ENROLLMENT | L'unité d'organisation dans laquelle l'instance d'entité suivie a été inscrite au programme |
| OWNER_AT_START (propriétaire au début) | L'unité d'organisation propriétaire de l'instance d'entité suivie au début de la période de déclaration. |
| OWNER_AT_END (propriétaire à la fin) | L'unité d'organisation propriétaire de l'instance d'entité suivie à la fin de la période de déclaration. |
Pour les requêtes d'agrégation, vous pouvez spécifier une plage ou un ensemble de légendes pour les éléments de données numériques et les dimensions d'attributs. L'objectif est de regrouper les valeurs numériques dans des plages. Par exemple, au lieu de générer des données pour un élément de données "Âge" pour des années différentes, vous pouvez regrouper les informations par tranche d'âge. Pour ce faire, l'élément de données ou l'attribut doit être associé à l'ensemble de légendes. Le format est décrit ci-dessous :
?dimension=<item-id>-<legend-set-id>
Voici donc un exemple :
/api/analytics/events/aggregate/eBAyeGv0exc.json?stage=Zj7UnCAulEk
&dimension=qrur9Dvnyt5-Yf6UHoPkdS6&dimension=ou:ImspTQPwCqd&dimension=pe:LAST_MONTH
Le format de représentation de réponse par défaut est JSON. Les requêtes doivent utiliser la méthode HTTP GET. La réponse va ressembler à ceci :
{
"headers": [
{
"name": "oZg33kd9taw",
"column": "Gender",
"valueType": "TEXT",
"meta": false
},
{
"name": "qrur9Dvnyt5",
"column": "Age",
"valueType": "TEXT",
"meta": false
},
{
"name": "pe",
"column": "Period",
"valueType": "TEXT",
"meta": false
},
{
"name": "ou",
"column": "Organisation unit",
"valueType": "TEXT",
"meta": false
},
{
"name": "value",
"column": "Value",
"valueType": "TEXT",
"meta": false
}
],
"metaData": {
"names": {
"eBAyeGv0exc": "Inpatient morbidity and mortality"
}
},
"width": 5,
"height": 39,
"rows": [
[
"Female",
"95",
"201605",
"O6uvpzGd5pu",
"2"
],
[
"Female",
"63",
"201605",
"O6uvpzGd5pu",
"2"
],
[
"Female",
"67",
"201605",
"O6uvpzGd5pu",
"1"
],
[
"Female",
"71",
"201605",
"O6uvpzGd5pu",
"1"
],
[
"Female",
"75",
"201605",
"O6uvpzGd5pu",
"14"
],
[
"Female",
"73",
"201605",
"O6uvpzGd5pu",
"5"
]
]
}
La limite maximale de lignes que peut comporter une réponse est de 10 000. Si la requête produit plus que la limite maximale, un code de statut 409 Conflict sera renvoyé.
La ressource analytics/events/cluster fournit des données géospatiales en grappes. Une requête se présente comme suit :
/api/analytics/events/cluster/eBAyeGv0exc?startDate=2016-01-01&endDate=2016-10-31
&dimension=ou:LEVEL-2&clusterSize=100000
&bbox=-13.2682125,7.3721619,-10.4261178,9.904012&includeClusterPoints=false
La réponse fournit le nombre de points sous-jacents, le point central et l'étendue de chaque grappe. Si le paramètre de requête includeClusterPoints (inclure des points en grappe) est défini sur 'true' (vrai), une chaîne contenant les identifiants des événements sous-jacents, séparés par des virgules, sera incluse dans la réponse. Voici un exemple de réponse :
{
"headers": [
{
"name": "count",
"column": "Count",
"valueType": "INTEGER",
"meta": false
},
{
"name": "center",
"column": "Center",
"valueType": "TEXT",
"meta": false
},
{
"name": "extent",
"column": "Extent",
"valueType": "TEXT",
"meta": false
},
{
"name": "points",
"column": "Points",
"valueType": "TEXT",
"meta": false
}
],
"width": 3,
"height": 4,
"rows": [
[
"3",
"POINT(-13.15818 8.47567)",
"BOX(-13.26821 8.4St7215,-13.08711 8.47807)",
""
],
[
"9",
"POINT(-13.11184 8.66424)",
"BOX(-13.24982 8.51961,-13.05816 8.87696)",
""
],
[
"1",
"POINT(-12.46144 7.50597)",
"BOX(-12.46144 7.50597,-12.46144 7.50597)",
""
],
[
"7",
"POINT(-12.47964 8.21533)",
"BOX(-12.91769 7.66775,-12.21011 8.49713)",
""
]
]
}
La ressource analytics/events/count est utilisée pour les requêtes de géométrie afin d'obtenir le nombre et l'étendue (zone de délimitation) des événements pour une requête spécifique. La syntaxe de la requête est identique à celle de la ressource events/query. Voici l'exemple d'une requête :
/api/analytics/events/count/eBAyeGv0exc?startDate=2016-01-01
&endDate=2016-10-31&dimension=ou:O6uvpzGd5pu
La réponse va fournir le nombre et l'étendue dans le format JSON :
{
"extent": "BOX(-13.2682125910096 7.38679562779441,-10.4261178860988 9.90401290212795)",
"count": 59
}
Les paramètres d'entrée que vous pouvez fournir à la ressource d'analyse des événements sont soumis à plusieurs contraintes. Si l'une de ces contraintes n'est pas respectée, l'API renvoie une réponse 409 Conflict avec un message semblable à celui-ci :
{
"httpStatus": "Conflict",
"httpStatusCode": 409,
"status": "ERROR",
"message": "At least one organisation unit must be specified",
"errorCode": "E7200"
}
Les erreurs de validation possibles pour l'API d'analyse d'événements sont décrites dans le tableau ci-dessous.
| Code d'erreur | Message |
|---|---|
| E7200 | Au moins une unité d'organisation doit être spécifiée |
| E7201 | Les dimensions ne peuvent pas être spécifiées plus d'une fois |
| E7202 | Les éléments de la requête ne peuvent pas être spécifiés plus d'une fois |
| E7203 | Une dimension de valeur ne peut pas être spécifiée en tant qu'élément ou filtre d'élément. |
| E7204 | La dimension de valeur ou les données agrégées doivent être spécifiées lorsque le type d'agrégation est spécifié. |
| E7205 | Les dates de début et de fin ou au moins une période doivent être spécifiées. |
| E7206 | La date de début est postérieure à la date de fin |
| E7207 | Le numéro de page doit être un nombre positif |
| E7208 | La taille de la page doit être zéro ou un nombre positif |
| E7209 | La limite est supérieure à la limite maximale |
| E7210 | Le champ de l'heure n'est pas valide |
| E7211 | Le champ de l'unité d'organisation n'est pas valide |
| E7212 | La taille de la grappe doit être un nombre positif |
| E7213 | La zone de délimitation n'est pas valide ; elle doit être au format : 'min-lng,min-lat,max-lng,max-lat' |
| E7214 | Le champ de la grappe doit être renseigné lorsque la zone de délimitation ou la taille de la grappe sont spécifiées. |
| E7215 | L'élément de requête ne peut pas spécifier à la fois un ensemble de légendes et un ensemble d'options. |
| E7216 | L'élément de requête doit pouvoir être agrégé lorsqu'il est utilisé dans une requête agrégée. |
| E7217 | L'utilisateur n'est pas autorisé à consulter les données d'analyse des événements |
| E7218 | Les bases de données spatiales ne sont pas activées |
| E7219 | L'élément de données doit être de type "coordonnée" pour pouvoir être utilisé comme champ de coordonnées. |
| E7220 | L'attribut doit être de type "coordonnée" pour pouvoir être utilisé comme champ de coordonnées. |
| E7221 | Le champ de coordonnées n'est pas valide |
| E7222 | L'élément de requête ou le filtre n'est pas valide |
| E7223 | La valeur ne fait pas référence à un élément de données ou à un attribut qui sont numériques et font partie du programme. |
| E7224 | L'identifiant d'élément ne fait référence à aucun élément de données, attribut ou indicateur qui fait partie du programme. |
| E7225 | L'étape de programme est obligatoire pour les dimensions de l'élément de données, dans les requêtes d'analyse d'inscriptions. |
| E7226 | La dimension n'est pas un élément de requête valide |
| E7227 | Le type d'entité 'relation' n'est pas pris en charge |
| E7228 | Le champ de coordonnées de repli n'est pas valide |
| E7229 | L'opérateur n'autorise pas les valeurs manquantes |
| E7230 | Header param does not exist |
| E7231 | Legacy can be updated only through event visualizations |
| E7232 | Le champ de coordonnées de repli n'est pas valide |
| E7234 | Query filter is not valid for query item value type |
| E7235 | Either programId or programStageId must be specified |
| E7236 | Program stage is not associated to program |
| E7237 | Sorting must have a valid dimension and a direction |
| E7238 | Sorting dimension is not a column |
| E7239 | Invalid operator for 'null' value |
| E7240 | Event query with org unit ownership does not support time fields |
| E7241 | Stage parameter cannot be used with stage-specific dimension identifiers |
| E7242 | Period dimension cannot be used with stage-specific date dimensions (ie: EVENT_DATE, SCHEDULED_DATE) |
| E7243 | Duplicate stage dimension identifier |
| E7244 | Multiple stages in stage-specific dimensions are not allowed |
| E7245 | Program stage does not belong to program |
L'API d'analyse des inscriptions vous permet d'accéder aux données agrégées des événements et d'interroger les inscriptions avec leurs données d'événements capturées dans DHIS2. Cette ressource vous permet d'extraire des données d'un programme à partir des étapes du programme et des éléments de données, en plus des attributs d'entités suivies. Lorsque vous effectuez une requête sur des données d'événements pour des étapes spécifiques d'un programme au sein de chaque inscription, les valeurs des éléments de données pour chaque étape du programme seront renvoyées dans une même ligne dans la réponse de l'API. Si vous effectuez une requête sur un élément de données dans une étape répétable du programme, la valeur la plus récente de l'élément de données sera utilisée pour cet élément de données dans la réponse de l'API.
Les dimensions d'inscription comprennent les éléments de données, les attributs, les unités d'organisation et les périodes. La ressource d'analyse des requêtes renvoie simplement les inscriptions correspondant à un ensemble de critères et n'effectue aucune agrégation.
Tableau : Dimensions dl'inscription
| Dimension | Identifiant de la dimension | Description |
|---|---|---|
| Éléments de données dans les étapes du programme | <program stage id>.<data element id> | Les identifiants des éléments de données doivent inclure l'étape de programme lors de la requête de données pour les inscriptions. |
| dimension=edqlbukwRfQ.vANAXwtLwcT | ||
| Attributs | <id> | Identifiants d'attribut |
| Périodes | pe | Périodes ISO et périodes relatives, voir "format de date et de période" |
| Unités d’organisation | ou | Identifiants d'unité d'organisation et mots-clés USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> et OU_GROUP-<group-id> |
L'identifiant de l'élément de données doit inclure l'étape de programme. L'étape de programme peut être répétée. Par exemple, la dimension edqlbukwRfQ.vANAXwtLwcT peut faire référence à une étape de programme répétable. L'élément de données de cette étape est accessible via les paramètres d'index (entourés de [ ]).
Tableau : Possibilités d'indexation des étapes répétables
| Dimension | Paramètres d'index | La valeur de l'élément de données est |
|---|---|---|
| edqlbukwRfQ.vANAXwtLwcT | N/A | date de la dernière exécution |
| edqlbukwRfQ[0].vANAXwtLwcT | 0 | date de la dernière exécution |
| dqlbukwRfQ[-2].vANAXwtLwcT | -2 | deuxième à partir de la dernière date d'exécution |
| dqlbukwRfQ[1].vANAXwtLwcT | 1 | date de la première exécution |
| dqlbukwRfQ[3].vANAXwtLwcT | 3 | date de la troisième exécution |
Avertissement : L'indexation d'une étape de programme non répétable entraîne une erreur de validation des paramètres.
La ressource analytics/enrollments/query vous permet d'effectuer des requêtes sur des inscriptions capturés. Cette ressource n'effectue pas d'agrégation ; elle vous permet plutôt de lancer des requêtes et de filtrer les informations sur les inscriptions.
/api/analytics/enrollments/query
Vous pouvez spécifier un nombre quelconque de dimensions et de filtres dans une requête. Les identifiants d'éléments de dimension peuvent faire référence à tout élément de données dans des étapes de programme, des attributs de personnes, des périodes fixes et relatives et des unités d'organisation. Les dimensions peuvent éventuellement être accompagnées d'un opérateur de requête et d'un filtre. Les requêtes d'inscription doivent respecter le format décrit ci-dessous.
/api/analytics/enrollments/query/<program-id>?startDate=yyyy-MM-dd&endDate=yyyy-MM-dd
&dimension=ou:<ou-id>;<ou-id>&dimension=<item-id>&dimension=<item-id>:<operator>:<filter>
Par exemple, pour extraire des inscriptions au programme "Soins prénatals" à partir de janvier 2019, où le "Prénom" est tiré des attributs, les éléments de données "Maladies chroniques" et "Tabagisme" sont inclus à partir de la première étape du programme, la "Valeur de l'hémoglobine" à partir de l'étape suivante du programme, et où seules les femmes atteintes de "Maladies chroniques" sont incluses, vous pouvez utiliser la requête suivante :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.json
?dimension=ou:ImspTQPwCqd
&dimension=w75KJ2mc4zz
&dimension=WZbXY0S00lP.de0FEHSIoxh:eq:1
&dimension=w75KJ2mc4zz
&dimension=WZbXY0S00lP.sWoqcoByYmD
&dimension=edqlbukwRfQ.vANAXwtLwcT
&startDate=2019-01-01&endDate=2019-01-31
Pour extraire des inscriptions au programme "Soins prénatals" à partir du mois dernier (par rapport au moment où la requête est effectuée), où les éléments de données "Maladies chroniques" et "Tabagisme" sont inclus à partir de la première étape du programme, et "Valeur de l'hémoglobine" à partir de l'étape de suivi du programme, et où seules les femmes fumeuses avec un taux d'hémoglobine inférieur à 20 sont prises en compte :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.json
?dimension=ou:ImspTQPwCqd
&dimension=WZbXY0S00lP.de0FEHSIoxh&dimension=w75KJ2mc4zz
&dimension=WZbXY0S00lP.sWoqcoByYmD:eq:1
&dimension=edqlbukwRfQ.vANAXwtLwcT:lt:20
&dimension=pe:LAST_MONTH
Un tri peut être appliqué à la requête pour les dates d'inscription et d'incident :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.xls
?dimension=ou:ImspTQPwCqd
&columns=w75KJ2mc4zz&dimension=WZbXY0S00lP.sWoqcoByYmD
&dimension=pe:LAST_MONTH
&stage=WZbXY0S00lP&pageSize=10
&page=1
&asc=ENROLLMENTDATE
&ouMode=DESCENDANTS
Vous pouvez appliquer la pagination à la requête à travers les paramètres de numéro de page et de taille de page. Si le numéro de page est spécifié mais que la taille de la page ne l'est pas, la taille de page "50" sera utilisée. Si la taille de la page est spécifiée mais que le numéro de page ne l'est pas, le numéro de page "1" sera utilisé. Pour obtenir la deuxième page de la réponse avec une taille de page de 10, vous pouvez utiliser la requête suivante :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.json
?dimension=ou:ImspTQPwCqd
&dimension=WZbXY0S00lP.de0FEHSIoxh
&dimension=w75KJ2mc4zz
&dimension=pe:LAST_MONTH
&dimension=WZbXY0S00lP.sWoqcoByYmD&pageSize=10
&page=2
Des filtres peuvent être appliqués aux éléments de données, aux attributs de personnes et aux identifiants de personnes. Le filtrage est effectué par le biais de la valeur du paramètre de la requête dans le format suivant :
&dimension=<item-id>:<operator>:<filter-value>
À titre d'exemple, vous pouvez filtrer l'élément de données "Poids" pour les valeurs supérieures à 2000 et inférieures à 4000 comme suit :
&dimension=WZbXY0S00lP.UXz7xuGCEhU:GT:2000&dimension=WZbXY0S00lP.UXz7xuGCEhU:LT:4000
Vous pouvez filtrer l'attribut "Âge" pour plusieurs âges spécifiques à l'aide de l'opérateur IN comme dans l'exemple suivant :
&dimension=qrur9Dvnyt5:IN:18;19;20
Vous pouvez spécifier plusieurs filtres pour un élément donné en répétant les composants de l'opérateur et du filtre, tous séparés par des points-virgules :
&dimension=qrur9Dvnyt5:GT:5:LT:15
Par défaut, les points d'extrémité query (requête) filtrent les périodes sur la base de enrollmentDate (date d'inscription). Il est également possible de filtrer les entrées en fonction de lastUpdated (dernière mise à jour) en utilisant le paramètre de requête timeField (champ de temps). Par exemple :
&timeField=LAST_UPDATED
Un mot-clé spécial NV peut être utilisé pour filtrer les valeurs null (nulles).
Le filtrage par l'ÂGE est nul
&dimension=qrur9Dvnyt5:EQ:NV
Le filtrage par l'ÂGE est non nul
&dimension=qrur9Dvnyt5:NE:NV
Le filtrage par l'ÂGE est 18, 19 ou est nul
&dimension=qrur9Dvnyt5:IN:18;19;NV
NV peut être utilisé avec les opérateurs EQ, NE et IN.
Les opérateurs disponibles sont répertoriés ci-dessous.
Tableau : Opérateurs de filtre
| Opérateur | Description |
|---|---|
| EQ | Egal à |
| GT | Supérieur à |
| GE | Supérieur ou égal à |
| LT | Inférieur à |
| LE | inférieur ou égal à |
| NE | Pas égal à |
| LIKE | Pareil (correspondance textuelle) |
| IN | Égal à l'une des multiples valeurs séparées par ";" |
L'API de requête d'inscription analytique vous permet de spécifier un ensemble de paramètres de requête.
Tableau : Paramètres de requête pour le point d'extrémité de la requête d'inscription
| Paramètre de requête | Obligatoire | Description | Options (par défaut en premier) |
|---|---|---|---|
| program | Oui | Identifiant du programme. | Tout identifiant de programme |
| startDate | Non | Date de début des inscriptions. | Les dates doivent être au format aaaa-MM-jj |
| endDate | Non | Date de fin des inscriptions. | Les dates doivent être au format aaaa-MM-jj |
| dimension | Oui | L'identifiant de dimension comprend les éléments de données, les attributs, les indicateurs de programme, les périodes, les unités d'organisation et les ensembles de groupes d'unités d'organisation. Le paramètre peut être répété autant de fois que nécessaire. Des filtres d'éléments peuvent être appliqués à une dimension selon le format <item-id>:<operator>:<filter>. Les valeurs des filtres ne sont pas sensibles à la casse. | Les opérateurs peuvent être EQ | GT| GE| LT| LE| NE | COMME | DANS |
| filter | Non | L'identifiant de dimension comprend les éléments de données, les attributs, les périodes, les unités d'organisation et les ensembles de groupes d'unités d'organisation. Le paramètre peut être répété autant de fois que nécessaire. Des filtres d'éléments peuvent être appliqués à une dimension selon le format <item-id>:<operator>:<filter>. Les valeurs des filtres ne sont pas sensibles à la casse. | |
| programStatus | Non | Spécifie le statut d’inscription des inscriptions à inclure. | ACTIF | TERMINÉ | ANNULÉ |
| relativePeriodDate (Date de la période relative) | chaîne | Non | Identifiant de date, par exemple : "2016-01-01". Il remplace la date de début de la période relative |
| ouMode | Non | The mode of selecting organisation units. Default is DESCENDANTS, meaning all sub units in the hierarchy. CHILDREN refers to immediate children in the hierarchy; SELECTED refers to the selected organisation units only. More details here | DESCENDANTS, SUBORDONNÉES, SÉLECTIONNÉES |
| asc | Non | Permet de trier les dimensions dans l'ordre croissant ; peut concerner la date d'inscription, la date d'incident, le nom et le code de l'unité d'organisation. | ouname | programstatus | createdbydisplayname | lastupdatedbydisplayname | enrollmentdate | incidentdate | lastupdated | item identifier |
| desc | Non | Permet de trier les dimensions dans l'ordre décroissant ; peut concerner la date d'inscription, la date d'incident, le nom et le code de l'unité d'organisation. | ouname | programstatus | createdbydisplayname | lastupdatedbydisplayname | enrollmentdate | incidentdate | lastupdated | item identifier |
| coordinatesOnly (coordonnées uniquement) | Non | Indique s'il faut uniquement renvoyer les inscriptions qui ont des coordonnées. | false |
| en-têtes | Non | Le nom des en-têtes à renvoyer dans la réponse. | Un ou plusieurs noms d'en-têtes séparés par une virgule |
| page | Non | Le numéro de page. La page par défaut est 1. | Valeur numérique positive |
| pageSize | Non | La taille de la page. La taille par défaut est de 50 éléments par page. | Zéro ou valeur positive |
| timeField (champ de temps) | Non | Il s'agit du champ de temps utilisé dans le cadre des agrégations/requêtes sur les inscriptions. Il s'applique uniquement aux éléments de données d'inscription. Il peut s'agir d'une option prédéfinie ou de l'identifiant d'un attribut ou d'un élément de données dont le type de valeur est temporel. Pour les points d'extrémité "/analytics/enrollments/", le champ de temps par défaut est ENROLLMENT_DATE. | ENROLLMENT_DATE | LAST_UPDATED | <Attribute ID> | <Data element ID> |
** There are some cases where it's possible to request specific fields through the dimension param. They are not true dimensions, but gives a better level of flexibility. They are:
EVENT_DATE)Filters by the date an event occurred. Can be used as a root-level dimension or scoped to a specific stage.
| Value form | Exemple | Signification |
|---|---|---|
{stageUid}.EVENT_DATE:{period} | dimension=A03MvHHogjR.EVENT_DATE:202205 | Events in stage A03MvHHogjR with an event date in May 2022. |
{stageUid}.EVENT_DATE:{start}_{end} | dimension=A03MvHHogjR.EVENT_DATE:2022-05-01_2022-05-10 | Events in that stage with an event date in the given inclusive date range. |
EVENT_DATE:{period} | dimension=EVENT_DATE:2022Sep | Root-level event date filter using a financial year period. |
SCHEDULED_DATE)Filters by the date an event was scheduled (as opposed to when it actually occurred). Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
SCHEDULED_DATE:{period} | dimension=SCHEDULED_DATE:202107 | Events in the given stage with a scheduled date in July 2021. |
CREATED)Filters by when the enrollment record was created in the system. Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
CREATED:{period} | dimension=CREATED:2016Sep | Enrollments created during the financial year starting September 2016. |
COMPLETED)Filters by when the enrollment was marked as completed. Also, it can be scoped to a specific stage (as EVENT_DATE).
| Value form | Exemple | Signification |
|---|---|---|
COMPLETED:{period} | dimension=COMPLETED:2022Sep | Enrollments completed during the financial year starting September 2022. |
EVENT_STATUS)Filters by the status of an event within a stage.
| Value form | Exemple | Signification |
|---|---|---|
{stageUid}.EVENT_STATUS:{status} | dimension=A03MvHHogjR.EVENT_STATUS:ACTIVE | Events in the stage with status ACTIVE. |
{stageUid}.EVENT_STATUS:{s1};{s2} | dimension=edqlbukwRfQ.EVENT_STATUS:COMPLETED;ACTIVE | Events with status COMPLETED or ACTIVE (OR logic). |
Valid status values: ACTIVE, COMPLETED, SCHEDULED, OVERDUE, SKIPPED.
PROGRAM_STATUS)Filters by the status of the enrollment itself (as opposed to individual events).
| Value form | Exemple | Signification |
|---|---|---|
PROGRAM_STATUS:{status} | dimension=PROGRAM_STATUS:ACTIVE | Only enrollments with the specified program status. |
Valid status values: ACTIVE, COMPLETED, CANCELLED.
Le format de représentation de réponse par défaut est JSON. Les requêtes doivent utiliser la méthode HTTP GET. Les formats de réponse suivants sont pris en charge.
À titre d'exemple, pour obtenir une réponse au format Excel, vous pouvez utiliser une extension de fichier dans l'URL de la requête comme ceci :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.xls
?dimension=ou:ImspTQPwCqd
&dimension=WZbXY0S00lP.de0FEHSIoxh
&columns=w75KJ2mc4zz
&dimension=WZbXY0S00lP.sWoqcoByYmD
&dimension=pe:LAST_MONTH
&stage=WZbXY0S00lP
&pageSize=10&page=1
&asc=ENROLLMENTDATE
&ouMode=DESCENDANTS
Le format JSON de réponse par défaut ressemblera à ceci :
{
"headers": [
{
"name": "pi",
"column": "Enrollment",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "tei",
"column": "Tracked entity instance",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "enrollmentdate",
"column": "Enrollment date",
"valueType": "DATE",
"hidden": false,
"meta": true
},
{
"name": "incidentdate",
"column": "Incident date",
"valueType": "DATE",
"hidden": false,
"meta": true
},
{
"name": "storedby",
"column": "Stored by",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "lastupdated",
"column": "Last Updated",
"valueType": "DATE",
"hidden": false,
"meta": true
},
{
"name": "storedby",
"column": "Stored by",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "createdbydisplayname",
"column": "Created by (display name)",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "lastupdatedbydisplayname",
"column": "Last updated by (display name)",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "geometry",
"column": "Geometry",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "longitude",
"column": "Longitude",
"valueType": "NUMBER",
"hidden": false,
"meta": true
},
{
"name": "latitude",
"column": "Latitude",
"valueType": "NUMBER",
"hidden": false,
"meta": true
},
{
"name": "ouname",
"column": "Organisation unit name",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "oucode",
"column": "Organisation unit code",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "ou",
"column": "Organisation unit",
"valueType": "TEXT",
"hidden": false,
"meta": true
},
{
"name": "de0FEHSIoxh",
"column": "WHOMCH Chronic conditions",
"valueType": "BOOLEAN",
"hidden": false,
"meta": true
},
{
"name": "sWoqcoByYmD",
"column": "WHOMCH Smoking",
"valueType": "BOOLEAN",
"hidden": false,
"meta": true
}
],
"metaData": {
"pager": {
"page": 2,
"total": 163,
"pageSize": 4,
"pageCount": 41
},
"items": {
"ImspTQPwCqd": {
"name": "Sierra Leone"
},
"PFDfvmGpsR3": {
"name": "Care at birth"
},
"bbKtnxRZKEP": {
"name": "Postpartum care visit"
},
"ou": {
"name": "Organisation unit"
},
"PUZaKR0Jh2k": {
"name": "Previous deliveries"
},
"edqlbukwRfQ": {
"name": "Antenatal care visit"
},
"WZbXY0S00lP": {
"name": "First antenatal care visit"
},
"sWoqcoByYmD": {
"name": "WHOMCH Smoking"
},
"WSGAb5XwJ3Y": {
"name": "WHO RMNCH Tracker"
},
"de0FEHSIoxh": {
"name": "WHOMCH Chronic conditions"
}
},
"dimensions": {
"pe": [],
"ou": [
"ImspTQPwCqd"
],
"sWoqcoByYmD": [],
"de0FEHSIoxh": []
}
},
"width": 12,
"rows": [
[
"A0cP533hIQv",
"to8G9jAprnx",
"2019-02-02 12:05:00.0",
"2019-02-02 12:05:00.0",
"system",
"2020-08-06 21:20:52.0",
"",
"0.0",
"0.0",
"Tonkomba MCHP",
"OU_193264",
"xIMxph4NMP1",
"0",
"1"
],
[
"ZqiUn2uXmBi",
"SJtv0WzoYki",
"2019-02-02 12:05:00.0",
"2019-02-02 12:05:00.0",
"system",
"2020-08-06 21:20:52.0",
"",
"0.0",
"0.0",
"Mawoma MCHP",
"OU_254973",
"Srnpwq8jKbp",
"0",
"0"
],
[
"lE747mUAtbz",
"PGzTv2A1xzn",
"2019-02-02 12:05:00.0",
"2019-02-02 12:05:00.0",
"system",
"2020-08-06 21:20:52.0",
"",
"0.0",
"0.0",
"Kunsho CHP",
"OU_193254",
"tdhB1JXYBx2",
"",
"0"
],
[
"nmcqu9QF8ow",
"pav3tGLjYuq",
"2019-02-03 12:05:00.0",
"2019-02-03 12:05:00.0",
"system",
"2020-08-06 21:20:52.0",
"",
"0.0",
"0.0",
"Korbu MCHP",
"OU_678893",
"m73lWmo5BDG",
"",
"1"
]
],
"height": 4
}
La section en-têtes de la réponse décrit le contenu du résultat de la requête. L'identifiant unique de l'inscription, l'identifiant de l'instance d'entité suivie, la date de l'inscription, le nom de l'incident, la géométrie, la latitude, la longitude, le nom et le code de l'unité d'organisation apparaissent en tant que premières dimensions dans la réponse et seront toujours présents. Viennent ensuite les éléments de données, les attributs d'entité suivie qui ont été définis comme dimensions dans la demande ; il s'agit dans ce cas précis des dimensions d'éléments de données "WHOMCH maladies chroniques" et "WHOMCH fumeuses". L'identifiant de l'élément de dimension se trouve dans la propriété "nom" et une description lisible de la dimension dans la propriété "colonne" de la section d'en-têtes.
La section metaData, objet ou (unité d'organisation), contient les identifiants de toutes les unités d'organisation présentes dans la réponse, mis en correspondance avec une chaîne qui représente la hiérarchie. Cette chaîne hiérarchique énumère les identifiants des ascendants de l'unité d'organisation en commençant par la racine. L'objet noms contient les identifiants de tous les éléments de la réponse mis en correspondance avec leurs noms.
La section lignes contient les inscriptions produites par la requête. Chaque ligne représente exactement un inscription.
L'API d'analyse des inscriptions sans agrégation permet également de relier les indicateurs de programme aux types de relations, afin d'afficher le résultat du calcul d'un indicateur de programme spécifique, appliqué aux entités liées à l'instance d'entité suivie répertoriée.
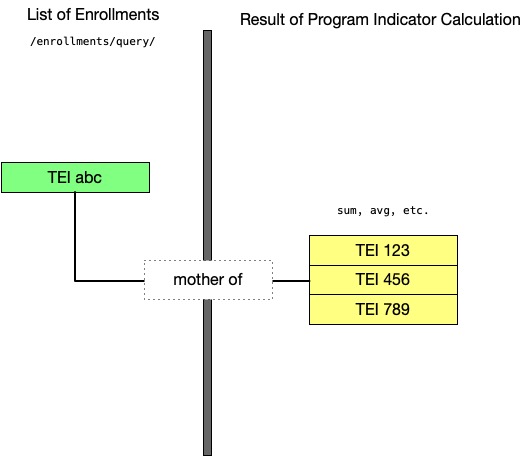
Pour que la relation Indicateur de programme & Type de relation fonctionne, il faudra ajouter à l'API /api/analytics/enrollments/query, une nouvelle dimension qui contient les UID du type de relation et l'Indicateur de programme choisis :
/api/analytics/enrollments/query/<program-id>
?dimension=<relationshiptype-id>.<programindicator-id>
Par exemple, pour extraire une liste d'inscriptions du programme "WHO RMNCH Tracker" pour janvier 2019 et afficher le nombre de cas de paludisme liés à cette inscription par le type de relation "Cas de paludisme lié à une personne", vous pouvez utiliser la requête suivante :
/api/analytics/enrollments/query/WSGAb5XwJ3Y.json?dimension=mxZDvSZYxlw.nFICjJluo74
&startDate=2019-01-01&endDate=2019-01-31
L'API permet d'utiliser des indicateurs de programme qui ne sont pas associés au programme "principal" (c'est-à-dire le programme dont l'ID est spécifié après /query/).
L'API d'analyse des entités suivies (ES) permet d'interroger les ES avec leurs données d'inscription et d'événement saisies dans DHIS2. Cette ressource permet d'extraire des données sur les ES, les inscriptions, les événements et les éléments de données dans plusieurs programmes, pour un type d'entité suivie donné.
Les dimensions des instances d'entités suivies comprennent les attributs de programme (attributs ES), les éléments de données, les unités d'organisation et différents types de périodes. La requête analytique renvoie simplement les ES correspondant à un ensemble de critères. Elle n'effectue aucune agrégation.
Tableau : Dimensions de l'ES
| Dimension | Identifiant de la dimension | Description |
|---|---|---|
| Attributs du programme (attributs de l'ES) | <attribute id> | L'identifiant de l'attribut du programme. |
| Éléments de données dans les étapes du programme | <program id>.<program stage id>[offset].<data element id> | Les identifiants des éléments de données doivent inclure le programme et la phase du programme. Par exemple : dimension=IpHINAT79UW.ZzYYXq4fJie.GQY2lXrypjO. |
| Périodes | N.A. | Il n'y a pas de support direct pour la dimension période. Les périodes sont prises en charge par plusieurs paramètres spécifiques. Voir la section Périodes ci-dessous. |
| Unités d'organisation de l'IES | ou | Les identifiants des unités d'organisation, ainsi que les mots clés USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> et OU_GROUP-<group-id>. |
| Unités d'organisation chargées de l'inscription | <program id>.ou | Les identifiants des unités d'organisation, ainsi que les mots clés USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> et OU_GROUP-<group-id>. |
| Unités d'organisation des événements | <program id><program stage id>.ou | Les identifiants des unités d'organisation, ainsi que les mots clés USER_ORGUNIT, USER_ORGUNIT_CHILDREN, USER_ORGUNIT_GRANDCHILDREN, LEVEL-<level> et OU_GROUP-<group-id>. |
Les dimensions qui font référence à des éléments dans des événements répétables peuvent inclure un décalage facultatif. Le décalage est utilisé pour spécifier la répétition de l'événement à utiliser. L'ordre des répétitions est basé sur la date de l'événement, l'événement le plus récent étant la dernière répétition. Le décalage est une valeur entière, où 0 correspond à la dernière répétition, -1 à l'avant-dernière, et ainsi de suite. Les valeurs positives font référence à la première (plus ancienne) répétition, à la deuxième répétition, et ainsi de suite. Le décalage est placé entre crochets [ ].
Exemple:
IpHINAT79UW.ZzYYXq4fJie.GQY2lXrypjO -- renvoie à la dernière répétition
IpHINAT79UW.ZzYYXq4fJie[-1].GQY2lXrypjO -- renvoie à l'avant-dernière répétition
IpHINAT79UW.ZzYYXq4fJie[2].GQY2lXrypjO -- renvoie à la deuxième répétition
Le endpoint analytics/trackedEntities/query fournit des requêtes pour les ES saisies, permettant ainsi d'interroger et de filtrer les informations relatives aux ES, ainsi qu'à leurs inscriptions et événements respectifs. Il n'effectue aucune agrégation.
/api/41/analytics/trackedEntities/query
Vous pouvez spécifier un nombre quelconque de dimensions et de filtres dans une requête. Les identifiants des éléments de dimension peuvent faire référence à tout élément de données dans les étapes du programme, les attributs du programme, les attributs des entités suivies, les périodes fixes et relatives et les unités d'organisation. Les dimensions peuvent éventuellement être associées à un opérateur de requête et à un filtre. Les requêtes d'ES doivent être présentées dans le format décrit ci-dessous.
/api/41/analytics/trackedEntities/query/<tracked-entity-type-id>?dimension=ou:<ou-id>;<ou-id>&
dimension=<item-id>&dimension=<item-id>:<operator>:<filter>
Par exemple, pour extraire les ES de type Personne des programmes "Enfant" et "Soins prénatals", où le "Prénom" est "Jacques" :
/api/41/analytics/trackedEntities/query/nEenWmSyUEp?program=IpHINAT79UW,WSGAb5XwJ3Y&dimension=IpHINAT79UW.w75KJ2mc4zz:eq:James
La pagination peut être appliquée à la requête en spécifiant les paramètres de numéro de page et de taille de page. Si le numéro de page est spécifié mais que la taille de la page ne l'est pas, la taille de page 50 sera utilisée. Si la taille de la page est spécifiée mais que le numéro de page ne l'est pas, le numéro de page 1 sera utilisé. Pour obtenir la deuxième page de la réponse avec une taille de page de 10, vous pouvez utiliser une requête comme celle-ci :
/api/41/analytics/trackedEntities/query/nEenWmSyUEp?program=IpHINAT79UW,WSGAb5XwJ3Y&dimension=IpHINAT79UW.w75KJ2mc4zz:eq:James
&pageSize=10&page=2
Les filtres peuvent être appliqués aux éléments de données, aux attributs des entités suivies et aux identifiants des entités suivies. Le filtrage est effectué au moyen d'un paramètre de requête au format suivant :
&dimension=<item-id>:<operator>:<filter-value>
Par exemple, vous pouvez filtrer l'élément de données "Poids du nourrisson (g)" du programme "Programme pour l'enfant" et de l'étape du programme "Bébé postnatal" en recherchant des valeurs supérieures à 2000 et inférieures à 4000. Le filtre est défini comme suit :
&dimension=IpHINAT79UW.ZzYYXq4fJie.GQY2lXrypjO:GT:2000&dimension=IpHINAT79UW.ZzYYXq4fJie.GQY2lXrypjO:LT:4000
Contrairement aux endpoints d'inscription et de requête d'événement, l'endpoint de l'ES prend en charge plusieurs méthodes de spécification de la période à laquelle les données appartiennent. Elles sont basées sur différents paramètres date, comme indiqué ci-dessous :
| Paramètre | Description |
|---|---|
| eventDate | Les ES seront filtrés en fonction de la date à laquelle l'événement s'est produit. |
| enrollmentDate (date d'inscription) | Les ES seront filtrés en fonction de la date d'inscription. |
| scheduledDate (date de programmation) | Les ES seront filtrés en fonction de la date à laquelle l'événement a été programmé. |
| incidentDate (date d'incident) | Les ES seront filtrés en fonction de la date d'incident de l'inscription. |
| lastUpdated (dernière mise à jour) | Les ES seront filtrés en fonction de la date de la dernière mise à jour de l'ES, de l'inscription ou de l'événement. |
| created | Les ES seront filtrés en fonction de la date de création de l'ES, de l'inscription ou de l'événement. |
Certaines périodes, mentionnées ci-dessus, peuvent être appliquées aux entités suivies, aux inscriptions ou aux événements, selon la manière dont elles sont exprimées.
Exemples :
lastUpdated=LAST_YEAR
lastUpdated=IpHINAT79UW.LAST_YEAR
lastUpdated=IpHINAT79UW.ZzYYXq4fJie.LAST_YEAR
enrollmentDate=IpHINAT79UW.LAST_YEAR
L'API de requête analytique de l'ES prend en charge une série de paramètres de requête.
Tableau : Paramètres de requête pour le endpoint de l'ES
| Paramètre de requête | Obligatoire | Description | Options (par défaut en premier) |
|---|---|---|---|
| TrackedEntityType | Oui | Identifiant du type d'entité suivie. | Tout identifiant de type d'entité suivie. |
| program | Non | Identifiants du programme. | Tout identifiant de programme. Il accepte plusieurs identifiants séparés par des virgules. |
| dimension | Non | Dimension identifier including data elements, attributes, program indicators, periods, organization units and organization unit group sets. Can be specified multiple times. Dimension filters can be applied to a dimension in the format <dimension-id>:<operator>:<filter-value>. Filter values can be case-insensitive (depending on the operator). | Opérateurs : EQ | IEQ | GT | GE | LT | LE | NE | LIKE | ILIKE | IN |
| filter | Non | Dimension identifier including data elements, attributes, periods, organization units and organization unit group sets. Can be specified multiple times. Dimension filters can be applied to a dimension in the format <dimension-id>:<operator>:<filter-value>. Filter values can be case-insensitive (depending on the operator). | Opérateurs : EQ | IEQ | GT | GE | LT | LE | NE | LIKE | ILIKE | IN |
| en-têtes | Non | Le nom des en-têtes à renvoyer dans la réponse. | Un ou plusieurs noms d'en-têtes (séparés par une virgule). |
| relativePeriodDate (Date de la période relative) | Non | Ce paramètre remplace la date de début, par conséquent les périodes relatives utiliseront cette date comme date de début. | Exemple: "2016-01-01" |
| ouMode | Non | The mode for the selection of organization units. The default is DESCENDANTS, meaning all subunits in the hierarchy. CHILDREN refers to immediate children in the hierarchy; SELECTED refers to the selected organization units only. | DESCENDANTS, CHILDREN, SELECTED |
| asc | Non | Permet de trier les dimensions dans l'ordre croissant ; peut concerner la date d'inscription, la date d'incident, le nom et le code de l'unité d'organisation. | ouname | programstatus | createdbydisplayname | lastupdatedbydisplayname | enrollmentdate | incidentdate | lastupdated | <dimension identifier> |
| desc | Non | Permet de trier les dimensions dans l'ordre décroissant ; peut concerner la date d'inscription, la date d'incident, le nom et le code de l'unité d'organisation. | ouname | programstatus | createdbydisplayname | lastupdatedbydisplayname | enrollmentdate | incidentdate | lastupdated | <dimension identifier> |
| page | Non | Le numéro de page. La valeur par défaut est 1. | Valeur numérique positive. |
| pageSize | Non | La taille de la page. La valeur par défaut est 50 (ce qui signifie 50 éléments par page). | Zéro ou valeur positive. |
| displayProperty (afficher la propriété) | Non | Affiche la propriété des métadonnées. | NAME | SHORTNAME |
| includeMetadataDetails (inclure les détails des métadonnées) | Non | Inclut les détails des métadonnées dans la réponse générée pour les données brutes. | false |
| outputIdScheme (schéma d'identification de la sortie) | Non | Schéma d'identification utilisé pour les éléments de métadonnées dans la réponse à la requête. Il accepte des identifiants, des codes ou des attributs. | UID | UUID | CODE | NAME | ATTRIBUTE:<ID> |
| dataIdScheme (schéma d'identification des données) | Non | Schéma d'identification à utiliser pour les données, plus spécifiquement pour les éléments de données et les attributs qui disposent d'un ensemble d'options ou de légendes. Ceci permet par exemple de renvoyer le nom de l'option au lieu du code, ou le nom de la légende au lieu de son ID, dans la réponse. | NAME | CODE | UID |
| programStatus | Non | Specify enrollment status of events to include. Deprecated, prefer enrollmentStatus | ACTIVE | COMPLETED | CANCELLED. La séparation peut se faire par des virgules (pour la requête uniquement). |
| enrollmentStatus | Non | Spécifie le statut d’inscription des événements à inclure. | ACTIVE | COMPLETED | CANCELLED. La séparation peut se faire par des virgules (pour la requête uniquement). |
| eventStatus | Non | Spécifier le statut des événements à inclure. | ACTIVE | COMPLETED | SCHEDULE | OVERDUE | SKIPPED. La séparation peut se faire par des virgules (pour la requête uniquement). |
| coordinatesOnly (coordonnées uniquement) | Non | Indique s'il faut uniquement renvoyer les événements qui ont des coordonnées. | false |
| geometryOnly (géométrie Uniquement) | Non | Indique s'il faut uniquement renvoyer les événements qui ont des géométries. | false |
| userOrgUnit (unité d'organisation d'utilisateur) | Non | Identifiant de l’unité d’organisation de l'utilisateur. | Tout identifiant de l’unité d’organisation. |
| skipMeta | Non | Ignorer les métadonnées dans la réponse. | false |
| skipData (ignorer les données) | Non | Ignorer les données dans la réponse. | false |
| skipRounding (ignorer l'arrondissement des valeurs) | Non | Évite d'arrondir les données. | false |
| skipHeaders (ignorer les en-têtes) | Non | Ignorer les en-têtes dans la réponse. | false |
| totalPages | Non | Indiquez le nombre total de pages dans la réponse. | false |
| displayProperty (afficher la propriété) | Non | Affiche la propriété des métadonnées. | NAME | SHORTNAME |
Vous pouvez extraire facilement les dimensions de données à partir de cinq ressources :
/analytics/events/query/dimensions /analytics/events/aggregate/dimensions/analytics/enrollments/query/dimensions/analytics/enrollments/aggregate/dimensions/analytics/teis/query/dimensionsLes ressources mentionnées ci-dessus utilisent tous le paramètre de requête suivant :
| Paramètre de requête | requis | Description | Options |
|---|---|---|---|
| filter | no | Permet de filtrer les valeurs des champs selon le format : filter=champ:OP:valeur&filter=champ:OP:valeur&... | Voir la [section des filtres de dimension].(#webapi_analytics_dimension_filters) |
| champs | no | Permet de filtrer les champs | |
| page | no | Numéro de page | La valeur par défaut est 1 (première page) |
| pageSize | no | Taille de la page | La valeur par défaut est de 50 éléments par page |
| pagination | no | Désactive la pagination s'il est définit sur false. | true ou false : la valeur par défaut est true |
| order | no | Permet d'effectuer le tri selon le format : order=field:direction | Voici les champs qui peuvent être triés : created (par défaut), lastUpdated, code, uid, id, name, displayName, dimensionTypeLe tri peut se faire dans l'ordre ASC (par défaut) ou DESC |
Les points d'extrémité des dimensions permettent de filtrer la sortie afin que la réponse ne porte que sur les éléments recherchés. Les filtres sont au format filter=field:op:value&filter=field:op:value&...&filter=field:op:value.
Les valeurs de champ prises en charge sont les suivantes :
DATA_ELEMENTPROGRAM_INDICATORPROGRAM_ATTRIBUTECATEGORYCATEGORY_OPTION_GROUP_SET (ensemble de groupes d'options de catégorie)Les valeurs op prises en charge sont :
startsWith - le champ commence par!startsWith - le champ ne commence pas parendsWith - le champ se termine par!endsWith - le champ ne se termine pas par- eq - égalieq - équivaut à ignorer le casne - pas égallike - contient!like - ne contient pasilike - contient des cas ignorés!ilike - ne contient pas des cas ignorésLa ressource /analytics/events/query/dimensions?programId={programId}&programStageId={programStageId} accepte :
programme trackerétape de programme trackerproramme et l'étape du programmeLa combinaison du programme et de l'étape du programme est soumise à des contraintes :
programme est spécifié, la ressource renvoie les dimensions des données pour chaque étape de programme fourni.l'étape de programme est spécifié, la ressource renvoie les dimensions des données pour l'étape de programme fournieprogramme et étape de programme sont spécifiés, la ressource renvoie les dimensions des données pour létape de programme fournie si elle appartient au programme fourni. Sinon, elle renvoie une erreur.les dimensions des données renvoyées sont les suivantes :
ATTRIBUTAll value types for data elements and tracked entity attributes are considered supported types, except IMAGE and FILE_RESOURCE.
La ressource /analytics/events/aggregate/dimensions?programStageId=... accepte un paramètre obligatoire programStageId et renvoie les dimensions de données suivantes :
ATTRIBUT associés au programme (dérivés de l'ID de l'étape de programme)Les éléments de données et les attributs d'entité suivie sont considérés comme des types pris en charge si leur type de valeur est l'un des suivants :
NOMBREINTERVALLE_UNITAIREPOURCENTAGEENTIERENTIER_POSITIFENTIER_NÉGATIFENTIER_ZÉRO_OU_POSITIFBOOLÉENTRUE_ONLY (vrai uniquement)La ressource /analytics/enrollments/query/dimensions?programId=... accepte un identifiant obligatoire d'un programme Tracker et renvoie les dimensions de données suivantes :
All value types for data elements and tracked entity attributes are considered supported types, except IMAGE and FILE_RESOURCE.
La ressource /analytics/enrollments/aggregate/dimensions?programId=... accepte un identifiant obligatoire d'un programme Tracker, qui fait référence à un programme avec inscription, et renvoie les dimensions de données suivantes :
Les éléments de données et les attributs d'entité suivie sont considérés comme des types pris en charge si leur type de valeur est l'un des suivants :
NOMBREINTERVALLE_UNITAIREPOURCENTAGEENTIERENTIER_POSITIFENTIER_NÉGATIFENTIER_ZÉRO_OU_POSITIFBOOLÉENTRUE_ONLY (vrai uniquement)La ressource /analytics/teis/query/dimensions?trackedEntityType=TET accepte un identifiant obligatoire d'un type d'entité suivie TET et renvoie les dimensions de données suivantes :
pour chaque programme P associé à une instance d'entité suivie de type TET : - Indicateurs de programme associés au P - Éléments de données des types pris en charge dans le P, avec une étape de programme pour chaque élément de données - Tracked entity attributes of supported types in P that are not marked to be skipped from Analytics. - attributs de programme du P
All value types for data elements and tracked entity attributes are considered supported types, except IMAGE and FILE_RESOURCE.
GET /api/analytics/teis/query/dimensions?programStageId=A03MvHHogjR&order=code&filter=name:ilike:weight
{
"page":1,
"total":5,
"pageSize":50,
"dimensions":[
{
"dimensionType":"PROGRAM_INDICATOR",
"created":"2015-08-06T22:49:20.128",
"lastUpdated":"2015-08-06T22:51:19.787",
"name":"Measles + Yellow fever doses low infant weight",
"displayName":"Measles + Yellow fever doses low infant weight",
"id":"tt54DiKuQ9c",
"uid":"tt54DiKuQ9c",
"displayShortName":"Measles + Yellow fever doses low infant weight"
},
{
"dimensionType":"PROGRAM_INDICATOR",
"created":"2017-01-20T10:32:26.388",
"lastUpdated":"2017-01-20T10:32:26.388",
"name":"Weight gain(in g) between birth and last postnatal",
"displayName":"Weight gain(in g) between birth and last postnatal",
"id":"qhTkqwAJLMv",
"uid":"qhTkqwAJLMv",
"displayShortName":"Weight gain(g)"
},
{
"dimensionType":"PROGRAM_INDICATOR",
"created":"2015-09-14T20:25:55.543",
"lastUpdated":"2018-08-28T12:22:47.857",
"name":"Average weight (g)",
"displayName":"Average weight (g)",
"id":"GxdhnY5wmHq",
"uid":"GxdhnY5wmHq",
"displayShortName":"Average weight (g)"
},
{
"dimensionType":"PROGRAM_INDICATOR",
"created":"2015-08-06T22:35:40.391",
"lastUpdated":"2015-08-06T22:35:40.391",
"name":"BCG doses low birth weight",
"displayName":"BCG doses low birth weight",
"id":"hCYU0G5Ti2T",
"uid":"hCYU0G5Ti2T",
"displayShortName":"BCG doses low birth weight"
},
{
"valueType":"NUMBER",
"dimensionType":"DATA_ELEMENT",
"created":"2012-09-20T17:37:45.474",
"lastUpdated":"2014-11-11T21:56:05.418",
"name":"MCH Weight (g)",
"displayName":"MCH Weight (g)",
"id":"A03MvHHogjR.UXz7xuGCEhU",
"uid":"UXz7xuGCEhU",
"code":"DE_2005736",
"displayShortName":"Weight (g)"
}
]
}
L'API d'analyse des unités d'organisation fournit des statistiques sur les unités d'organisation classées par ensembles de groupes d'unités d'organisation, c'est-à-dire le nombre d'unités d'organisation dans chaque groupe au sein des ensembles de groupes d'unités d'organisation.
GET /api/orgUnitAnalytics?ou=<org-unit-id>&ougs=<org-unit-group-set-id>
L'API requiert au moins une unité d'organisation et au moins un ensemble de groupes d'unités d'organisation. Plusieurs unités d'organisation et ensembles de groupes peuvent être fournis, séparés par un point-virgule.
La ressource analytique des unités d'organisation vous permet de spécifier un ensemble de paramètres de requête :
Tableau : Paramètres de requête analytique pour les unités d'organisation
| Propriété | Description | Obligatoire |
|---|---|---|
| ou | Identifiants d'unités d'organisation, éventuellement séparés par un point-virgule. | Oui |
| ougs | Identifiants des ensembles de groupes d'unités d'organisation, éventuellement séparés par un point-virgule. | Oui |
| colonnes | Identifiants des ensembles de groupes d'unités d'organisation, éventuellement séparés par un point-virgule. Ils déterminent les ensembles de groupes qui apparaissent sous forme de colonnes dans un tableau. | Non |
La réponse contiendra une colonne pour l'unité d'organisation mère, des colonnes pour chaque groupe d'unités d'organisation faisant partie de la requête et une colonne pour le nombre d'unités d'organisation. Les statistiques comprennent le nombre d'unités d'organisation qui se trouvent en dessous des unités d'organisation spécifiées dans la requête. La réponse contient une section 'métadonnées' qui spécifie le nom de chaque unité d'organisation et de chaque groupe d'unités d'organisation qui font partie de la réponse. Elles sont référencées par leurs identifiants.
La réponse par défaut comporte une seule colonne count. Elle peut être présentée dans un tableau dans lequel au moins un groupe d'unités d'organisation est spécifié à l'aide du paramètre de requête columns.
Le point d'extrémité analytique des unités d'organisation rend en charge les formats de représentation suivants :
Pour obtenir des analyses d'unité d'organisation pour une unité d'organisation et un ensemble de groupes d'unités d'organisation, utilisez ce qui suit :
GET /api/orgUnitAnalytics?ou=lc3eMKXaEfw&ougs=J5jldMd8OHv
Pour obtenir des données analytiques d'unité d'organisation pour deux unités d'organisation et deux ensembles de groupes d'unités d'organisation, utilisez ce qui suit :
GET /api/orgUnitAnalytics?ou=lc3eMKXaEfw;PMa2VCrupOd&ougs=J5jldMd8OHv;Bpx0589u8y0
Pour obtenir des données analytiques d'unité d'organisation dans un tableau avec un ensemble de groupes présenté dans des colonnes, utilisez ceci :
GET /api/orgUnitAnalytics?ou=fdc6uOvgoji;jUb8gELQApl;lc3eMKXaEfw;PMa2VCrupOd
&ougs=J5jldMd8OHv&columns=J5jldMd8OHv
Les éventuelles erreurs de validation spécifiques à l'API d'analyse des unités d'organisation sont décrites dans le tableau ci-dessous. Certaines erreurs spécifiées pour l'API d'analyse agrégée sont également concernées.
| Code d'erreur | Message |
|---|---|
| E7300 | Au moins une unité d'organisation doit être spécifiée |
| E7301 | Au moins un ensemble de groupes d'unités d'organisation doit être spécifié. |
Les rapports sur les ensembles de données peuvent être générés avec l'API Web, à l'aide de la ressource /dataSetReport. Cette ressource génère des rapports sur les ensembles de données et renvoie le résultat dans un un tableau HTML.
/api/dataSetReport
La requête prend en charge les paramètres suivants :
Tableau : Paramètres de la requête du rapport d'ensemble de données
| Paramètre | Description | Type | Obligatoire |
|---|---|---|---|
| ds | L'ensemble de données à partir duquel le rapport est créé. | UID de l'ensemble de données | Oui |
| pe | La ou les période(s) à partir de laquelle/desquelles le rapport doit être créé. Il peut s'agir d'une liste dont les éléments sont séparés par des virgules. | Chaîne ISO | Oui |
| ou | L'unité d'organisation à partir de laquelle le rapport doit être créé. | L'UID de l'unité d'organisation | Oui |
| filter | Les filtres à utiliser pour le rapport ; ils peuvent être répétés autant de fois que nécessaire. Ils viennent juste après la syntaxe de l'API analytique. | Un ou plusieurs UID | Non |
| selectedUnitOnly (unité sélectionnée uniquement) | Détermine s'il faut utiliser les données saisies uniquement ou les données agrégées. | Booléen | Non |
La ressource du rapport sur les ensembles de données accepte uniquement les requêtes GET. Le contenu de la réponse est de type application/json et les données sont renvoyées dans une grille. Ce point d'extrémité fonctionne pour tous les types d'ensemble de données, notamment les formulaires par défaut, les formulaires à sections et les formulaires personnalisés.
Voici un exemple de requête d'extraction d'un rapport pour un ensemble de données mensuel et une unité d'organisation pour le mois d'octobre 2018 :
GET /api/dataSetReport?ds=BfMAe6Itzgt&pe=201810&ou=ImspTQPwCqd&selectedUnitOnly=false
Voici un exemple de requête d'extraction d'un rapport pour un ensemble de données mensuel et une unité d'organisation pour octobre, novembre et décembre 2018 :
GET /api/dataSetReport?ds=BfMAe6Itzgt&pe=201810,201811,201812&ou=ImspTQPwCqd&selectedUnitOnly=false
Pour obtenir un rapport sur un ensemble de données avec un filtre, vous pouvez utiliser le paramètre filter. Dans ce cas, le filtre se base sur un ensemble de groupes d'unités d'organisation et deux groupes d'unités d'organisation :
GET /api/dataSetReport?ds=BfMAe6Itzgt&pe=201810&ou=ImspTQPwCqd
&filter=J5jldMd8OHv:RXL3lPSK8oG;tDZVQ1WtwpA
Le point d'extrémité du rapport sur l'ensemble de données prend en charge les formats de sortie suivants. Vous pouvez récupérer un point d'extrémité spécifique en utilisant l'extension du fichier ou l'en-tête HTTP Accept.
Un point d'extrémité spécifique est disponible pour les ensembles de données avec des formulaires HTML personnalisés. Ce point d'extrémité renvoie le contenu du formulaire HTML avec le type de contenu text/html et les données y sont insérées. Vous pouvez également utiliser le point d'extrémité du rapport général sur les ensembles de données pour les ensembles de données avec des formulaires personnalisés. Cependant, ce point d'extrémité renverra le rapport au format JSON dans une grille. Ce point d'extrémité ne fonctionne que pour les ensembles de données avec des formulaires HTML personnalisés.
GET /api/dataSetReport/custom
La syntaxe de ce point d'extrémité est par ailleurs la même que celle du point d'extrémité du rapport général sur les ensembles de données. Pour récupérer un rapport HTML personnalisé sur un ensemble de données, vous pouvez effectuer la requête suivante :
GET /api/dataSetReport/custom?ds=lyLU2wR22tC&pe=201810&ou=ImspTQPwCqd
L'API d'analyse push comprend des points d'extrémité qui permettent la prévisualisation d'un rapport d'analyse push par l'utilisateur connecté et le déclenchement manuel de la génération et de l'envoi de rapports d'analyse push par le système, en plus des opérations CRUD normales. Lorsque vous utilisez les points d'extrémité de création et de mise à jour pour l'analyse push, celle-ci est programmée pour s'exécuter selon les propriétés de l'analyse push. De même, lorsque vous supprimez ou mettez à jour une analyse push pour la désactiver, la tâche ne pourra plus être exécutée à l'avenir.
Pour obtenir l'aperçu d'une analyse push existante en HTML, vous pouvez effectuer une requête GET au point d'extrémité suivant :
/api/pushAnalysis/<id>/render
Pour déclencher manuellement une tâche d'analyse push, vous pouvez envoyer une requête POST au point d'extrémité suivant :
/api/pushAnalysis/<id>/run
Une analyse push comprend les propriétés suivantes, dont certaines sont nécessaires pour l'exécution automatique des tâches d'analyse push :
Tableau : Propriétés de l'analyse push
| Propriété | Description | Type | Obligatoire |
|---|---|---|---|
| tableau de bord | Tableau de bord sur lequel repose les rapports | UID du tableau de bord | Oui |
| message | Apparaît après le titre dans les rapports | Chaîne | Non |
| recipientUserGroups (groupes d'utilisateurs destinataires) | Un ensemble de groupes d'utilisateurs qui doivent recevoir les rapports | Un ou plusieurs UID de groupes d'utilisateurs | Non. Les tâches programmées sans destinataire seront ignorés. |
| activé | Indique si cette analyse push doit être programmée ou non. La valeur par défaut est 'Faux'. | Booléen | Oui. Doit être défini sur "true" pour être programmée. |
| schedulingFrequency (fréquence de planification) | La fréquence à laquelle les rapports doivent être programmés. | "QUOTIDIENNE", "HEBDOMADAIRE", "MENSUELLE" | Non. Les analyses push sans fréquence ne seront pas programmées. |
| schedulingDayOfFrequency (Programmation du jour de la fréquence) | Le jour dans la fréquence où la tâche doit être programmée. | Entier. Toute valeur est valide lorsque la fréquence est "QUOTIDIENNE". 0-7 lorsque la fréquence est "HEBDOMADAIRE". 1-31 lorsque la fréquence est "MENSUELLE" | Non. Les analyses push qui n'ont pas de jour de fréquence valide pour l'ensemble de fréquences ne seront pas programmées. |
L'API d'analyse de l'utilisation vous permet d'accéder à des informations sur la manière dont les gens utilisent DHIS2 sur la base d'une analyse de données. Lorsque les utilisateurs accèdent aux favoris, un événement est enregistré. L'événement se compose du nom de l'utilisateur, de l'UID du favori, de la date de l'événement et du type d'événement. Les différents types d'événements sont répertoriés dans le tableau.
/api/dataStatistics
L'API d'analyse de l'utilisation vous permet de récupérer des instantanés agrégés sur l'analyse de l'utilisation, en fonction d'intervalles de temps donnés. L'API capture les visualisations des utilisateurs (par exemple le nombre de fois qu'un graphique ou un tableau croisé dynamique a été visualisé par un utilisateur) et les favoris d'analyse enregistrés (par exemple les graphiques et les tableaux croisés dynamiques favoris). DHIS2 capture des instantanés nocturnes qui sont ensuite agrégés à la demande.
L'API d'analyse de l'utilisation (statistiques de données) prend en charge deux opérations :
POST: crée un événement de visualisation
GET: récupère les statistiques agrégées
L'API d'analyse de l'utilisation vous permet de créer des visualisations d'événement. Le paramètre dataStatisticsEventType (type d'événement des statistiques de données) décrit le type de l'élément visualisé. Le paramètre de favori indique l'identifiant du favori concerné.
L'URL qui crée une nouvelle visualisation d'événement des graphiques :
POST /api/dataStatistics?eventType=CHART_VIEW&favorite=LW0O27b7TdD
Une opération de sauvegarde réussie renvoie un code de statut HTTP "201". Le tableau ci-dessous présente les types d'événements pris en charge.
Tableau : Types d'événements pris en charge
| Clé | Description |
|---|---|
| VISUALIZATION_VIEW (APERÇU DE LA VISUALISATION) | Aperçu de la visualisation |
| MAP_VIEW | Aperçu de la carte (GIS) |
| EVENT_REPORT_VIEW | Aperçu du rapport d'événement |
| EVENT_CHART_VIEW | Aperçu du graphique d'événement |
| EVENT_VISUALIZATION_VIEW | Aperçu de la visualisation d'événement |
| DASHBOARD_VIEW | Aperçu du tableau de bord |
| PASSIVE_DASHBOARD_VIEW | Aperçu du tableau de bord (lorsque le tableau de bord n'est pas explicitement sélectionné) |
| DATA_SET_REPORT_VIEW | Aperçu du rapport sur l'ensemble des données |
L'API d'analyse de l'utilisation (statistiques de données) vous permet de spécifier certains paramètres de requête lorsque vous demandez un rapport agrégé.
Tableau : Paramètres de requête pour l'analyse agrégée de l'utilisation (statistiques de données)
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| startDate | Oui | Date de début de la période | Les dates doivent être au format aaaa-MM-jj |
| endDate | Oui | Date de fin de la période | Les dates doivent être au format aaaa-MM-jj |
| intervalle | Oui | Type d'intervalle pour l'agrégation | JOUR, SEMAINE, MOIS, ANNÉE |
Les paramètres 'date de début' et 'date de fin' spécifient la période pour laquelle les instantanés doivent être utilisés dans l'agrégation. Vous devez mettre les dates au format indiqué ci-dessus. Si aucun instantané n'est sauvegardé au cours de la période spécifiée, une liste vide est renvoyée. Le paramètre appelé 'intervalle' spécifie le type d'agrégation qui sera effectué.
Requête API qui crée une agrégation mensuelle :
GET /api/dataStatistics?startDate=2014-01-02&endDate=2016-01-01&interval=MONTH
L'API d'analyse de l'utilisation vous permet de récupérer les principaux favoris utilisés dans DHIS2, et par utilisateur.
Tableau : Paramètres requête pour les principaux favoris
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| eventType (type d'événement) | Oui | Le type d'événement des statistiques de données | Voir le tableau ci-dessus |
| pageSize | Non | Taille de la liste renvoyée | Par exemple 5, 10, 25. La valeur par défaut est 25 |
| sortOrder | Non | Décroissant ou croissant | ASC ou DESC. La valeur par défaut est DESC. |
| Nom d'utilisateur | Non | Si ce paramètre est spécifié, la réponse ne contiendra que les favoris de cet utilisateur. | Par exemple, "admin". |
La requête API peut être utilisée sans nom d'utilisateur. Dans ce cas, elle trouvera les principaux favoris de tout le système.
/api/dataStatistics/favorites?eventType=CHART_VIEW&pageSize=25&sortOrder=ASC
Si le nom d'utilisateur est spécifié, la réponse ne contiendra que les principaux favoris de cet utilisateur.
/api/dataStatistics/favorites?eventType=CHART_VIEW&pageSize=25
&sortOrder=ASC&username=admin
Vous pouvez renvoyer les données agrégées dans une réponse d'analyse d'utilisation dans différents formats de représentation. Le format par défaut est JSON. Les formats et types de contenu disponibles sont les suivants :
json (application/json)
xml (application/xml)
html (texte/html)
Requête API qui demande une réponse d'analyse d'utilisation au format XML :
/api/dataStatistics.xml?startDate=2014-01-01&endDate=2016-01-01&interval=WEEK
Pour obtenir une réponse d'analyse d'utilisation au format JSON :
/api/dataStatistics?startDate=2016-02-01&endDate=2016-02-14&interval=WEEK
La réponse JSON ressemble à ceci :
[
{
"year": 2016,
"week": 5,
"mapViews": 2181,
"chartViews": 2227,
"reportTableViews": 5633,
"eventReportViews": 6757,
"eventChartViews": 9860,
"eventVisualizationViews": 2387,
"dashboardViews": 10082,
"passiveDashboardViews": 0,
"totalViews": 46346,
"averageViews": 468,
"averageMapViews": 22,
"averageChartViews": 22,
"averageReportTableViews": 56,
"averageEventReportViews": 68,
"averageEventChartViews": 99,
"averageEventVisualizationViews": 10,
"averageDashboardViews": 101,
"averagePassiveDashboardViews": 0,
"savedMaps": 1805,
"savedCharts": 2205,
"savedReportTables": 1995,
"savedEventReports": 1679,
"savedEventCharts": 1613,
"savedEventVisualizations": 1231,
"savedDashboards": 0,
"savedIndicators": 1831,
"activeUsers": 99,
"users": 969
},
{
"year": 2016,
"week": 6,
"mapViews": 2018,
"chartViews": 2267,
"reportTableViews": 4714,
"eventReportViews": 6697,
"eventChartViews": 9511,
"dashboardViews": 12181,
"passiveDashboardViews": 0,
"totalViews": 47746,
"averageViews": 497,
"averageMapViews": 21,
"averageChartViews": 23,
"averageReportTableViews": 49,
"averageEventReportViews": 69,
"averageEventChartViews": 99,
"averageDashboardViews": 126,
"averagePassiveDashboardViews": 0,
"savedMaps": 1643,
"savedCharts": 1935,
"savedReportTables": 1867,
"savedEventReports": 1977,
"savedEventCharts": 1714,
"savedDashboards": 0,
"savedIndicators": 1646,
"activeUsers": 96,
"users": 953
}
]
Notez que le nombre de activeUsers (utilisateurs actifs) indique le nombre d'utilisateurs distincts qui ont eu des événements au cours de la période de temps demandée. Le nombre de users (utilisateurs) représente le nombre total d'utilisateurs dans le système (à la fois activés et désactivés).
Vous pouvez obtenir le nombre de visualisations pour un favori spécifique en utilisant la ressource favoris, où {favorite-id} (Id du favori) doit être remplacé par l'identifiant du favori en question :
/api/dataStatistics/favorites/{favorite-id}.json
La réponse contiendra le nombre de visualisations pour le favori en question et ressemblera à ceci :
{
"views": 3
}
La ressource geoFeatures vous permet d'extraire des informations géospatiales de DHIS2. Les éléments géospatiaux sont stockées avec les unités d'organisation. La syntaxe utilisée pour extraire ces éléments est identique à la celle utilisée pour la dimension d'unité d'organisation de la ressource analytique. Nous vous recommandons de vous renseigner sur la ressource de l'API analytique avant de poursuivre la lecture de cette section. Vous devez utiliser le type de requête GET et seul le format de réponse JSON est pris en charge.
Par exemple, pour récupérer les éléments géospatiaux de toutes les unités d'organisation situées au niveau 3 de la hiérarchie des unités d'organisation, vous pouvez utiliser une requête GET avec l'URL suivante :
/api/geoFeatures.json?ou=ou:LEVEL-3
Pour récupérer les éléments géospatiaux des unités d'organisation à un niveau situé à l'intérieur d'une unité d'organisation (par exemple au niveau 2), vous pouvez utiliser l'URL suivante :
/api/geoFeatures.json?ou=ou:LEVEL-4;O6uvpzGd5pu
La valeur des coordonnées de la réponse peut être lue à partir de deux propriétés déterminées par le paramètre coordinateField (champ de coordonnées). - La propriété geometry de l'unité d'organisation : c'est le fonctionnement par défaut qui est appliqué lorsque le paramètre coordinateField n'est pas fourni. - L'attribut de l'unité d'organisation de type de valeur GeoJSON : l'API va utiliser le champ coordinateField={attributeId} fourni pour obtenir les coordonnées GeoJSON à partir de la valeur de cet attribut.
Par exemple, si vous voulez récupérer des éléments géospatiaux pour toutes les unités d'organisation au niveau 3 tel que mentionné plus haut, mais en obtenant les coordonnées à partir de l'attribut d'unité d'organisation tJqtSV4quLb, utilisez ceci :
/api/geoFeatures.json?ou=ou:LEVEL-3&coordinateField=tJqtSV4quLb
La sémantique des propriétés de la réponse est décrite dans le tableau suivant :
Tableau : Réponse pour les éléments géospatiaux
| Propriété | Description |
|---|---|
| id | Unité d'organisation / identifiant de l'élément géospatiale |
| na | Unité d'organisation / nom de l'élément géospatiale |
| hcd | Les coordonnées se trouvent vers le bas ; elles indiquent s'il existe une ou plusieurs unités d'organisation subordonnées avec des coordonnées (c'est-à-dire qu'elle(s) se trouvent à un niveau inférieur dans la hiérarchie). |
| hcu | Les coordonnées se trouvent vers le haut ; elles indiquent si l'unité d'organisation mère a des coordonnées (c'est-à-dire qu'elle se trouve à un niveau supérieur dans la hiérarchie). |
| le | Niveau de cette unité d'organisation / élément géospatial |
| pg | Graphique mère : il s'agit du graphique contenant les identifiants des unités d'organisation mères jusqu'à la racine de la hiérarchie. |
| pi | Identifiant mère : il s'agit de l'identifiant de l'ascendant direct de cette unité d'organisation |
| pn | Nom de l'ascendant direct : il s'agit du nom de l'ascendant direct de cette unité d'organisation |
| ty | Type d'élément géospatial, 1 = point et 2 = polygone ou multi-polygone |
| co | Coordonnées de cet élément géospatial |
Pour exporter du GeoJSON, vous pouvez simplement ajouter .geosjon en tant qu'extension au point d'extrémité /api/organisationUnits, ou vous pouvez utiliser l'en-tête Accept avec application/json+geojson.
Deux paramètres sont pris en charge : level (1 par défaut) et parent (unités d'organisation racine par défaut). Les deux paramètres peuvent être ajoutés à plusieurs reprise. Quelques exemples :
Pour obtenir tous les éléments aux niveaux 2 et 4 :
/api/organisationUnits.geojson?level=2&level=4
Pour obtenir tous les éléments au niveau 3 avec une unité d'organisation limite :
/api/organisationUnits.geojson?parent=fdc6uOvgoji&level=3
Les crochets de tableaux analytiques fournissent un mécanisme permettant d'appeler des scripts SQL au cours des différentes phases du processus de génération des tableaux analytiques. Ceci permet de personnaliser les données dans les tableaux de ressources et d'analyse, par exemple pour obtenir une logique spécifique pour les calculs et l'agrégation. Vous pouvez manipuler les crochets de tables analytiques à l'aide du point d'extrémité d'API suivant :
/api/analyticsTableHooks
L'API des crochets de tableaux analytiques prend en charge les opérations CRUD HTTP standard pour créer (POST), mettre à jour (PUT), récupérer (GET) et supprimer (DELETE) des entités.
Les crochets de tableaux analytiques comportent les champs suivants :
Tableau : Champs des crochets de tableaux analytiques
| Champ | Options | Description |
|---|---|---|
| name | Texte | Nom du crochet. |
| phase | RESOURCE_TABLE_POPULATED, ANALYTICS_TABLE_POPULATED (tableau de ressources et tableau analytique renseignés) | Phase au cours de laquelle le script SQL doit être appelé. |
| resourceTableType (type de tableau de ressources) | Voir la colonne "Type de tableau" dans le tableau "Phases, types de tableaux et tableaux temporaires" ci-dessous. | Le type de tableau de ressources pour lequel le script SQL doit être appelé. Ceci ne s'applique qu'aux crochets définis avec la phase RESOURCE_TABLE_POPULATED. |
| analyticsTableType (type de tableau analytique) | Voir la colonne "Type de tableau" dans le tableau "Phases, types de tableaux et tableaux temporaires" ci-dessous. | Le type de tableau analytique pour lequel le script SQL doit être appelé. Ceci ne s'applique qu'aux crochets définis avec la phase ANALYTICS_TABLE_POPULATED. |
| sql | Texte | Le script SQL à appeler. |
La phase ANALYTICS_TABLE_POPULATED a lieu après le remplissage du tableau analytique, mais avant la création des index et le remplacement du tableau temporaire par le tableau principale. Le script SQL va désormais faire référence au tableau analytique temporaire, par exemple analytics_temp, analytics_completeness_temp, analytics_event_temp_ebayegv0exc.
Ceci s'applique également à la phase RESOURCE_TABLE_POPULATED, qui a lieu après le remplissage du tableau de ressources, mais avant la création des index et le remplacement du tableau temporaire par le tableau principal. Le script SQL va désormais faire référence au tableau de ressources temporaire, par exemple _orgunitstructure_temp, _categorystructure_temp.
Vous ne devez définir qu'un seul champ entre resourceTableType et analyticsTableType. Vous le ferez en fonction de la phase définie.
Vous pouvez faire référence au tableau temporaire de la base de données qui correspond uniquement au type du tableau de crochets spécifié (les autres tableaux temporaires ne seront pas disponibles). Par exemple, si vous spécifiez ORG_UNIT_STRUCTURE comme type de tableau de ressources, vous ne pourrez faire référence qu'au tableau temporaire de la base de données _orgunitstructure_temp.
Le tableau suivant présente les combinaisons valables de phases, de types de tableaux et de tableaux temporaire.
Tableau : Phases, types de tableaux et tableaux temporaires
| Phase | Type de tableau | Table temporaire |
|---|---|---|
| RESOURCE_TABLE_POPULATED | ORG_UNIT_STRUCTURE (structure de l'unité d'organisation) | _orgunitstructure_temp |
| DATA_SET_ORG_UNIT_CATEGORY | _datasetorgunitcategory_temp | |
| CATEGORY_OPTION_COMBO_NAME (nom de la combinaison d'options de catégorie) | _categoryoptioncomboname_temp | |
| DATA_ELEMENT_GROUP_SET_STRUCTURE (structure de l'ensemble de groupes d'éléments de données) | _dataelementgroupsetstructure_temp | |
| INDICATOR_GROUP_SET_STRUCTURE (structure de l'ensemble de groupes d'indicateurs) | _indicatorgroupsetstructure_temp | |
| ORG_UNIT_GROUP_SET_STRUCTURE (structure de l'ensemble de groupes d'unités d'organisation) | _organisationunitgroupsetstructure_temp | |
| CATEGORY_STRUCTURE (structure de la catégorie) | _categorystructure_temp | |
| DATA_ELEMENT_STRUCTURE (structure de l'élément de données) | _dataelementstructure_temp | |
| PERIOD_STRUCTURE (structure de la période) | _periodstructure_temp | |
| DATE_PERIOD_STRUCTURE (structure de la période + la date) | _dateperiodstructure_temp | |
| DATA_ELEMENT_CATEGORY_OPTION_COMBO (combinaison d'option de catégorie de l'élément de donnée) | _dataelementcategoryoptioncombo_temp | |
| DATA_APPROVAL_MIN_LEVEL (niveau minimal d'approbation des données) | _dataapprovalminlevel_temp | |
| ANALYTICS_TABLE_POPULATED | DATA_VALUE | analytics_temp |
| COMPLETENESS (complétude) | analytics_completeness_temp | |
| COMPLETENESS_TARGET (cible de complétude) | analytics_completenesstarget_temp | |
| ORG_UNIT_TARGET (cible de l'unité d'organisation) | analytics_orgunittarget_temp | |
| ÉVÉNEMENT | analytics_event_temp_{program-uid} | |
| ENROLLMENT | analytics_enrollment_temp_{program-uid} | |
| VALIDATION_RESULT (résultat de validation) | analytics_validationresult_temp |
You can create hooks with the Maintenance app or with the API.
Pour créer un crochet qui doit être exécuté après le remplissage des tableaux de ressources, vous pouvez effectuer la requête POST suivante en utilisant JSON comme type de contenu :
POST /api/analyticsTableHooks
{
"name": "Update 'Area' in org unit group set resource table",
"phase": "RESOURCE_TABLE_POPULATED",
"resourceTableType": "ORG_UNIT_GROUP_SET_STRUCTURE",
"sql": "update _organisationunitgroupsetstructure_temp set \"uIuxlbV1vRT\" = 'b0EsAxm8Nge'"
}
Pour créer un crochet qui doit être exécuté après le remplissage du tableau d'analyse des valeurs de données, vous pouvez effectuer la requête POST suivante en utilisant le format JSON :
{
"name": "Update 'Currently on treatment' data in analytics table",
"phase": "ANALYTICS_TABLE_POPULATED",
"analyticsTableType": "DATA_VALUE",
"sql": "update analytics_temp set monthly = '200212' where monthly in ('200210', '200211')"
}
Pour créer un crochet qui doit être exécuté après le remplissage des tableaux d'analyse d'événements, vous pouvez effectuer la requête POST suivante en utilisant le format JSON :
{
"name": "Delete data for a data element",
"phase": "ANALYTICS_TABLE_POPULATED",
"analyticsTableType": "EVENT",
"sql": "delete from analytics_event_temp_lxaq7zs9vyr where dx = 'uDX9LKGRwaH'"
}
L'API Web fournit une ressource qui peut être utilisée pour convertir le contenu SVG dans des formats plus utilisés tels que PNG et PDF. Idéalement, cette conversion devrait avoir lieu côté client, mais toutes les technologies côté client ne sont pas en mesure d'effectuer cette tâche. Actuellement, les formats de sortie PNG et PDF sont pris en charge. Le contenu SVG lui-même doit être transmis avec un paramètre de requête svg, et un paramètre de requête facultatif filename peut être utilisé pour spécifier le nom de fichier de la pièce jointe à la réponse. Notez que l'extension du fichier doit être omise. Pour obtenir une réponse dans le format PNG, vous pouvez envoyer une requête POST à l'URL suivante avec pour type de contenu application/x-www-form-urlencoded. Ce processus est identique à la soumission d'un formulaire HTML classique.
api/svg.png
Pour obtenir la réponse dans le format PDF, vous pouvez envoyer une requête POST à l'URL suivante avec pour type de contenu application/x-www-form-urlencoded.
api/svg.pdf
Tableau : Paramètres de requête
| Paramètre de requête | Obligatoire | Description |
|---|---|---|
| svg | Oui | Le contenu SVG |
| nom du fichier | Non | Le nom de fichier de la pièce jointe renvoyée sans extension de fichier |
L'API analytique de valeurs atypiques fournit des endpoints pour l'investigation de la qualité des données sur la base du score Z et du score Z modifié. Ces deux scores sont des mesures statistiques qui permettent d'analyser et d'interpréter les données dans le contexte des écarts par rapport à la valeur moyenne. Ils sont particulièrement utiles pour identifier les valeurs atypiques ou extrêmes dans un ensemble de données. L'API est mise en œuvre sous la forme d'un endpoint analytique unique :
Paramètre de requête
| Paramètre de requête | Description | Obligatoire | Options (par défaut en premier) |
|---|---|---|---|
| ds | Ensemble de données | Oui | Identifiant de l'ensemble de données |
| startDate | Date en début de l'intervalle pour contrôler les valeurs atypiques. | Non (la période de date relative est obligatoire dans ce cas) | Date (aaaa-MM-jj) |
| endDate | Date en fin de l'intervalle pour vérifier les valeurs atypiques | Non (la période de date relative est obligatoire dans ce cas) | Date (aaaa-MM-jj) |
| pe | Les périodes ISO et les périodes relatives | Non (les dates de début et de fin sont obligatoires dans ce cas) | voir le "format de date et de période" |
| relativePeriodDate (Date de la période relative) | Date utilisée comme base pour les périodes relatives. | Non | Date (aaaa-MM-jj) |
| ou | L'unité d'organisation, le niveau de l'unité d'organisation ou les groupes (peuvent être combinés) | Non | Identifiant de l'unité d'organisation (niveau, groupe) |
| en-têtes | Le nom des en-têtes à renvoyer dans la réponse. Un ou plusieurs noms d'en-têtes séparés par des virgules | Non | (NULL), dx, dxname, pename, pe ... |
| orderBy | Trier les enregistrements sur la colonne des valeurs | Non | absdev, zscore, modifiedzscore, median, mean, stddev, medianabsdeviation, lowerbound, upperbound |
| sortOrder | Trier les enregistrements sur la colonne des valeurs par ordre croissant ou décroissant | Non | ASC, DESC |
| algorithm | Algorithme à utiliser pour la détection des valeurs atypiques | Non | Z_SCORE, Z_SCORE_MODIFIÉ |
| threshold | Seuil pour les valeurs atypiques Z_SCORE ou Z_SCORE_MODIFIÉ | Non | Numérique, supérieur à zéro. Par défaut: 3.0 |
| inputIdScheme | Schéma d'identification à utiliser pour les éléments de métadonnées dans la requête. Il peut être un identifiant, un code ou constitué d'attributs. | Non | UID, ID, CODE, NOM |
| maxResults | Nombre maximum de lignes (réponses) | Non | 500 |
| skipRounding (ignorer l'arrondissement des valeurs) | Évite l'arrondissement des valeurs de données, c'est-à-dire que les valeurs fournies ont une précision exacte (échelle 10). | Non | faux, vrai |
Exemple de requête
GET api/analytics/outlierDetection?ds=BfMAe6Itzgt&ou=ImspTQPwCqd&startDate=2022-07-26&endDate=2022-10-26&algorithm=Z_SCORE&maxResults=30&orderBy=value&threshold=3.0&sortOrder=asc&outputIdScheme=code
La réponse est fournie dans plusieurs formats de représentation. Le format par défaut est JSON. Les formats et types de contenu disponibles sont les suivants :
Exemple de réponse
{
"headers":[
{
"name":"dx",
"column":"Data",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"dxname",
"column":"Data name",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"pe",
"column":"Period",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"pename",
"column":"Period name",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"ou",
"column":"Organisation unit",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"ouname",
"column":"Organisation unit name",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"ounamehierarchy",
"column":"Organisation unit name hierarchy",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"coc",
"column":"Category option combo",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"cocname",
"column":"Category option combo name",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"aoc",
"column":"Attribute option combo",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"aocname",
"column":"Attribute option combo name",
"valueType":"TEXT",
"hidden":false,
"meta":false
},
{
"name":"value",
"column":"Value",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"mean",
"column":"Mean",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"stddev",
"column":"Standard deviation",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"absdev",
"column":"Absolute deviation",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"zscore",
"column":"zScore",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"lowerbound",
"column":"Lower boundary",
"valueType":"NUMBER",
"hidden":false,
"meta":false
},
{
"name":"upperbound",
"column":"Upper boundary",
"valueType":"NUMBER",
"hidden":false,
"meta":false
}
],
"metaData":{
"maxResults":30,
"count":3,
"orderBy":"VALUE",
"threshold":3.0,
"algorithm":"Z_SCORE"
},
"rowContext":{
},
"width":18,
"rows":[
[
"DE_22",
"Q_Early breastfeeding (within 1 hr after delivery) at BCG",
"202209",
"September 2022",
"OU_204860",
"Sandaru CHC",
"/Sierra Leone/Kailahun/Penguia/Sandaru CHC",
"COC_292",
"Fixed, <1y",
"default",
"default",
"105.0",
"18.3",
"28.7",
"86.7",
"3.0",
"-67.9",
"104.4"
],
[
"DE_359706",
"BCG doses given",
"202208",
"August 2022",
"OU_595",
"Ngalu CHC",
"/Sierra Leone/Bo/Bargbe/Ngalu CHC",
"COC_292",
"Fixed, <1y",
"default",
"default",
"220.0",
"41.6",
"57.4",
"178.3",
"3.1",
"-130.7",
"213.9"
],
[
"DE_35",
"Yellow Fever doses given",
"202209",
"September 2022",
"OU_1027",
"Yemoh Town CHC",
"/Sierra Leone/Bo/Kakua/Yemoh Town CHC",
"COC_292",
"Fixed, <1y",
"default",
"default",
"466.0",
"48.1",
"114.2",
"417.8",
"3.6",
"-294.6",
"391.0"
]
],
"headerWidth":18,
"height":3
}
| Mesure statistique | Nom de l'en-tête | Description | Lien |
|---|---|---|---|
| Valeur | value | La valeur numérique de l'ensemble ou de l'élément de données (doses de Penta1 administrées, doses de rougeole administrées, etc.) | |
| Signification | moyenne | La valeur moyenne d'un ensemble de nombres. Calculée en additionnant toutes les valeurs et en les divisant par le nombre. | https://www.khanacademy.org/math/statistics-probability/summarizing-quantitative-data |
| Écart type | stddev | Mesure de variation ou de dispersion d'un ensemble de valeurs. | https://www.statisticshowto.com/probability-and-statistics/standard-deviation/ |
| Écart absolu | absdev | La différence absolue entre chaque valeur de données et la valeur moyenne. | https://www.mathsisfun.com/data/mean-absolute-deviation.html |
| Z Score | zscore | Un score standardisé qui représente le nombre d'écarts types d'une valeur de données par rapport à la moyenne. | https://www.statisticshowto.com/probability-and-statistics/z-score/ |
| Z score modifié | Z score modifié | Similaire au score Z mais résistant aux valeurs atypiques. Il utilise la médiane et l'écart absolu médian. | https://www.statisticshowto.com/modified-z-scores/ |
| Écart absolu médian | Écart absolu médian | Mesure solide de la dispersion des valeurs des données, calculée comme la médiane des écarts absolus par rapport à la médiane. | https://math.stackexchange.com/questions/2232309/median-absolute-deviation-mad-formula |
| Minimum | lowerbound | Le minimum est la plus petite valeur d'un ensemble de données. Il représente la plus petite valeur observée parmi toutes les valeurs de données. | |
| Maximum | upperbound | Le maximum est la plus grande valeur d'un ensemble de données. Il représente la valeur observée la plus élevée parmi toutes les valeurs de données. |
All error messages are delivered with http status code 409.
| Code | Message |
|---|---|
| E2200 | Au moins un élément de données doit être spécifié. |
| E2201 | La date de début et la date de fin ou la période relative doivent être spécifiées. |
| E2202 | La date de début doit être antérieure à la date de fin. |
| E2203 | Au moins une unité d'organisation doit être spécifiée. |
| E2204 | Le seuil doit être un nombre positif. |
| E2205 | Les résultats maximum doivent être exprimés en nombres positifs. |
| E2206 | Le nombre maximum de résultats est supérieur à la limite maximale autorisée : 500. |
| E2207 | La date de début des données doit être antérieure à la date de fin des données. |
| E2208 | Valeurs de données non numériques rencontrées lors de la détection des valeurs atypiques. |
| E2209 | La date de début des données n'est pas autorisée. |
| E2210 | La date de fin des données n'est pas autorisée. |
| E2211 | Les valeurs min-max de l'algorithme ne sont pas autorisées. |
| E2212 | Il n'est pas possible de spécifier à la fois une date de début/fin et une période relative. |
| E2213 | La valeur du paramètre orderBy n'est pas compatible avec l'algorithme Z_SCORE. |
| E7180 | Les données analytiques des valeurs atypiques n'existent pas. Veuillez vous assurer que la tâche d'analyse a été exécutée et qu'elle n'a pas ignoré les valeurs atypiques. |
| E7181 | La colonne dxname spécifiée dans orderBy n'est pas éligible pour orderBy ou n'existe pas. |
The values in error messages are examples only.
Exemple de message d'erreur
{
"httpStatus": "Conflict",
"httpStatusCode": 409,
"status": "ERROR",
"message": "Start date and end date or relative period must be specified",
"errorCode": "E2201"
}
L'API analytique fournit des points d'extrémité permettant d'examiner les problèmes liés à la performance des requêtes. Il est implémenté dans tous les points d'extrémité d'analyse :
Exemple
GET /api/analytics/explain?displayProperty=NAME
&dimension=dx:Uvn6LCg7dVU;sB79w2hiLp8,ou:USER_ORGUNIT
&filter=pe:THIS_YEAR&includeNumDen=false&skipMeta=false
&skipData=true&includeMetadataDetails=true
The response will show the execution plan that the PostgreSQL planner generates for the supplied statement.
Le plan d'exécution indique comment le ou les tableau(x) référencé(s) dans l'instruction seront explorés : par un simple scan séquentiel, par un scan d'index, et si plusieurs tableaux sont référencés, quelles jointures seront utilisées pour rassembler les lignes requises à partir de chaque tableau d'entrée.
The most critical part of the display is the estimated statement execution cost, which is the query planner's estimate of how long it will take to run the statement.
Tous les points d'entrée sont sécurisés par une autorisation. Le rôle F_PERFORM_ANALYTICS_EXPLAIN est requis.
/api/analytics/explain
/api/analytics/event/aggregate/{program}/explain
/api/analytics/event/query/{program}/explain
/api/analytics/enrollment/query/{program}/explain
/api/analytics/outlierDetection/explain
DHIS2 comporte un ensemble de tableaux de base de données générés qui sont utilisés comme base pour diverses fonctionnalités du système. Ces tableaux peuvent être exécutés immédiatement ou programmés à intervalles réguliers via l'interface utilisateur. Ils peuvent également être générés via l'API Web, comme expliqué dans cette section. Cette tâche incombe généralement à un administrateur système et non aux clients consommateurs.
Les tables de ressources sont utilisées en interne par l'application DHIS2 pour diverses fonctions d'analyse. Ces tables sont également utiles aux utilisateurs qui rédigent des rapports SQL avancés. Elles peuvent être générées par une requête POST ou PUT à l'URL suivante :
/api/33/resourceTables
Les tableaux analytiques sont optimisés pour l'agrégation des données et sont actuellement utilisés dans DHIS2 pour le module de tableau croisé dynamique. Les tableaux d'analyse peuvent être générés à l'aide d'une requête POST ou PUT à :
/api/33/resourceTables/analytics
Tableau : Paramètres de requête facultatifs des tableaux d'analyse
| Paramètre de requête | Options | Description |
|---|---|---|
| Ignorer les tableaux de ressources | false | true |
| Ignorer l'agrégat | false | true |
| Ignorer les événements | false | true |
| ignorer l'inscription | false | true |
| Ignorer la propriété de l'unité d'Organisation | false | true |
| années précédentes | entier | Nombre de dernières années de données à inclure |
Note
lastYears=0 means latest or continuous analytics, as defined in Continuous analytics table.
Les tâches « Qualité des données “ et ” Surveillance des données » peuvent être exécutées via la tâche de surveillance, déclenchée avec le endpoint
/api/33/resourceTables/monitoring
Cette tâche analyse vos règles de validation, détecte les violations et les conserve en tant que résultats de validation.
Ces demandes sont renvoyées immédiatement et déclenchent un processus côté serveur.
Pour effectuer la maintenance, vous pouvez interagir avec la ressource maintenance. Vous devez utiliser POST ou PUT comme méthode pour les requêtes. Les méthodes suivantes sont disponibles.
La suppression des tables d'analyse entraîne la disparition de toutes les tables d'analyse.
POST PUT /api/maintenance/analyticsTablesClear
L'analyse des tables d'analyse permet de collecter des statistiques sur le contenu des tables d'analyse de la base de données.
POST PUT /api/maintenance/analyticsTablesAnalyze
La suppression des invitations expirées permet de supprimer toutes les invitations de comptes d'utilisateurs qui ont expiré.
POST PUT /api/maintenance/expiredInvitationsClear
L'élagage des périodes permet de supprimer les périodes qui ne sont liées à aucune valeur de données.
POST PUT /api/maintenance/periodPruning
La suppression des valeurs de données nulles permet de supprimer les valeurs de données nulles liées à des éléments de données où les données nulles sont définies comme non significatives :
POST PUT /api/maintenance/zeroDataValueRemoval
La suppression des valeurs de données supprimées de façon réversible supprime définitivement les valeurs de données supprimées de façon réversible.
POST PUT /api/maintenance/softDeletedDataValueRemoval
La suppression de l'instance de l'étape du programme supprimé de façon réversible supprime de façon permanente les événements supprimés de façon réversible.
POST PUT /api/maintenance/softDeletedProgramStageInstanceRemoval
La suppression de l'instance de programme supprimée de façon réversible supprime définitivement les inscriptions supprimées de façon réversible.
POST PUT /api/maintenance/softDeletedProgramInstanceRemoval
La suppression des instances d'entités suivies supprimées de façon réversible supprime définitivement les instances d'entités suivies supprimées de façon réversible.
POST PUT /api/maintenance/softDeletedTrackedEntityInstanceRemoval
Supprimer les vues SQL supprime toutes les vues SQL de la base de données. Notez qu'il ne supprime pas les entités de la vue SQL de DHIS2.
POST PUT /api/maintenance/sqlViewsDrop
Créer des vues SQL va recréer toutes les vues SQL dans la base de données.
POST PUT /api/maintenance/sqlViewsCreate
La mise à jour des combinaisons d'options de catégories supprimera les combinaisons d'options de catégories obsolètes et générera les combinaisons d'options de catégories manquantes pour toutes les combinaisons de catégories.
POST PUT /api/maintenance/categoryOptionComboUpdate
Il est également possible de mettre à jour les combinaisons d'options de catégorie pour une seule combinaison de catégorie en utilisant le point d'extrémité suivant.
POST PUT /api/maintenance/categoryOptionComboUpdate/categoryCombo/<category-combo-uid>
Le nettoyage du cache efface le cache d'hibernation de l'application et les caches de la partition analytique.
POST PUT /api/maintenance/cacheClear
La mise à jour des chemins des unités d'organisation va regénérer la propriété du chemin de l'unité d'organisation. Cela peut être utile, par exemple, si vous avez importé des unités d'organisation avec SQL.
POST PUT /api/maintenance/ouPathsUpdate
L'élagage des données permet de supprimer des enregistrements complets d'ensembles de données, des approbations de données, des audits de valeurs de données et des valeurs de données, dans ce cas pour une unité d'organisation.
POST PUT /api/maintenance/dataPruning/organisationUnits/<org-unit-id>
L'élagage des données pour les éléments de données, qui supprime les audits de valeurs de données et les valeurs de données.
POST PUT /api/maintenance/dataPruning/dataElements/<data-element-uid>
La validation des métadonnées appliquera toutes les règles de validation des métadonnées et renverra le résultat de l'opération.
POST PUT /api/metadataValidation
Le rechargement d'applications actualise le cache des applications installées géré par DHIS2 en lisant le système de fichiers.
POST PUT /api/appReload
Les opérations de maintenance sont prises en charge par lots au moyen d'une requête POST à la ressource api/maintenance, où les opérations sont fournies en tant que paramètres de requête :
POST PUT /api/maintenance?analyticsTablesClear=true&expiredInvitationsClear=true
&periodPruning=true&zeroDataValueRemoval=true&sqlViewsDrop=true&sqlViewsCreate=true
&categoryOptionComboUpdate=true&cacheClear=true&ouPathsUpdate=true
La ressource système vous fournit des informations et des fonctions pratiques. La ressource système se trouve à l'adresse /api/system.
Pour générer des identifiants DHIS2 valides et aléatoires, vous pouvez effectuer une requête GET à cette ressource :
/api/33/system/id?limit=3
Le paramètre de requête limite est facultatif et indique le nombre d'identifiants à renvoyer avec la réponse. La valeur par défaut est de renvoyer un seul identifiant. La réponse contiendra un objet JSON avec un tableau nommé codes, similaire à ceci :
{
"codes": [
"Y0moqFplrX4",
"WI0VHXuWQuV",
"BRJNBBpu4ki"
]
}
Le format DHIS2 UID répond à ces critères :
Long de 11 caractères.
Caractères alphanumériques uniquement, c'est-à-dire caractères alphabétiques ou numériques (A-Za-z0-9).
Commencez par un caractère alphabétique (A-Za-z).
Pour obtenir des informations sur le système actuel, vous pouvez envoyer une requête GET à cette URL :
/api/33/system/info
Les formats de réponse JSON et JSONP sont pris en charge. La réponse info système comprend actuellement les propriétés suivantes.
{
"contextPath": "http://yourdomain.com",
"userAgent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 Chrome/29.0.1547.62",
"calendar": "iso8601",
"dateFormat": "yyyy-mm-dd",
"serverDate": "2021-01-05T09:16:03.548",
"serverTimeZoneId": "Etc/UTC",
"serverTimeZoneDisplayName": "Coordinated Universal Time",
"version": "2.13-SNAPSHOT",
"revision": "11852",
"buildTime": "2013-09-01T21:36:21.000+0000",
"serverDate": "2013-09-02T12:35:54.311+0000",
"environmentVariable": "DHIS2_HOME",
"javaVersion": "1.7.0_06",
"javaVendor": "Oracle Corporation",
"javaIoTmpDir": "/tmp",
"javaOpts": "-Xms600m -Xmx1500m -XX:PermSize=400m -XX:MaxPermSize=500m",
"osName": "Linux",
"osArchitecture": "amd64",
"osVersion": "3.2.0-52-generic",
"externalDirectory": "/home/dhis/config/dhis2",
"databaseInfo": {
"type": "PostgreSQL",
"name": "dhis2",
"user": "dhis",
"spatialSupport": false
},
"memoryInfo": "Mem Total in JVM: 848 Free in JVM: 581 Max Limit: 1333",
"cpuCores": 8
}
Remarque
Si l'utilisateur qui demande cette ressource n'a pas toute l'autorité nécessaire, seules les propriétés qui ne sont pas considérées comme sensibles seront incluses.
Pour obtenir des informations sur le contexte du système uniquement, c'est-à-dire contextPath et userAgent, vous pouvez faire une requête GET à l'URL ci-dessous. Les formats de réponse JSON et JSONP sont supportés :
/api/33/system/context
Pour vérifier si les informations d'identification d'un utilisateur (combinaison d'un nom d'utilisateur et d'un mot de passe) est correcte, vous pouvez envoyer une requête GET à la ressource suivante en utilisant l'option authentification de base :
/api/33/system/ping
Vous pouvez détecter le résultat de l'authentification en inspectant le code du statut HTTP de l'en-tête de la réponse. La signification des codes de statut possibles sont énumérés ci-dessous. Notez que cela s'applique aux demandes d'API Web en général.
Tableau : Codes de statut HTTP
| Code de statut HTTP | Description | Résultat |
|---|---|---|
| 200 | OK | L'authentification a réussi |
| 302 | Trouvé | Aucune information d'identification n'a été fournie avec la requête - aucune authentification n'a eu lieu. |
| 401 | Non autorisé | La combinaison du nom d'utilisateur et du mot de passe est incorrecte - l'authentification a échoué. |
Les tâches qui prennent souvent beaucoup de temps peuvent être exécutées de manière asynchrone. Après avoir initié une tâche asynchrone, vous pouvez interroger son statut via la ressource system/tasks en fournissant la catégorie de tâche et l'identifiant de la tâche qui vous intéresse.
Lorsque vous demandez le statut d'une tâche, vous devez vous authentifier en tant qu'utilisateur ayant initié la tâche. Les catégories de tâches suivantes sont prises en charge :
Tableau : Catégories de tâches
| Identificateur | Description |
|---|---|
| TABLE_ANALYTIQUE | Génération des tableaux analytiques. |
| TABLE_DE RESSOURCES | Génération des tableaux de ressources. |
| SURVEILLANCE | Traitement des règles de validation des données de surveillance/contrôle. |
| IMPORTATION_DE DONNÉES | Importation de données. |
| IMPORTATION_D'ÉVÉNEMENTS | Importation d'événements. |
| IMPORTATION_D'INSCRIPTION | Importation des inscriptions. |
| IMPORTATION_D'IES | Importation d'instances d'entités suivies. |
| IMPORTATION_DE MÉTADONNÉES | Importation de métadonnées. |
| INTÉGRITÉ_DES DONNÉES | Traitement des contrôles d'intégrité des données. |
Chaque tâche asynchrone se voit automatiquement attribuer un identifiant qui peut être utilisé pour contrôler le statut de la tâche. Cet identifiant de tâche est renvoyé par l'API lorsque vous lancez une tâche asynchrone via les différents endpoints activés asynchrones.
Vous pouvez consulter l'état des tâches par le biais d'une requête GET à la ressource des tâches du système, comme suit :
/api/33/system/tasks/{task-category-id}/{task-id}
Un exemple de requête peut ressembler à ceci :
/api/33/system/tasks/DATAVALUE_IMPORT/j8Ki6TgreFw
La réponse fournira des informations sur le statut, telles que le niveau de notification, la catégorie, l'heure et le statut. La propriété terminé indique si le processus est considéré comme terminé.
[{
"uid": "hpiaeMy7wFX",
"level": "INFO",
"category": "DATAVALUE_IMPORT",
"time": "2015-09-02T07:43:14.595+0000",
"message": "Import done",
"completed": true
}]
Vous pouvez consulter toutes les tâches d'une catégorie spécifique par le biais d'une requête GET vers la ressource des tâches du système :
/api/33/system/tasks/{task-category-id}
Un exemple de requête pour consulter le statut des tâches d'importation de données ressemble à ceci :
/api/33/system/tasks/DATAVALUE_IMPORT
Vous pouvez demander une liste de toutes les tâches en cours d'exécution dans le système avec une requête GET à la ressource tâches du système :
/api/33/system/tasks
La réponse ressemblera à ceci :
[{
"EVENT_IMPORT": {},
"DATA_STATISTICS": {},
"RESOURCE_TABLE": {},
"FILE_RESOURCE_CLEANUP": {},
"METADATA_IMPORT": {},
"CREDENTIALS_EXPIRY_ALERT": {},
"SMS_SEND": {},
"MOCK": {},
"ANALYTICSTABLE_UPDATE": {},
"COMPLETE_DATA_SET_REGISTRATION_IMPORT": {},
"DATAVALUE_IMPORT": {},
"DATA_SET_NOTIFICATION": {},
"DATA_INTEGRITY": {
"OB1qGRlCzap": [{
"uid": "LdHQK0PXZyF",
"level": "INFO",
"category": "DATA_INTEGRITY",
"time": "2018-03-26T15:02:32.171",
"message": "Data integrity checks completed in 38.31 seconds.",
"completed": true
}]
},
"PUSH_ANALYSIS": {},
"MONITORING": {},
"VALIDATION_RESULTS_NOTIFICATION": {},
"REMOVE_EXPIRED_RESERVED_VALUES": {},
"DATA_SYNC": {},
"SEND_SCHEDULED_MESSAGE": {},
"DATAVALUE_IMPORT_INTERNAL": {},
"PROGRAM_NOTIFICATIONS": {},
"META_DATA_SYNC": {},
"ANALYTICS_TABLE": {},
"PREDICTOR": {}
}]
La ressource résumés de tâches vous permet de récupérer un résumé d'une invocation d'une tâche asynchrone. Vous devez spécifier la catégorie et, éventuellement l'identifiant de la tâche. L'identifiant de la tâche peut être récupéré à partir de la réponse de la requête API qui a initié la tâche asynchrone.
Pour récupérer le résumé d'une tâche spécifique, vous pouvez envoyer une requête à :
/api/33/system/taskSummaries/{task-category-id}/{task-id}
Un exemple de requête pourrait ressembler à ceci :
/api/33/system/taskSummaries/DATAVALUE_IMPORT/k72jHfF13J1
La réponse ressemblera à ceci :
{
"responseType": "ImportSummary",
"status": "SUCCESS",
"importOptions": {
"idSchemes": {},
"dryRun": false,
"async": true,
"importStrategy": "CREATE_AND_UPDATE",
"reportMode": "FULL",
"skipExistingCheck": false,
"sharing": false,
"skipNotifications": false,
"datasetAllowsPeriods": false,
"strictPeriods": false,
"strictCategoryOptionCombos": false,
"strictAttributeOptionCombos": false,
"strictOrganisationUnits": false,
"requireCategoryOptionCombo": false,
"requireAttributeOptionCombo": false,
"skipPatternValidation": false
},
"description": "Import process completed successfully",
"importCount": {
"imported": 0,
"updated": 431,
"ignored": 0,
"deleted": 0
},
"dataSetComplete": "false"
}
Vous pouvez également récupérer des résumés d'importation pour plusieurs tâches d'une catégorie spécifique avec une requête comme celle-ci :
/api/33/system/taskSummaries/{task-category-id}
Vous pouvez récupérer les icônes de drapeaux disponibles au format JSON à l'aide d'une requête GET :
/api/33/system/flags
Vous pouvez récupérer les styles d'interface utilisateur disponibles au format JSON à l'aide d'une requête GET :
/api/33/system/styles
Lorsque DHIS 2 est configuré en cluster, il est utile de savoir quel nœud du cluster agit en tant que principal nœud du cluster. L'API suivante peut être utilisée pour obtenir les détails de l'instance du nœud principal. L'API prend en charge les formats JSON et XML.
GET /api/36/cluster/leader
Un exemple de réponse JSON ressemble à ceci :
{
"leaderNodeId": "play-dhis2-org-dev",
"leaderNodeUuid": "d386e46b-26d4-4937-915c-025eb99c8cad",
"currentNodeId": "play-dhis2-org-dev",
"currentNodeUuid": "d386e46b-26d4-4937-915c-025eb99c8cad",
"leader": true
}
La ressource éléments de données min-max vous permet de définir des plages de valeurs minimales et maximales pour les éléments de données. Elle est unique en raison de la combinaison de l'unité d'organisation, de l'élément de données et de l'option de catégorie.
/api/minMaxDataElements
Tableau : Structure des données de l'élément Min-max
| Élément | Description | Type de données |
|---|---|---|
| source | Identifiant de l'unité d'organisation | Chaîne |
| dataElement | Identifiant de l'élément de données | Chaîne |
| Combinaison d'options | Identifiant de la combinaison d'options de catégorie de l'élément de données | Chaîne |
| min | Valeur minimale | Entier |
| max | Valeur maximale | Entier |
| généré | Indique si cet objet est généré par le système (et non défini manuellement). | Booléen |
Vous pouvez obtenir une liste de tous les éléments de données min-max à partir de la ressource suivante :
GET /api/minMaxDataElements.json
Vous pouvez filtrer la réponse comme suit :
GET /api/minMaxDataElements.json?filter=dataElement.id:eq:UOlfIjgN8X6
GET /api/minMaxDataElements.json?filter=dataElement.id:in:[UOlfIjgN8X6,xc8gmAKfO95]
Le paramètre de filtrage des éléments de données min-max prend en charge deux opérateurs : eq et in. Vous pouvez également utiliser le paramètre de requête fields.
GET /api/minMaxDataElements.json?fields=:all,dataElement[id,name]
Pour ajouter un nouvel élément de données min-max, utilisez la requête POST à :
POST /api/minMaxDataElements.json
Le format de contenu JSON se présente comme suit :
{
"min": 1,
"generated": false,
"max": 100,
"dataElement": {
"id": "UOlfIjgN8X6"
},
"source": {
"id": "DiszpKrYNg8"
},
"optionCombo": {
"id": "psbwp3CQEhs"
}
}
Si la combinaison de l'élément de données, de l'unité d'organisation et de la catégorie existe, la valeur min-max sera mise à jour.
Pour supprimer un élément de données min-max, envoyez une requête avec la méthode DELETE :
DELETE /api/minMaxDataElements.json
Le contenu JSON est dans le même format que ci-dessus :
{
"min": 1,
"generated": false,
"max": 100,
"dataElement": {
"id": "UOlfIjgN8X6"
},
"source": {
"id": "DiszpKrYNg8"
},
"optionCombo": {
"id": "psbwp3CQEhs"
}
}
To add or update multiple min-max data elements, you can use a POST request to the following resource:
POST /api/minMaxDataElements/upsert
The JSON content format for multiple min-max data elements looks like this:
[
{
"dataSet": "BfMAe6Itzgt",
"values": [
{
"dataElement": "s46m5MS0hxu",
"orgUnit": "Qc9lf4VM9bD",
"optionCombo": "Prlt0C1RF0s",
"minValue": 27,
"maxValue": 564
},
{
"dataElement": "s46m5MS0hxu",
"orgUnit": "Qc9lf4VM9bD",
"optionCombo": "V6L425pT3A0",
"minValue": 0,
"maxValue": 100
}
]
Note that the dataSet property is required in the request body when using JSON. Each min-max value should contain UID references to dataElement, orgUnit, optionCombo. The minValue and maxValue properties represent the minimum and maximum values for the data element, respectively and will be parsed as integers.
You can also specify the generated property if you want to indicate whether the min-max data element is generated by the system or set manually. If not specified, it defaults to true.
Gzipped JSON payloads are also supported for this endpoint, which can be useful for large datasets. The server will automatically decompress the gzipped content. If you send a gzipped payload, make sure to set the Content-Encoding header to gzip and include the Content-Type header with the value application/json. The payload itself should be part of the request body.
CSV payloads are also supported for this endpoint. The CSV file should be delimited with commas. You should set the Content-Type header to text/csv and the Accept header to application/json. You will also need to specify the dataSet query parameter in the request URL. The CSV payload should contain the following columns:
| Column Name | Description |
|---|---|
| dataElement | The UID of the data element |
| orgUnit | The UID of the organisation unit |
| Combinaison d'options | The UID of the category option combo |
| minValue | The minimum value for the data element |
| maxValue | The maximum value for the data element |
| généré | (optional) Indicates whether the min-max data element is generated by the system or set manually. Defaults to true if not specified. |
An example CSV payload might look like this:
dataElement,orgUnit,optionCombo,minValue,maxValue,generated
s46m5MS0hxu,Qc9lf4VM9bD,Prlt0C1RF0s,27,564,false
s46m5MS0hxu,Qc9lf4VM9bD,V6L425pT3A0,0,100,true
To delete multiple min-max data elements, you can use a DELETE request to the following resource:
DELETE /api/minMaxDataElements/delete
The JSON content for the request body should be in the same format as for adding or updating multiple min-max data elements, but you only need to specify the dataElement, orgUnit, and optionCombo properties for each min-max data element you want to delete. The minValue, maxValue, and generated properties are not required for deletion. Gzipped JSON payloads and CSV payloads are also supported for this endpoint, similar to the add/update multiple min-max data elements endpoint. Be sure to set the appropriate headers (Content-Encoding as gzip and Content-Type as application/csv or application/json) when sending the request. If using CSV, you will also need to specify the dataSet query parameter in the request URL.
La ressource exceptions de blocage vous permet d'ouvrir des ensembles de données verrouillés pour la saisie de données pour un ensemble de données, une période et une unité d'organisation spécifiques. Vous pouvez lire les exceptions de verrouillage à partir de la ressource suivante :
/api/lockExceptions
Pour créer une nouvelle exception de verrouillage, vous pouvez utiliser une requête POST et spécifier l'ensemble de données, la période et l'unité d'organisation :
POST /api/lockExceptions?ds=BfMAe6Itzgt&pe=201709&ou=DiszpKrYNg8
Pour supprimer une exception de verrouillage, vous pouvez utiliser une syntaxe de demande similaire avec une requête DELETE :
DELETE /api/lockExceptions?ds=BfMAe6Itzgt&pe=201709&ou=DiszpKrYNg8
The data summary resource provides some metrics about the database and level of system usage. The metrics include: Data statistics can be accessed with a GET request to :
GET /api/dataSummary
A JSON response similar to the one below is provided. We will explain the various parts of the response in the following sections.
Object counts represent the number of different metadata objects in the system. These counts can be useful for monitoring the size and complexity of a DHIS2 instance. An example of the objectCounts part of the response is shown below: Note that these values represent the number of objects at a specific point in time and will change as data is added or removed from the system.
"objectCounts": {
"indicator": 77,
"trackerevent": 55781,
"trackedEntity": 73125,
"visualization": 292,
"period": 384,
"organisationUnit": 1332,
"validationRule": 37,
"dataValue": 4935894,
"dataElement": 1037,
"program": 14,
"organisationUnitGroup": 18,
"singleevent": 317816,
"enrollment": 73126,
"indicatorType": 5,
"eventVisualization": 50,
"event": 373597,
"indicatorGroup": 17,
"dataSet": 26,
"userGroup": 34,
"user": 131,
"dataElementGroup": 84,
"map": 91,
"dashboard": 27
}
In addition to object counts, the data summary response also includes various usage statistics related to users and data in the form of histograms. activeUsers represents the number of users who have performed an action which results in a data statistics event (opened a dashboard, viewed a report, etc.) over the past hour (0), today (1), last 2 days (2), last 7 days (7) and last 30 days (30). Note that the "today" value represents the number of unique users who have been active since midnight server time, while the "last 2 days", "last 7 days" and "last 30 days" values represent the number of unique users who have been active in the respective time periods calculated backwards from the current time. logins represents the number of successful user logins over the same time periods. userInvitations provides the number of user invitations currently in the system, both total and expired. An example of these parts of the response is shown below:
"activeUsers": {
"0": 1,
"1": 1,
"2": 1,
"7": 2,
"30": 2
},
"logins": {
"0": 1,
"1": 1,
"2": 131,
"7": 131,
"30": 131
},
"userInvitations": {
"all": 0,
"expired": 0
}
In addition, the data summary response includes information about different types of data stored in the system. dataValueCount represents the number of data values entered into the system over the past hour (0), today (1), last 7 days (7) and last 30 days (30). singleEventCount and trackerEventCount represents the number of single events and tracker events entered into the system over the same time periods.
"dataValueCount": {
"0": 0,
"1": 0,
"7": 0,
"30": 0
},
"eventCount": {
"0": 0,
"1": 0,
"7": 1,
"30": 2
}
....
Finally, the data summary response includes information about the system itself, such as the version, revision, build time, system ID and current server date. An example of the system part of the response is shown below:
"system": {
"version": "2.43-SNAPSHOT",
"revision": "db516b5",
"buildTime": "2025-11-18T10:53:50.000",
"systemId": "eed3d451-4ff5-4193-b951-ffcc68954299",
"serverDate": "2025-11-18T10:55:15.048"
}
In order to support the long-term monitoring of DHIS2 instances, a special endpoint is available which outputs the data summary information in the Prometheus text exposition format. This can be fetched from the server by making a GET request to : GET api/dataSummary/metrics
An example of the output is provided below
# HELP data_summary_object_counts Count of metadata objects { #help-data_summary_object_counts-count-of-metadata-objects }
# TYPE data_summary_object_counts gauge { #type-data_summary_object_counts-gauge }
data_summary_object_counts{type="indicator"} 77
data_summary_object_counts{type="trackedEntity"} 73125
data_summary_object_counts{type="visualization"} 292
data_summary_object_counts{type="period"} 384
data_summary_object_counts{type="programStageInstance"} 373597
This endpoint provides essentially the same information as the api/dataSummary endpoint, but in a format which Prometheus is capable of scraping and importing. Most of the metrics represent object counts, such as the current number of data elements, organization units, etc.
The build information metric is explained in more detail below.
# HELP data_summary_build_info Build information { #help-data_summary_build_info-build-information }
# TYPE data_summary_build_info gauge { #type-data_summary_build_info-gauge }
data_summary_build_info{version="2.42-SNAPSHOT", commit="932e552"} 1737621197
This metric represents the current version and commit hash of the server. The metric itself is an integer and represents the build time as seconds since the epoch. This metric can be easily converted or to an actual date when needed.
Note On systems with large amounts of data, the
dataValueCountandeventCountmetrics may take a long time to compute due to the large number of records in the database. Users should thus use caution if scraping metrics from this endpoint as it may impact the performance of the server. It should generally be sufficient to scrape this endpoint once per day, since this will provide a good overview of the system usage and performance.
Cette section décrit le service d'échange de données agrégées et l'API.
Le service d'échange de données agrégées permet d'échanger des données entre des instances de DHIS 2, et éventuellement d'autres logiciels qui prennent en charge le format JSON de l'ensemble des valeurs de données de DHIS 2. Il permet également l'échange de données au sein d'une seule instance de DHIS 2, par exemple pour l'agrégation de données de suivi et l'enregistrement du résultat en tant que données agrégées.
Le service d'échange de données agrégées est adapté à des cas d'utilisation tels que :
Le service d'échange de données agrégées permet l'échange de données entre une instance source du DHIS 2 et une instance cible du DHIS 2. Un échange de données peut être externe, c'est-à-dire que l'instance cible est différente/externe à l'instance source. Un échange de données peut également être interne, l'instance cible étant la même que l'instance source. La source d'échange de données agrégées peut contenir plusieurs requêtes de source, une requête de source correspondant à peu près à une requête d'API analytique.
La valeur des données sera récupérée et transformée dans le format ensemble de valeurs de données, puis transmise à l'instance cible de DHIS 2. Le service d'échange de données agrégées prend en charge les systèmes d'identification pour permettre une certaine souplesse dans le mapping des métadonnées entre les instances.
Les données seront récupérées et agrégées à partir de l'instance source à l'aide du moteur d'analyse. Cela implique que les éléments de données, les indicateurs agrégés, les taux de déclaration des ensembles de données et les indicateurs de programme peuvent être référencés dans la requête adressée à l'instance source. Une demande de source contient également des périodes, où les périodes fixes et relatives sont prises en charge, et des unités d'organisation. Un nombre quelconque de filtres peut être appliqué à une requête source.
Un échange de données peut être exécuté en tant que tâche planifiée, c'est-à-dire que l'échange de données peut être programmé pour être exécuté à un intervalle spécifique. Un échange de données peut également être exécuté sur demande via l'API.
Pour créer et manipuler des échanges de données agrégées, les autorités F_AGGREGATE_DATA_EXCHANGE_PUBLIC_ADD / F_AGGREGATE_DATA_EXCHANGE_PRIVATE_ADD et F_AGGREGATE_DATA_EXCHANGE_DELETE sont nécessaires.
Les définitions d'échange de données agrégées sont des métadonnées normales dans DHIS 2, ce qui signifie que les définitions peuvent être importées et exportées entre les instances de DHIS 2, à l'exception des informations d'identification (noms d'utilisateur et jetons d'accès) qui ne seront pas exposées dans les exportations de métadonnées. Les informations d'identification sont cryptées lors du stockage afin de fournir une couche de sécurité supplémentaire.
Le service d'échange de données agrégées a été introduit dans la version 2.39, ce qui signifie que l'instance source de DHIS 2 doit être la version 2.39 ou ultérieure. L'instance cible du DHIS 2 doit être la version 2.38 ou ultérieure.
Pour les échanges de données de type externe, l'URL de base et les informations d'authentification de l'instance DHIS 2 cible doivent être spécifiées. Pour l'authentification, l'authentification de base et les jetons d'accès personnels (PAT) sont pris en charge.
Il est recommandé de spécifier soit l'authentification de base, soit l'authentification PAT. Si les deux sont spécifiées, l'authentification PAT est prioritaire.
Notez que la prise en charge de PAT a été introduite dans la version 2.38.1, ce qui signifie que pour utiliser l'authentification PAT, l'instance DHIS 2 cible doit être la version 2.38.1 ou une version ultérieure.
Like other metadata objects, fine-grained security can be associated with aggregate data exchanges. Each exchange can be shared with individual users and/or user groups to control which users have access to the specific exchange. External data exchanges contain authentication details of users on the target system, thus great care should be taken to ensure that only authorized users have access to actually submit data which results from the exchange.
The following table summarizes how sharing can be used with aggregate data exchanges.
| Partage | Effective permissions |
|---|---|
| "r-------" | Can view metadata of the data exchange. |
| "-w------" | Can edit metadata of the data exchange. |
| "--r-----" | Can view data which is part of the exchange. |
| "---w----" | Can submit data which is part of the exchange. |
L'API d'échange de données agrégées est abordée dans la section qui suit.
POST /api/aggregateDataExchanges
Type de contenu : application/json
Exemple de charge utile d'échange de données internes, où les données d'événement sont calculées avec les indicateurs de programme et sauvegardées en tant que valeurs de données agrégées :
{
"name": "Internal data exchange",
"source": {
"params": {
"periodTypes": [
"MONTHLY",
"QUARTERLY"
]
},
"requests": [
{
"name": "ANC",
"visualization": null,
"dx": [
"fbfJHSPpUQD",
"cYeuwXTCPkU",
"Jtf34kNZhzP"
],
"pe": [
"LAST_12_MONTHS",
"202201"
],
"ou": [
"ImspTQPwCqd"
],
"filters": [
{
"dimension": "Bpx0589u8y0",
"items": [
"oRVt7g429ZO",
"MAs88nJc9nL"
]
}
],
"inputIdScheme": "UID",
"outputDataElementIdScheme": "UID",
"outputOrgUnitIdScheme": "UID",
"outputIdScheme": "UID"
}
]
},
"target": {
"type": "INTERNAL",
"request": {
"dataElementIdScheme": "UID",
"orgUnitIdScheme": "UID",
"categoryOptionComboIdScheme": "UID",
"idScheme": "UID"
}
}
}
Exemple de charge utile d'échange de données externes avec authentification de base et schéma d'identification code, où les données sont transmises à une instance DHIS 2 externe :
{
"name": "External data exchange with basic authentication",
"source": {
"requests": [
{
"name": "ANC",
"visualization": null,
"dx": [
"fbfJHSPpUQD",
"cYeuwXTCPkU",
"Jtf34kNZhzP"
],
"pe": [
"LAST_12_MONTHS",
"202201"
],
"ou": [
"ImspTQPwCqd"
],
"inputIdScheme": "UID",
"outputIdScheme": "CODE"
}
]
},
"target": {
"type": "EXTERNAL",
"api": {
"url": "https://play.dhis2.org/2.38.2.1",
"username": "admin",
"password": "district"
},
"request": {
"idScheme": "CODE"
}
}
}
Exemple de charge utile d'échange de données externes avec authentification PAT et schéma d'identification code, où les données sont transmises à une instance DHIS 2 externe :
{
"name": "External data exchange with PAT authentication",
"source": {
"requests": [
{
"name": "ANC",
"dx": [
"fbfJHSPpUQD",
"cYeuwXTCPkU",
"Jtf34kNZhzP"
],
"pe": [
"LAST_12_MONTHS",
"202201"
],
"ou": [
"ImspTQPwCqd"
],
"inputIdScheme": "UID",
"outputIdScheme": "CODE"
}
]
},
"target": {
"type": "EXTERNAL",
"api": {
"url": "https://play.dhis2.org/2.38.2.1",
"accessToken": "d2pat_XIrqgAGjW935LLPuSP2hXSZwpTxTW2pg3580716988"
},
"request": {
"idScheme": "CODE"
}
}
}
La syntaxe des demandes de source suit la syntaxe de l'API du point d'extrémité de l'analyse. Cela signifie que pour la partie dx, les éléments de données, les indicateurs, les taux de déclaration des ensembles de données, les éléments de données de programme et les indicateurs de programme sont pris en charge. Notez que pour les éléments de données de programme, l'élément de données doit être préfixé avec l'identifiant du programme. Pour la partie pe, les périodes relatives ainsi que les périodes fixes sont prises en charge. Pour la partie ou, les unités d'organisation d'utilisateurs, les niveaux d'unités d'organisation et les groupes d'unités d'organisation ainsi que les unités d'organisation individuelles sont pris en charge. Pour une explication complète, veuillez consulter le chapitre Analytiques > les sections Dimensions et éléments et La dimension dx.
201 Créés
{
"httpStatus": "Created",
"httpStatusCode": 201,
"status": "OK",
"response": {
"responseType": "ObjectReport",
"uid": "pG4bBTMiCqO",
"klass": "org.hisp.dhis.dataexchange.aggregate.AggregateDataExchange",
"errorReports": []
}
}
PUT /api/aggregateDataExchanges/{id}
Type de contenu : application/json
Le contenu de la requête est identique à celui de l'opération de création.
200 OK
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"response": {
"responseType": "ObjectReport",
"uid": "pG4bBTMiCqO",
"klass": "org.hisp.dhis.dataexchange.aggregate.AggregateDataExchange",
"errorReports": []
}
}
GET /api/aggregateDataExchanges/{id}
Accepter: application/json
Les points d'extrémité de récupération suivent la sémantique habituelle de filtrage des champs et des objets des points d'extrémité de métadonnées. JSON est le seul format de réponse pris en charge.
200 OK
DELETE /api/aggregateDataExchanges/{id}
204 No Content
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"response": {
"responseType": "ObjectReport",
"uid": "pG4bBTMiCqO",
"klass": "org.hisp.dhis.dataexchange.aggregate.AggregateDataExchange",
"errorReports": []
}
}
Un échange de données agrégées peut être exécuté directement à l'aide d'une requête POST au point d'extrémité suivant :
POST /api/aggregateDataExchanges/{id}/exchange
200 OK
{
"responseType": "ImportSummaries",
"status": "SUCCESS",
"imported": 36,
"updated": 0,
"deleted": 0,
"ignored": 0,
"importSummaries": ["<import summaries here>"]
}
Un résumé d'importation décrivant le résultat de l'échange de données sera renvoyé, y compris le nombre de valeurs de données qui ont été importées, mises à jour, supprimées et ignorées.
Les données agrégées pour la requête source d'un échange de données agrégées peuvent être récupérées dans le format de données analytiques avec une requête GET au point d'extrémité suivant :
GET /api/aggregateDataExchanges/{id}/sourceData
Accept: application/json
200 OK
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| outputIdScheme (schéma d'identification de la sortie) | Non | Remplacer le schéma d'identification de la sortie pour la réponse aux données. | UID | CODE | ATTRIBUT:{ID} |
Le format de la charge utile de la réponse est identique à celui du point d'extrémité de l'API d'analyse. Ce point final est utile à des fins de débogage. Veuillez consulter le guide de l'API d'analyse pour plus de détails.
Les données agrégées pour la requête source d'un échange de données agrégées peuvent être récupérées dans le format de l'ensemble de valeurs de données avec une requête GET au point d'extrémité suivant :
GET /api/aggregateDataExchanges/{id}/sourceDataValueSets
Accept: application/json
200 OK
| Paramètre de requête | Obligatoire | Description | Options |
|---|---|---|---|
| outputIdScheme (schéma d'identification de la sortie) | Non | Remplacer le schéma d'identification de la sortie pour la réponse aux données. | UID | CODE | ATTRIBUT:{ID} |
Le format de la charge utile de la réponse est identique à celui du point d'extrémité de l'API relatif aux ensembles de valeurs de données. Ce point d'extrémité est utile à des fins de débogage. Veuillez consulter le guide de l'API sur les ensembles de valeurs de données pour plus d'informations.
Le modèle de données d'échange de données agrégées / charge utile est décrit dans la section qui suit.
| Champ | Type de données | Obligatoire | Description |
|---|---|---|---|
| name | Chaîne | Oui | Nom de l'échange de données agrégées. Unique. |
| source | Objet | Oui | Source d'échange de données agrégées. |
| source.params (paramètres source) | Objet | Non | Paramètres pour la requête source. |
| source.params.periodTypes (Types de période des paramètres.source) | Tableau/Chaîne | Non | Types de période autorisés pour remplacer les périodes dans la requête source. |
| source.requests (requêtes source) | Tableau/Objet | Oui | Requêtes de la source. |
| requêtes source (nom des requêtes source) | Chaîne | Oui | Nom de la requête source. |
| source.requests.visualization (visualisations des requêtes source) | Chaîne | Non | Identifiant de l'objet de visualisation associé. |
| source.requests.dx (requêtes source.dx) | Tableau/Chaîne | Oui | Identifiants des éléments de données, des indicateurs, des ensembles de données et des indicateurs de programme pour la requête source. |
| source.requests.pe (requêtes source.pe) | Tableau/Chaîne | Oui | Identifiants des périodes fixes et relatives pour la requête source. |
| source.requests.ou (requêtes source ou) | Tableau/Chaîne | Oui | Identifiants des unités d'organisation pour la requête source. |
| source.requests.filters (filtres de requêtes source) | Tableau (Objet) | Non | Filtres pour la requête source. |
| source.requests.filters.dimension (dimensions des filtres de requêtes source) | Chaîne | Non | Identifiant de dimension pour le filtre. |
| source.requests.filters.items (éléments des filtres de requêtes source) | Tableau/Chaîne | Non | Identifiants des éléments du filtre. |
| source.requests.inputIdScheme ( Schéma d'identification d'entrée des requêtes source ) | Chaîne | Non | Le schéma de l'Identifiant d'entrée peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.requests.outputDataElementIdScheme ( Schéma d'identification de l'élément de données de sortie des requêtes source) | Chaîne | Non | Le schéma de l'identifiant de l'élément de données de sortie peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.requests.outputDataItemIdScheme | Chaîne | Non | Output data item ID scheme applies to data elements, indicators and program indicators, can be UID, CODE, ATTRIBUTE:{ID}. |
| source.requests.outputOrgUnitIdScheme ( Schéma d'identification de l'unité d'organisation de sortie des requêtes source) | Chaîne | Non | Le schéma d'identification de l'unité d'organisation de sortie, peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.requests.outputIdScheme (Schéma d'identification de sortie des requêtes source) | Chaîne | Non | Le schéma d'identification général de sortie peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.cible | Objet | Oui | Cible pour l'échange de données agrégées. |
| source.target.type (type de source cible) | Chaîne | Oui | Le type de cible peut être EXTERNE, INTERNE. |
| source.target.api (api de la source cible) | Objet | Conditionnel | Informations sur l'API cible, obligatoires uniquement pour le type EXTERNAL. |
| source.target.api.url (url de l'api de la source cible) | Chaîne | Conditionnel | URL de base de l'instance DHIS 2 ciblée, ne pas inclure la partie /api. |
| source.target.api.accessToken (jeton d'accès de l'api de la source cible) | Chaîne | Conditionnel | Jeton d'accès (PAT) pour l'instance DHIS 2 ciblée, utilisé pour l'authentification PAT. |
| source.target.api.username ( nom d'utilisateur de l'api de la source cible) | Chaîne | Conditionnel | Nom d'utilisateur de l'instance DHIS 2 ciblée, utilisé pour l'authentification de base. |
| source.target.api.password (mot de passe de l'api de la source cible) | Chaîne | Conditionnel | Mot de passe de l'instance DHIS 2 ciblée, utilisé pour l'authentification de base. |
| source.target.request (requête de la source cible) | Objet | Non | Informations sur la requête cible. |
| source.target.request.dataElementIdScheme ( Schéma de la requête d'identification de l'élément de données de la source cible) | Chaîne | Non | Le schéma d'identification de l'élément de données d'entrée peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.target.request.orgUnitIdScheme ( Schéma de la requête d'identification de l'unité d'organisation de la source cible) | Chaîne | Non | Le schéma d'identification de l'unité d'organisation d'entrée, peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.target.request.categoryOptionComboIdScheme ( Schéma de la requête d'identification de la combinaison d'option de catégorie de la source cible) | Chaîne | Non | Le schéma d'identification de la combinaison d'options de catégorie d'entrée peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.target.request.idScheme ( Schéma de la requête d'identificationn de la source cible ) | Chaîne | Non | Le schéma d'identification général de l'entrée peut être UID, CODE, ATTRIBUTE:{ID}. |
| source.target.request.importStrategy | Chaîne | Non | Import strategy, can be CREATE_AND_UPDATE, CREATE, UPDATE, DELETE. |
| source.target.request.skipAudit | Booléen | Non | "Ignorer l'audit" signifie que les valeurs d'audit ne seront pas générées. Améliore les performances au détriment de la capacité à auditer les modifications. Nécessite l'autorité "F_SKIP_DATA_IMPORT_AUDIT". |
| source.target.request.dryRun | Booléen | Non | Détermine s'il faut sauvegarder les modifications sur le serveur ou renvoyer le récapitulatif de l'importation. |
Lors de l'exécution d'un échange de données par identifiant, des informations sur le résultat de l'opération seront disponibles dans la charge utile de la réponse. La réponse contiendra une liste de résumés d'importation, c'est-à-dire un résumé d'importation par requête source. Le résumé d'importation indiquera tout conflit potentiel résultant de l'extraction des données de l'instance source et de l'importation des données dans l'instance cible.
Cet exemple montre comment échanger des données basées sur des indicateurs de programme dans l'instance source de DHIS 2 et des éléments de données dans l'instance cible. Le schéma d'identification code signifie que l'échange de données utilisera la propriété code des métadonnées pour référencer les données. L'utilisation de codes est utile lorsque les propriétés de l'identifiant ne correspondent pas d'une instance DHIS 2 à l'autre. L'exemple montre comment les données peuvent être agrégées dans l'instance source, y compris l'agrégation dans le temps et la hiérarchie des unités, avant d'être échangées avec l'instance cible.
L'exemple échangera des données en utilisant l'environnement de jeu DHIS 2, et se référera à la version 2.39 à https://play.dhis2.org/2.39 comme instance source, et à la version 2.38 à https://play.dhis2.org/2.38.2.1 comme instance cible. Notez que les URL changeront au fil du temps, à mesure que de nouvelles versions de correctifs seront publiées, donc assurez-vous de mettre à jour les URL cibles.
Connectez-vous à l'instance source, naviguez jusqu'à l'application Maintenance et vérifiez l'existence de trois indicateurs de programme.
doses de BCG avec le code BCG_DOSE
MEASLES_DOSE doses de fièvre jaune avec le code YELLOW_FEVER_DOSE
Observez que l'unité d'org racine est Sierra Leone avec le code OU_525.
Connectez-vous à l'instance cible et accédez à l'application Maintenance. Créez trois éléments de données, dont les codes correspondent aux indicateurs de programme mentionnés précédemment :
Nom doses de BCG et le code BCG_DOSE
MEASLES_DOSENom doses de fièvre jaune avec le code YELLOW_FEVER_DOSE
Dans l'instance cible, créez un nouvel ensemble de données avec un nom quelconque, par exemple Échange de données, sélectionnez les trois éléments de données nouvellement créés et affectez l'ensemble de données à l'unité d'organisation principale Sierra Leone.
Notons que l'unité d'organisation racine Sierra Leone a le code OU_525, qui est égal à l'instance source.
Ouvrez un outil HTTP tel que Postman et créez la charge utile d'échange de données agrégées suivante en JSON.
POST /api/aggregateDataExchanges
Content-Type: application/json
{
"name": "Immunization doses program indicators to data elements",
"source": {
"requests": [
{
"name": "Immunization doses",
"dx": [
"BCG_DOSE",
"MEASLES_DOSE",
"YELLOW_FEVER_DOSE"
],
"pe": [
"202201"
],
"ou": [
"OU_525"
],
"inputIdScheme": "code",
"outputIdScheme": "code"
}
]
},
"target": {
"type": "EXTERNAL",
"api": {
"url": "https://play.dhis2.org/2.38.2.1",
"username": "admin",
"password": "district"
},
"request": {
"idScheme": "code"
}
}
}
Dans cette charge utile, on remarque que pour la requête source, les indicateurs de programme sont référencés à l'aide de codes. Le paramètre inputIdScheme est fixé à code, ce qui signifie que le moteur d'analyse de DHIS 2 utilisera la propriété code pour référencer les métadonnées, telles que les indicateurs de programme. Le paramètre outputIdScheme est fixé à code, ce qui signifie que la propriété code sera utilisée pour référencer les métadonnées dans la sortie. Pour la requête cible, le idScheme est également fixé à code, ce qui signifie que la propriété code sera utilisée pour référencer les métadonnées lors de l'importation de la valeur des données. Notez que les schémas d'identification peuvent être spécifiés par type d'entité, comme dataElementIdScheme et orgUnitIdScheme.
Notez que la période est 202201 ou janvier 2022. Il se peut que la période soit mise à jour au fil du temps.
Exécutez la requête POST pour créer la définition d'échange de données agrégées. Confirmez que le code d'état de la réponse de l'API est 201. Notez que le nom de l'échange de données est unique. Notez l'ID de l'objet nouvellement créé en regardant response > uid dans le corps de la réponse.
Exécutez l'échange de données nouvellement créé avec une requête POST (remplacez {id} par l'ID de l'échange de données) :
POST /api/aggregateDataExchanges/{id}/exchange
Confirmez que la réponse de l'API indique que trois valeurs de données ont été importées avec succès.
{
"responseType": "ImportSummaries",
"status": "SUCCESS",
"imported": 3,
"updated": 0,
"deleted": 0,
"ignored": 0
}
Dans l'instance cible, naviguez jusqu'à l'application Saisie de données, sélectionnez l'unité d'organisation Sierra Leone, l'ensemble de données Échange de données et la période Janvier 2022. On observe que les valeurs des données échangées sont visibles dans le formulaire.
En résumé, dans cet exemple, les enregistrements de données d'événements ont été agrégés du niveau de l'établissement au niveau national, dans la hiérarchie des unités d'organisation, et des données d'événements aux données mensuelles à l'aide d'indicateurs de programme. Les données ont été échangées avec une instance DHIS 2 cible en utilisant la propriété code pour référencer les métadonnées.
DHIS2 prend en charge les traductions à la fois pour l'interface utilisateur et pour le contenu de la base de données.
Vous pouvez récupérer les langues disponibles pour l'interface utilisateur par le biais de la ressource suivante avec une requête GET. Les représentations XML et JSON sont prises en charge.
/api/33/locales/ui
An example of the response in JSON format:
[
{
"locale": "ar",
"languageTag": "ar",
"name": "العربية",
"displayName": "Arabic"
},
{
"locale": "ar_EG",
"languageTag": "ar-EG",
"name": "العربية (مصر)",
"displayName": "Arabic (Egypt)"
},
{
"locale": "uz_UZ_Cyrl",
"languageTag": "uz-Cyrl-UZ",
"name": "ўзбекча (Кирил, Ўзбекистон)",
"displayName": "Uzbek (Cyrillic, Uzbekistan)"
}
]
The locale property is an internal DHIS2 representation of the locale, and consists of the language code, country code and script code (if applicable) separated by underscores. It should not be confused with the languageTag property, which is the standard IETF BCP 47 language tag representation of the locale, with components separated by hyphens. The name property is the name of the locale in its own language, while the displayName property is the name of the locale in the users's preferred language.
You can retrieve and create locales for the database content with GET and POST requests through the dbLocales resource. XML and JSON resource representations are supported. To POST data, there is one required parameter: country. This should correspond to a valid ISO 3166-1 alpha-2 country code. An optional parameter is language, which should correspond to a valid ISO 639-1 language code. A third option paramater script can also be provided, corresponding to a valid ISO 15924 script code. Do take note that if the script parameter is provided, the language parameter must also be provided.
Example request to get database locales for US English:
/api/locales/dbLocales?country=US&language=en
Example request to create a new database locale for Canadian French: POST /api/locales/dbLocales?country=CA&language=fr
DHIS2 permet de traduire le contenu de la base de données. Si une métadonnée est traduisible, elle aura une propriété traductions.
Cela signifie que vous pouvez récupérer et mettre à jour les traductions en utilisant les ressources des classes de métadonnées telles que api/dataElements, api/organisationUnits, api/dataSets, etc.
Vous pouvez obtenir des traductions pour un objet de métadonnées tel que l'élément de données en envoyant une requête GET à api/dataElements/{dataElementUID}
La réponse contient tous les détails de l'élément de données qui comprend également la propriété traductions comme suit
{
"id": "fbfJHSPpUQD",
"href": "https://play.dhis2.org/dev/api/29/dataElements/fbfJHSPpUQD",
"created": "2010-02-05T10:58:43.646",
"name": "ANC 1st visit",
"shortName": "ANC 1st visit",
"translations":
[
{
"property": "SHORT_NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
},
{
"property": "NAME",
"locale": "fr",
"value": "Soin prénatal 1"
},
{
"property": "NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
}
]
}
traductions d'un objet en envoyant une requête GET à api/dataElements/{dataElementUID}/translations {
"translations":
[
{
"property": "SHORT_NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
},
{
"property": "NAME",
"locale": "fr",
"value": "Soin prénatal 1"
},
{
"property": "NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
}
]
}
Vous pouvez faire des traductions en envoyant une requête PUT avec le même format JSON à api/dataElements/{dataElementUID}/translations
{
"translations":
[
{
"property": "SHORT_NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
},
{
"property": "NAME",
"locale": "fr",
"value": "Soin prénatal 1"
},
{
"property": "DESCRIPTION",
"locale": "fr",
"value": "description in french"
},
{
"property": "FORM_NAME",
"locale": "fr",
"value": "name in french"
}
]
}
Il est également possible de mettre à jour l'objet avec la charge, y compris la propriété traductions.
Envoyez une requête PUT à api/dataElements/{dataElementUID} avec l'objet complet comme ci-dessous :
{
"id": "fbfJHSPpUQD",
"created": "2010-02-05T10:58:43.646",
"name": "ANC 1st visit",
"shortName": "ANC 1st visit",
"translations":
[
{
"property": "SHORT_NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
},
{
"property": "NAME",
"locale": "fr",
"value": "Soin prénatal 1"
},
{
"property": "NAME",
"locale": "en_GB",
"value": "ANC 1st visit"
}
]
}
Le code de statut sera 204 No Content si la valeur de données a été sauvegardée ou mise à jour avec succès, ou 409 Conflit si une erreur de validation s'est produite (par exemple, plus d'un NOM_COURT pour la même langue).
Les propriétés communes qui prennent en charge les traductions sont listées dans le tableau ci-dessous.
Tableau : Noms des propriétés
| Nom de la propriété | Description |
|---|---|
| name | Nom de l'objet |
| Nom court | Nom court de l'objet |
| description | Description de l'objet |
Les classes qui prennent en charge les traductions sont listées dans le tableau ci-dessous.
Tableau : Noms des classes
| Nom de la classe | Description | Autres propriétés traduisibles |
|---|---|---|
| Option de Catégorie d'Élément de Données | Option de catégorie | |
| Categorie d'Eléments de Données | Catégorie | |
| Combinaison de Catégorie d'Eléments de Données | Combinaison de catégories | |
| DataElement | Élément de données | |
| Groupe d'Eléments de Données | Groupe d'éléments de données | |
| Ensemble de Groupe d'Eléménts de Données | Ensemble de groupes d'éléments de donnée | |
| Indicateur | Indicateur | description du numérateur, description du dénominateur |
| Type d'indicateur | Type d'indicateur | |
| Groupe d'indicateurs | Groupe d’indicateurs | |
| Ensemble de Groupe d'Indicateur | Ensemble de groupes d'indicateurs | |
| Unité d'organisation | Unité d’organisation | |
| Groupe d'Unité d'Organisation | Groupe d'unités d'organisation | |
| Ensemble de Groupe d'Unité d'Organisation | Ensemble de groupes d'unités d'organisation | |
| Ensemble de données | Ensemble de données | |
| Section | Section de l'ensemble des données | |
| Règle de validation | Règle de validation | instruction |
| Groupes de règles de validation | Groupe de règles de validation | |
| Programme | Programme | étiquette de date d'inscription, étiquette de date d'incident |
| Étape de programme | Étape du programme | étiquette de la date d'exécution, étiquette de la date d'échéance |
| Attribut d'entité suivie | Attribut d’entité suivie | |
| Entité suivie | Entité suivie | |
| Type de relation | Type de relation pour les instances d'entités suivies | fromToName, toFromName |
| Ensemble d'options | Ensemble d'options | |
| Option | Option | |
| Attribut | Attribut des métadonnées | |
| Modèle de notification de programme | Modèle de notification de programme | modèle de sujet, modèle de message |
| Modèle de notification de validation | Modèle de notification de validation | modèle de sujet, modèle de message |
| Modèle de notification de l'ensemble de données | Modèle de notification de l'ensemble de données | modèle de sujet, modèle de message |
| Visualisation | Visualisation | titre, sous-titre, étiquette d'axe de plage, étiquette de ligne de base, étiquette de ligne cible, étiquette d'axe de domaine |
| Action de règle de programme | Action de règle de programme | contenu |
| Prédicteur | Prédicteur | Nom, nom court, description, description du générateur |
| Règle de validation | Règle de validation | Nom, Description, Instruction, Expression du côté gauche, Expression du côté droit |
Pour récupérer les paires clé-valeur des chaînes traduites, vous pouvez utiliser la ressource i18n.
/api/33/i18n
Le point d'accès est situé à /api/i18n et le format de la requête est un simple tableau de paires de valeurs clés :
[
"access_denied",
"uploading_data_notification"
]
La requête doit être de type POST et utiliser l' application/json comme type de contenu. Un exemple utilisant curl, en supposant que les données de la requête sont sauvegardées dans le fichier keys.json :
curl -d @keys.json "play.dhis2.org/demo/api/33/i18n" -X POST
-H "Content-Type: application/json" -u admin:district
Le résultat ressemblera à ceci :
{
"access_denied":"Access denied",
"uploading_data_notification":"Uploading locally stored data to the server"
}
Cette section porte sur l'API Web SMS, qui permet d'envoyer et de recevoir des messages texte courts.
L'API Web prend en charge l'envoi de SMS sortants à l'aide de la méthode POST. Les SMS peuvent être envoyés à un ou plusieurs destinataires. Une ou plusieurs passerelles doivent être configurées avant d'utiliser le service. Un SMS ne sera pas envoyé si aucune passerelle n'est configurée. Il nécessite un ensemble de destinataires et un texte de message au format JSON, comme indiqué ci-dessous.
/api/sms/sortant
{
"message":"Texte du Sms",
"destinataires": [
"004712341234",
"004712341235"
]
}
Remarque
La liste des destinataires sera divisée si la taille dépasse la limite
DESTINATAIRES_MAXIMUM_AUTORISÉSde 200.
L'API Web prend également en charge une version de paramètre de requête, mais l'API paramétrée ne peut être utilisée que pour envoyer des SMS à un seul destinataire.
/api/sms/outbound?message=text&recipient=004712341234
Les messages sortants peuvent être récupérés à l'aide de la ressource GET.
GET /api/sms/outbound
GET /api/sms/outbound?filter=status:eq:SENT
GET /api/sms/outbound?filter=status:eq:SENT&fields=*
Les messages sortants peuvent être supprimés à l'aide de la ressource SUPPRIMER.
SUPPRIMER/api/sms/outbound/{uid}
SUPPRIMER /api/sms/outbound?ids=uid1,uid2
La passerelle peut répondre avec les codes de réponse suivants.
Tableau : Codes de réponse de la passerelle
| Code de la réponse | Message de réponse | Description détaillée |
|---|---|---|
| CODE DU_RÉSULTAT_0 | succès | Le message a été envoyé avec succès |
| CODE DU_RÉSULTAT_1 | programmé | Le message a été programmé avec succès |
| CODE DU_RÉSULTAT_22 | erreur fatale interne | erreur fatale interne |
| CODE DU_RÉSULTAT_23 | échec de l'authentification | Les données de l'authentification sont incorrectes |
| CODE DU_RÉSULTAT_24 | échec de la validation des données | Les paramètres fournis dans la demande sont incorrects |
| CODE DU_RÉSULTAT_25 | crédits insuffisants | Le crédit est insuffisant pour envoyer un message |
| CODE DU_RÉSULTAT_26 | montant du crédit non disponible | Montant du crédit non disponible |
| CODE DU_RÉSULTAT_27 | vous avez dépassé votre quota journalier | vous avez dépassé votre quota journalier |
| CODE DU_RÉSULTAT_40 | temporairement indisponible | Le service est temporairement interrompu |
| CODE DU_RÉSULTAT_201 | taille maximale du lot dépassée | Taille maximale du lot dépassée |
| CODE DU_RÉSULTAT_200 | succès | La requête a été traitée avec succès |
| CODE DU_RÉSULTAT_202 | accepté | Le(s) message(s) sera(ont) traité(s) |
| CODE DU_RÉSULTAT_207 | multi-statut | Plus d'un message a été soumis à l'API ; cependant, tous les messages n'ont pas le même statut. |
| CODE DU_RÉSULTAT_400 | mauvaise requête | Échec de validation (paramètres ou en-têtes manquants/invalides) |
| CODE DU_RÉSULTAT_401 | Non-autorisé | Échec de l'authentification. Ce problème peut également être causé par des paramètres de verrouillage de l'IP. |
| CODE DU_RÉSULTAT_402 | paiement requis | Crédit insuffisant pour envoyer un message |
| CODE DU_RÉSULTAT_404 | pas trouvé | La ressource n'existe pas |
| CODE DU_RÉSULTAT_405 | méthode non autorisée | La méthode Http n'est pas supportée par la ressource |
| CODE DU_RÉSULTAT_410 | parti | Le numéro du téléphone portable est bloqué |
| CODE DU_RÉSULTAT_429 | trop de requêtes | Erreur générique de limitation du taux |
| CODE DU_RÉSULTAT_503 | Service indisponible | Une erreur temporaire s'est produite sur notre plateforme - veuillez réessayer |
L'API Web prend en charge la collecte des messages SMS entrants à l'aide de la méthode POST. Les messages entrants acheminés vers l'API Web DHIS2 peuvent être reçus à l'aide de cette API. L'API collecte les messages SMS entrants et les fournit aux auditeurs pour qu'ils les analysent, en fonction du contenu du SMS (commande SMS). Un exemple de charge utile au format JSON est donné ci-dessous. Le texte, l'expéditeur, la date de réception et la date d'envoi sont des paramètres obligatoires. Les autres sont facultatifs, mais le système utilisera la valeur par défaut pour ces paramètres.
/api/sms/entrant
{
"texte" : "texte de l'échantillon",
"auteur": "004712341234",
"iddelapasserelle " : " inconnu",
"date de réception": "2016-05-01",
"date d'envoi":"2016-05-01",
"codage sms": "1",
"statut sms":"1"
}
Les messages entrants peuvent être récupérés à l'aide de la ressource GET.
GET /api/sms/inbound
GET /api/sms/inbound?fields=*&filter=smsstatus=INCOMING
Les messages entrants peuvent être supprimés à l'aide de la ressource SUPPRIMER.
SUPPRIMER /api/sms/inbound/{uid}
SUPPRIMER /api/sms/inbound?ids=uid1,uid2
Pour importer tous les messages non traités
POST /api/sms/entrant/importer
Tableau : Paramètres de requête de l'utilisateur
| Paramètre | Type | Description |
|---|---|---|
| message | Chaîne | Il s'agit d'un paramètre obligatoire qui contient le message textuel proprement dit. |
| auteur | Chaîne | Il s'agit d'un paramètre obligatoire qui indique de qui provient le message. |
| passerelle | Chaîne | Il s'agit d'un paramètre facultatif qui indique l'identifiant de la passerelle. S'il n'est pas présent, le texte par défaut " INCONNU " sera stocké |
| heure de réception | Date | Ce paramètre est facultatif. Il indique l'heure à laquelle le message a été reçu par la passerelle. |
L'API Web expose des ressources qui permettent de configurer et de mettre à jour les configurations de la passerelle SMS.
La liste des différentes passerelles configurées peut être obtenue à l'aide de la méthode GET
GET /api/33/gateways
Les configurations peuvent également être récupérées pour un type de passerelle spécifique à l'aide de la méthode GET.
GET /api/33/gateways/{uid}
De nouvelles configurations de passerelles peuvent être ajoutées à l'aide de POST. L'api POST nécessite un paramètre de requête de type et actuellement sa valeur peut être http,bulksms,clickatell,smpp. La première passerelle ajoutée sera définie par défaut. Une seule passerelle peut être définie par défaut à la fois. La passerelle par défaut ne peut être modifiée que par l'intermédiaire de son interface utilisateur. Si la passerelle par défaut est supprimée, la suivante dans la liste deviendra automatiquement la passerelle par défaut.
POST /api/33/gateways
La configuration peut être mise à jour en fournissant l'uid et la configuration de la passerelle comme indiqué ci-dessous
PUT /api/33/gateways/{uids}
Les configurations peuvent être supprimées pour un type de passerelle spécifique à l'aide de la méthode SUPPRIMER
DELETE /api/33/gateways/{uid}
La passerelle par défaut peut être récupérée et mise à jour.
GET /api/33/gateways/default
Default gateway can be set using the PUT method.
PUT /api/33/gateways/default/{uid}
L'API Web vous permet de créer et de mettre à jour les configurations de la passerelle. Pour chaque type de passerelle, les paramètres de la charge utile JSON sont différents. Des exemples de charges utiles JSON pour chaque passerelle sont donnés ci-dessous. POST est utilisé pour créer et PUT pour mettre à jour les configurations. Le paramètre En-tête peut être utilisé dans le cas de "GenericHttpGateway" pour envoyer un ou plusieurs paramètres en tant qu'en-tête http.
{
"type" : "clickatell",
"nom" : "clickatell",
"nom d'utilisateur": "utilisateur de clickatell",
"authToken": "XXXXXXXXXXXXXXXXXXXX",
"modèle d'url": "https://platform.clickatell.com/messages"
}
{
"type": "bulksms",
"nom": "bulkSMS",
"nom d'utilisateur": "utilisateur bulk",
"mot de passe": "abc123"
}
{
"type": "smpp",
"nom": "smpp gateway2",
"systemId": "smppclient1",
"hôte" : " hôte local",
"type de système": "cp",
"Indicateur de plan de numérotation": "INCONNU",
"typeDeNombre": "INCONNU",
"type de lien": "BIND_TX",
"port": 2775,
"mot de passe" : "mot de passe",
"compressé" : faux
}
{
"type": "http",
"nom": "Générique",
"modèle de configuration": "nom d'utilisateur=${nom d'utilisateur}&mot de passe=${mot de passe}&to=${destinataires}&code pays=880&message=${text$}&identifiant du message=0",
"useGet": faux,
"paramètres d'envoi d'URL":faux,
"type de contenu": "APPLICATION_JSON",
"modèle d'url":"https://samplegateway.com/messages",
"paramètres": [
{
"en-tête": vrai,
"code": faux,
"clé": "nom d'utilisateur",
"valeur": "utilisateur_uio",
"confidentiel": vrai
},
{
"en-tête": vrai,
"code": faux,
"clé": "mot de passe",
"valeur": "123abcxyz",
"confidentiel": vrai
},
{
"en-tête": faux,
"code": faux,
"clé": "rapport de diffusion",
"valeur": "oui",
"confidentiel": faux
}
],
"estParDéfaut": faux
}
Dans une passerelle générique http, il est possible d'ajouter un nombre illimité de paramètres.
Tableau : Paramètres génériques de la passerelle SMS
| Paramètre | Type | Description |
|---|---|---|
| name | Chaîne | nom de la passerelle |
| modèle de configuration | Chaîne | Le modèle de configuration qui est rempli avec les valeurs des paramètres. Par exemple, le modèle de configuration donné ci-dessus sera rempli comme suit : { "to" : "+27001234567", "body" : "Hello World !"} |
| useGet | Booléen | La méthode Http POST est utilisée par défaut. Pour la remplacer par Http GET, l'utilisateur peut attribuer la valeur "true" au paramètre "useGet". |
| type de contenu | Chaîne | Le type de contenu spécifie le type de données envoyées. Les types pris en charge sont l'APPLICATION_JSON, l'APPLICATION_XML, le FORMULAIRE_URL_CODE, TEXTE_CLAIR |
| modèle d'url | Chaîne | modèle d'url |
| En-tête | Booléen | Si le paramètre doit être envoyé dans les en-têtes Http |
| coder | Booléen | Si le paramètre doit être codé |
| key | Chaîne | clé de paramètre |
| value | Chaîne | valeur du paramètre |
| confidentiel | Booléen | Si le paramètre est confidentiel. Ce paramètre ne sera pas exposé à travers l'API |
| Paramètres d'envoi d'Url | Booléen | Si cette option est cochée, le modèle d'url peut être ajouté aux paramètres de la requête. Ceci est utile si l'API de la passerelle ne prend en charge que le HTTP GET. Un exemple de modèle d'url ressemble à ceci "urlTemplate" : "https://samplegateway.com/messages?apiKey={apiKey}&to={recipients},content={text},deliveryreport={dp}". |
HTTP.OK sera renvoyé si les configurations sont sauvegardées avec succès, sinon Erreur s'affiche
Les commandes SMS sont utilisées pour collecter des données par SMS. Ces commandes appartiennent à un type d'analyseur spécifique. Chaque analyseur a des fonctionnalités différentes.
La liste des commandes peut être récupérée à l'aide de la fonction GET.
GET /api/smsCommands
Une commande particulière peut être récupérée à l'aide de GET.
GET /api/smsCommands/uid
Une commande particulière peut être mise à jour à l'aide de PUT.
PUT /api/smsCommands/uid
La commande peut être créée en utilisant POST.
POST /api/smsCommands
Une commande particulière peut être supprimée à l'aide de la commande SUPPRIMER.
DELETE /api/smsCommands/uid
| Type | Utilisation |
|---|---|
| ANALYSEUR_CLÉ_DE VALEUR | Pour la collecte de données agrégées. |
| ANALYSEUR_D'ALERTES | Pour envoyer des messages d'alerte. |
| ANALYSEUR_NON ENREGISTRÉ | Pour la surveillance des maladies et la notification des cas. |
| ANALYSEUR_D'ENREGISTREMENT_D'ENTITÉS_SUIVIES | Pour l'enregistrement de l'entité du tracker. |
| ANALYSEUR_DE SAISIE DE DONNÉES_DE L'ÉTAPE_DU PROGRAMME | Collecte de données pour l'étape du programme. ( L'IES est identifié sur la base du numéro de téléphone ) |
| ANALYSEUR_D'ENREGISTREMENT_D'ÉVÉNEMENTS | Enregistrement d'un événement unique. Elle est utilisée pour les programmes d'événements. |
Ces types de commandes peuvent être utilisés par l'application Android pour l'envoi de données par SMS lorsque la connexion internet n'est pas disponible. Le SMS est composé par l'application Android.
| Type | Utilisation |
|---|---|
| ENSEMBLE DE DONNÉES_AGRÉGÉ | Pour la collecte de données agrégées. |
| ENROLLMENT | Pour l'enregistrement de l'entité du tracker. |
| ÉVÉNEMENT_TRACKER | Inscription à un événement pour les programmes tracker. |
| ÉVÉNEMENT_SIMPLE | Inscription aux programmes d'événements. |
| RELATION | Créer des relations. |
| SUPPRIMER | Supprimer un événement. |
Cette section couvre les méthodes de ressources de l'utilisateur.
/api/users
La ressource utilisateurs offre des paramètres de requête supplémentaires en plus des paramètres standard (par exemple, la pagination). Pour rechercher des utilisateurs dans la ressource vous pouvez utiliser les paramètres suivants.
Tableau : Paramètres de requête de l'utilisateur
| Paramètre | Type | Description |
|---|---|---|
| query | Texte | Valeur de la requête pour le prénom, le nom de famille, le nom d'utilisateur et l'adresse électronique, sensible à la casse. |
| Numéro de Téléphone | Texte | Requête pour un numéro de téléphone. |
| canManage | false | true |
| autorisation de sous-ensemble | false | true |
| dernière connexion | Date | Filtre les utilisateurs qui se sont connectés après la date indiquée. |
| mois inactifs | Numéro | Filtre les utilisateurs qui ne se sont pas connectés pendant le nombre de mois indiqué. |
| inactif Depuis | Date | Filtre les utilisateurs qui ne se sont pas connectés après la date indiquée. |
| auto-inscrit | false | true |
| statut de l'invitation | aucun | all | expiré | Filtre les invitations des utilisateurs, notamment toutes les invitations ou les invitations expirées. |
| ou | Identificateur | Filtre les utilisateurs associés à l'unité d'organisation dont l'identifiant est indiqué. |
| unités d'organisation des utilisateurs | false | true |
| includeChildren | false | true |
| page | Numéro | Le nombre de la page. |
| pageSize | Numéro | La taille de la page |
| limite de l'unité d'organisation | saisie de_données | ; sortie de_données | ; recherche_d'ies | Restreint la recherche aux utilisateurs ayant une unité d'organisation commune avec l'utilisateur actuel pour la limite indiquée |
Une requête pour un maximum de 10 utilisateurs avec "konan" comme prénom ou nom de famille (sensible à la casse) qui ont un sous-ensemble d'autorisations par rapport à l'utilisateur actuel :
/api/users?query=konan&authSubset=true&pageSize=10
Récupérer tous les comptes d'utilisateurs qui ont été initialement auto-inscrits :
/api/users?selfRegistered=true
La syntaxe suivante permet d'obtenir des informations complètes sur un utilisateur ayant un identifiant particulier.
/api/users/{id}
Voici un exemple d'identifiant particulier :
/api/users/OYLGMiazHtW
L'API de recherche d'utilisateurs propose un système de récupération des utilisateurs lorsque la réponse comporte un minimum d'informations. Aucune autorité spécifique n'est requise et elle permet aux clients de rechercher des informations telles que le prénom et le nom de famille de l'utilisateur, sans pour autant révéler des informations potentiellement sensibles.
/api/userLookup
Le système de recherche de l'utilisateur comporte deux méthodes.
Vous pouvez effectuer une recherche d'utilisateur par identifiant en utilisant la requête API suivante :
GET /api/userLookup/{id}
L'ID de l'utilisateur sera recherché par rapport aux propriétés d'utilisateur suivantes dans l'ordre indiqué :
Voici donc un exemple de requête :
/api/userLookup/QqvaU7JjkUV
La réponse comportera un minimum d'informations relatives à l'utilisateur.
{
"id": "QqvaU7JjkUV",
"username": "nkono",
"firstName": "Thomas",
"surname": "Nkono",
"displayName": "Thomas Nkono"
}
Vous pouvez réaliser une requête des utilisateurs à partir de la requête API suivante :
GET /api/userLookup?query={string}
Le paramètre de requête query est obligatoire. La chaîne de requête query sera comparée aux propriétés utilisateur suivantes :
En plus du paramètre query, la recherche peut être restreinte par le paramètre orgUnitBoundary comme décrit dans le tableau des paramètres pour les utilisateurs ci-dessus.
Voici donc un exemple de requête :
/api/userLookup?query=John
La réponse comportera des informations relatives aux utilisateurs et correspondants à la requête.
{
"users": [
{
"id": "DXyJmlo9rge",
"username": "jbarnes",
"firstName": "John",
"surname": "Barnes",
"displayName": "John Barnes"
},
{
"id": "N3PZBUlN8vq",
"username": "jkamara",
"firstName": "John",
"surname": "Kamara",
"displayName": "John Kamara"
}
]
}
La création et la mise à jour des utilisateurs sont prises en charge par l'API. Une charge utile de base pour créer un utilisateur ressemble à l'exemple ci-dessous. Notez que le mot de passe sera envoyé en texte clair, n'oubliez donc pas d'activer SSL/HTTPS pour le transport réseau.
{
"id": "Mj8balLULKp",
"firstName": "John",
"surname": "Doe",
"email": "johndoe@mail.com",
"userCredentials": {
"id": "lWCkJ4etppc",
"userInfo": {
"id": "Mj8balLULKp"
},
"username": "johndoe123",
"password": "Your-password-123",
"skype": "john.doe",
"telegram": "joh.doe",
"whatsApp": "+1-541-754-3010",
"facebookMessenger": "john.doe",
"avatar": {
"id": "<fileResource id>"
},
"userRoles": [
{
"id": "Ufph3mGRmMo"
}
]
},
"organisationUnits": [
{
"id": "Rp268JB6Ne4"
}
],
"userGroups": [
{
"id": "wl5cDMuUhmF"
}
]
}
curl -X POST -d @u.json "http://server/api/33/users" -u user:pass
-H "Content-Type: application/json"
Dans la charge utile de création d'utilisateurs, les groupes d'utilisateurs ne sont pris en charge que lors de l'importation ou du POSTing d'un seul utilisateur à la fois. Si vous tentez de créer plus d'un utilisateur tout en spécifiant des groupes d'utilisateurs, vous ne recevrez pas d'erreur et les utilisateurs seront créés, mais aucun groupe d'utilisateurs ne sera affecté. Ceci est prévu et limité en raison de la relation de plusieurs à plusieurs entre les utilisateurs et les groupes d'utilisateurs, les groupes d'utilisateurs étant propriétaires de la relation. Pour mettre à jour ou créer plusieurs utilisateurs et leurs groupes d'utilisateurs, envisagez un programme pour POSTER un à la fois, ou POSTER tous les utilisateurs suivi d'une autre action pour mettre à jour leurs groupes d'utilisateurs tout en spécifiant les identifiants du nouvel utilisateur.
Lors de la création d'un utilisateur, la charge utile peut également contenir les paramètres de l'utilisateur. Ceux-ci sont ajoutés en tant qu'objet settings à l'objet racine. Chaque paire clé-valeur devient un membre de l'objet settings, par exemple :
{
"id": "Mj8balLULKp",
"firstName": "John",
"surname": "Doe",
"settings": {
"keyUiLocale": "de"
},
//...
}
Après la création de l'utilisateur, une entête Location est renvoyée avec l'identifiant nouvellement généré (vous pouvez également fournir le vôtre en utilisant le point d'extrémité /api/system/id). La même charge utile peut alors être utilisée pour faire des mises à jour, mais n'oubliez pas d'utiliser PUT au lieu de POST et le point d'extrémité est désormais /api/users/ID.
curl -X PUT -d @u.json "http://server/api/33/users/ID" -u user:pass
-H "Content-Type: application/json"
Pour plus d'informations sur l'ensemble des données disponibles, voir /api/schemas/user.
Pour plus d'informations sur le téléchargement et la récupération des avatars des utilisateurs, veuillez consulter le point d'extrémité /fileResources.
L'API Web permet d'inviter des personnes à créer des comptes d'utilisateur par le biais de la ressource invite. Pour créer une invitation, vous devez POSTER un utilisateur au format XML ou JSON à la ressource "invite". Un nom d'utilisateur spécifique peut être imposé en définissant le nom d'utilisateur dans l'entité postée. En omettant le nom d'utilisateur, la personne pourra le spécifier elle-même. Le système enverra une invitation par courrier électronique. Il faut pour cela que les paramètres de messagerie soient correctement configurés.
La ressource "invite" est utile pour permettre en toute sécurité à des personnes de créer des comptes sans que personne d'autre ne connaisse le mot de passe ou en transférant le mot de passe en texte clair. La charge utile à utiliser pour l'invitation est la même que pour la création d'utilisateurs. Un exemple de charge utile en JSON ressemble à ceci :
{
"firstName": "John",
"surname": "Doe",
"email": "johndoe@mail.com",
"userCredentials": {
"username": "johndoe",
"userRoles": [{
"id": "Euq3XfEIEbx"
}]
},
"organisationUnits": [ {
"id": "ImspTQPwCqd"
} ],
"userGroups": [ {
"id": "vAvEltyXGbD"
}]
}
L'entité d'invitation de l'utilisateur peut être affichée comme suit :
curl -d @invite.json "localhost/api/33/users/invite" -u admin:district
-H "Content-Type:application/json"
Pour envoyer des invitations à plusieurs utilisateurs en même temps, vous devez utiliser un format légèrement différent. Pour JSON :
{
"users": [ {
"firstName": "John",
"surname": "Doe",
"email": "johndoe@mail.com",
"userCredentials": {
"username": "johndoe",
"userRoles": [ {
"id": "Euq3XfEIEbx"
} ]
},
"organisationUnits": [ {
"id": "ImspTQPwCqd"
} ]
}, {
"firstName": "Tom",
"surname": "Johnson",
"email": "tomj@mail.com",
"userCredentials": {
"userRoles": [ {
"id": "Euq3XfEIEbx"
} ]
},
"organisationUnits": [ {
"id": "ImspTQPwCqd"
} ]
}
]
}
Pour créer plusieurs invitations, vous pouvez envoyer la charge utile à la ressource api/users/invites comme ceci :
curl -d @invites.json "localhost/api/33/users/invites" -u admin:district
-H "Content-Type:application/json"
Certaines conditions doivent être remplies pour que les invitations à ouvrir un compte d'utilisateur soient envoyées :
Le serveur SMTP doit être configuré correctement sur le serveur.
L'utilisateur à inviter doit avoir indiqué un e-mail valide.
Si le nom d'utilisateur est spécifié, il ne doit pas être déjà pris par un autre utilisateur existant.
Si l'une de ces conditions n'est pas remplie, la ressource invitée renvoie un code d'état 409 Conflict accompagné d'un message descriptif.
This endpoint is not meant for external use, unless you are implementing a custom login app, which you probably should not do, unless you have a very good reason.
A user can log in and get a session cookie with the following example:
POST /api/auth/login
with JSON body:
{
"username": "username",
"password": "password",
"twoFactorCode": "two_factor_code"
}
{
"loginStatus": "SUCCESS",
"redirectUrl": "/dhis-web-dashboard/"
}
Important
Avant de confirmer une invitation, il faut qu'un utilisateur administrateur configure l'utilisateur et lui envoie un lien d'invitation. Cette condition préalable ajoute également quelques données nécessaires dans la table de la base de donnéesuserinfoou informations d'utilisateur (idToken,restoreToken,restoreExpiry) pour cet utilisateur, afin de terminer l'invitation.
Un utilisateur peut confirmer une invitation via le point d'extrémité suivant : POST /api/auth/invite ; avec un corps JSON :
{
"username": "TestUser",
"firstName": "Test",
"surname": "User",
"password": "Test123!",
"email": "test@test.com",
"phoneNumber": "123456789",
"g-recaptcha-response": "recaptchaResponse",
"token": "aWRUb2tlbjpJRHJlc3RvcmVUb2tlbg=="
}
Note La valeur
g-recaptcha-responseserait remplie par l'utilisation de l'interface utilisateur principale de l'application de connexion. Le champtokenattend une valeur encodée en Base64. Dans cet exemple, décodé, c'estidToken:IDrestoreToken. Celui-ci sera envoyé par email à l'utilisateur invité (il est en fait créé en interne (et rempli dans la base de données) durant l'opération/api/users/invite).
Voici un exemple de réponse après une opération réussie :
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"message": "Account updated"
}
Un utilisateur peut s'enregistrer directement via le point d'extrémité suivant : POST /api/auth/registration avec un corps JSON :
{
"username": "testSelfReg",
"firstName": "test",
"surname": "selfReg",
"password": "P@ssword123",
"email": "test@test.com",
"phoneNumber": "12345oooo",
"g-recaptcha-response": "recap response"
}
Voici un exemple de réponse après une opération réussie :
{
"httpStatus": "Created",
"httpStatusCode": 201,
"status": "OK",
"message": "Account created"
}
Ce point d'extrémité est utilisé pour déclencher le flux de mots de passe oubliés. Il peut être déclenché après que soient fournis le nom d'utilisateur ou l'adresse électronique de l'utilisateur dont le mot de passe doit être réinitialisé. Cela se fait via une requête POST /api/auth/forgotPassword avec un corps JSON comme suit :
{
"emailOrUsername": "testUsername1"
}
Une réponse après une opération réussie renvoie un 200 OK vide. Cela devrait déclencher l'envoi d'un email à l'utilisateur pour lui permettre de réinitialiser son mot de passe.
Lorsqu'un utilisateur reçoit un email contenant un lien pour réinitialiser son mot de passe, celui-ci contient un token qui peut être utilisé pour l'opération. POST /api/auth/passwordReset avec un corps JSON :
{
"newPassword": "ChangeMe123!",
"resetToken": "token-value-from-email-link"
}
Une réponse après une opération réussie renvoie un 200 OK vide. L'utilisateur devrait maintenant pouvoir se connecter en utilisant son nouveau mot de passe.
Pour reproduire un utilisateur, vous pouvez utiliser la ressource replica. Reproduire un utilisateur peut être utile pour déboguer ou reproduire des problèmes signalés par un particulier. Vous devez fournir un nouveau nom d'utilisateur et un nouveau mot de passe à l'utilisateur reproduit, que vous allez utiliser pour vous authentifier ultérieurement. Notez que vous avez besoin de l'autorisation ALL pour effectuer cette action. Pour reproduire un utilisateur, vous vous pouvez envoyer une charge utile JSON comme ci-dessous :
{
"username": "user_replica",
"password": "SecretPassword"
}
Cette charge utile peut être envoyée à la ressource réplica, où vous fournissez l'identifiant de l'utilisateur à répliquer dans l'URL :
/api/33/users/<uid>/replica
Voici un exemple de reproduction d'un utilisateur à l'aide de curl :
curl -d @replica.json "localhost/api/33/users/N3PZBUlN8vq/replica"
-H "Content-Type:application/json" -u admin:district
Les administrateurs utilisateurs (disposant des droits appropriés) peuvent réinitialiser le compte d'un autre utilisateur en déclenchant la récupération du mot de passe. Une fois l'opération déclenchée, un e-mail contenant un lien de récupération est envoyé à l'utilisateur. Les utilisateurs qui suivent le lien accèdent à un formulaire qui leur permet de définir un nouveau mot de passe.
Pour déclencher ce flux de travail pour l'utilisateur tH7WIiIJ0O3, utilisez :
POST /api/37/users/tH7WIiIJ0O3/reset
Les comptes d'utilisateurs peuvent être marqués comme désactivés. Un utilisateur désactivé ne peut plus se connecter.
Pour marquer un utilisateur avec l'UID tH7WIiIJ0O3 comme désactivé (nécessite un utilisateur avec les droits appropriés) :
POST /api/36/users/tH7WIiIJ0O3/disabled
Pour permettre à un utilisateur désactivé d'utiliser à nouveau l'outil en question (l'utilisateur doit disposer des droits appropriés) :
POST /api/36/users/tH7WIiIJ0O3/enabled
Une date d'expiration peut être définie pour un compte d'utilisateur. Elle marque le moment à partir duquel le compte d'utilisateur a expiré et ne peut plus être utilisé. L'utilisateur dont le compte a expiré ne peut plus se connecter.
Pour mettre à jour la date d'expiration de l'utilisateur avec l'UID tH7WIiIJ0O3 et la mettre à la date 2021-01-01 (nécessite un utilisateur avec les droits appropriés) :
POST /api/36/users/tH7WIiIJ0O3/expired?date=2021-01-01
Pour désactiver la date d'expiration afin que le compte n'expire jamais utiliser en conséquence (nécessite un utilisateur disposant des droits appropriés) :
POST /api/36/users/tH7WIiIJ0O3/unexpired
Pour connaître les flux de travail et les niveaux d'approbation des données auxquels un utilisateur peut accéder, vous pouvez utiliser la ressource dataApprovalWorkflows comme suit :
GET /api/users/{id}/dataApprovalWorkflows
If linked accounts are enabled in dhis.conf and a user has logged in via OIDC, then it is possible for the user to switch between DHIS2 accounts that are linked to the same identity provider account using this API call:
GET /dhis-web-commons-security/logout.action?current={current_username}&switch={username_to_switch_to}
Cette opération a pour effet de déconnecter l'utilisateur actuel et de connecter le nouvel utilisateur. L'opération semble transparente, sauf que le nouvel utilisateur se retrouve sur la page par défaut de l'instance DHIS2.
Notez que cet appel API sera probablement modifié à l'avenir, mais que sa fonction générale restera la même.
Pour consulter la liste des utilisateurs vers lesquels il est possible de basculer, utilisez cet appel API :
GET /api/account/linkedAccounts
Pour obtenir des informations sur l'utilisateur actuellement authentifié et ses associations avec d'autres ressources, vous pouvez utiliser la ressource me (vous pouvez également l'appeler par son ancien nom currentUser). Les ressources liées à l'utilisateur actuel fournissent des informations utiles lors de la création de clients, par exemple pour la saisie de données et la gestion des utilisateurs. Les paragraphes suivants décrivent ces ressources et leur objectif.
Fournit des informations de base sur l'utilisateur sous lequel vous êtes actuellement connecté. en tant qu'utilisateur, y compris le nom d'utilisateur, les informations d'identification de l'utilisateur, les unités d'organisation affectées:
/api/me
Donne des informations sur les messages non lus et les interprétations :
/api/me/tableau de bord
Pour modifier le mot de passe, ce point d'extrémité peut être utilisé pour valider le mot de passe nouvellement saisi. le nouveau mot de passe. La validation du mot de passe sera effectuée sur la base des PasswordValidationRules configurées dans le système. Ce point d'extrémité prend en charge POST et la chaîne du mot de passe doit être envoyée dans le corps de POST.
/api/me/valider le mot de passe
Lors d'un changement de mot de passe, ce point final (support POST) peut être utilisé pour vérifier l'ancien mot de passe. La chaîne du mot de passe doit être envoyée dans le corps du POST.
/api/me/verifier le mot de passe
Renvoie l'ensemble des autorisations accordées à l'utilisateur actuel :
/api/me/authorisation
Renvoie vrai ou faux, indiquant si l'utilisateur actuel a reçu l'autorisation <auth> donnée:
/api/me/authorisation/<auth>
Indique les niveaux d'approbation des données correspondant à l'utilisateur actuel :
/api/me/Niveaux d'approbation des données
Indique les flux de travail d'approbation des données accessibles à l'utilisateur actuel. Pour chaque flux de travail, indique les niveaux d'approbation des données que l'utilisateur peut voir, et les autorisations dont il dispose à chaque niveau :
/api/me/dataApprovalWorkflows
Vous pouvez manipuler les paramètres du système en interagissant avec la ressource systemSettings. Un paramètre système est une simple paire clé-valeur, où la clé et la valeur sont des chaînes de texte en clair. Pour enregistrer ou mettre à jour un paramètre système, vous pouvez envoyer une requête POST à l'URL suivante :
/api/33/systemSettings/my-key?value=my-val
Vous pouvez également soumettre la valeur du paramètre dans le corps de la requête, où le type de contenu est défini sur "texte/clair". Par exemple, vous pouvez utiliser curl comme suit :
curl "play.dhis2.org/demo/api/33/systemSettings/my-key" -d "My long value"
-H "Content-Type: text/plain" -u admin:district
Pour définir les paramètres du système en bloc, vous pouvez envoyer un objet JSON avec une propriété et une valeur pour chaque paire clé-valeur de paramètre du système à l'aide d'une requête POST :
{
"notification de l'application clé" : "Bienvenue",
"intro de l'application clé": "DHIS2",
"pied de page de l'application clé" : "En savoir plus sur dhis2.org"
}
Les traductions pour les clés de paramétrage traduisibles peuvent être définies en spécifiant le paramètre local comme paramètre de requête et la valeur traduite qui peut être spécifiée soit comme paramètre de requête, soit dans la charge utile du corps. Voir un exemple d'URL :
/api/33/systemSettings/<my-key>?locale=<my-locale>&value=<my-translated-value>
Vous devez remplacer my-key par votre clé réelle et my-val par votre valeur réelle. Pour récupérer la valeur d'une clé donnée (en JSON ou en texte brut) vous pouvez envoyer une requête GET à l'URL suivante :
/api/33/systemSettings/my-key
Alternativement, vous pouvez spécifier la clé en tant que paramètre de requête :
/api/33/systemSettings?key=my-key
Si une clé n'est pas retrouvée ou marquée comme confidentielle, une réponse 404 sera renvoyée comme suit :
{
"httpStatus": "Not Found",
"httpStatusCode": 404,
"status": "ERROR",
"message": "Setting does not exist or is marked as confidential",
"errorCode": "E1005"
}
Vous pouvez récupérer des paramètres système spécifiques sous forme de JSON en répétant la clé paramètre de la requête :
curl "play.dhis2.org/demo/api/33/systemSettings?key=keyApplicationNotification&key=keyApplicationIntro"
-u admin:district
Vous pouvez récupérer tous les paramètres du système à l'aide d'une requête GET :
/api/33/systemSettings
Pour récupérer une traduction spécifique pour une clé traduisible donnée, vous pouvez spécifier un paramètre local comme paramètre de requête :
/api/33/systemSettings/<my-key>?locale=<my-locale>
Si elle est présente, la traduction pour le paramètre local donné est renvoyée. Sinon, une valeur est renvoyée. Si aucun paramètre local n'est spécifié pour la clé traduisible, le paramètre local par défaut de l'interface utilisateur est utilisé pour obtenir la traduction correcte. Si la traduction donnée n'est pas présente, la valeur par défaut est renvoyée.
La priorité pour les clés traduisibles est la suivante :
locale spécifiée > UI local par défaut de l'utilisateur > valeur par défaut
Pour supprimer un paramètre du système, vous pouvez envoyer une requête DELETE à l'URL similaire à celle utilisée ci-dessus pour la récupération. Si une clé traduisible est utilisée, toutes les traductions présentes seront également supprimées.
Pour supprimer uniquement une traduction spécifique d'une clé traduisible, il convient d'utiliser la même URL que pour l'ajout d'une traduction et la valeur vide doit être fournie :
/api/33/systemSettings/<my-key>?locale=<my-locale>&value=
Les paramètres système disponibles sont énumérés ci-dessous.
Tableau : Paramètres du système
| Clé | Description | Traduisible |
|---|---|---|
| cléUiLocale | Paramètre local pour l'interface utilisateur | Non |
| cléDbLocale | Paramètre local de la base de données | Non |
| Propriété d'affichage de l'analyse clé | La propriété à afficher dans l'analyse. Par défaut : " nom " | Non |
| Séparateur de groupes de chiffres de l'analyse clé | Le séparateur utilisé pour séparer les groupes de chiffres | Non |
| type clé du domaine actuel | Pas encore en service | Non |
| présentation du tableau de bord clé du tracker | Utilisé par la saisie tracker | Non |
| titre de l'application | Titre de l'application. Par défaut : « DHIS2 » | Oui |
| clé Introduction de l'application | La présentation de l'application | Oui |
| Notification clé de l'application | Notification de l'application | Oui |
| clé Pied de page de l'application | Pied de page gauche de l'application | Oui |
| clé pied de page droit de l'application | pied de page droit de l'application | Oui |
| clé Drapeau | Drapeau de l'application | Non |
| clé Image du drapeau | Drapeau utilisé dans le menu tableau de bord | Non |
| module démarrer | La page de démarrage de l'application. Par défaut : " Intégration du-tableau de bord-de dhis-web " | Non |
| Module Démarrer Activer Faible poids | L'application de la page de départ pour le rendu d'une page de destination légère. Par défaut : " faux " | Non |
| facteur Écart | Facteur d'écart-type de l'analyse des données. Par défaut :"2d" | Non |
| clé Nom de l'hôte de l'email | Nom d'hôte du serveur e-mail | Non |
| clé Port Email | Port du serveur email | Non |
| clé Tls de l'email | Utiliser TLS. Par défaut : « vrai » | Non |
| clé Expéditeur de l'e-mail | Expéditeur de l'e-mail | Non |
| clé Nom d'utilisateur de l'e-mail | Nom d'utilisateur du serveur de l'email | Non |
| clé Mot de passe de l'e-mail | Mot de passe du serveur de l'email | Non |
| Longueur minimale du mot de passe | Longueur minimale du mot de passe | Non |
| Longueur maximale du mot de passe | Longueur maximale du mot de passe | Non |
| clé Paramètre des Sms | Configuration de SMS | Non |
| clé Stratégie de mise en cache | Stratégie de mise en cache. Par défaut : " MIS EN CACHE_6H_DEMAIN " | Non |
| clé Mise en cache | PUBLIC ou PRIVÉ. Détermine si les serveurs proxy sont autorisés à mettre des données en cache ou non. | Non |
| Code régional du numéro de téléphone | Code régional du numéro de téléphone | Non |
| Clé Récupération de compte | Active la récupération des comptes d'utilisateurs. Par défaut : " faux " | Non |
| Clé Verrouillage des touches en cas d'échecs multiples de connexion | Active le verrouillage de l'accès après plusieurs échecs de connexion | Non |
| Analyse de Google UA | Clé d'analyse Google UA pour le suivi de l'utilisation du site | Non |
| Informations d'identification Expirés | Demande de modification du mot de passe du compte utilisateur. Par défaut : « 0 » (jamais) | Non |
| Alerte d'expiration des informations d'identification | Activer l'alerte lorsque les informations d'identification sont proches de la date d'expiration | Non |
| Rappel de l'expiration des informations d'identification en jours | Nombre de jours pendant lesquels l'alerte relative à l'expiration des informations d'identification doit être envoyée avant l'expiration effective. Par défaut : 28 | Non |
| alerte d'expiration du compte | Envoi un e-mail d'alerte aux utilisateurs dont le compte est sur le point d'expirer en raison d'une date d'expiration définie. Par défaut : " faux " | Non |
| expiration du compte en jours | Nombre de jours pendant lesquels l'alerte d'expiration du compte doit être envoyée avant l'expiration réelle. Par défaut : 7 | Non |
| clé Auto inscription, pas de recaptcha | Ne pas exiger de recaptcha pour l'auto-inscription. Par défaut : " faux " | Non |
| secret de recaptcha | Secret de recaptcha de l'API Google. Par défaut : l'API secret de l'instance de jeu dhis2, mais cela ne fonctionnera que sur votre instance locale et pas en production. | Non |
| site de recaptcha | Site de recaptcha de l'API Google. Par défaut : l'API du site de l'instance de jeu dhis2, mais cela ne fonctionnera que sur votre instance locale et pas en production. | Non |
| clé Peut accorder des groupes d'autorisation à ses propres utilisateurs | Permet aux utilisateurs d'attribuer leurs propres rôles. Par défaut : " faux " | Non |
| clé limite maximale de vue Sql | Limite maximale pour la vue SQL | Non |
| keyDataQualityMaxLimit | Max limit for data quality results. Must be between zero and 50,000. | Non |
| clé Respecter les dates de début et de fin des métadonnées dans l'exportation des tableaux analytiques | Lorsque cette option est " vraie ", l'outil d'analyse ignore les données qui ne sont pas comprises dans les dates de début et de fin de l'option de catégorie. Par défaut : " faux " | Non |
| clé Sauter la validation du type de données dans l'exportation de tableaux analytiques | Ne pas valider le type de données dans l'exportation de tableaux analytiques | Non |
| clé Logo personnalisé de la page de connexion | Logo pour la page de connexion personnalisée | Non |
| clé Logo du menu supérieur personnalisé | Logo pour le menu supérieur personnalisé | Non |
| globalShellEnabled | When this property is enabled (set to true), apps will be displayed as iframes within a global shell. This global shell provides a consistent header bar across the system which has expanded functionalities compared to the original header bar. Default: true. | Non |
| clé Seuil de l'année des données du Cache analytique | Les données analytiques plus anciennes que cette valeur (en années) seront toujours mises en cache. La valeur « 0 » désactive ce paramètre. Par défaut : 0 | Non |
| Analyse du début de l'exercice financier | Set financial year start. Options: FINANCIAL_YEAR_FEBRUARY, FINANCIAL_YEAR_APRIL, FINANCIAL_YEAR_JULY, INANCIAL_YEAR_AUGUST, FINANCIAL_YEAR_SEPTEMBER, FINANCIAL_YEAR_OCTOBER. Default: FINANCIAL_YEAR_OCTOBER | Non |
| analyticsWeeklyStart | Set weekly relative period start day. Options: WEEKLY (Monday), WEEKLY_WEDNESDAY, WEEKLY_THURSDAY, WEEKLY_FRIDAY, WEEKLY_SATURDAY, WEEKLY_SUNDAY. Default: WEEKLY (Monday) | Non |
| clé Ignorer le seuil de l'année d'approbation de l'analyse | « 0 » vérifie l'approbation de toutes les données. « -1 » désactive le contrôle de l'approbation. « 1 » ou plus vérifie l'approbation de toutes les données qui sont plus récentes que « 1 » année. | Non |
| clé Limite Maximale Analytique | Nombre maximal d'enregistrements analytiques. Par défaut : « 50000 » | Non |
| KeyTrackedEntityMaxLimit (Clé Limite maximale de l'entité suivie) | Maximum number of tracked entities that are returned by /tracker/trackedEntities. More info here. Default: "50000" | Non |
| keyAnalyticsMaintenanceMode (Clé Mode de maintenance analytique) | Mettre l'analyse en mode maintenance. Par défaut : "false" | Non |
| clé Période d'analyse des Années de compensation | Définit le décalage des années à utiliser dans le processus d'exportation des données analytiques. Si l'année d'une date donnée est en dehors du décalage, le système renvoie un message d'avertissement au cours du processus. À ce stade, l'étape de génération de la période est ignorée. Par exemple : supposons que l'utilisateur du système définisse la valeur du décalage à 5, et que nous soyons en l'an 2023. Cela signifie que l'analyse acceptera d'exporter des dates allant de 2018 (inclus) à 2028 (inclus). Ce qui se traduit par : [2018, 2019, 2020, 2021, 2022, 2023, 2024, 2025, 2026, 2027, 2028]. REMARQUE : Le décalage aura une influence significative sur l'utilisation des ressources. Des valeurs plus élevées entraîneront une utilisation plus importante de la mémoire RAM/HEAP et de l'unité centrale. La définition de nombres négatifs pour cette clé désactivera tout type de validation (ce qui signifie qu'il n'y aura pas d'avertissement) et la plage interne d'années sera utilisée (1970 à l'année en cours plus 10) Par défaut : 22 | Non |
| clé Unités centrales du serveur de la base de données | Nombre d'unités centrales du serveur de base de données. Par défaut : « 0 » (Automatique) | Non |
| clé Dernière exécution réussie des tableaux d'analyse | Conserve l'horodatage de la dernière exécution réussie des tables d'analyse. | Non |
| keyLastSuccessfulLatestAnalyticsPartitionRuntime (clé Temps d'exécution de la dernière analyse de la dernière Partition) | Conserve l'horodatage de la dernière exécution réussie de la partition analytique | Non |
| clé Dernière Exécution de la Surveillance | Conserve l'horodatage de la dernière exécution de la surveillance | Non |
| clé Dernière Syncronisation de Données Réussie | Conserve l'horodatage de la dernière synchronisation réussie des valeurs de données | Non |
| clé Dernière synchronisation réussie d'événements de données | Conserve l'horodatage de la dernière synchronisation réussie des données des programmes d'événements. | Non |
| keyLastCompleteDataSetRegistrationSyncSuccess (clé Succès de la synchronisation de l'enregistrement du dernier ensemble de données complet ) | Conserve l'horodatage de la dernière synchronisation réussie de l'exhaustivité | Non |
| sync Sauter la synchronisation pour les données modifiées avant | Spécifie l'horodatage utilisé pour ignorer la synchronisation de toutes les données modifiées avant ce point dans le temps | Non |
| Dernière mise à jour réussie des tableaux d'analyse | Conserve l'horodatage de la dernière mise à jour réussie des tableaux d'analyse | Non |
| clé Dernière mise à jour réussie de la partition analytique | Conserve l'horodatage de la dernière mise à jour réussie de la partition analytique | Non |
| clé Dernière mise à jour réussie des tableaux de ressources | Conserve l'horodatage de la dernière mise à jour réussie des tableaux de ressources | Non |
| keyLastSuccessfulSystemMonitoringPush (Clé Dernier push réussi de la surveillance du système ) | Conserve l'horodatage de du dernier push réussi de la surveillance du système | Non |
| keyLastSuccessfulMonitoring (clé Dernière surveillance réussie) | Conserve l'horodatage de la dernière surveillance réussie | Non |
| keyNextAnalyticsTableUpdate (clé Mise à jour du tableau analytique suivant) | Conserve l'horodatage de la prochaine mise à jour du tableau d'analyse | Non |
| Lien de la page d'aide | Lien vers la page d'aide. Par défaut : "https://dhis2.github.io/dhis2-docs/master/en/user/html/dhis2_user_manual_en.html | Non |
| keyAcceptanceRequiredForApproval (clé Acceptation requise pour l'approbation) | L'acceptation est requise avant la validation. Par défaut "faux" | Non |
| clé Notifications Email du Système | Où envoyer les notifications du système par e-mail | Non |
| clé Analyse de la Période Relative | Période relative par défaut pour l'analyse. Par défaut : « 12_DERNIERS_MOIS ». | Non |
| keyRequireAddToView (clé Nécessite Ajouter à l'affichage) | Autorisation requise pour l'ajout de listes d'objets à visualiser. Par défaut : « faux » | Non |
| keyAllowObjectAssignment (clé Autoriser l'affectation d'objets) | Autoriser l'affectation d'un objet à des objets apparentés lors d'un ajout ou d'une mise à jour. Par défaut "faux" | Non |
| keyUseCustomLogoFront (Clé Utilisation du logo personnalisé sur la face avant) | Permet l'utilisation d'un logo personnalisé sur la page d'accueil. Par défaut : « faux » | Non |
| keyUseCustomLogoBanner (clé Utiliser une bannière du logo personnalisé) | Permet l'utilisation d'une bannière personnalisée sur le site web. Par défaut : « faux » | Non |
| keyDataImportStrictPeriods (clé Importation de données de Périodes strictes) | Non | |
| keyDataImportStrictPeriods (clé Importation de données de Périodes strictes) | Exige que les périodes correspondent au type de période de l'ensemble de données. Par défaut : « faux » | Non |
| keyDataImportStrictDataElements (Clé Importation de données Éléments de données stricts) | Exiger que les éléments de données fassent partie de l'ensemble de données. Par défaut : « faux » | Non |
| keyDataImportStrictCategoryOptionCombos (clé Importation de données Strict Combinaisons d'options de catégories) | Nécessite que les combinaisons d'options de catégorie correspondent à la combinaison de catégories de l'élément de données. Par défaut : « faux » | Non |
| keyDataImportStrictOrganisationUnits (clé Importation de données Unités d'organisation strictes) | Nécessite que les unités d'organisation correspondent à l'affectation de l'ensemble de données. Par défaut : « faux » | Non |
| keyDataImportStrictAttributeOptionsCombos | Nécessite que l'option d'attribut combis corresponde à la catégorie combo de l'ensemble de données. Par défaut : « faux » | Non |
| keyDataImportStrictDataSetApproval | vrai : si un ensemble de données déjà approuvé existe pour une saisie de valeur de données quelconque, il n'est pas autorisé ; faux : Si un ensemble de données non encore approuvé existe pour une saisie de valeur de données quelconque, l'autorisation est accordée. Par défaut : « vrai » | Non |
| keyDataImportStrictDataSetLocking | vrai : s'il existe un ensemble de données pour lequel la saisie a expiré sans exception de verrouillage pour une valeur de données quelconque, la saisie n'est pas autorisée ; faux : S'il existe un ensemble de données pour lequel la saisie n'a pas expiré ou pour lequel une exception de verrouillage s'applique pour une valeur de données quelconque, la saisie est autorisée. Par défaut : « vrai » | Non |
| keyDataImportStrictDataSetInputPeriods | true : S'il existe un ensemble de données pour lequel la période de saisie est clôturée pour une saisie de valeur de données quelconque, cela n'est pas autorisé ; faux : S'il existe un ensemble de données pour lequel la période de saisie est ouverte pour une saisie de valeur de données quelconque, cela n'est pas autorisé : Par défaut : « vrai » | Non |
| keyDataImportRequireCategoryOptionCombo | Exige que la combinaison d'options de catégorie soit spécifiée. Par défaut : « faux » | Non |
| keyDataImportRequireAttributeOptionCombo | Exige que la combinaison d'options d'attributs soit spécifiée. Par défaut : « faux » | Non |
| keyCustomJs | JavaScript personnalisé à utiliser sur le site web | Non |
| keyCustomCss | CSS personnalisé à utiliser sur le site web | Non |
| clé calendrier | Le type de calendrier. Par défaut : « iso8601 ». | Non |
| keyDateFormat | Format dans lequel les dates doivent être affichées. Par défaut : « aaaa-MM-jj ». | Non |
| cléStyle | The style used by the DHIS2 Android app. Default: "light_blue/light_blue.css". | Non |
| keyRemoteInstanceUrl | Url utilisée pour se connecter à l'instance distante | Non |
| keyRemoteInstanceUsername | Nom d'utilisateur utilisé pour se connecter à l'instance DHIS2 distante | Non |
| keyRemoteInstancePassword | Mot de passe utilisé pour se connecter à l'instance DHIS2 distante | Non |
| keyGoogleMapsApiKey | Clé API Google Maps | Non |
| keyGoogleCloudApiKey | Clé de l'API Google Cloud | Non |
| keyLastMetaDataSyncSuccess | Conserve l'horodatage de la dernière synchronisation réussie des métadonnées. | Non |
| keyVersionEnabled | Permet le versionnage des métadonnées | Non |
| keyMetadataFailedVersion | Conserve les détails de l'échec de la version de synchronisation des métadonnées | Non |
| keyMetadataLastFailedTime | Conserve l'horodatage du dernier échec de synchronisation des métadonnées | Non |
| keyLastSuccessfulScheduledProgramNotifications | Non | |
| keyLastSuccessfulScheduledDataSetNotifications | Non | |
| keyRemoteMetadataVersion | Détails sur la version des métadonnées de l'instance distante | Non |
| keySystemMetadataVersion | Détails sur la version des métadonnées du système | Non |
| keyStopMetadataSync | Drapeau pour arrêter la synchronisation des métadonnées | Non |
| keyFileResourceRetentionStrategy | Détermine la durée de conservation des ressources du fichier associées aux valeurs supprimées ou mises à jour. AUCUNE, TROIS_MOIS, UNE_ANNÉE ou INDÉFINIMENT. | Non |
| syncMaxRemoteServerAvailabilityCheckAttempts | Indique combien de fois la disponibilité du serveur distant sera vérifiée avant que les tâches de synchronisation n'échouent. | Non |
| syncMaxAttempts | Spécifie le nombre maximum de tentatives pour les tâches de synchronisation | Non |
| syncDelayBetweenRemoteServerAvailabilityCheckAttempts | Délai entre les contrôles de disponibilité du serveur distant | Non |
| lastSuccessfulDataStatistics | Conserve l'horodatage de la dernière analyse de données réussie | Non |
| keyHideDailyPeriods | Pas en cours d'utilisation | Non |
| keyHideWeeklyPeriods | Non | |
| keyHideBiWeeklyPeriods | Indicateur booléen utilisé pour masquer/afficher les périodes bihebdomadaires | Non |
| keyHideMonthlyPeriods | Non | |
| keyHideBiMonthlyPeriods | Non | |
| keyGatherAnalyticalObjectStatisticsInDashboardViews | Si l'on souhaite recueillir des statistiques analytiques sur les objets lorsqu'ils sont visualisés dans un tableau de bord. | Non |
| keyCountPassiveDashboardViewsInUsageAnalytics | Comptabilise les consultations « passives » des tableaux de bord (sans sélection d'un tableau de bord particulier) dans l'analyse de l'utilisation. | Non |
| keyDashboardContextMenuItemSwitchViewType | Permet aux utilisateurs de changer le type d'affichage des favoris du tableau de bord | Oui |
| keyDashboardContextMenuItemOpenInRelevantApp | Permet aux utilisateurs d'ouvrir les favoris du tableau de bord dans les applications pertinentes. | Oui |
| keyDashboardContextMenuItemShowInterpretationsAndDetails | Permet aux utilisateurs d'afficher les interprétations et les détails des favoris du tableau de bord | Oui |
| keyDashboardContextMenuItemViewFullscreen | Permet aux utilisateurs d'afficher les favoris du tableau de bord en plein écran | Oui |
| jobsRescheduleAfterMinutes (tâches reprogrammées après des minutes) | Si une tâche est dans le statut RUNNING (en cours d'exécution) pendant ce nombre de minutes ou plus sans faire de progrès sous la forme d'une mise à jour de son chronogramme lastAlive (dernière vue), la tâche est considérée comme périmée et réinitialisée dans le statut SCHEDULED (planifié). | Non |
| jobsCleanupAfterMinutes (Nettoyage des tâches après quelques minutes) | Une tâche "exécutée une fois" est supprimée lorsque ce nombre de minutes s'est écoulé après l'exécution réussie ou non de la tâche. | Non |
| jobsMaxCronDelayHours (tâches Heures maximales de délai Cron) | Une tâche déclenchée par une expression CRON ne se déclenchera que dans la fenêtre comprise entre l'heure cible de la journée et ce nombre d'heures plus tard. S'il n'a pas pu s'exécuter dans cette fenêtre, l'exécution est ignorée et la prochaine exécution selon l'expression CRON est la prochaine exécution cible | Non |
| jobsLogDebugBelowSeconds (tâches Journal de débogage en dessous de secondes) | Une tâche dont l'intervalle d'exécution est inférieur à ce nombre de secondes enregistre ses informations sur le débogage plutôt que sur l'information | Non |
| clé Tâches parallèles dans l'exportation de tableaux analytiques | Renvoie le nombre de tâches parallèles à utiliser pour traiter les tableaux analytiques. Il est prioritaire sur « keyDatabaseServerCpus ». Par défaut : -1 | Non |
| orgUnitCentroidsInEventsAnalytics | If true, the analytics event tables are created with a centroid value for each Data Element or TEA of type OU or OU Geometry. Default: false | Non |
Vous pouvez manipuler les paramètres de l'utilisateur en interagissant avec la ressource userSettings. Un paramètre utilisateur est une simple paire clé-valeur, où la clé et la valeur sont des chaînes de texte en clair. Le paramètre utilisateur sera lié à l'utilisateur authentifié pour la requête de l'API Web. Pour obtenir une liste de tous les paramètres utilisateur, vous pouvez envoyer une requête GET à l'URL suivante :
/api/33/userSettings
Les paramètres non définis par l'utilisateur seront remplacés par les paramètres équivalents du système. Pour ne renvoyer que les valeurs définies explicitement par l'utilisateur, vous pouvez ajouter ?useFallback=false à l'URL ci-dessus, comme ceci :
/api/33/userSettings?useFallback=false
Pour enregistrer ou mettre à jour un paramètre pour l'utilisateur actuellement authentifié, vous pouvez envoyer une requête POST à l'URL suivante :
/api/33/userSettings/my-key?value=my-val
Vous pouvez spécifier explicitement l'utilisateur pour lequel le paramètre doit être sauvegardé en utilisant cette syntaxe :
/api/33/userSettings/my-key?user=username&value=my-val
Vous pouvez également soumettre la valeur du paramètre dans le corps de la requête, où le type de contenu est défini sur "texte/clair". Par exemple, vous pouvez utiliser curl comme suit :
curl "https://play.dhis2.org/demo/api/33/userSettings/my-key" -d "My long value"
-H "Content-Type: text/plain" -u admin:district
Par exemple, pour définir les paramètres linguistiques de l'interface utilisateur de l'utilisateur actuel en français, vous pouvez utiliser la commande suivante.
curl "https://play.dhis2.org/demo/api/33/userSettings/keyUiLocale?value=fr"
-X POST -u admin:district
Vous devez remplacer my-key par votre véritable clé et my-val par votre valeur réelle. Pour récupérer la valeur d'une clé donnée en texte brut, vous pouvez envoyer une requête GET à l'URL suivante :
/api/33/userSettings/my-key
Pour supprimer un paramètre utilisateur, vous pouvez envoyer une requête DELETE à l'URL similaire à celle utilisée ci-dessus pour la récupération.
Les paramètres système disponibles sont énumérés ci-dessous.
Tableau : Paramètres de l'utilisateur
| Clé | Options | Description |
|---|---|---|
| cléStyle | light_blue/light_blue.css | green/green.css | vietnam/vietnam.css | Feuille de style de l'interface utilisateur. |
| Clé Message de notification par Email | false | true |
| clé Notification par message Sms | false | true |
| cléUiLocale | Valeur locale | Locale de l'interface utilisateur. |
| cléDbLocale | Valeur locale | Locale du contenu de la base de données. |
| Propriété d'affichage de l'analyse clé | nom | Nom court | Propriété à afficher pour les métadonnées dans les applications d'analyse. |
| type clé du domaine actuel | tous | ; agrégat | ; tracker | Type de domaine de l'élément de données à afficher dans les listes. |
| clé Sauvegarde automatique du formulaire de saisie de cas | false | true |
| clé Formulaire d'enregistrement automatique des entités suivies | false | true |
| clé Sauvegarde automatique du formulaire de saisie des données | false | true |
| présentation du tableau de bord clé du tracker | false | true |
Pour accéder à la configuration, vous pouvez interagir avec la ressource configuration. Vous pouvez obtenir des réponses XML et JSON via l'en-tête Accepter ou en utilisant les extensions .json ou .xml. Vous pouvez OBTENIR toutes les propriétés de la configuration depuis :
/api/33/configuration
Vous pouvez envoyer des requêtes GET et POST aux ressources spécifiques suivantes :
GET /api/33/configuration/systemId
GET POST DELETE /api/configuration/feedbackRecipients
GET POST DELETE /api/configuration/offlineOrganisationUnitLevel
GET POST /api/configuration/infrastructuralDataElements
GET POST /api/configuration/infrastructuralIndicators
GET POST /api/configuration/infrastructuralPeriodType
GET POST /api/configuration/dataOutputPeriodTypes
GET POST DELETE /api/configuration/selfRegistrationRole
GET POST DELETE /api/configuration/selfRegistrationOrgUnit
GET POST /api/facilityOrgUnitGroupSet
GET POST /api/facilityOrgUnitLevel
Pour la configuration de la liste d'autorisations CORS, vous pouvez effectuer une requête POST avec un tableau d'URLs vers la liste d'autorisations comme charge utile en utilisant "application/json" comme type de contenu, par exemple :
["www.google.com", "www.dhis2.org", "www.who.int"]
GET POST /api/33/configuration/corsAllowlist
Pour les requêtes POST, la valeur de configuration doit être envoyée sous forme de texte dans la charge utile de la requête. Le tableau suivant indique les valeurs de configuration appropriées pour chaque propriété.
Tableau : Valeurs de configuration
| Propriété de la configuration | Valeur |
|---|---|
| Bénéficiaires du retour d'information | Identifiant du Groupe d’utilisateurs |
| niveau de l'unité d'organisation hors ligne | Identifiant du niveau de l'unité d'organisation |
| éléments de données infrastructurelles | Identifiant du groupe d'éléments de données |
| Indicateurs infrastructurels | Identifiant du groupe d'indicateurs |
| Type de période infrastructurelle | Nom du type de période (par exemple « Mensuel ») |
| dataOutputPeriodTypes | JSON list of period type name (e.g. "Monthly", "Quarterly", "Yearly", etc.) |
| rôle d'auto-inscription | Identifiant du rôle d'utilisateur |
| Unité d'organisation d'auto-inscription | Identifiant de l'unité d'organisation |
| Mot de passe smtp | Mot de passe du serveur email SMTP |
| Url du serveur distant | Url au serveur distant |
| Nom d'utilisateur du serveur distant | Nom d'utilisateur pour l'authentification du serveur distant |
| mot de passe du serveur distant | Mot de passe pour l'authentification du serveur distant |
| corsAllowlist (Liste de permis Cors) | Liste JSON des URL |
Par exemple, pour définir le groupe d'utilisateurs des destinataires du retour d'information, vous pouvez invoquer la commande curl suivante :
curl "localhost/api/33/configuration/feedbackRecipients" -d "wl5cDMuUhmF"
-H "Content-Type:text/plain"-u admin:district
La ressource tokens fournit des jetons d'accès à différents services.
Vous pouvez récupérer un jeton d'accès OAuth 2.0 du compte de service Google à l'aide d'une requête GET vers la ressource suivante.
GET /api/tokens/google
Le jeton est valable pendant un certain temps, après quoi un autre jeton doit être demandé à cette ressource. La réponse contient un en-tête de contrôle de cache qui correspond à l'expiration du jeton. La réponse contiendra les propriétés suivantes au format JSON.
Tableau : Réponse du jeton
| Propriété | Description |
|---|---|
| jeton_d'accès | Jeton d'accès OAuth 2.0 à utiliser lors de l'authentification auprès des services Google. |
| expire_dans | Nombre de secondes avant l'expiration du jeton d'accès, généralement 3600 secondes (1 heure). |
| identifiant_du client | L'identifiant du client du compte du service Google. |
Cela suppose qu'un compte de service Google a été créé et configuré pour DHIS2. Veuillez consulter le guide d'installation pour plus d'informations.
La ressource staticContent vous permet de télécharger et d'extraire des logos personnalisés utilisés dans DHIS2. La ressource permet à l'utilisateur de télécharger un fichier avec une clé associée, qui peut ensuite être extraite à l'aide de la clé. Seuls les fichiers PNG sont pris en charge et ne peuvent être téléchargés que vers les clés logo_banner et logo_front.
/api/33/staticContent
Tableau : Clés de contenu statique
| Clé | Description |
|---|---|
| logo_bannière | Logo dans le menu supérieur de l'application sur le côté gauche. |
| logo_façade | Logo sur la page de connexion au-dessus du formulaire de connexion. |
Pour télécharger un fichier, envoyez-le avec une requête POST à :
POST /api/33/staticContent/<key>
Exemple de requête pour télécharger logo.png dans la clé logo_front :
curl -F "file=@logo.png;type=image/png" "https://play.dhis2.org/demo/api/33/staticContent/logo_front"
-X POST -H "Content-Type: multipart/form-data" -u admin:district
Le téléchargement de plusieurs fichiers avec la même clé écrasera le fichier existant. Ainsi, la recherche d'un fichier pour une clé donnée ne renverra que le dernier fichier téléchargé.
Pour récupérer un logo, vous pouvez OBTENIR ce qui suit :
GET /api/33/staticContent/<key>
Exemple de requêtes pour récupérer le fichier stocké pour logo_front :
curl "https://play.dhis2.org/demo/api/33/staticContent/logo_front"
-H "Accept: text/html" -L -u admin:district
curl "https://play.dhis2.org/demo/api/33/staticContent/logo_front"
-H "Accept: application/json" -L -u admin:district
Les messages de succès et d'erreur se présentent comme suit :
{
"images": {
"png": "http://localhost:8080/dhis/api/staticContent/logo_front"
}
}
{
"httpStatus": "Non trouvé",
"httpStatusCode": 404,
"statut": "ERREUR",
"message": "Aucun fichier personnalisé n'a été trouvé."
}
Pour utiliser des logos personnalisés, vous devez activer les paramètres système correspondants en leur attribuant la valeur vrai. Si le paramètre correspondant est faux, le logo par défaut sera utilisé.
Pour parametrer l'interface utilisateur de l'application DHIS2, vous pouvez insérer des styles JavaScript et CSS personnalisés via la ressource files.
POST GET DELETE /api/33/files/script
POST GET DELETE /api/33/files/style
Le contenu JavaScript et CSS inséré par le biais de cette ressource sera chargé par l'application web DHIS2. Cela peut être particulièrement utile dans certaines situations :
Remplacer les styles CSS de l'application DHIS2, tels que la page de connexion ou la page principale.
Définir des fonctions JavaScript communes à plusieurs formulaires de saisie de données personnalisés et à des rapports basés sur HTML.
Y compris les styles CSS utilisés dans les formulaires de saisie de données personnalisés et les rapports basés sur HTML.
L'application Paramètres permet aux utilisateurs de définir une variété d'éléments (texte, logo, drapeau) qui peuvent être utilisés pour paramétrer la page de connexion de DHIS2. En outre, il est possible de choisir entre deux présentations préconfigurées (la présentation par défaut et une présentation avec barre latérale).
Au besoin, le style et la présentation de l'application de connexion peuvent être personnalisés en téléchargeant un modèle HTML (également définissable dans l'application de configuration). Ce modèle HTML remplace certains éléments (basés sur l'ID) ; les ID en réserve sont listés dans le tableau ci-dessous. Il est donc possible de combiner un style personnalisé (à l'aide de css) et une mise en page personnalisée (à l'aide de HTML) pour modifier l'apparence de l'application de connexion. Le modèle personnalisé ne prend pas en charge les scripts personnalisés, et les balises de script seront supprimées de tout modèle téléchargé.
Pour créer un modèle personnalisé, il est recommandé de commencer par l'un des modèles existants (ceux-ci peuvent être téléchargés à partir de l'application de connexion à l'extension dhis-web-login/#download).
| ID | Remplacé par |
|---|---|
| boîte de connexion | La boîte de dialogue principale de connexion, qui invite l'utilisateur à saisir son nom d'utilisateur et son mot de passe. Cette boîte doit être incluse pour que l'application de connexion fonctionne comme prévu. |
| Titre de l'application | Texte pour le titre de l'application. |
| Introduction de l'application | Texte pour l'introduction de l'application. |
| drapeau | Le drapeau sélectionné. |
| logo | Le logo (le logo de DHIS2 est utilisé si le logo personnalisé n'est pas défini). |
| alimenté par | Un lien vers DHIS2.org. |
| application-pieds de page gauche | Texte pour le pied de page gauche. |
| application-pied de page droit | Texte pour le pied de page droite. |
| langue-selectionnée | La sélection permet de contrôler la langue de l'application de connexion. |
L'apparence de la boîte de dialogue de connexion peut également être modifiée en définissant des variables css dans le modèle HTML. Les variables css suivantes sont disponibles pour le paramétrage :
--form-container-margin-block-start
--form-container-margin-block-end
--form-container-margin-inline-start, auto
--form-container-margin-inline-end
--form-container-default-width
--form-container-padding
--form-container-background-color
--form-container-box-border-radius
--form-container-box-shadow
--form-container-font-color
--form-title-font-size
--form-title-font-weight
--form-container-title-color
You can reset the login page theme using the API by making a POST request to /api/41/systemSettings/loginPageLayout including the loginPageLayout DEFAULT or SIDEBAR value in the request body, where content type is set to "text/plain". As an example, you can use curl like this:
curl "play.im.dhis2.org/stable-2-41-0/api/41/systemSettings/loginPageLayout" -d "DEFAULT" -H "Content-Type: text/plain" -u admin:district
Note
Tracker has been re-implemented in DHIS2 2.36. This document describes the new tracker endpoints
POST /api/trackerGET /api/tracker/trackedEntitiesGET /api/tracker/enrollmentsGET /api/tracker/eventsGET /api/tracker/relationshipsThe deprecated tracker endpoints
GET/POST/PUT/DELETE /api/trackedEntityInstanceGET/POST/PUT/DELETE /api/enrollmentsGET/POST/PUT/DELETE /api/eventsGET/POST/PUT/DELETE /api/relationshipshave been removed in version 42!
Migrating to new tracker endpoints should help you get started with your migration. Reach out on the community of practice if you need further assistance.
Le Tracker est constitué de différents types d'objets interconnectés destinés à représenter les données. Dans cette section, nous montrerons et décrirons chacun des objets utilisés dans l'API du Tracker.
Les entités suivies constituent la base du modèle Tracker.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| trackedEntity | L’identifiant de l’entité suivie. Il est généré au cas où il n'est pas fourni | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| TrackedEntityType | Le type d’entité suivie. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| créé à | Date et heure à laquelle l'utilisateur a créé l'entité suivie. Elle est définie sur le serveur. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| crééAtClient (Création au niveau du client) | Date et heure à laquelle l'utilisateur a créé l'entité suivie au niveau du client. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Timestamp when the object or any enrollment, event, attribute or originating relationship, was last updated. Set on the server. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAtClient (mise à jour au niveau du client) | Date et heure de la dernière mise à jour de l'objet au niveau du client. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| orgUnit | L'unité d'organisation dans laquelle l'utilisateur a créé l'entité suivie. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| inactif | Indique si l'entité suivie est inactive ou non. | Non | Oui | Booléen | Par défaut: faux, vrai |
| supprimé | Indique si l'entité suivie a été supprimée. Ne peut être modifié qu'au moment de la suppression. | Non | Non | Booléen | Faux jusqu'à suppression |
| potentialDuplicate | Indique si l'entité suivie est un doublon potentiel | Non | Non | Booléen | Par défaut: faux |
| géométrie | Il s'agit d'une représentation géographique de l'entité suivie. Elle se base sur le « type de fonctionnalité » du type d'entité suivie. | Non | Oui | GeoJson | { "type": "POINT", "coordonnées": [123.0, 123.0] } |
| createdBy (créé par) | Only for reading data. User that created the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| updatedBy (mis à jour par) | Only for reading data. User that last updated the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| attributs | Liste des valeurs d'attributs d'entité suivie appartenant à l'entité suivie. | Non | Oui | Liste des valeurs d'attributs d'entité suivie | Voir les attributs |
| inscriptions | Liste des inscriptions appartenant à l’entité suivie. | Non | Oui | Liste des inscriptions | Voir les inscriptions |
| relations | Liste de relations connectées à l'entité suivie. | Non | Oui | Liste des relations | Voir les relations |
| Propriétaires du programme | A list of organisation units with access through specific programs to this tracked entity. See "Program Ownership". | Non | Oui | Liste des propriétaires du programme | Voir la section « Propriété du programme » |
Remarque
Les
entités suivies"possèdent" toutes lesValeurs d'attribut d'entités suivies(ou les "attributs" décrits dans le tableau précédent). Cependant, lesattributs d'entités suiviessont soit connectés à uneentité suivievia sontype d'entité suiviesoit à unprogramme. Nous désignons souvent cette séparation parAttributs de type d'entité suivietAttributs de programme d'entité suivi. L'importance de cette distinction est liée au contrôle d'accès et à la limitation des informations que l'utilisateur peut voir.Les "attributs" mentionnés dans
Entité suiviesont desAttributs de type d'entité suivie.
Tracked Entities can enroll into TRACKER PROGRAM for which they are eligible. Tracked entities are eligible as long as the program is configured with the same Tracked Entity Type as the tracked entity. We represent the enrollment with the Enrollment object, which we describe in this section.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| enrollment | The identifier of the enrollment. Generated if not supplied. | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| program | The tracker program the enrollment is enrolled into. | Oui | Non | Chaîne : Uid | ABCDEF12345 |
| trackedEntity | Une référence à l’entité suivie inscrite. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| status | Statut de l'inscription. Il est ACTIF au cas où n'est pas fourni. | Non | Non | Énumération | ACTIF, EFFECTUÉ, ANNULÉ |
| orgUnit | L'unité d'organisation dans laquelle l'utilisateur a inscrit l'entité suivie. | Oui | Non | Chaîne : Uid | ABCDEF12345 |
| créé à | Date et heure à laquelle l'utilisateur a créé l'objet. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| crééAtClient (Création au niveau du client) | Timestamp when the user created the object on client. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Date et heure de la dernière mise à jour de l'objet. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAtClient (mise à jour au niveau du client) | Timestamp when the object was last updated on client. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| inscrit à | Date et heure à laquelle l'utilisateur a inscrit l'entité suivie. | Oui | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| occurredAt (s'est produit à) | Date et heure à laquelle l'inscription a eu lieu. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| completedAt (effectué à) | Timestamp when the user completed the enrollment. Set on the server if not set by the client. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| completedBy | Only for reading data. User that completed the enrollment. Set on the server. | Non | Non | Chaîne : Toute | John Doe |
| followUp | Indicates whether the enrollment requires follow-up. False if not supplied. | Non | Non | Booléen | Par défaut : Faux, Vrai |
| supprimé | Indique si l'inscription a été supprimée. Ne peut être modifié qu'au moment de la suppression. | Non | Oui | Booléen | Faux jusqu'à suppression |
| géométrie | A geographical representation of the enrollment. Based on the "featureType" of the program. | Non | Non | GeoJson | { "type": "POINT", "coordonnées": [123.0, 123.0] } |
| createdBy (créé par) | Only for reading data. User that created the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| updatedBy (mis à jour par) | Only for reading data. User that last updated the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| attributs | Liste des valeurs d'attributs d'entité suivie associées à l'inscription. | Non | Non | Liste des valeurs d'attributs d'entité suivie | Voir les attributs |
| events | Liste des événements appartenant à l'inscription. | Non | Non | Liste des événements | Voir les évènements |
| relations | Liste des relations liées à l'inscription. | Non | Non | Liste des relations | Voir les relations |
| notes | Notes liées à l'inscription. Elles ne peuvent qu'être créées. | Non | Oui | Liste des notes | Voir les notes |
| attributeOptionCombo (combinaison d'options d'attribut) | Attribute option combo for the enrollment. If not supplied, the default value defined by the program’s category combo is used. | Non | Non | Chaîne : Uid | ABCDEF12345 |
Remarque
Les
entités suivies"possèdent" toutes lesValeurs d'attribut d'entités suivies(ou les "attributs" décrits dans le tableau précédent). Cependant, lesattributs d'entités suiviessont soit connectés à uneentité suivievia sontype d'entité suiviesoit à unprogramme. Nous désignons souvent cette séparation parAttributs de type d'entité suivietAttributs de programme d'entité suivi. L'importance de cette distinction est liée au contrôle d'accès et à la limitation des informations que l'utilisateur peut voir.Les "attributs" mentionnés dans
Inscriptionsont desAttributs de programmes d'entités suivies.
Les Événements font partie d'un PROGRAMME D'ÉVÉNEMENT ou d'un PROGRAMME TRACKER. Pour le PROGRAMME TRACKER, les événements appartiennent à une Inscription, laquelle appartient à une Entité suivie. D'un autre côté, PROGRAMME D'ÉVÉNEMENT concerne les Événements non rattachées à une Inscription ou à une Entité suivie spécifique. La différence réside dans le fait que nous effectuons ou non un suivi pour une Entité suivie spécifique. Nous désignons parfois les événements PROGRAMME D'ÉVÉNEMENT "événements anonymes "ou "événements uniques" puisqu'ils ne se représentent qu'eux-mêmes et non une autre Entité suivie.
In the API, the significant difference is that events are either not linked to any enrollment (EVENT PROGRAM) or are linked to different enrollments (TRACKER PROGRAM). The table below will point out any exceptional cases between these two.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| event | The identifier of the event. Generated if not supplied. | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| programStage | L'étape du programme que représente l'événement. | Oui | Non | Chaîne : Uid | ABCDEF12345 |
| enrollment | A reference to the enrollment which owns the event. Not applicable for EVENT PROGRAM. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| program | Uniquement pour lire les données. Il s'agit du type de programme de l'inscription qui possède l'événement. | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| trackedEntity | Only for reading data. The tracked entity which owns the event. Not applicable for EVENT PROGRAM. | Non | Non | Chaîne : Uid | ABCDEF12345 |
| status | Status of the event. Default is ACTIVE. For EVENT PROGRAM only ACTIVE and COMPLETED statuses are allowed. | Non | Non | Énumération | ACTIF, EFFECTUÉ, VISITÉ, HORAIRE, EN RETARD, SAUTÉ |
| orgUnit | Il s'agit de l'unité d'organisation dans laquelle l'utilisateur a enregistré l'événement. | Oui | Non | Chaîne : Uid | ABCDEF12345 |
| créé à | Uniquement pour lire des données. Date et heure à laquelle l'utilisateur a créé l'évènement. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| crééAtClient (Création au niveau du client) | Timestamp when the user created the event on client. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Uniquement pour lire des données. Date et heure de la dernière mise à jour de l'évènement. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAtClient (mise à jour au niveau du client) | Timestamp when the event was last updated on client. | Non | Non | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| scheduledAt (programmé à) | Timestamp when the event was scheduled for. Not applicable for EVENT PROGRAM. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| occurredAt (s'est produit à) | Date et heure à laquelle quelque chose se passe. | Oui | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| completedAt (effectué à) | Timestamp when the user completed the event. Set on the server if not set by the client. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| completedBy | Only for reading data. User that completed the event. Set on the server. | Non | Non | Chaîne : Toute | John Doe |
| followUp | Uniquement pour lire les données. Indique si l'événement a été marqué pour un suivi. | Non | Non | Booléen | Faux, Vrai |
| supprimé | Uniquement pour lire les données. Indique si l'évènement a été supprimée. Ne peut être modifié qu'au moment de la suppression. | Non | Oui | Booléen | Faux jusqu'à suppression |
| géométrie | A geographical representation of the event. Based on the "featureType" of the program stage. | Non | Non | GeoJson | { "type": "POINT", "coordonnées": [123.0, 123.0] } |
| createdBy (créé par) | Only for reading data. User that created the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| updatedBy (mis à jour par) | Only for reading data. User that last updated the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| attributeOptionCombo (combinaison d'options d'attribut) | Attribute option combo for the event. If not supplied, the default value defined by the program’s category combo is used. | Non | Non | Chaîne : Uid | ABCDEF12345 |
| attributeCategoryOptions (options de catégorie d'attribut) | Attribute category option for the event. If not supplied, the default value defined by the program’s category combo is used | Non | Non | Chaîne : Uid | ABCDEF12345 |
| assignedUser | Fait référence à un utilisateur qui a été assigné à l'événement. | Non | Non | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| dataValues (Valeurs de données) | Liste des valeurs de données liées à l'événement. | Non | Non | Liste des valeurs d'attributs d'entité suivie | Voir les attributs |
| relations | Liste des relations liées à l'évènement. | Non | Non | Liste des relations | Voir les relations |
| notes | Notes liées à l'évènement. Elles ne peuvent qu'être créées. | Non | Oui | Liste des notes | Voir les notes |
Les Relations sont des objets qui relient deux autres objets Tracker. Les contraintes auxquelles chaque côté de la relation doit se conformer sont basées sur le Type de relation de la Relation.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| relation | L'identifiant de la relation. Il est généré au cas où il n'est pas fourni | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| Type de relation | Il s'agit du type de relation. Il détermine quels objets peuvent être reliés dans une relation. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| Nom de la relation | Only for reading data. The name of the relationship type of this relationship. | Non | Non | Chaîne : Toute | Sibling |
| créé à | Date et heure à laquelle l'utilisateur a créé la relation. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Date et heure de la dernière mise à jour de la relation. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| crééAtClient (Création au niveau du client) | Date et heure à laquelle l'utilisateur a créé la relation au niveau du client. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| bidirectionnel | Uniquement pour lire les données. Indique si le type de relation est bidirectionnel ou non. | Non | Non | Booléen | Vrai ou faux |
| de, à | A reference to each side of the relationship. Must conform to the constraints set in the relationship type. | Oui | Oui | Élément de la relation | {"trackedEntity": {"trackedEntity": "ABCEF12345"}}, {"enrollment": {"enrollment": "ABCDEF12345"}} or {"event": {"event": "ABCDEF12345" }} |
Note
Relationship itemrepresents a link to an object. Since arelationshipcan be between any tracker object liketracked entity,enrollment, andevent, the value depends on therelationship type. For example, if arelationship typeconnects from aneventto atracked entity, the format is strict:{ "from": { "event": { "event": "ABCDEF12345" } }, "to": { "trackedEntity": { "trackedEntity": "FEDCBA12345" } } }
Attributes are the values describing the tracked entities. Attributes can be associated either through a tracked entity type or a program. This implies that attributes can be part of both a tracked entity and an enrollment. Importantly, an attribute can only have one value, even if a tracked entity has multiple enrollments that define that attribute. This is because the tracked entity ultimately owns the attribute value.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| attribute | Fait référence à l’attribut d’entité suivi représenté. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| code | Uniquement pour lire les données. Il s'agit du code de l'attribut de l'entité suivie. | Non | Non | Chaîne : Toute | ABC |
| Nom d'affichage | Uniquement pour lire les données. Il s'agit du nom d'affichage de l'attribut de l'entité suivie. | Non | Non | Chaîne : Toute | Nom |
| créé à | Date et heure à laquelle la valeur a été ajoutée. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Date et heure de la dernière mise à jour de la valeur. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| storedBy | Client reference for who stored/created the value. Set on the server | Non | Oui | Chaîne : Toute | John Doe |
| Type de valeur | Uniquement pour lire les données. Il s'agit du type de valeur que l'attribut représente. | Non | Non | Énumération | TEXTE, ENTIER et plus |
| value | La valeur de l'attribut d'entité suivi. | Non | Non | Chaîne : Toute | John Doe |
Note
When adding or updating an attribute, only the
attributeandvalueproperties are required. To remove an attribute from a tracked entity or enrollment, set thevaluetonullexample.In the context of tracker, we refer to
Tracked Entity AttributesandTracked Entity Attribute Valuessimply as attributes. However, it's important to note that attributes and attribute values are also concepts within metadata. Therefore, distinguishing between tracker attributes and metadata attributes is essential. In the tracker API, you can reference metadata attributes by specifying theidSchemeon import (see request parameters) and event export.
While attributes describe a tracked entity, data values describe an event.
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| dataElement | L'élément de données que cette valeur représente. | Oui | Oui | Chaîne : Uid | ABCDEF12345 |
| value | La valeur de données. | Non | Non | Chaîne : Toute | 123 |
| providedElsewhere | Indique si l'utilisateur a fourni la valeur ailleurs ou non. Faux si la valeur n'a pas été fournie. | Non | Non | Booléen | Faux ou vrai |
| créé à | Date et heure à laquelle l'utilisateur a ajouté la valeur. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| updatedAt (mis à jour à) | Date et heure de la dernière mise à jour de la valeur. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| createdBy (créé par) | Only for reading data. User that created the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| updatedBy (mis à jour par) | Only for reading data. User that last updated the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
Note
When adding or updating a data value, only the
dataElementandvalueproperties are required. To remove a data value from an event, set thevaluetonullsee example.
In situations where additional information or notes about specific issues need to be recorded, these can be captured using notes.
There are two types of notes: enrollment-level notes and event-level notes. An enrollment can consist of one or more events, and notes can be recorded for each event to document reasons such as why an event was missed, rescheduled, or partially completed. Each event within an enrollment can have its own notes. Additionally, overall observations of these events can be recorded using a parent enrollment note. Enrollment notes are useful for documenting reasons such as why an enrollment was canceled. The use of notes is flexible and can be tailored to the user's needs and specific use cases.
Both enrollment and event notes can have an unlimited number of entries; there is no limit to the number of notes that can be added. However, it is not possible to delete or update these notes once they are created. They function like a logbook. To amend a note, a new note can be created. The only way to delete a note is by deleting the parent object, either the event or the enrollment.
Notes do not have a dedicated endpoint; they are exchanged as part of the parent event and/or enrollment payload. A sample payload is found below.
{
"trackedEntity": "oi3PMIGYJH8",
"enrollments": [
{
"enrollment": "EbRsJr8LSSO",
"notes": [
{
"note": "vxmCvYcPdaW",
"value": "Enrollment note 1"
},
{
"value": "Enrollment note 2."
}
],
"events": [
{
"event": "zfzS9WeO0uM",
"notes": [
{
"note": "MAQFb7fAggS",
"value": "Event Note 1."
},
{
"value": "Event Note 2."
}
]
}
]
}
]
}
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| note | La référence de la note. Elle est générée si rien n'est fourni | Non | Oui | Chaîne : Uid | ABCDEF12345 |
| value | Le contenu de la note. | Oui | Oui | Chaîne : Toute | Ceci est une note |
| Stocké à | Date et heure à laquelle l'utilisateur a ajouté la note. Elle est définie sur le serveur. | Non | Oui | Date : ISO 8601 | AAAA-MM-JJThh:mm:ss |
| createdBy (créé par) | Only for reading data. User that created the object. Set on the server. | Non | Oui | Utilisateur | { "uid": "ABCDEF12345", "Nom d'utilisateur": "Nom d'utilisateur", "Prénom": "John", "Nom de famille": "Doe" } |
| Propriété | Description | Obligatoire | Immuable | Type | Exemple |
|---|---|---|---|---|---|
| uid | L'identifiant de l'utilisateur. | Oui* | Oui | Chaîne : Uid | ABCDEF12345 |
| Nom d'utilisateur | Le nom d'utilisateur utilisé par l'utilisateur. | Oui* | Oui | Chaîne : Toute | 123 |
| Prénom | Uniquement pour lire les données. Il s'agit du prénom de l'utilisateur. | Non | Oui | Chaîne : Toute | John |
| Nom de famille | Uniquement pour lire les données. Il s'agit du nom de famille de l'utilisateur. | Non | Oui | Chaîne : Toute | Doe |
Note
Either
uidorusernamemust be provided. If both are provided, only username is considered.
Tracker supports different identifier schemes, referred to as ID schemes. The default ID scheme for import and export is UID.
ID schemes are supported in the following endpoints.
See each section for request parameters.
Only metadata fields directly on the entity are exported using the chosen idScheme. Metadata in collections are always exported using UIDs, except for:
TrackedEntity.attributes[].attributeEvent.dataValues[].dataElementFor example, metadata references in TrackedEntity.relationships or enrollments will always use UIDs for import/export.
The import expects metadata identifiers to only use the chosen idScheme. Similarly, metadata is exported only using the chosen idScheme. If metadata lacks identifiers for the chosen idScheme, you'll receive an error like the below.
{
"httpStatus": "Unprocessable Entity",
"httpStatusCode": 422,
"status": "ERROR",
"message": "Not all metadata has an identifier for the requested idScheme. Either change the requested idScheme or add the missing identifiers to the metadata.",
"devMessage": "Following metadata listed using their UIDs is missing identifiers for the requested idScheme: ProgramStage[ATTRIBUTE:Y1LUDU8sWBR]=A03MvHHogjR .."
}
To resolve this, either:
idScheme parameters to use a scheme with complete information.POST /api/tracker
The endpoint POST /api/tracker is also called the tracker importer. This endpoint allows clients to import i.e. create, update and delete
The tracker importer supports the following parameters:
| Paramètre de requête | Description | Type | Valeurs autorisées | Valeur par défaut |
|---|---|---|---|---|
| async | Indique si l’importation doit avoir lieu de manière asynchrone ou synchrone. | Booléen | true, false | true |
| Mode de rapport | Uniquement lors d'une importation synchrone. Voir le "Récapitulatif de l'importation" pour plus d’informations. | Énumération | COMPLET, ERREURS, AVERTISSEMENTS | ERRORS |
| Mode d'importation | Peut être soit VALIDATE qui rapportera les erreurs dans la charge sans faire de changements dans la base de données, soit COMMIT (par défaut) qui validera la charge et fera des changements dans la base de données. | Énumération | VALIDER, COMMITER | COMMIT |
| idScheme | IdScheme used for all metadata references unless overridden by a metadata specific parameter. Default is UID. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | UID |
| dataElementIdScheme | IdScheme used for data element references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| orgUnitIdScheme | IdScheme used for organisation unit references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| programIdScheme | IdScheme used for program references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| programStageIdScheme | IdScheme used for program stage references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| categoryOptionComboIdScheme | IdScheme used for category option combo references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| categoryOptionIdScheme (Schéma d'identification des options de catégorie) | IdScheme used for category option references. Defaults to the idScheme parameter. | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | idScheme parameter |
| importStrategy (stratégie d'importation) | Indique l'effet que l'importation doit avoir. Les différentes possibilités sont CRÉER, METTRE À JOUR, CRÉER_ET_METTRE À JOUR et SUPPRIMER. Respectivement, elles permettent d'importer de nouvelles données, d'importer des modifications à des données existantes, d'importer de nouvelles données ou des mises à jour à des données existantes et, enfin, de supprimer des données. | Énumération | CRÉER, METTRE À JOUR, CRÉER_ET_METTRE À JOUR et SUPPRIMER | CRÉER |
| Mode atomique | Indique comment l'importation répond aux erreurs de validation. S'il est défini sur TOUS, toutes les données importées doivent être valides avant que chaque donnée ne soit commitée. Par contre s'il est défini sur OBJET, seules les données commitées doivent être valides, tandis que d'autres données peuvent être invalides. | Énumération | TOUS, OBJET | TOUS |
| flushMode (mode de vidage) | Indique la fréquence de vidange. Il s'agit de la fréquence à laquelle les données sont introduites dans la base de données au cours de l'importation. Il est principalement utilisé à des fins de débogage et ne doit pas être modifié dans un environnement de production. | Énumération | AUTO, OBJET | AUTO |
| Mode de validation | Indicates the completeness of the validation step. It can be skipped, set to fail fast (Return on the first error), or full (default), which will return any errors found | Énumération | COMPLET, ÉCHOUER_RAPIDEMENT, SAUTER | COMPLET |
| Validation du modèle de saut | S'il est défini sur 'vrai', la validation du modèle des attributs générés sera sautée. | Booléen | true, false | faux |
| Sauter les effets secondaires | Si défini sur 'vrai', les effets secondaires de l'importation seront ignorés. | Booléen | true, false | faux |
| Sauter les règles | Si défini sur 'vrai', l'exécution des règles de programme pour l'importation sera ignorée. | Booléen | true, false | faux |
The main difference for the user between synchronous and asynchronous imports is the timing of the API response. Synchronous imports provide an immediate import summary once the import is finished. In contrast, asynchronous imports return a reference to the import job right away. The progress of the import job can be tracked using this response.location. An example of an asynchronous import response is found below.
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"message": "Tracker job added",
"response": {
"id": "cHh2OCTJvRw",
"location": "https://play.im.dhis2.org/dev/api/tracker/jobs/cHh2OCTJvRw"
}
}
For large imports, opting for asynchronous import can be advantageous, as it prevents long waiting times for a response.
The importer supports both flat and nested payloads.
The flat payload can include collections for each of the core tracker objects: tracked entities, enrollments, events, and relationships. This format integrates well with existing data that already has UIDs assigned. However, for new data, the client must provide new UIDs for any references between objects. For instance, if you import a new tracked entity with a new enrollment, the client must provide a UID for the tracked entity so that the enrollment can be linked to it.
{
"trackedEntities": [
{
"orgUnit": "y77LiPqLMoq",
"trackedEntity": "Kj6vYde4LHh",
"trackedEntityType": "nEenWmSyUEp"
},
{
"orgUnit": "y77LiPqLMoq",
"trackedEntity": "Gjaiu3ea38E",
"trackedEntityType": "nEenWmSyUEp"
}
],
"enrollments": [
{
"enrolledAt": "2019-08-19T00:00:00.000",
"enrollment": "MNWZ6hnuhSw",
"occurredAt": "2019-08-19T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"status": "ACTIVE",
"trackedEntity": "Kj6vYde4LHh",
"trackedEntityType": "nEenWmSyUEp",
"attributeOptionCombo": "HllvX50cXC0",
}
],
"events": [
{
"attributeCategoryOptions": "xYerKDKCefk",
"attributeOptionCombo": "HllvX50cXC0",
"dataValues": [
{
"dataElement": "bx6fsa0t90x",
"value": "true"
},
{
"dataElement": "UXz7xuGCEhU",
"value": "5.7"
}
],
"enrollment": "MNWZ6hnuhSw",
"enrollmentStatus": "ACTIVE",
"event": "ZwwuwNp6gVd",
"occurredAt": "2019-08-01T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"programStage": "A03MvHHogjR",
"scheduledAt": "2019-08-19T13:59:13.688",
"status": "ACTIVE",
"trackedEntity": "Kj6vYde4LHh"
},
{
"attributeCategoryOptions": "xYerKDKCefk",
"attributeOptionCombo": "HllvX50cXC0",
"enrollment": "MNWZ6hnuhSw",
"enrollmentStatus": "ACTIVE",
"event": "XwwuwNp6gVE",
"occurredAt": "2019-08-01T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"programStage": "ZzYYXq4fJie",
"scheduledAt": "2019-08-19T13:59:13.688",
"status": "ACTIVE",
"trackedEntity": "Kj6vYde4LHh"
}
],
"relationships": [
{
"from": {
"trackedEntity": {
"trackedEntity": "Kj6vYde4LHh"
}
},
"relationshipType": "dDrh5UyCyvQ",
"to": {
"trackedEntity": {
"trackedEntity": "Gjaiu3ea38E"
}
}
}
]
}
Nested payloads are the most commonly used structure, where tracker objects are embedded within their parent objects, such as an enrollment within a tracked entity. The advantage of this structure is that the client does not need to provide UIDs for these references, as this is handled automatically.
Note
Although nested payloads can be easier for clients to manage, the payload will always be flattened before the import. For large imports, using a flat structured payload offers more control and reduces overhead during the import process. However, you cannot nest new tracked entities, enrollments or events within a relationship.
{
"trackedEntities": [
{
"enrollments": [
{
"attributes": [
{
"attribute": "zDhUuAYrxNC",
"displayName": "Last name",
"value": "Kelly"
},
{
"attribute": "w75KJ2mc4zz",
"displayName": "First name",
"value": "John"
}
],
"enrolledAt": "2019-08-19T00:00:00.000",
"events": [
{
"attributeCategoryOptions": "xYerKDKCefk",
"attributeOptionCombo": "HllvX50cXC0",
"dataValues": [
{
"dataElement": "bx6fsa0t90x",
"value": "true"
},
{
"dataElement": "UXz7xuGCEhU",
"value": "5.7"
}
],
"enrollmentStatus": "ACTIVE",
"notes": [
{
"value": "need to follow up"
}
],
"occurredAt": "2019-08-01T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"programStage": "A03MvHHogjR",
"scheduledAt": "2019-08-19T13:59:13.688",
"status": "ACTIVE"
}
],
"occurredAt": "2019-08-19T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"status": "ACTIVE",
"trackedEntityType": "nEenWmSyUEp"
}
],
"orgUnit": "y77LiPqLMoq",
"trackedEntityType": "nEenWmSyUEp"
}
]
}
Make a POST request to /api/tracker with the importStrategy set to CREATE or CREATE_AND_UPDATE and a payload as described here.
Make a POST request to /api/tracker with the importStrategy set to UPDATE or CREATE_AND_UPDATE and a payload as described here.
The payload must include all fields of the object you are updating, even if they have not been modified. The only exception is collections. Items in a collection that should not be changed can be omitted, as demonstrated in update attribute values and update data values.
Note
Deleted tracker objects and relationships cannot be updated.
The following updates one of the attribute values of a tracked entity.
POST /api/tracker?async=false
{
"trackedEntities": [
{
"trackedEntity": "PQfMcpmXeFE",
"trackedEntityType": "nEenWmSyUEp",
"orgUnit": "DiszpKrYNg8",
"attributes": [
{
"attribute": "w75KJ2mc4zz",
"code": "MMD_PER_NAM",
"displayName": "First name",
"createdAt": "2016-08-03T23:49:43.308",
"updatedAt": "2016-08-03T23:49:43.308",
"valueType": "TEXT",
"value": "Johnny"
}
]
}
]
}
Note that it is not necessary to specify the tracked entity's enrollments. However, you must specify the non-collection fields of the tracked entity, even if you are not changing them.
The following deletes one of the attribute values of a tracked entity:
POST /api/tracker?async=false
{
"trackedEntities": [
{
"trackedEntity": "PQfMcpmXeFE",
"trackedEntityType": "nEenWmSyUEp",
"orgUnit": "DiszpKrYNg8",
"attributes": [
{
"attribute": "w75KJ2mc4zz",
"value": null
}
]
}
]
}
The following updates one of the data values of an event:
POST /api/tracker?async=false
{
"events": [
{
"event": "ZwwuwNp6gVd",
"dataValues": [
{
"dataElement": "bx6fsa0t90x",
"value": "true"
}
],
"attributeOptionCombo": "HllvX50cXC0",
"attributeCategoryOptions": "xYerKDKCefk",
"enrollment": "MNWZ6hnuhSw",
"enrollmentStatus": "ACTIVE",
"occurredAt": "2019-08-01T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"programStage": "A03MvHHogjR",
"scheduledAt": "2019-08-19T13:59:13.688",
"status": "ACTIVE",
"trackedEntity": "Kj6vYde4LHh"
}
]
}
The following deletes one of the data values of an event:
POST /api/tracker?async=false
{
"events": [
{
"event": "ZwwuwNp6gVd",
"dataValues": [
{
"dataElement": "bx6fsa0t90x",
"value": null
}
],
"attributeOptionCombo": "HllvX50cXC0",
"attributeCategoryOptions": "xYerKDKCefk",
"enrollment": "MNWZ6hnuhSw",
"enrollmentStatus": "ACTIVE",
"occurredAt": "2019-08-01T00:00:00.000",
"orgUnit": "y77LiPqLMoq",
"program": "IpHINAT79UW",
"programStage": "A03MvHHogjR",
"scheduledAt": "2019-08-19T13:59:13.688",
"status": "ACTIVE",
"trackedEntity": "Kj6vYde4LHh"
}
]
}
Make a POST to /api/tracker with importStrategy set to DELETE. The payload should include only the UIDs of the trackedEntities, enrollments, events or relationships you wish to delete.
The following deletes the events created with this payload:
POST /api/tracker?async=false&importStrategy=DELETE
{
"events": [
{
"event": "ZwwuwNp6gVd",
},
{
"event": "XwwuwNp6gVE",
}
]
}
The following deletes the tracked entities and all its child tracker objects which are enrollments, events and relationships:
POST /api/tracker?async=false&importStrategy=DELETE
{
"trackedEntities": [
{
"trackedEntity": "Kj6vYde4LHh",
},
{
"trackedEntity": "Gjaiu3ea38E",
}
]
}
All the children of a tracker object will be deleted if the user making the request has the authorities F_TEI_CASCADE_DELETE and F_ENROLLMENT_CASCADE_DELETE. Relationships linked to an entity are always deleted, without the need of any authority.
To import events using CSV make a POST request with CSV body file and the Content-Type set to application/csv or text/csv.
Every row of the CSV payload represents an event and a data value. So, for events with multiple data values, the CSV file will have x rows per event, where x is the number of data values in that event.
Votre fichier CSV peut se présenter comme suit :
event,status,program,programStage,enrollment,orgUnit,occurredAt,scheduledAt,geometry,latitude,longitude,followUp,deleted,createdAt,createdAtClient,updatedAt,updatedAtClient,completedBy,completedAt,updatedBy,attributeOptionCombo,attributeCategoryOptions,assignedUser,dataElement,value,providedElsewhere,storedByDataValue,updatedAtDataValue,createdAtDataValue
A7rzcnZTe2T,ACTIVE,eBAyeGv0exc,Zj7UnCAulEk,RiLEKhWHlxZ,DwpbWkiqjMy,2023-02-12T23:00:00Z,2023-02-12T23:00:00Z,"POINT (-11.468912037323042 7.515913998868316)",7.515913998868316,-11.468912037323042,false,false,2017-09-08T19:40:22Z,,2017-09-08T19:40:22Z,,,,,HllvX50cXC0,xYerKDKCefk,,F3ogKBuviRA,"[-11.4880220438585,7.50978830548003]",false,,2016-12-06T17:22:34.438Z,2016-12-06T17:22:34.438Z
Voir Événements CSV dans la section relative à l'exportation pour une définition plus détaillée des champs CSV.
L'API du Tracker dispose de deux endpoints de base qui permettent aux consommateurs d'obtenir des commentaires sur leurs importations. Ces endpoints concernent plus les tâches d'importation asynchrone, mais ils sont également disponibles pour les importations synchrones. Ces endpoints renverront soit le journal de l'importation, soit le récapitulatif de l'importation lui-même.
Remarque
Ces endpoints s'appuient sur des informations stockées dans la mémoire de l'application. Cela signifie que les informations seront indisponibles après certaines situations, telle qu'un redémarrage de l'application ou après un grand nombre de requêtes d'importation qui commencent après celle-ci.
Après avoir soumis une requête d'importation Tracker, nous pouvons accéder aux endpoints suivants afin de surveiller la progression de la tâche en fonction des journaux:
GET /tracker/jobs/{uid}
| Paramètre de requête | Description | Exemple |
|---|---|---|
| uid | The UID of a tracker import job | eAjkbUGBcZ5 |
GET /tracker/jobs/PQK63sMwjQp
[
{
"uid": "PQK63sMwjQp",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:16.370",
"message": "Import complete with status OK, 0 created, 0 updated, 0 deleted, 0 ignored",
"completed": true,
"id": "PQK63sMwjQp"
},
{
"uid": "XIfTJ1UUNcd",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:16.369",
"message": "PostCommit",
"completed": false,
"id": "XIfTJ1UUNcd"
},
{
"uid": "uCG4FNJLLBJ",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:16.364",
"message": "Commit Transaction",
"completed": false,
"id": "uCG4FNJLLBJ"
},
{
"uid": "xfOUv2Lk2MC",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:16.361",
"message": "Running Rule Engine Validation",
"completed": false,
"id": "xfOUv2Lk2MC"
},
{
"uid": "cSPfA776obb",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:16.325",
"message": "Running Rule Engine",
"completed": false,
"id": "cSPfA776obb"
},
{
"uid": "t9gOjotekQt",
"level": "INFO",
"category": "TRACKER_IMPORT_JOB",
"time": "2024-03-19T13:18:15.837",
"message": "Tracker import started",
"completed": false,
"dataType": "PARAMETERS",
"data": {
"userId": "xE7jOejl9FI",
"importMode": "VALIDATE",
"idSchemes": {
"dataElementIdScheme": {
"idScheme": "UID",
"attributeUid": null
},
"orgUnitIdScheme": {
"idScheme": "UID",
"attributeUid": null
},
"programIdScheme": {
"idScheme": "UID",
"attributeUid": null
},
"programStageIdScheme": {
"idScheme": "UID",
"attributeUid": null
},
"idScheme": {
"idScheme": "UID",
"attributeUid": null
},
"categoryOptionComboIdScheme": {
"idScheme": "UID",
"attributeUid": null
},
"categoryOptionIdScheme": {
"idScheme": "UID",
"attributeUid": null
}
},
"importStrategy": "CREATE_AND_UPDATE",
"atomicMode": "ALL",
"flushMode": "AUTO",
"validationMode": "FULL",
"skipPatternValidation": false,
"skipSideEffects": false,
"skipRuleEngine": false,
"filename": null,
"reportMode": "ERRORS"
},
"id": "t9gOjotekQt"
}
]
De plus, le endpoint suivant renverra le récapitulatif de la tâche d’importation. Ce récapitulatif ne sera disponible qu'une fois l'importation terminée:
GET /tracker/jobs/{uid}/report
| Paramètre de requête | Description | Exemple |
|---|---|---|
path /{uid} | ID of an existing tracker import job. | ABCDEF12345 |
| Mode de rapport | Level of detail for the report. | COMPLET, ERREURS, AVERTISSEMENTS |
GET /tracker/jobs/mEfEaFSCKCC/report
La charge de la réponse est la même que celle renvoyée après une requête d'importation synchrone.
Remarque
Les deux endpoints sont principalement utilisés pour l'importation asynchrone. Cependant,
GET /tracker/jobs/{uid}devrait également fonctionner pour les requêtes synchrones car au final il utilise le même processus d'importation et la même journalisation que les requêtes asynchrones.
La structure globale des récapitulatifs d'importation se présente comme suit, en fonction du mode de rapport faisant l'objet de la requête :
{
"status": "OK",
"validationReport": {
"errorReports": [],
"warningReports": []
},
"stats": {
"created": 3,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 3
},
"bundleReport": {
"typeReportMap": {
"EVENT": {
"trackerType": "EVENT",
"stats": {
"created": 1,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 1
},
"objectReports": [
{
"trackerType": "EVENT",
"uid": "gTZBPT3Jq39",
"errorReports": []
}
]
},
"ENROLLMENT": {
"trackerType": "ENROLLMENT",
"stats": {
"created": 1,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 1
},
"objectReports": [
{
"trackerType": "ENROLLMENT",
"uid": "ffcvJvWjiNZ",
"errorReports": []
}
]
},
"RELATIONSHIP": {
"trackerType": "RELATIONSHIP",
"stats": {
"created": 0,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 0
},
"objectReports": []
},
"TRACKED_ENTITY": {
"trackerType": "TRACKED_ENTITY",
"stats": {
"created": 1,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 1
},
"objectReports": [
{
"trackerType": "TRACKED_ENTITY",
"uid": "aVcGf9iO8Xp",
"errorReports": []
}
]
}
}
}
}
La propriété statut du récapitulatif d'importation indique l'état global de l'importation. Si aucune erreur ou avertissement n'est signalé(e) lors de l'importation, le statut est OK. Par contre, si une erreur ou un avertissement est signalé(e) lors de l'importation, le statut devient ERREUR ou AVERTISSEMENT.
Le statut dépend de la présence du Rapport de validation le plus important. ERREUR est le plus important, suivi de AVERTISSEMENT et enfin OK. Cela signifie que le statut est ERREUR si une seule erreur est détectée lors de l'importation, quel que soit le nombre d'avertissements.
Remarque
Si l'importation est faite selon le mode atomique "OBJET", où les données sont importées sans erreurs de validation, le statut sera toujours
ERREURsi des erreurs sont détectées.
Le Rapport de validation peut inclure des Rapports d'erreur et des Rapports d'avertissement si des erreurs ou des avertissements étaient présents lors de l'importation. Lorsqu'ils sont présents, ils fournissent une liste détaillée des erreurs ou avertissements rencontrés.
Prenons l'exemple d'une erreur de validation lors de l'importation d'une ENTIÉE_SUIVIE :
{
"validationReport": {
"errorReports": [
{
"message": "Could not find TrackedEntityType: `Q9GufDoplCL`.",
"errorCode": "E1005",
"trackerType": "TRACKED_ENTITY",
"uid": "Kj6vYde4LHh"
}
],
"warningReports": [
]
}
}
The report contains a message and a code describing the actual error (See the error codes section for more information about errors). Additionally, the report includes the trackerType and uid, which aims to describe where in the data the error was found. In this case, there was a TRACKED_ENTITY with the uid Kj6vYde4LHh, which had a reference to a tracked entity type that was not found.
Remarque
Les
uiddes objets trackers servent de noms à ces objets dans la charge. Par exemple, l'uidd'une entité suivie dans la charge serait "trackedEntity". La même chose s'applique aux inscriptions, aux événements et aux relations qui portent respectivement les noms "enrollment", "event" et "relationship".Si aucun uid n'est fourni dans la charge, le processus d'importation générera de nouveaux uids. Cela signifie que le rapport d'erreur peut faire référence à un uid qui n'existe pas dans votre charge.
Les erreurs signalent des problèmes avec la charge que l'importateur ne peut pas contourner. Toute erreur empêchera l'importation de ces données. Les avertissements, en revanche, sont des problèmes qui peuvent être contournés en toute sécurité, mais dont l'utilisateur doit être informé. Les avertissements ne bloquent pas l'importation des données.
The stats object provides an overview of the import operation. After an import is completed, these will be the actual counts displaying how many objects were created, updated, deleted and ignored.
Exemple de réponse :
{
"stats": {
"created": 2,
"updated": 2,
"deleted": 1,
"ignored": 5,
"total": 10
}
}
The created field refers to how many new objects were created. In general, objects without an existing uid in the payload will be treated as new objects.
The updated field refers to the number of objects updated. If an object has a uid set in the payload, it will be treated as an update as long as that same uid exists in the database.
The deleted field refers to the number of objects deleted during the import. Deletion only happens when the import is configured to delete data and only then when the objects in the payload have existing uids set.
The ignored field refers to objects that were not persisted. Objects can be ignored for several reasons, for example trying to create something that already exists. Ignores should always be safe, so if something was ignored, it was not necessary, or it was due to the configuration of the import.
Une fois l'importation terminée, le bundleReport contient tous les objets tracker importés.
An example for TRACKED_ENTITY:
{
"bundleReport": {
"typeReportMap": {
"TRACKED_ENTITY": {
"trackerType": "TRACKED_ENTITY",
"stats": {
"created": 1,
"updated": 0,
"deleted": 0,
"ignored": 0,
"total": 1
},
"objectReports": [
{
"trackerType": "TRACKED_ENTITY",
"uid": "aVcGf9iO8Xp",
"errorReports": []
}
]
}
}
}
}
Each type of tracker object will be reported, and each has its own stats and objectReports. These objectReports will provide details about each imported object, like their type, their uid, and any error or warning reports if applicable.
Si l'importation se termine brusquement, le message va contenir des informations supplémentaires sur ce qui s'est passé.
A import summary report can be retrieved using a specific reportMode parameter in a GET /tracker/jobs/{uid}/report request. By default the endpoint will return an importSummary with reportMode ERROR.
| Valeur | Description |
|---|---|
| FULL | Renvoie tout à partir de AVERTISSEMENTS, en plus des timingsStats |
| WARNINGS | Renvoie tout à partir de ERREURS, en plus de warningReports (rapports d'avertissements) dans validationReports (rapports de validation) |
| ERRORS (default) | Renvoie uniquement errorReports (rapports d'erreurs) dans validationReports |
De plus, tous les reportModes (modes de rapports) renverront statut, statistiques, bundleReport et message le cas échéant.
There are various error codes for different error scenarios. The following table has the list of error codes thrown from the Tracker API, along with the error messages and some additional descriptions. The placeholders in the error messages ({0},{1},{2}..) are usually uids unless otherwise specified.
| Code d'erreur | Message d'erreur | Description |
|---|---|---|
| E1000 | User: {0}, has no capture scope access to OrganisationUnit: {1}. | |
| E1001 | L'utilisateur : {0} n'a pas d'accès en écriture de données sur le Type d'entité suivie : {1}. | The error occurs when the user is not authorized to create or modify data of the TrackedEntityType {1} |
| E1002 | L'entité suivie {0} existe déjà. | Cette erreur se produit lorsque l'on essaie de créer une nouvelle entité suivie avec un uid déjà existant. Veillez à utiliser un nouvel uid lors de l'ajout d'une nouvelle entité suivie. |
| E1005 | Impossible de trouver le Type d'entité suivie : {0}. | L'erreur se produit lorsque l'on essaie de récupérer un Type d'entité suivie qui n'existe pas avec l'uid {0}. Cela peut également signifier que l'utilisateur n'a pas d'accès en lecture à ce Type d'entité suivie. |
| E1006 | L'attribut : {0} n'existe pas. | L'erreur se produit lorsque le système n'a pas pu trouver un attribut d'entité suivie correspondant avec l'uid {0}. Cela peut également signifier que l'utilisateur n'a pas accès à l'attribut d'entité suivie. |
| E1007 | Erreur de validation du type de valeur d'attribut : {0} ; Erreur : {1}. | Incompatibilité entre le type de valeur d'un attribut d'entité suivie et la valeur d'attribut qui lui est fournie. L'erreur de validation réelle sera affichée dans {1}. |
| E1008 | L'étape de programme {0} n'a pas de référence à un programme. Vérifiez la configuration de l'étape du programme | |
| E1009 | La ressource de fichier : {0} a déjà été attribuée à un autre objet. | L'uid de ressource de fichier {0} est déjà attribué à un autre objet du système. |
| E1010 | Impossible de trouver le programme : {0} lié à l'événement. | Le système n'a pas pu trouver un programme avec l'uid {0} spécifié dans la charge utile de l'événement. Cela peut également signifier que l'utilisateur connecté n'a pas accès à ce programme. |
| E1011 | Impossible de trouver l'unité d'organisation : {0} lié à l'événement. | Le système n'a pas pu trouver une unité d'organisation avec l'uid {0} spécifié dans la charge utile de l'événement. |
| E1012 | La géométrie n'est pas conforme au FeatureType (type de fonctionnalité) : {0}. | Le type de fonctionnalité fourni est soit NONE (aucun), soit incompatible avec la valeur géométrique fournie. |
| E1013 | Impossible de trouver le ProgramStage (étape de programme) : {0} lié à l'événement. | Le système n'a pas pu trouver une étape de programme avec l'uid {0} spécifié dans la charge utile de l'événement. Cela peut également signifier que l'utilisateur connecté n'a pas accès à l'étape de programme. |
| E1014 | Un programme identifié {0} est un programme sans enregistrement. Aucune inscription ne peut être créée dans un programme sans enregistrement. | Les inscriptions ne peuvent être créées que pour les programmes avec des enregistrements. |
| E1015 | L'entité suivie : {0} a déjà une inscription active dans le programme {1}. | Il est impossible de s'inscrire à un programme si une autre inscription active existe déjà pour le programme. L’inscription active devra au moins être terminée au préalable. |
| E1016 | L'entité suivie : {0} a déjà une inscription active dans le programme: {1}, et ce programme n'autorise qu'une seule inscription . | Conformément à la configuration du programme {1}, une entité suivie ne peut être inscrite qu'une seule fois à ce programme. Il semble que l'entité suivie {0} ait déjà une inscription ACTIVE ou TERMINÉE dans ce programme. Une autre inscription ne peut donc pas être ajoutée. |
| E1018 | L'attribut : {0} est obligatoire dans le programme {1} mais il n'est pas déclaré dans l'inscription {2}. | La valeur de l'attribut est manquante dans la charge utile, pour un attribut défini comme obligatoire pour un programme. Assurez-vous que les valeurs des attributs obligatoires sont fournies dans la charge utile. |
| E1019 | Only Program attributes are allowed for enrollment; invalid attribute: {0}. | L'uid d'attribut {0} spécifié dans la charge utile d'inscription n'est pas associé au programme. |
| E1020 | Enrollment date: {0}, cannot be a future date. | Il est impossible de créer une inscription à une date ultérieure à moins que le Programme ne le permette dans sa configuration. |
| E1021 | Incident date: {0}, cannot be a future date. | La date d'incidence ne peut pas être une date ultérieure à moins que le Programme ne le permette dans sa configuration. |
| E1022 | L'entité suivie {0} doit avoir le même type d'entité suivie que le programme {1}. | Le programme est configuré pour accepter un UID de type d'entité suivie différent de celui fourni dans la charge utile d’inscription. |
| E1023 | DisplayIncidentDate is true but property occurredAt is null. | Program is configured with DisplayIncidentDate but it is null in the payload. |
| E1025 | Property enrolledAt is null. | EnrolledAt Date is mandatory for an Enrollment. Make sure it is not null. |
| E1029 | L'unité d'organisation Évènement identifiée {0} et le Programme {1} ne correspondent pas. | La charge utile de l'événement utilise un programme {1} qui n'est pas configuré pour être accessible par l'unité d'organisation {0}. |
| E1030 | L'Événement {0} existe déjà. | Cette erreur se produit lorsque l'on essaie d'ajouter un nouvel événement avec un uid déjà existant. Veillez à utiliser un nouvel uid lors de l'ajout d'un nouvel événement. |
| E1031 | Event occurredAt date is missing. | OccurredAt property is either null or has an invalid date format in the payload. |
| E1032 | Event: {0} does not exist. | |
| E1033 | La valeur d'inscription de l'Événement {0} est NULLE. | |
| E1039 | L'Étape de programme {0} n'est pas répétable et un événement existe déjà. | Un événement existe déjà pour l'étape de programme de l’inscription. Étant donné que l'étape de programme est configuré pour être non répétable, un autre événement ne peut pas être ajouté pour la même étape de programme. |
| E1041 | L'unité d'organisation Inscription {0} et le Programme {1} ne correspondent pas. | La charge utile de l'inscription contient un programme {1} qui n'est pas configuré pour être accessible par l'unité d'organisation {0}. |
| E1043 | La date de fin de l'événement : {0}, a expiré ; il n'est donc plus possible d'apporter des modifications à cet événement. | Un utilisateur qui ne dispose pas de l'autorité 'F_EDIT_EXPIRED' ne peut pas mettre à jour un événement dont les jours d'expiration, tels que configurés dans son programme, sont dépassés. |
| E1046 | L'Événement : {0}, doit avoir au moins une date (d'événement ou de programmation). | Either of occurredAt or scheduledAt property should be present in the Event payload. |
| E1047 | La date de l'événement : {0}, appartient à une période expirée. Un tel événement ne peut être créé. | Event occurredAt or scheduledAt has a value that is earlier than the PeriodType start date. |
| E1049 | Impossible de trouver l'unité d'organisation : {0} lié à l'entité suivie. | Le système n'a pas trouvé une Unité d'Organisation avec l'uid {0}. |
| E1050 | La date à laquelle l'événement est programmé (ScheduledAt) est manquante. | La propriété "ScheduledAt" dans la charge utile de l'événement est soit manquante, soit son format de date est invalide. |
| E1051 | Event: {0}, completedAt must be null when status is {1}. | Event completedAt can only be passed in the payload if status is COMPLETED |
| E1052 | Enrollment: {0}, completedAt must be null when status is {1}. | Enrollment completedAt can only be passed in the payload if status is COMPLETED |
| E1054 | La combinaison d'options d'attributs {0} n'est pas dans la combinaison de catégories de programmes d'événements {1}. | |
| E1055 | La combinaison d'options d'attribut (AttributeOptionCombo) par défaut n'est pas autorisée car le programme ne dispose pas d'une combinaison de catégories (CategoryCombo) par défaut. | Le programme est configuré pour contenir une combinaison de catégories différente de celle par défaut, mais la requête utilise la combinaison d'options d'attribut par défaut. |
| E1056 | La date d'événement : {0}, est antérieure à la date de début : {1}, pour l'option d'attribut (AttributeOption) : {2}. | L'option de catégorie a une date de début configurée ; la date de l'événement dans la charge utile ne peut pas être antérieure à cette date de début. |
| E1057 | La date d'événement : {0}, est postérieure à la date de fin : {1}, pour l'option d'attribut (AttributeOption) : {2}. | L'option de catégorie a une date de fin configurée ; la date de l'événement dans la charge utile ne peut pas être postérieure à cette date de fin. |
| E1063 | L'entité suivie {0} n'existe pas. | L'erreur se produit lorsque l'on essaie de récupérer une Entité suivie qui n'existe pas avec l'uid {0}. Cela peut également signifier que l'utilisateur n'a pas d'accès en lecture à cette Entité suivie. |
| E1064 | Valeur d'attribut non unique {0} pour l'attribut {1} | La valeur de l'attribut doit être unique dans le champ d'application défini. L'erreur indique que la valeur de l'attribut existe déjà pour une autre Entité suivie. |
| E1068 | Impossible de trouver l'entité suivie : {0}, lié à l'inscription. | Le système n'a pas pu trouver l'entité suivie spécifiée dans la charge utile d'inscription. Cela peut également signifier que l'utilisateur n'a pas d'accès en lecture à cette entité suivie. |
| E1069 | Impossible de trouver le programme : {0} lié à l'inscription. | Le système n'a pas pu trouver le programme spécifié dans la charge utile d'inscription. Cela peut également signifier que l'utilisateur n'a pas d'accès en lecture à ce programme. |
| E1070 | Impossible de trouver l'unité d'organisation : {0} lié à l'inscription. | Le système n'a pas pu trouver l'unité d'organisation spécifiée dans la charge utile d'inscription. |
| E1074 | FeatureType (Type de fonctionnalité) est manquant. | |
| E1075 | L'attribut : {0}, n'a pas d'uid. | |
| E1076 | {0} {1} est obligatoire et ne peut pas être nul | |
| E1077 | La valeur du texte de l'attribut : {0}, dépasse la longueur maximale autorisée : {0}. | |
| E1079 | Événement : {0}, le programme : {1} est différent du programme défini dans l'inscription {2}. | |
| E1080 | L'Inscription {0} existe déjà. | This error is thrown when trying to create a new Enrollment with an already existing uid. Make sure a new uid is used when adding a new Enrollment. |
| E1081 | L'Inscription {0} n'existe pas. | L'erreur se produit lorsque l'on essaie de récupérer une Inscription qui n'existe pas avec l'uid {0}. Cela peut également signifier que l'utilisateur n'a pas d'accès en lecture à cette Inscription. |
| E1082 | L'Événement : {0}, est déjà supprimé et ne peut donc plus être modifié. | Si l’événement est supprimé de façon réversible (soft delete), aucune modification n’est autorisée sur cet événement. |
| E1083 | L'Utilisateur : {0}, n'est pas autorisé à modifier les événements terminés. | Seul un super utilisateur ou un utilisateur disposant de l'autorité "F_UNCOMPLETE_EVENT" peut modifier les événements terminés. Les événements terminés sont les événements dont le statut est "TERMINÉ". |
| E1089 | L'Événement : {0}, fait référence à une Étape de programme {1} qui n'appartient pas au Programme {2}. | L’uid de l'Étape de programme et l’uid de Programme présent dans la charge utile de l’Événement sont incompatibles. |
| E1090 | L'attribut : {0} est obligatoire dans le type d'entité suivie {1} mais il n'est pas déclaré dans l'entité suivie {2}. | Des valeurs manquent dans la charge utile pour les attributs de type d'entité suivie obligatoires. |
| E1091 | L'utilisateur : {0} n'a pas d'accès en écriture de données sur le Programme : {1}. | La configuration du partage du Programme est telle que l'utilisateur n'a pas d'accès en écriture pour ce programme. |
| E1095 | L'utilisateur : {0} n'a pas d'accès en écriture de données sur l'Étape de programme : {1}. | La configuration du partage de l'Étape de programme est telle que l'utilisateur n'a pas d'accès en écriture pour cette Étape de programme. |
| E1096 | L'utilisateur : {0} n'a pas d'accès en lecture de données sur le Programme : {1}. | La configuration du partage du Programme est telle que l'utilisateur n'a pas d'accès en lecture pour ce programme. |
| E1097 | User: {0}, has no data read access to ProgramStage: {1}. | The ProgramStage sharing configuration is such that, the user does not have read access for this ProgramStage. |
| E1098 | User: {0}, has no read access to CategoryOption: {1}. | The CategoryOption sharing configuration is such that, the user does not have read access for this CategoryOption. |
| E1099 | L'utilisateur : {0} n'a pas d'accès en écriture sur l'Option de catégorie : {1}. | La configuration du partage de l'Option de catégorie est telle que l'utilisateur n'a pas d'accès en écriture pour cette Option de catégorie. |
| E1100 | L'Utilisateur: {0}, ne dispose pas de l'autorité 'F_TEI_CASCADE_DELETE' pour supprimer l'entité suivie : {1}. | Certaines Inscriptions n'ont pas été supprimées pour cette Entité suivie. Si l'utilisateur ne dispose pas de l'autorité "F_TEI_CASCADE_DELETE", ces inscriptions devront d'abord être supprimées explicitement avant qu'il puisse supprimer l'Entité suivie. |
| E1102 | L'Utilisateur : {0}, n'a pas accès à la combinaison de l'Entité suivie : {1} et du Programme : {2}. | Cette erreur se produit lorsque l'unité d'organisation de l'utilisateur ne possède pas cette entité suivie, pour ce programme spécifique. L'unité d'organisation propriétaire de la combinaison Entité Suivie-Programme (TrackedEntity-Program) doit se trouver dans le champ de saisie (dans certains cas, dans le champ de recherche) de l'utilisateur. |
| E1103 | L'Utilisateur : {0}, ne dispose pas de l'autorité 'F_ENROLLMENT_CASCADE_DELETE' pour supprimer l'Inscription : {1}. | Certains Événements n'ont pas été supprimées pour cette Inscription. Si l'utilisateur ne dispose pas de l'autorité 'F_ENROLLMENT_CASCADE_DELETE', ces Événements devront d'abord être supprimées explicitement avant qu'il puisse supprimer l'Inscription. |
| E1104 | L'utilisateur : {0} n'a pas d'accès en lecture de données sur le programme : {1} et le type d'entité suivie : {2}. | La configuration du partage du Type d'entité suivie associé au Programme est telle que l'utilisateur n'a pas d'accès en lecture de données pour ce type d'entité suivie. |
| E1105 | User: {0}, has no search scope access to OrganisationUnit: {1}. | |
| E1113 | L'Inscription : {0}, est déjà supprimée et ne peut donc plus être modifiée. | Si l'inscription est supprimée de façon réversible, aucune modification n’est autorisée sur cette inscription. |
| E1114 | L'Entité suivie : {0}, est déjà supprimée et ne peut donc plus être modifiée. | Si l'entité suivie est supprimée de façon réversible, aucune modification n’est autorisée sur cette entité suivie. |
| E1115 | Impossible de trouver la Combinaison d'options de catégorie : {0}. | |
| E1116 | Impossible de trouver la l'Option de catégorie : {0}. | Cela peut également signifier que l'utilisateur n'a pas accès à cette option de catégorie. |
| E1117 | La Combinaison d'options de catégorie n'existe pas pour la combinaison de catégories et les options de catégorie fournies : {0}. | |
| E1118 | L'utilisateur assigné {0} n'est pas un uid valide. | |
| E1119 | A Note with uid {0} already exists. | |
| E1120 | L'Étape de programme {0} n'autorise pas l'assignation d'utilisateurs | La charge utile d'événement a attribué un identifiant d'utilisateur (uid) mais l'étape de programme n’est pas configurée pour autoriser l'assignation d’utilisateurs. |
| E1121 | La propriété d'entité suivie requise est manquante : {0}. | |
| E1122 | La propriété d'inscription requise est manquante : {0}. | |
| E1123 | La propriété d'événement requise est manquante : {0}. | |
| E1124 | La propriété de relation requise est manquante : {0}. | |
| E1125 | La valeur {0} n'est pas un code d'option valide dans l'ensemble d'options {1} | |
| E1126 | Not allowed to update Tracked Entity property: {0}. | |
| E1127 | Not allowed to update Enrollment property: {0}. | |
| E1128 | Not allowed to update Event property: {0}. | |
| E1129 | CategoryOptionCombo not found for CategoryCombo {0}. | |
| E1130 | AttributeOptionCombo {0} is not in the program enrollment CategoryCombo {1}. | |
| E1131 | User: {0} has no data read access to TrackedEntityType: {1}. | |
| E1300 | Généré par la règle de programme ({0}) - {1} | |
| E1301 | Généré par la règle de programme ({0}) - L'élément de données obligatoire {1} n'est pas présent | |
| E1302 | DataElement {0} is not valid: {1} | |
| E1303 | Mandatory DataElement {0} is not present | |
| E1304 | DataElement {0} is not a valid data element | |
| E1305 | DataElement {0} is not part of {1} program stage | |
| E1306 | Généré par la règle de programme ({0}) - L'attribut obligatoire {1} n'est pas présent | |
| E1307 | Généré par la règle de programme ({0}) - Impossible d'attribuer une valeur à l'élément de données {1}. La valeur fournie doit être vide ou correspondre à la valeur calculée {2} | |
| E1308 | Généré par la règle de programme ({0}) - L'élément de données {1} est remplacé dans l'événement {2} | |
| E1309 | Généré par la règle de programme ({0}) - Impossible d'attribuer une valeur à l'attribut {1}. La valeur fournie doit être vide ou correspondre à la valeur calculée {2} | |
| E1310 | Generated by program rule ({0}) - Attribute {1} is being replaced in te {2} | |
| E1313 | Event {0} of an enrollment does not reference a TrackedEntity. The data in your system might be corrupted | Il s'agit d'une anomalie dans les données existantes, où les inscriptions peuvent ne pas faire référence à une entité suivie. |
| E1314 | Generated by program rule ({0}) - DataElement {1} is mandatory and cannot be deleted. | |
| E1315 | Status {0} does not allow defining data values. Statuses that do allow defining data values are: {1} | |
| E1316 | No event can transition from status {0} to status {1}. | |
| E1317 | Generated by program rule ({0}) - Attribute {1} is mandatory and cannot be deleted. | |
| E1318 | Status {0} is not applicable for single events. | The status used in the Event payload is not valid for a single event. |
| E1320 | Generated by program rule ({0}) - Event ({1}) was automatically scheduled at {2}. | |
| E1321 | Generated by program rule ({0}) - User ({1}) does not have write access to ProgramStage {2}, where an event was auto-scheduled using SCHEDULEEVENT rule action. | |
| E1322 | Generated by program rule ({0}) - Event for programStage ({1}) and enrollment ({2}) already exists. | |
| E1323 | User: {0} has no write access to any program. | |
| E1324 | User {0} has no ownership access to any program for the provided TrackedEntity: {1}. | |
| E1325 | User: {0} has no read access to any program. | |
| E4000 | La relation : {0} ne peut pas être reliée à elle-même | |
| E4001 | Relationship Item {0} for Relationship {1} is invalid: an Item can link only one Tracker entity, Enrollment or Event. | |
| E4006 | Impossible de trouver le Type de relation : {0}. | |
| E4010 | La contrainte du type de relation {0} nécessite un {1} mais un {2} a été trouvé . | |
| E4012 | Impossible de trouver {0} : {1}, liés à la relation. | |
| E4014 | La contrainte du type de relation {0} nécessite une entité suivie de type {1} mais c'est un type {2} qui a été trouvé. | |
| E4015 | La relation {0} existe déjà. | |
| E4016 | Relationship: {0}, does not exist. | |
| E4017 | La relation: {0}, est déjà supprimé et ne peut donc plus être modifié. | |
| E4018 | La relation : {0}, liant {1} : {2} à {3} : {4} existe déjà. | |
| E4019 | User: {0} has no data read access to RelationshipType: {1}. | |
| E4020 | User: {0} has no data write access to RelationshipType: {1}. | |
| E5000 | "{0}" {1} ne peut pas être maintenu car "{2}" {3} référencé par lui ne peut pas être maintenu. | L'importateur ne peut pas maintenir un objet tracker car une référence ne peut pas être maintenue. |
| E9999 | N/A | Message d'erreur non défini. |
Lors de l'importation de données à l'aide de l'importateur du Tracker, une série de validations est effectuée pour garantir la validité des données. Cette section décrit certains types de validation effectués afin que vous puissiez mieux comprendre un échec de validation lors de votre importation.
Each of the tracker objects has a few required properties that need to be present when importing data. For an exhaustive list of required properties, have a look at the tracker objects section.
Lors de la validation des propriétés requises, nous parlons généralement de références à d'autres données ou métadonnées. Dans ces cas, on note trois critères principaux :
Si la première condition n'est pas remplie, l'importation échouera et un message indiquant une référence manquante sera généré. Cependant, si la référence indique un objet qui n'existe pas ou auquel l'utilisateur n'a pas accès, le message généré indiquera que la référence n'a pas été trouvée.
Certaines propriétés des objets Tracker requièrent un format spécifique. Lors de l'importation des données, chacune de ces propriétés est validée au regard du format attendu et renvoie des erreurs en fonction de la propriété dont le format est incorrect. Voici quelques exemples de propriétés validées de cette manière :
All data imported will be validated based on the metadata (sharing) and the organisation units (scopes) referenced in the data. You can find more information about sharing and organisation unit scopes in the following sections.
Sharing is validated at the same time as references are looked up in the database. Metadata outside of the user access scope will be treated as if it does not exist. The import will validate any metadata referenced in the data.
Organisation units, on the other hand, serve a dual purpose. It will primarily make sure that data can only be imported when imported for an organisation unit the user has within their capture scope. Secondly, organisation units are also used to restrict what programs are available. That means if you are trying to import data for an organisation unit that does not have access to the Program you are importing, the import will be invalid.
Les utilisateurs disposant de l'autorité TOUS ne sont pas affectés par les limites des champs d'application de partage et d'unité d'organisation lorsqu'ils importent des données. Cependant, ils ne peuvent pas importer d'inscriptions dans des unités d'organisation qui n'ont pas accès au programme d'inscription.
Les attributs et les valeurs de données font partie respectivement d'une entité suivie et d'un événement. Cependant, les attributs peuvent être liés à une entité suivie soit par son type (TrackedEntityType), soit par son programme (Program). Les attributs peuvent également être uniques.
La première validation effectuée lors de l'importation consiste à s'assurer que la valeur fournie pour un attribut ou un élément de données est conforme au type de valeur attendu. Par exemple, supposons que vous importiez une valeur pour un élément de données de type numérique. Dans ce cas, la valeur doit être numérique. Toute erreur liée à une non-concordance entre un type et une valeur se traduira par le même code d'erreur, mais avec un message spécifique lié au type de violation.
Mandatory attributes and data values are also checked on creation, on update mandatory attributes and data values are not required in the payload. Currently, removing mandatory attributes and data values is never allowed. Some use-cases require values to be sent separately, while others require all values to be sent as one. Programs can be configured to either validate mandatory attributes ON_COMPLETE or ON_UPDATE_AND_INSERT to accommodate these use-cases.
The import will validate unique attributes at the time of import. That means as long as the provided value is unique for the attribute in the whole system, it will pass. However, if the unique value is found to be used by any other tracked entity other than the one being imported, it will fail.
Les dernières validations dans l'importateur sont des validations basées sur la configuration des métadonnées pertinentes par l'utilisateur. Pour plus d'informations sur chaque configuration, consultez les sections correspondantes. Trouvez ci-après quelques exemples de validations configurables :
Ces configurations apporteront des modifications supplémentaires à la manière dont la validation est effectuée lors de l'importation.
Tracked entity attributes that use automatic generation of unique values have three endpoints utilized by apps for generating and reserving these values.
A TextPattern may include variables that change based on different factors. Some of these factors are unknown to the server; thus, the values for these variables must be supplied when generating and reserving values.
This endpoint returns a map of required and optional values that the server will inject into the TextPattern when generating new values. Required variables must be supplied for generation, whereas optional variables should only be provided if necessary.
GET /api/trackedEntityAttributes/Gs1ICEQTPlG/requiredValues
{
"REQUIRED": [
"ORG_UNIT_CODE"
],
"OPTIONAL": [
"RANDOM"
]
}
Online web apps and other clients can use this endpoint to generate a unique value for immediate use. The generated value is guaranteed to be unique at the time of generation and is reserved for 3 days. If your TextPattern includes required values, they can be passed as parameters.
To override the expiration time, add ?expiration=<number-of-days> to the request.
GET /api/trackedEntityAttributes/Gs1ICEQTPlG/generate?ORG_UNIT_CODE=OSLO
{
"ownerObject": "TRACKEDENTITYATTRIBUTE",
"ownerUid": "Gs1ICEQTPlG",
"key": "RANDOM(X)-OSL",
"value": "C-OSL",
"created": "2018-03-02T12:01:36.680",
"expiryDate": "2018-03-05T12:01:36.678"
}
Offline clients can use this endpoint to reserve a number of unique IDs for later use when registering new tracked entities. The number of IDs to generate can be specified with the numberToReserve parameter (default is 1).
To override the default expiration time of 60 days, add ?expiration=<number-of-days> to the request.
GET /api/trackedEntityAttributes/Gs1ICEQTPlG/generateAndReserve?numberToReserve=3&ORG_UNIT_CODE=OSLO
[
{
"ownerObject": "TRACKEDENTITYATTRIBUTE",
"ownerUid": "Gs1ICEQTPlG",
"key": "RANDOM(X)-OSL",
"value": "B-OSL",
"created": "2018-03-02T13:22:35.175",
"expiryDate": "2018-05-01T13:22:35.174"
},
{
"ownerObject": "TRACKEDENTITYATTRIBUTE",
"ownerUid": "Gs1ICEQTPlG",
"key": "RANDOM(X)-OSL",
"value": "Q-OSL",
"created": "2018-03-02T13:22:35.175",
"expiryDate": "2018-05-01T13:22:35.174"
},
{
"ownerObject": "TRACKEDENTITYATTRIBUTE",
"ownerUid": "Gs1ICEQTPlG",
"key": "RANDOM(X)-OSL",
"value": "S-OSL",
"created": "2018-03-02T13:22:35.175",
"expiryDate": "2018-05-01T13:22:35.174"
}
]
Les valeurs réservées ne sont actuellement pas accessibles via l'API, mais elles sont renvoyées par les points d'extrémité generate (génération) et generate And Reserve (génération et réservation). Le tableau suivant explique les propriétés de l'objet de valeur réservée :
Tableau : Valeurs réservées
| Propriété | Description |
|---|---|
| ownerObject | Le type de métadonnées référencé lors de la génération et de la réservation de la valeur. Actuellement, seul TRACKEDENTITYATTRIBUTE (attribut d'entité suivie) est pris en charge. |
| ownerUid | L'uid de l'objet de métadonnées référencé lors de la génération et de la réservation de la valeur. |
| key | Une valeur partiellement générée où les segments générés ne sont pas encore ajoutés. |
| value | La valeur réservée. C'est la valeur que vous envoyez au serveur lorsque vous stockez des données. |
| created | Date et heure à laquelle la réservation a été effectuée |
| expiryDate | Date et heure à partir de laquelle la réservation ne sera plus valable. |
Les réservations expirées sont supprimées quotidiennement. Si un modèle change, les valeurs déjà réservées seront acceptées lors du stockage des données, même si elles ne correspondent pas au nouveau modèle, tant que la réservation n'a pas expiré.
Users can configure program rules, which adds conditional behavior to tracker forms. In addition to running these rules in the tracker apps, the tracker importer will also run a selection of these rules. Since the importer is also running these rules, we can ensure an additional level of validation.
Toutes les actions de règles de programme ne sont pas prises en charge, car elles ne sont adaptées qu'à une présentation de type « frontend ». Une liste complète des actions de règles de programme prises en charge est présentée ci-dessous.
| Action de la règle du programme | Pris en charge |
|---|---|
| DISPLAYTEXT | |
| DISPLAYKEYVALUEPAIR | |
| HIDEFIELD | |
| HIDESECTION | |
| ASSIGN | X |
| SHOWWARNING | X |
| SHOWERROR | X |
| WARNINGONCOMPLETION | X |
| ERRORONCOMPLETION | X |
| CREATEEVENT | |
| SETMANDATORYFIELD | X |
| SENDMESSAGE | X |
| SCHEDULEMESSAGE | X |
Program rules are evaluated in the importer in the same way they are evaluated in the tracker apps. To summarize, the following conditions are considered when enforcing the program rules:
Les résultats des règles de programme dépendent des actions définies dans ces règles :
SHOWWARNING and WARNINGONCOMPLETION actions can generate only warnings.SHOWERROR, ERRORONCOMPLETION, and SETMANDATORYFIELD actions can generate only errors.ASSIGN action can generate both Warnings and Errors.RULE_ENGINE_ASSIGN_OVERWRITE system setting is true.Les règles de programme peuvent également entraîner des effets secondaires, telles que l'envoi et la planification de messages. Pour plus d’informations sur les actions non voulues, veuillez consulter la section suivante.
Note
Program rules can be skipped during import using the
skipProgramRulesparameter.
Une fois qu'une importation est terminée, des tâches spécifiques peuvent être déclenchées du fait de cette importation. Ces tâches sont ce que nous appelons des « effets secondaires ». Ces tâches exécutent des opérations qui n'affectent pas l'importation elle-même.
Les effets secondaires sont des tâches qui s'exécutent séparément de l'importation, mais qui sont toujours déclenchées par une importation. Étant donné que les effets secondaires sont dissociés de l'importation, ils peuvent échouer même si l'importation réussit. De plus, les effets secondaires ne sont exécutés que lorsque l'importation réussit ; ils ne peuvent donc pas échouer dans l'autre sens.
Voici donc les effets secondaires actuellement pris en charge :
| Effets secondaires | Pris en charge | Description |
|---|---|---|
| Tracker Notification | X | Updates can trigger notifications. Updates which trigger notifications are enrollment, event update, event or enrollment completion. |
| ProgramRule Notification | X | Les règles de programme peuvent déclencher des notifications. Notez que ces notifications font partie des effets des règles de programme qui sont générés via le moteur de règles de DHIS2. |
Note
Certain configurations can control the execution of side effects.
skipSideEffectsflag can be set during the import to skip side effects entirely. This parameter can be useful if you import something you don't want to trigger notifications for, as an example.
Certains processus bénéficient du fait que des événements soient traités comme des tâches, et pour cette raison, vous pouvez assigner un utilisateur à un événement.
L'assignation d'un utilisateur à un événement ne modifie pas l'accès ou les autorisations des utilisateurs, mais crée un lien entre l'événement et l'utilisateur. Lorsqu'un utilisateur est assigné à un événement, vous pouvez lancer des requêtes sur les événements à partir de l'API en utilisant le champ assignedUser (utilisateur attribué) en tant que paramètre.
Lorsque vous voulez assigner un utilisateur à un événement, fournissez simplement l'UID de cet utilisateur dans le champ assignedUser. Voir l'exemple suivant:
{
"events": [
{
"event": "ZwwuwNp6gVd",
"programStage": "nlXNK4b7LVr",
"orgUnit": "O6uvpzGd5pu",
"enrollment": "MNWZ6hnuhSw",
"assignedUser" : "M0fCOxtkURr"
}
]
}
In this example, the user with uid M0fCOxtkURr will be assigned to the event with uid ZwwuwNp6gVd. Only one user can be assigned to a single event.
Pour utiliser cette fonctionnalité, l'assignation d'utilisateurs doit être activée pour l'étape de programme concernée et l'uid fourni pour l'utilisateur doit renvoyer à un utilisateur existant et valide.
Les points d'extrémité de l'exportation Tracker vous permettent de récupérer les objets précédemment importés, à savoir :
Note
- All tracker export endpoints default to a
JSONresponse content.CSVis only supported by tracked entities and events.- You can export a CSV file by adding the
Acceptheader text/csv or application/csv to the request.- You can download in zip and gzip formats:
- CSV for Tracked entities
- JSON and CSV for Events
- You can export a Gzip file by adding the
Acceptheader application/csv+gzip for CSV or application/json+gzip for JSON.- You can export a Zip file by adding the
Acceptheader application/csv+zip for CSV or application/json+zip for JSON.
The following endpoints support standard pagination parameters.
GET /api/tracker/trackedEntitiesGET /api/tracker/eventsGET /api/tracker/enrollmentsGET /api/tracker/relationships| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| page | Entier | Tout entier positif | Numéro de page à renvoyer. La valeur par défaut est 1 . |
| pageSize | Entier | Tout entier positif | Taille de la page. La valeur par défaut est 50. |
| totalPages | Booléen | true, false | Indique s'il faut renvoyer le nombre total d'éléments et de pages. La valeur par défaut est false car l'obtention des totaux est une opération coûteuse. |
| pagination | Booléen | true, false | Indique si la pagination doit être ignorée et si toutes les lignes doivent être renvoyées. La valeur par défaut est true, ce qui signifie que par défaut toutes les requêtes sont paginées, sauf si paging=false (c'est-à-dire si le paramètre "pagination" est défini sur "faux") |
| order | Chaîne | Comma-separated list of field and sort direction pairs in format field:sortDirection. Example: createdAt:descEntities are ordered by newest (internal ID descending) by default. Note: field is case sensitive. Valid sortDirections are asc and desc, where sortDirection is case insensitive, and sortDirection defaults to asc for fields or UIDs without explicit sortDirection. |
Note
Be aware that performance is directly related to the amount of data requested. Greater page sizes will take more time to return.
The available organisation unit selection modes are SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE and ALL. Each mode is explained in detail in this section.
Tous les points d'extrémité d'exportation acceptent un paramètre fields (champs) qui contrôle les champs qui seront renvoyés dans la réponse JSON. Le paramètre fields accepte une liste de noms de champs ou de modèles séparés par des virgules. Quelques filtres fields possibles sont présentés ci-dessous. Consultez la section [filtre de champ de métadonnées (#webapi_metadata_field_filter)] pour obtenir un guide plus complet sur l'utilisation du paramètre fields.
| Query parameter example | Description |
|---|---|
| fields=* | Returns all fields |
| fields=createdAt,uid | Returns fields createdAt and uid |
| fields=enrollments[*,!uid] | Returns all fields of enrollments except uid |
| fields=enrollments[uid] | Returns enrollments field uid |
| fields=enrollments[uid,enrolledAt] | Returns enrollments fields uid and enrolledAt |
GET /api/tracker/trackedEntities
Deux points d'extrémité sont dédiés aux entités suivies :
GET /api/tracker/trackedEntitiesGET /api/tracker/trackedEntities/{id}If not otherwise specified, JSON is the default response for the GET method. The API also supports CSV export for single and collection endpoints. Furthermore, compressed CSV types is an option for the collection endpoint.
In the case of CSV, the fields request parameter has no effect, and the response will always contain the following fields:
Point et si la latitude et la longitude sont fournies)Point)Point)Voir Entités suivies et Attributs pour plus de descriptions de champs.
La réponse est le fichier trackedEntities.csv.gz contenant le fichier trackedEntities.csv.
La réponse est le fichier trackedEntities.csv.zip contenant le fichier trackedEntities.csv.
GET /api/tracker/trackedEntities
Le but de ce point d'extrémité est de récupérer les entités suivies correspondant aux critères fournis par le client.
Le point d'extrémité renvoie une liste d'entités suivies qui correspondent aux paramètres de la requête.
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| filter | Chaîne | Comma separated values of attribute filters. | Narrows response to tracked entities matching given filters. More on filters here |
| orgUnits | Chaîne | Liste des unités d'organisation UID séparées par des virgules. | Renvoie uniquement les d'entités suivies appartenant aux unités d'organisation fournies |
| orgUnitMode | Chaîne | SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE, ALL | Get tracked entities owned by given orgUnits relative to the orgUnitMode and program parameters. Defaults to ACCESSIBLE if no organisation unit(s) are set via orgUnits. Defaults to SELECTED if organisation unit(s) are set via orgUnits. See org unit modes. |
| program | Chaîne | UID de programme | A tracker program UID for which tracked entities in the response must be enrolled into. |
programStatus deprecated for removal in version 43 use enrollmentStatus | String | ACTIVE, COMPLETED, CANCELLED | The status of the tracked entities enrollment in the given program. |
| programStage | Chaîne | UID | un UID d'étape de programme pour lequel les entités suivies présentes dans la réponse doivent avoir des événements. |
| followUp | Booléen | true, false | Indique si l'entité suivie est marquée pour le suivi du programme spécifié. |
| updatedAfter | DateTime | ISO-8601 | Date et heure de début de la dernière mise à jour |
| updatedBefore | DateTime | ISO-8601 | Date et heure de fin de la dernière mise à jour |
| updatedWithin | Duration | ISO-8601 | Returns tracked entities not older than specified Duration |
| enrollmentStatus | Chaîne | ACTIVE, COMPLETED, CANCELLED | The status of the tracked entities enrollment in the given program. |
| enrollmentEnrolledAfter | DateTime | ISO-8601 | Date et heure de début de l’inscription au programme donné |
| enrollmentEnrolledBefore | DateTime | ISO-8601 | Date et heure de fin de l’inscription au programme donné |
| enrollmentOccurredAfter | DateTime | ISO-8601 | Start date for when the enrollment occurred in the given program |
| enrollmentOccurredBefore | DateTime | ISO-8601 | End date for when the enrollment occurred in the given program |
| TrackedEntityType | Chaîne | UID du type d'entité suivi | Renvoie uniquement les entités suivies d'un type donné |
| trackedEntities | Chaîne | Liste des UID des entités suivies, séparée par des virgules. | Il est possible de filtrer le résultat de manière à obtenir un ensemble limité d'entités suivies qui utilisent les uids explicites des entités suivies. Vous pouvez le en utilisant le paramètre trackedEntity=id1;id2. Ce paramètre créera, au minimum, la limite externe des résultats, en constituant la liste de toutes les entités suivies à l'aide des uids fournis. Si d'autres paramètres/filtres de ce tableau sont utilisés, ils limiteront davantage les résultats à partir de la limite externe explicite. |
| assignedUserMode | Chaîne | CURRENT, PROVIDED, NONE, ANY, ALL | Restricts result to tracked entities with events assigned based on the assigned user selection mode. See table below "Assigned user modes" for explanations. Default is ALL. |
| assignedUser | Chaîne | Liste des UID d'utilisateurs séparés par des virgules, à filtrer sur la base des événements affectés aux utilisateurs. | Il est possible de filtrer le résultat pour obtenir un ensemble limité d'entités suivies avec des événements attribués aux UID donnés, à l'aide du paramètre assignedUser=id1;id2. Ce paramètre ne sera pris en compte que si le mode d'utilisateur assigné est FOURNI ou nul. L'API va générer une erreur si, par exemple, assignedUserMode=CURRENT et assignedUser=someId |
| order | Chaîne | Liste séparée par des virgules de paires de noms de propriétés, d'attributs ou d'UID et de directions de tri au format propName:sortDirection. | Les valeurs prises en charge sont: createdAt (créé à) createdAtClient (créé au niveau du client), enrolledAt (inscrit à), inactive (inactif), trackedEntity (entité suivie), updatedAt (mis à jour à), updatedAtClient (mis à jour au niveau du client), . |
| eventStatus | Chaîne | ACTIVE, COMPLETED, VISITED, SCHEDULE, OVERDUE, SKIPPED | Il s'agit du statut de tous les événements présents dans le programme spécifié |
| eventOccurredAfter | DateTime | ISO-8601 | Date et heure de début de l'événement pour le programme donné |
| eventOccurredBefore | DateTime | ISO-8601 | Date et heure de fin de l'événement pour le programme donné |
| includeDeleted | Booléen | true, false | Indique s’il faut inclure les éléments supprimés de façon réversible |
| potentialDuplicate | Booléen | true, false | Filter the result based on the fact that a tracked entities is a potential duplicate. true: returns tracked entities flagged as potential duplicates. false: returns tracked entities NOT flagged as potential duplicates. |
| idScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for all metadata references unless overridden by a metadata specific parameter. Default is UID. Note: only metadata in fields trackedEntity.trackedEntityType, orgUnit and attributes is exported in this idScheme. All other fields will always be exported using UIDs. |
| orgUnitIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for organisation unit references. Defaults to the idScheme parameter. |
Les modes d'utilisateur assigné disponibles sont expliqués dans le tableau suivant.
Tableau : Modes d'utilisateur assigné
| Mode | Description |
|---|---|
| CURRENT | Inclut les événements attribués à l’utilisateur actuellement connecté. |
| PROVIDED | Inclut les événements attribués à l’utilisateur indiqué dans la requête. |
| NONE | Inclut uniquement les événements non attribués. |
| ANY | Includes all assigned events, regardless of who they are assigned to, as long as they are assigned to someone. |
| ALL | Includes all events irrespective of whether a user is assigned. This is the default mode. |
La requête n'est pas sensible à la casse. Les règles suivantes s'appliquent aux paramètres de requête.
orgUnit (un ou plusieurs), ou orgUnitMode=ALL doit être spécifié.program et trackedEntity peut être spécifié (zéro ou un).programStatus is specified, then program must also be specified.enrollmentStatus is specified, then program must also be specified.followUp est spécifié, alors program doit également être spécifié.Si enrollmentEnrolledAfter ou enrollmentEnrolledBefore est spécifié, alors program doit également être spécifié.
Les éléments du filtre ne peuvent être spécifiés qu'une seule fois.
A query for all tracked entities associated with a specific organisation unit and tracker program can look like this:
GET /api/tracker/trackedEntities?program=IpHINAT79UW&orgUnits=DiszpKrYNg8
Pour lancer une requête sur les entités suivies en utilisant un attribut avec un filtre et un attribut sans filtre, avec une unité d'organisation en utilisant le mode de requête par unité d'organisation descendante :
GET /api/tracker/trackedEntities?program=IpHINAT79UW&orgUnits=DiszpKrYNg8&filter=w75KJ2mc4zz:EQ:John
Une requête dans laquelle plusieurs opérandes et filtres sont spécifiés pour un élément de filtre :
GET /api/tracker/trackedEntities?orgUnits=DiszpKrYNg8&program=ur1Edk5Oe2n&filter=lw1SqmMlnfh:GT:150&filter=lw1SqmMlnfh:LT:190
Un filtre de requête avec une valeur qui doit être échappée et qui sera interprétée comme :,/ :
GET /api/tracker/trackedEntities?orgUnits=DiszpKrYNg8&program=ur1Edk5Oe2n&filter=lw1SqmMlnfh:EQ:/:/,//
Pour spécifier les dates d'inscription au programme dans la requête :
GET /api/tracker/trackedEntities?orgUnits=DiszpKrYNg8&program=IpHINAT79UW&fields=trackedEntity,enrollments[enrolledAt]&enrollmentEnrolledAfter=2024-01-01
To query on an attribute using multiple values with an IN filter and semicolon-separated values:
GET /api/tracker/trackedEntities?trackedEntityType=nEenWmSyUEp&orgUnits=DiszpKrYNg8&filter=w75KJ2mc4zz:IN:Scott;Jimmy;Santiago
All of the following operators are supported regardless of the value type. Values are compared using text comparison unless stated otherwise. Integer and decimal value types are treated as PostgreSQL integer and numeric data types for the specified operators.
Supported binary operators:
| Opérateur | Description |
|---|---|
| eq | equal to, uses integer/numeric semantics for integer/decimal value types |
| ieq | equal to, ignoring case (use eq instead)* |
| ge | greater than or equal to (uses integer/number semantics for integer/decimal value types) |
| gt | greater than, uses integer/number semantics for integer/decimal value types |
| le | less than or equal to, uses integer/number semantics for integer/decimal value types |
| lt | less than (uses integer/number semantics for integer/decimal value types) |
| ne | not equal to (uses integer/number semantics for integer/decimal value types) |
| neq | not equal to (uses integer/number semantics for integer/decimal value types), use ne instead* |
| nieq | not equal to, ignoring case (use ne instead)* |
| dans | one of multiple values separated by semicolon ";", uses integer/number semantics for integer/decimal value types |
| like | like text match |
| ilike | like text match, ignoring case (use like instead)* |
| nlike | not like |
| nilike | not like, ignoring case (use nlike instead)* |
| sw | starts with |
| ew | ends with |
*These operators are currently supported but may be removed in the future. We recommend using the operator mentioned in the description, as it provides the same functionality.
Matches are case-insensitive, for example eq and ieq (i for insensitive) behave in the same way. To ensure future compatibility, always use the non-i form (eq, like, etc.).
For instance, filter=w75KJ2mc4zz:eq:Scott would return values of the given attribute that match any variation of "Scott" regardless of case, such as SCOTT, scott, Scott...
Supported unary operators:
| Opérateur | Description |
|---|---|
| null | has no value |
| !null | has a value |
Filtering by a tracked entity attribute narrows the response to tracked entities matching given filters. A filter is a colon separated property or attribute UID with optional operator and value pairs.
Example: filter=H9IlTX2X6SL:sw:A with operator starts with sw followed by a value.
A filter like filter=H9IlTX2X6SL:!null returns all entries where the given attribute has a value.
Special characters like + need to be percent-encoded, so %2B instead of +. Characters such as : or ,, as part of the filter value, need to be escaped by /. Likewise, / needs to be escaped.
Multiple operators for the same attribute like filter=AuPLng5hLbE:gt:438901703:lt:448901704 are allowed.
Each tracked entity attribute can be configured with: - A minimum number of characters required to perform a search (0 means no minimum) - Blocked operators. Only sw, ew, and like can be blocked. All other operators cannot be blocked.
The following request:
GET /api/tracker/trackedEntities?program=IpHINAT79UW&orgUnits=DiszpKrYNg8&filter=w75KJ2mc4zz:EQ:John
EQ operator was blocked for the specified tracked entity attribute. The API supports CSV and JSON response for GET /api/tracker/trackedEntities.
Responses can be filtered on desired fields, see field filter for more information.
A JSON response looks like the following:
{
"pager": {
"page": 1,
"pageSize": 1
},
"trackedEntities": [
{
"trackedEntity": "F8yKM85NbxW",
"trackedEntityType": "Zy2SEgA61ys",
"createdAt": "2019-08-21T13:25:38.022",
"createdAtClient": "2019-03-19T01:12:16.624",
"updatedAt": "2019-08-21T13:31:33.410",
"updatedAtClient": "2019-03-19T01:12:16.624",
"orgUnit": "DiszpKrYNg8",
"inactive": false,
"deleted": false,
"potentialDuplicate": false,
"geometry": {
"type": "Point",
"coordinates": [
-11.7896,
8.2593
]
},
"attributes": [
{
"attribute": "B6TnnFMgmCk",
"displayName": "Age (years)",
"createdAt": "2019-08-21T13:25:38.477",
"updatedAt": "2019-08-21T13:25:38.477",
"storedBy": "braimbault",
"valueType": "INTEGER_ZERO_OR_POSITIVE",
"value": "30"
},
{
"attribute": "TfdH5KvFmMy",
"displayName": "First Name",
"createdAt": "2019-08-21T13:25:38.066",
"updatedAt": "2019-08-21T13:25:38.067",
"storedBy": "josemp10",
"valueType": "TEXT",
"value": "Sarah"
},
{
"attribute": "aW66s2QSosT",
"displayName": "Last Name",
"createdAt": "2019-08-21T13:25:38.388",
"updatedAt": "2019-08-21T13:25:38.388",
"storedBy": "karoline",
"valueType": "TEXT",
"value": "Johnson"
}
]
}
]
}
A CSV response looks like the following:
trackedEntity,trackedEntityType,createdAt,createdAtClient,updatedAt,updatedAtClient,orgUnit,inactive,deleted,potentialDuplicate,geometry,latitude,longitude,createdBy,updatedBy,attrCreatedAt,attrUpdatedAt,attribute,displayName,value,valueType
F8yKM85NbxW,Zy2SEgA61ys,2019-08-21T11:25:38.022Z,2019-03-19T00:12:16.624Z,2019-08-21T11:31:33.410Z,2019-03-19T00:12:16.624Z,DiszpKrYNg8,false,false,false,"POINT (-11.7896 8.2593)",8.2593,-11.7896,,,2019-08-21T11:25:38.477Z,2019-08-21T11:25:38.477Z,B6TnnFMgmCk,"Age (years)",30,INTEGER_ZERO_OR_POSITIVE
F8yKM85NbxW,Zy2SEgA61ys,2019-08-21T11:25:38.022Z,2019-03-19T00:12:16.624Z,2019-08-21T11:31:33.410Z,2019-03-19T00:12:16.624Z,DiszpKrYNg8,false,false,false,"POINT (-11.7896 8.2593)",8.2593,-11.7896,,,2019-08-21T11:25:38.066Z,2019-08-21T11:25:38.067Z,TfdH5KvFmMy,"First Name",Sarah,TEXT
F8yKM85NbxW,Zy2SEgA61ys,2019-08-21T11:25:38.022Z,2019-03-19T00:12:16.624Z,2019-08-21T11:31:33.410Z,2019-03-19T00:12:16.624Z,DiszpKrYNg8,false,false,false,"POINT (-11.7896 8.2593)",8.2593,-11.7896,,,2019-08-21T11:25:38.388Z,2019-08-21T11:25:38.388Z,aW66s2QSosT,"Last Name",Johnson,TEXT
The collection endpoint limits results in three ways:
KeyTrackedEntityMaxLimit in System settings: KeyTrackedEntityMaxLimit defines the maximum tracked entities in an API response, protecting database and server resources. No limit applies when set to 0. Configure it via /api/systemSettings as described in the documentation.
Max number of TEs to return in Program or tracked entity type: it limits results when searching outside the capture scope with a specified program or tracked entity type. The API returns an error if matches exceed this limit. No limit applies when searching within the capture scope or when set to 0. This limit is configurable in the maintenance app.
Pagination: As explained here.
For paginated requests with non-zero KeyTrackedEntityMaxLimit:
If pageSize ≤ KeyTrackedEntityMaxLimit: pageSize is enforced
If pageSize > KeyTrackedEntityMaxLimit: The API returns an error
GET /api/tracker/trackedEntities/{uid}
This endpoint retrieves a tracked entity given by ID.
GET /api/tracker/trackedEntities/{uid}?program={programUid}&fields={fields}
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| uid | Chaîne | uid | Renvoie l'entité suivie disposant de l'uid spécifié |
| program | Chaîne | uid | Inclut les attributs du programme dans la réponse (seuls ceux auxquels l'utilisateur a accès) |
| champs | Chaîne | Tout filtre de champ valide (par défaut *,!relationships,!enrollments,!events,!programOwners) | Inclut les sous-objets spécifiés dans la réponse |
Une requête pour une entité suivie:
GET /api/tracker/trackedEntities/PQfMcpmXeFE
The API supports CSV and JSON response for GET /api/tracker/trackedEntities/{uid}
An example JSON response.
{
"trackedEntity": "PQfMcpmXeFE",
"trackedEntityType": "nEenWmSyUEp",
"createdAt": "2014-03-06T05:49:28.256",
"createdAtClient": "2014-03-06T05:49:28.256",
"updatedAt": "2016-08-03T23:49:43.309",
"orgUnit": "DiszpKrYNg8",
"inactive": false,
"deleted": false,
"potentialDuplicate": false,
"attributes": [
{
"attribute": "w75KJ2mc4zz",
"code": "MMD_PER_NAM",
"displayName": "First name",
"createdAt": "2016-08-03T23:49:43.308",
"updatedAt": "2016-08-03T23:49:43.308",
"valueType": "TEXT",
"value": "John"
},
{
"attribute": "zDhUuAYrxNC",
"displayName": "Last name",
"createdAt": "2016-08-03T23:49:43.309",
"updatedAt": "2016-08-03T23:49:43.309",
"valueType": "TEXT",
"value": "Kelly"
}
],
"enrollments": [
{
"enrollment": "JMgRZyeLWOo",
"createdAt": "2017-03-06T05:49:28.340",
"createdAtClient": "2016-03-06T05:49:28.340",
"updatedAt": "2017-03-06T05:49:28.357",
"trackedEntity": "PQfMcpmXeFE",
"program": "IpHINAT79UW",
"status": "ACTIVE",
"orgUnit": "DiszpKrYNg8",
"enrolledAt": "2024-03-06T00:00:00.000",
"occurredAt": "2024-03-04T00:00:00.000",
"attributeOptionCombo": "HllvX50cXC0",
"followUp": false,
"deleted": false,
"events": [
{
"event": "Zq2dg6pTNoj",
"status": "ACTIVE",
"program": "IpHINAT79UW",
"programStage": "ZzYYXq4fJie",
"enrollment": "JMgRZyeLWOo",
"trackedEntity": "PQfMcpmXeFE",
"relationships": [],
"scheduledAt": "2023-03-10T00:00:00.000",
"followUp": false,
"deleted": false,
"createdAt": "2017-03-06T05:49:28.353",
"createdAtClient": "2016-03-06T05:49:28.353",
"updatedAt": "2017-03-06T05:49:28.353",
"attributeOptionCombo": "HllvX50cXC0",
"attributeCategoryOptions": "xYerKDKCefk",
"dataValues": [],
"notes": []
}
],
"relationships": [],
"attributes": [
{
"attribute": "w75KJ2mc4zz",
"code": "MMD_PER_NAM",
"displayName": "First name",
"createdAt": "2016-08-03T23:49:43.308",
"updatedAt": "2016-08-03T23:49:43.308",
"valueType": "TEXT",
"value": "John"
},
{
"attribute": "zDhUuAYrxNC",
"displayName": "Last name",
"createdAt": "2016-08-03T23:49:43.309",
"updatedAt": "2016-08-03T23:49:43.309",
"valueType": "TEXT",
"value": "Kelly"
},
{
"attribute": "AuPLng5hLbE",
"code": "National identifier",
"displayName": "National identifier",
"createdAt": "2016-08-03T23:49:43.301",
"updatedAt": "2016-08-03T23:49:43.301",
"valueType": "TEXT",
"value": "245435245"
},
{
"attribute": "ruQQnf6rswq",
"displayName": "TB number",
"createdAt": "2016-08-03T23:49:43.308",
"updatedAt": "2016-08-03T23:49:43.308",
"valueType": "TEXT",
"value": "1Z 1F2 A84 59 4464 173 6"
},
{
"attribute": "cejWyOfXge6",
"displayName": "Gender",
"createdAt": "2016-08-03T23:49:43.307",
"updatedAt": "2016-08-03T23:49:43.307",
"valueType": "TEXT",
"value": "Male"
},
{
"attribute": "VqEFza8wbwA",
"code": "MMD_PER_ADR1",
"displayName": "Address",
"createdAt": "2016-08-03T23:49:43.307",
"updatedAt": "2016-08-03T23:49:43.307",
"valueType": "TEXT",
"value": "Main street 2"
}
],
"notes": []
}
],
"programOwners": [
{
"orgUnit": "DiszpKrYNg8",
"trackedEntity": "PQfMcpmXeFE",
"program": "ur1Edk5Oe2n"
},
{
"orgUnit": "DiszpKrYNg8",
"trackedEntity": "PQfMcpmXeFE",
"program": "IpHINAT79UW"
}
]
}
The response will be the same as the collection endpoint but referring to a single tracked entity, although it might have multiple rows for each attribute.
GET /api/tracker/trackedEntities/{uid}/changeLogs
This endpoint retrieves change logs for the attributes of a specific tracked entity. It returns a list of all tracked entity attributes that have changed over time for that entity.
| Paramètre de requête | Type | Valeurs autorisées |
|---|---|---|
path /{uid} | Chaîne | Tracked entity UID. |
| program | String | Program UID (optional). |
| order | String | Field and sort direction pair in the format field:sortDirection.Change logs are ordered by newest (creation date in descending order) by default, when no order parameter is provided. Example: createdAt:descfield is case-sensitive. Valid sortDirection values are asc and desc. sortDirection is case-insensitive and defaults to asc for fields without explicit sortDirection. Supported fields are attribute, createdAt, and username. |
| filter | Chaîne | Colon-separated field name with the eq operator and value in the format field:eq:value.Example: attribute:eq:w75KJ2mc4zzFiltering is supported for attribute and username fields, one at a time. Only the eq (equals) operator is supported. |
An example JSON response.
{
"pager": {
"page": 1,
"pageSize": 10
},
"changeLogs": [
{
"createdBy": {
"uid": "AIK2aQOJIbj",
"username": "tracker",
"firstName": "Tracker demo",
"surname": "User"
},
"createdAt": "2024-06-20T14:51:16.433",
"type": "UPDATE",
"change": {
"attributeValue": {
"attribute": "w75KJ2mc4zz",
"previousValue": "John",
"currentValue": "Johnny"
}
}
},
{
"createdBy": {
"uid": "AIK2aQOJIbj",
"username": "tracker",
"firstName": "Tracker demo",
"surname": "User"
},
"createdAt": "2024-06-20T14:50:32.966",
"type": "CREATE",
"change": {
"attributeValue": {
"attribute": "w75KJ2mc4zz",
"currentValue": "John"
}
}
}
]
}
The change log type can be CREATE, UPDATE, or DELETE. CREATE and DELETE will always hold a single value: the former shows the current value, and the latter shows the value that was deleted. UPDATE will hold two values: the previous and the current.
More on change log configuration here
GET /api/tracker/enrollments
Two endpoints are dedicated to enrollments.
GET /api/tracker/enrollmentsGET /api/tracker/enrollments/{id}GET /api/tracker/enrollmentsReturns a list of enrollments based on filters.
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| orgUnits | Chaîne | Liste des unités d'organisation UID séparées par des virgules. | Renvoie uniquement les inscriptions appartenant aux unités d'organisation fournies. |
| orgUnitMode (see orgUnitModes) | Chaîne | SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE, ALL | The mode of selecting organisation units. Default is SELECTED. |
| program | Chaîne | uid | Identifier of a tracker program the enrollment is enrolled into. This parameter is mandatory. |
programStatus deprecated for removal in version 43 use status | Chaîne | ACTIVE, COMPLETED, CANCELLED | The status of the enrollment. |
| status | Chaîne | ACTIVE, COMPLETED, CANCELLED | The status of the enrollment. |
| followUp | booléen | true, false | Follow up status of the tracked entity for the given program. Can be true, false or omitted. |
| updatedAfter | DateTime | ISO-8601 | Seules les inscriptions mises à jour après cette date |
| updatedWithin | Duration | ISO-8601 | Seules les inscriptions mises à jour depuis une durée donnée |
| enrolledAfter | DateTime | ISO-8601 | Seules les inscriptions plus récentes que cette date |
| enrolledBefore | DateTime | ISO-8601 | Seules les inscriptions antérieures à cette date |
| trackedEntity | Chaîne | uid | Identifiant d'une entité suivie |
| order | Chaîne | Liste séparée par des virgules de paires de noms de propriétés, d'attributs ou d'UID et de directions de tri au format propName:sortDirection. | Champs pris en charge : completedAt,(terminé à), createdAt (créé à), createdAtClient (créé au niveau du client), enrolledAt (inscrit à), updatedAt (mis à jour à), updatedAtClient (mis à jour au niveau du client). |
| inscriptions | Chaîne | Liste des UID des inscriptions, séparée par des virgules. | Filtre le résultat pour obtenir un ensemble limité d’identifiants en utilisant enrollments=id1,id2. |
| attributeOptionCombo (combinaison d'options d'attribut) | Chaîne | uid | Filters enrollments by the given attribute option combo. Only matching enrollments are returned. |
| includeDeleted | Booléen | S'il est défini sur "vrai", les événements supprimés de façon réversible seront inclus dans le résultat de votre requête. |
The query is case-insensitive. The only requirement is that the program parameter must be provided.
Une requête pour toutes les inscriptions associées à une unité d'organisation spécifique peut ressembler à ceci :
GET /api/tracker/enrollments?orgUnits=DiszpKrYNg8
To constrain the response to enrollments which are part of a specific tracker program you can include a program query parameter:
GET /api/tracker/enrollments?orgUnits=O6uvpzGd5pu&orgUnitMode=DESCENDANTS&program=ur1Edk5Oe2n
Pour spécifier les dates d'inscription au programme dans la requête :
GET /api/tracker/enrollments?orgUnits=DiszpKrYNg8&program=M3xtLkYBlKI&enrolledAfter=2023-11-14&enrolledBefore=2024-02-07
Pour limiter la réponse aux inscriptions d'une entité suivie spécifique, vous pouvez inclure un paramètre de requête d'entité suivie:
GET /api/tracker/enrollments?trackedEntity=ClJ3fn47c4s
Pour limiter la réponse aux inscriptions d'une entité suivie spécifique, vous pouvez inclure un paramètre de requête d'entité suivie. Dans ce cas, nous avons limité la réponse aux inscriptions disponibles pour l'utilisateur actuel :
GET /api/tracker/enrollments?orgUnitMode=ACCESSIBLE&trackedEntity=tphfdyIiVL6
The JSON response can look like the following.
{
"pager": {
"page": 1,
"pageSize": 1
},
"enrollments": [
{
"enrollment": "TRE0GT7eh7Q",
"createdAt": "2019-08-21T13:28:00.056",
"createdAtClient": "2018-11-13T15:06:49.009",
"updatedAt": "2019-08-21T13:29:44.942",
"updatedAtClient": "2019-08-21T13:29:44.942",
"trackedEntity": "s4NfKOuayqG",
"program": "M3xtLkYBlKI",
"status": "COMPLETED",
"orgUnit": "DiszpKrYNg8",
"enrolledAt": "2023-11-13T00:00:00.000",
"occurredAt": "2023-11-13T00:00:00.000",
"followUp": false,
"deleted": false,
"notes": []
}
]
}
GET /api/tracker/enrollments/{uid}
The purpose of this endpoint is to retrieve an enrollment given its ID.
GET /api/tracker/enrollment/{uid}
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| uid | Chaîne | uid | Renvoie l'inscription disposant de l'uid spécifié |
| champs | Chaîne | Tout filtre de champ valide (par défaut *,!relationships,!events,!attributes) | Inclut les sous-objets spécifiés dans la réponse |
A query for an enrollment.
GET /api/tracker/enrollments/JMgRZyeLWOo
{
"enrollment": "JMgRZyeLWOo",
"createdAt": "2017-03-06T05:49:28.340",
"createdAtClient": "2016-03-06T05:49:28.340",
"updatedAt": "2017-03-06T05:49:28.357",
"trackedEntity": "PQfMcpmXeFE",
"program": "IpHINAT79UW",
"status": "ACTIVE",
"orgUnit": "DiszpKrYNg8",
"enrolledAt": "2024-03-06T00:00:00.000",
"occurredAt": "2024-03-04T00:00:00.000",
"followUp": false,
"deleted": false,
"notes": []
}
GET /api/tracker/events)Two endpoints are dedicated to events. To retrieve events matching specific criteria:
GET /api/tracker/events
To retrieve an event with a specific ID:
GET /api/tracker/events/{id}
If not otherwise specified, JSON is the default response for the GET method. The API also supports CSV export for single and collection endpoints. Furthermore, it supports compressed JSON and CSV for the collection endpoint.
In the case of CSV, the fields request parameter has no effect, and the response will always contain the following fields:
| Propriété | Type |
|---|---|
| event | UID |
| status | Chaîne |
| program | Identifiant |
| programStage | Identifiant |
| enrollment | Identifiant |
| orgUnit | Identifiant |
| occurredAt (s'est produit à) | DateTime |
| scheduledAt (programmé à) | DateTime |
| géométrie | WKT, can be omitted it in case of a Point type and with latitude and longitude provided |
| latitude | Latitude of a Point type of Geometry |
| longitude | Longitude of a Point type of Geometry |
| followUp | booléen |
| supprimé | booléen |
| créé à | DateTime |
| crééAtClient (Création au niveau du client) | DateTime |
| updatedAt (mis à jour à) | DateTime |
| updatedAtClient (mise à jour au niveau du client) | DateTime |
| completedBy | Nom d'utilisateur |
| completedAt (effectué à) | DateTime |
| updatedBy (mis à jour par) | Nom d'utilisateur |
| attributeOptionCombo (combinaison d'options d'attribut) | Identifiant |
| attributeCategoryOptions (options de catégorie d'attribut) | Identifiant |
| assignedUser | Nom d'utilisateur |
| dataElement | Identifiant |
| value | Chaîne |
| providedElsewhere | booléen |
| storedByDataValue | Chaîne |
| createdAtDataValue | DateTime |
| updatedAtDataValue | DateTime |
See Events and Data Values for more field descriptions.
The response is file events.json.gz or events.csv.gz containing the events.json or events.csv file.
The response is file events.json.zip or events.csv.zip containing the events.json or events.csv file.
GET /api/tracker/eventsRenvoie une liste d'événements en fonction des filtres fournis.
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| program | Chaîne | uid | Identifier of a tracker or event program. This parameter is mandatory. |
| programStage | Chaîne | uid | Identifiant de l'étape de programme |
programStatus deprecated for removal in version 43 use enrollmentStatus | Chaîne | ACTIVE, COMPLETED, CANCELLED | The status of the events enrollment. |
| filter | Chaîne | Valeurs des filtres d'éléments de données, séparées par des virgules | Narrows response to events matching given filters. A filter is a colon separated property or data element UID with optional operator and value pairs. Example: filter=fazCI2ygYkq:eq:PASSIVE with operator starts with eq followed by a value. A filter like filter=fazCI2ygYkq:!null returns all events where the given data element has a value. Characters such as : or ,, as part of the filter value, need to be escaped by /. Likewise, / needs to be escaped. Multiple operators for the same data element like filter=qrur9Dvnyt5:gt:70:lt:80 are allowed. User needs access to the data element to filter on it. |
| filterAttributes | Chaîne | Valeurs des filtres d'attribut séparées par des virgules | Narrows response to tracked entities matching given filters. Example: filterAttributes=H9IlTX2X6SL:eq:John. More on filters here |
| followUp | booléen | true, false | Détermine si l'événement est pris en compte pour un suivi dans le programme. La valeur par défaut est vrai |
| trackedEntity | Chaîne | uid | Identifiant d'une entité suivie |
| orgUnit | Chaîne | uid | Identifiant de l'unité d'organisation |
| orgUnitMode see orgUnitModes | Chaîne | SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE, ALL | Le mode de sélection des unités d'organisation peut l'être. La valeur par défaut est SÉLECTIONNÉ, qui fait uniquement référence aux unités d'organisation sélectionnées. |
| status | Chaîne | ACTIVE, COMPLETED, VISITED, SCHEDULE, OVERDUE, SKIPPED | Statut de l'événement |
| occurredAfter | DateTime | ISO-8601 | Filtre pour les événements survenus après cette date. |
| occurredBefore | DateTime | ISO-8601 | Filtre pour les événements survenus jusqu'à cette date. |
| scheduledAfter | DateTime | ISO-8601 | Filtre pour les événements programmés après cette date. |
| scheduledBefore | DateTime | ISO-8601 | Filtre pour les événements programmés avant cette date. |
| updatedAfter | DateTime | ISO-8601 | Filtre pour les événements qui ont été mis à jour après cette date. Ne peut pas être utilisé avec updatedWithin (mis à jour pendant). |
| updatedBefore | DateTime | ISO-8601 | Filtre pour les événements qui ont été mis à jour jusqu'à cette date. Ne peut pas être utilisé avec updatedWithin. |
| updatedWithin | Duration | ISO-8601 | Incluez uniquement les éléments mis à jour pendant la durée indiquée. Le format est ISO-8601#Duration |
| enrollmentStatus | Chaîne | ACTIVE, COMPLETED, CANCELLED | The status of the events enrollment. |
| enrollmentEnrolledAfter | DateTime | ISO-8601 | Date et heure de début de l’inscription au programme donné |
| enrollmentEnrolledBefore | DateTime | ISO-8601 | Date et heure de fin de l’inscription au programme donné |
| enrollmentOccurredAfter | DateTime | ISO-8601 | Start date for when the enrollment occurred in the given program |
| enrollmentOccurredBefore | DateTime | ISO-8601 | End date for when the enrollment occurred in the given program |
| idScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for all metadata references unless overridden by a metadata specific parameter. Default is UID. Note: metadata in event.relationships will always be exported using UIDs. |
| dataElementIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for data element references. Defaults to the idScheme parameter. |
| orgUnitIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for organisation unit references. Defaults to the idScheme parameter. |
| programIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for program references. Defaults to the idScheme parameter. |
| programStageIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for program stage references. Defaults to the idScheme parameter. |
| categoryOptionComboIdScheme | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for category option combo references. Defaults to the idScheme parameter. |
| categoryOptionIdScheme (Schéma d'identification des options de catégorie) | Énumération | UID, CODE, NAME, ATTRIBUTE:{uid} | IdScheme used for category option references. Defaults to the idScheme parameter. |
| order | Chaîne | Liste de paires de noms de propriétés, d'attributs ou d'éléments de données UID et de directions de tri, séparées par des virgules, au format propName:sortDirection. | Les champs pris en charge sont : assignedUser, assignedUserDisplayName, attributeOptionCombo, completedAt, completedBy, createdAt, createdAtClient, createdBy, deleted, enrolledAt, enrollment, enrollmentStatus, event, followUp, occurredAt, orgUnit, program, programStage, scheduledAt, status, storedBy, trackedEntity, updatedAt, updatedAtClient, updatedBy. |
| events | Chaîne | Liste des UID des événements, séparée par des virgules. | Filtre le résultat pour obtenir un ensemble limité d’identifiants en utilisant event=id1,id2. |
| attributeCategoryCombo (see note) | Chaîne | Identifiant de la combinaison de catégories d'attributs. Doit être combiné avec attributeCategoryOptions. | |
| attributeCategoryOptions (see note) | Chaîne | Identifiants d'options de catégories d'attributs séparés par des virgules. Doit être combiné avec attributeCategoryCombo. | |
| includeDeleted | Booléen | S'il est défini sur "vrai", les événements supprimés de façon réversible seront inclus dans le résultat de votre requête. | |
| assignedUserMode | Chaîne | CURRENT, PROVIDED, NONE, ANY | Mode de sélection de l'utilisateur assigné |
| assignedUser | Chaîne | Liste des UID d'utilisateurs séparés par des virgules, à filtrer sur la base des événements affectés aux utilisateurs. | Il est possible de filtrer le résultat pour obtenir un ensemble limité d'entités suivies avec des événements attribués aux UID donnés, à l'aide du paramètre assignedUser=id1;id2. Ce paramètre ne sera pris en compte que si le mode d'utilisateur assigné est FOURNI ou nul. L'API va générer une erreur si, par exemple, assignedUserMode=CURRENT et assignedUser=someId |
Note
If the query contains neither
attributeCategoryCombonorattributeCategoryOptions, the server returns events for all attribute option combos where the user has read access.
La requête pour tous les événements associés aux subordonnées d'une unité d'organisation donnée :
GET /api/tracker/events?orgUnit=YuQRtpLP10I&orgUnitMode=CHILDREN
La requête pour tous les événements associés à tous les descendants d'une unité d'organisation donnée, c'est-à-dire toutes les unités d'organisation qui lui sont inférieurs dans la hiérarchie :
GET /api/tracker/events?orgUnit=O6uvpzGd5pu&orgUnitMode=DESCENDANTS
Requête pour tous les événements associés à un programme et à une unité d'organisation :
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=eBAyeGv0exc
La requête pour tous les événements disposant d'un programme et d'une unité d'organisation, ordonnés par date programmée en ordre croissant :
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=eBAyeGv0exc&order=scheduledAt
La requête pour les 10 événements dont la date de déroulement est la plus récente dans un programme et une unité d'organisation donné - par pagination et ordonnés par date de déroulement en ordre décroissant :
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=eBAyeGv0exc&order=occurredAt:desc&pageSize=10&page=1
La requête pour tous les événements avec un programme et une unité d'organisation pour une entité suivie donnée :
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=M3xtLkYBlKI&trackedEntity=dNpxRu1mWG5
Query for all events before or equal to 2024-02-03 and associated with a program and organisation unit:
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=eBAyeGv0exc&occurredBefore=2024-02-03
Une requête dans laquelle plusieurs opérandes et filtres sont spécifiés pour un UID d'élément de données :
GET /api/tracker/events?orgUnit=g8upMTyEZGZ&program=M3xtLkYBlKI&filter=rFQNCGMYud2:GT:35&filter=rFQNCGMYud2:LT:50
Un filtre de requête avec une valeur qui doit être échappée et qui sera interprétée comme :,/ :
GET /api/tracker/events?orgUnit=DiszpKrYNg8&program=lxAQ7Zs9VYR&filter=DanTR5x0WDK:EQ:/:/,//
L'API prend en charge les réponses CSV et JSON pour GET /api/tracker/events.
La réponse JSON peut ressembler à ce qui suit:
{
"pager": {
"page": 1,
"pageSize": 1
},
"events": [
{
"event": "A7rzcnZTe2T",
"status": "ACTIVE",
"program": "eBAyeGv0exc",
"programStage": "Zj7UnCAulEk",
"enrollment": "RiLEKhWHlxZ",
"orgUnit": "DwpbWkiqjMy",
"occurredAt": "2023-02-13T00:00:00.000",
"scheduledAt": "2023-02-13T00:00:00.000",
"followUp": false,
"deleted": false,
"createdAt": "2017-09-08T21:40:22.000",
"createdAtClient": "2016-09-08T21:40:22.000",
"updatedAt": "2017-09-08T21:40:22.000",
"attributeOptionCombo": "HllvX50cXC0",
"attributeCategoryOptions": "xYerKDKCefk",
"geometry": {
"type": "Point",
"coordinates": [-11.468912037323042, 7.515913998868316]
},
"dataValues": [
{
"createdAt": "2016-12-06T18:22:34.438",
"updatedAt": "2016-12-06T18:22:34.438",
"providedElsewhere": false,
"dataElement": "F3ogKBuviRA",
"value": "[-11.4880220438585,7.50978830548003]"
},
{
"createdAt": "2013-12-30T14:23:57.423",
"updatedAt": "2013-12-30T14:23:57.423",
"providedElsewhere": false,
"dataElement": "eMyVanycQSC",
"value": "2018-02-07"
},
{
"createdAt": "2013-12-30T14:23:57.382",
"updatedAt": "2013-12-30T14:23:57.382",
"providedElsewhere": false,
"dataElement": "oZg33kd9taw",
"value": "Male"
}
],
"notes": [],
"followup": false
}
]
}
La réponse CSV peut ressembler à ce qui suit:
event,status,program,programStage,enrollment,orgUnit,occurredAt,scheduledAt,geometry,latitude,longitude,followUp,deleted,createdAt,createdAtClient,updatedAt,updatedAtClient,completedBy,completedAt,updatedBy,attributeOptionCombo,attributeCategoryOptions,assignedUser,dataElement,value,providedElsewhere,storedByDataValue,updatedAtDataValue,createdAtDataValue
A7rzcnZTe2T,ACTIVE,eBAyeGv0exc,Zj7UnCAulEk,RiLEKhWHlxZ,DwpbWkiqjMy,2023-02-12T23:00:00Z,2023-02-12T23:00:00Z,"POINT (-11.468912037323042 7.515913998868316)",7.515913998868316,-11.468912037323042,false,false,2017-09-08T19:40:22Z,,2017-09-08T19:40:22Z,,,,,HllvX50cXC0,xYerKDKCefk,,F3ogKBuviRA,"[-11.4880220438585,7.50978830548003]",false,,2016-12-06T17:22:34.438Z,2016-12-06T17:22:34.438Z
A7rzcnZTe2T,ACTIVE,eBAyeGv0exc,Zj7UnCAulEk,RiLEKhWHlxZ,DwpbWkiqjMy,2023-02-12T23:00:00Z,2023-02-12T23:00:00Z,"POINT (-11.468912037323042 7.515913998868316)",7.515913998868316,-11.468912037323042,false,false,2017-09-08T19:40:22Z,,2017-09-08T19:40:22Z,,,,,HllvX50cXC0,xYerKDKCefk,,eMyVanycQSC,2018-02-07,false,,2013-12-30T13:23:57.423Z,2013-12-30T13:23:57.423Z
A7rzcnZTe2T,ACTIVE,eBAyeGv0exc,Zj7UnCAulEk,RiLEKhWHlxZ,DwpbWkiqjMy,2023-02-12T23:00:00Z,2023-02-12T23:00:00Z,"POINT (-11.468912037323042 7.515913998868316)",7.515913998868316,-11.468912037323042,false,false,2017-09-08T19:40:22Z,,2017-09-08T19:40:22Z,,,,,HllvX50cXC0,xYerKDKCefk,,msodh3rEMJa,2018-02-13,false,,2013-12-30T13:23:57.467Z,2013-12-30T13:23:57.467Z
GET /api/tracker/events/{uid}Le but de ce point d'extrémité est de récupérer un événement en se basant sur son UID.
GET /api/tracker/events/{uid}?fields={fields}
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
uid | String | uid | Renvoie l'événement disposant de l'uid spécifié |
champs | String | Tout filtre de champ valide (par défaut *,!relationships) | Inclut les sous-objets spécifiés dans la réponse |
Une requête pour un événement :
GET /api/tracker/events/rgWr86qs0sI
The API supports CSV and JSON response for GET /api/tracker/events/{uid}
{
"event": "rgWr86qs0sI",
"status": "ACTIVE",
"program": "kla3mAPgvCH",
"programStage": "aNLq9ZYoy9W",
"enrollment": "Lo3SHzCnMSm",
"orgUnit": "DiszpKrYNg8",
"occurredAt": "2024-10-12T00:00:00.000",
"followUp": false,
"deleted": false,
"createdAt": "2018-10-20T12:09:19.492",
"createdAtClient": "2017-10-20T12:09:19.492",
"updatedAt": "2018-10-20T12:09:19.492",
"attributeOptionCombo": "amw2rQP6r6M",
"attributeCategoryOptions": "RkbOhHwiOgW",
"dataValues": [
{
"createdAt": "2015-10-20T12:09:19.640",
"updatedAt": "2015-10-20T12:09:19.640",
"providedElsewhere": false,
"dataElement": "HyJL2Lt37jN",
"value": "12"
}
],
"notes": [],
"followup": false
}
The response will be the same as the collection endpoint but referring to a single event, although it might have multiple rows for each data element value.
GET /api/tracker/events/{uid}/changeLogs
This endpoint retrieves change logs for the data values of a specific event. It returns a list of all event data values and event fields (occurredAt, scheduledAt, and geometry) that have changed over time for the specified event.
| Paramètre de requête | Type | Valeurs autorisées |
|---|---|---|
path /{uid} | Chaîne | Event UID. |
| order | Chaîne | Field and sort direction pair in the format field:sortDirection.Change logs are ordered by newest (creation date in descending order) by default, when no order parameter is provided. Example: createdAt:descfield is case-sensitive. Valid sortDirection values are asc and desc. sortDirection is case-insensitive and defaults to asc for fields without explicit sortDirection. Supported fields are createdAt, change and username, only one at a time. |
| filter | Chaîne | Colon-separated field name with the eq operator and value in the format field:eq:value.Example: dataElement:eq:w75KJ2mc4zzFiltering is supported for field, dataElement and username fields, one at a time. Only the eq (equals) operator is supported. |
An example of a JSON response:
{
"pager":{
"page":1,
"pageSize":10
},
"changeLogs":[
{
"createdBy":{
"uid":"AIK2aQOJIbj",
"username":"tracker",
"firstName":"Tracker demo",
"surname":"User"
},
"createdAt":"2024-06-20T15:43:36.342",
"type":"DELETE",
"change":{
"dataValue":{
"dataElement":"UXz7xuGCEhU",
"previousValue":"12"
}
}
},
{
"createdBy":{
"uid":"AIK2aQOJIbj",
"username":"tracker",
"firstName":"Tracker demo",
"surname":"User"
},
"createdAt":"2024-06-20T15:43:27.175",
"type":"CREATE",
"change":{
"dataValue":{
"dataElement":"UXz7xuGCEhU",
"currentValue":"12"
}
}
},
{
"createdBy":{
"uid":"AIK2aQOJIbj",
"username":"tracker",
"firstName":"Tracker demo",
"surname":"User"
},
"createdAt":"2024-06-20T14:51:16.433",
"type":"UPDATE",
"change":{
"dataValue":{
"dataElement":"bx6fsa0t90x",
"previousValue":"true",
"currentValue":"false"
}
}
}
]
}
The change log type can be CREATE, UPDATE, or DELETE. CREATE and DELETE will always hold a single value: the former shows the current value, and the latter shows the value that was deleted. UPDATE will hold two values: the previous and the current.
More on change log configuration here
GET /api/tracker/relationships
Les relations sont des liens entre deux entités dans le Tracker. Ces entités peuvent être des entités suivies, des inscriptions et des événements.
Le but de ce point d'extrémité est de récupérer les relations entre les objets.
Contrairement aux autres points d'extrémité d'objets suivis, les relations n'exposent qu'un seul point d'extrémité :
GET /api/tracker/relationships?[trackedEntity={trackedEntityUid}|enrollment={enrollmentUid}|event={eventUid}]&fields=[fields]
| Paramètre de requête | Type | Valeurs autorisées | Description |
|---|---|---|---|
| trackedEntity | Chaîne | uid | Identifiant d'une entité suivie |
| enrollment | Chaîne | uid | Identifiant d'une inscription |
| event | Chaîne | uid | Identifiant d'un événement |
| champs | Chaîne | Tout filtre de champ valide (par défaut relationship,relationshipType,createdAtClient,from[trackedEntity[trackedEntity],enrollment[enrollment],event[event]],to[trackedEntity[trackedEntity],enrollment[enrollment],event[event]]) | Inclut les sous-objets spécifiés dans la réponse |
| order | Chaîne | Liste séparée par des virgules de paires de noms de propriétés, d'attributs ou d'UID et de directions de tri au format propName:sortDirection. | Champs pris en charge : createdAt, createdAtClient. |
| includeDeleted | Booléen | true, false | détermine s'il faut inclure dans le résultat de votre requête, des éléments supprimés mais pas définitivement |
Les règles suivantes s'appliquent aux paramètres de requête.
Only one parameter among trackedEntity, enrollment, event can be passed.
Note
Using
trackedEntity,enrollmentoreventparams, will return any relationship where the trackedEntity, enrollment or event is part of the relationship (either from or to). As long as the user has access to it.
{
"pager": {
"page": 1,
"pageSize": 2
},
"relationships": [
{
"relationship": "oGtgtJpp6fG",
"relationshipType": "Mv8R4MPcNcX",
"from": {
"trackedEntity": {
"trackedEntity": "neR4cmMY22o"
}
},
"to": {
"trackedEntity": {
"trackedEntity": "DsSlC54GNXy"
}
}
},
{
"relationship": "SSfIicJKbh5",
"relationshipType": "Mv8R4MPcNcX",
"from": {
"trackedEntity": {
"trackedEntity": "neR4cmMY22o"
}
},
"to": {
"trackedEntity": {
"trackedEntity": "rEYUGH97Ssd"
}
}
}
]
}
Le Tracker dispose de quelques concepts en ce qui concerne le contrôle d'accès, tels que le partage, les champs d'application des unités d'organisation, la propriété et les niveaux d'accès. Les sections suivantes fournissent une brève introduction aux différents sujets.
Le paramètre de partage est une fonctionnalité standard de DHIS2 qui s'applique aux métadonnées/données du Tracker et de l'Agrégé, ainsi qu'aux tableaux de bord et aux éléments de visualisation. Au cœur du partage se trouve la possibilité de définir qui peut voir/faire quoi. En général, il existe cinq configurations de partage possibles : aucun accès, lecture des métadonnées, écriture des métadonnées, lecture des données et écriture des données. Ces configurations d'accès peuvent être accordées au niveau de l'utilisateur et/ou du groupe d'utilisateurs (pour plus de flexibilité). En ce qui concerne le Tracker, les métadonnées suivantes et leur configuration de partage sont d'une importance particulière : Élément de données, option de catégorie, programme, étape de programme, type d'entité suivie, attribut d'entité suivie, ainsi que les tableaux de bord et les éléments de tableau de bord liés au Tracker.
Sharing settings are enforced during Tracker data import/export. Data read/write access is needed to read and write respectively. Similarly, if a user is expected to modify metadata, it is essential to grant metadata write access.
One critical point with Tracker data is the need to have a holistic approach. For example, a user won’t be able to see the Data Element value by having read access to just the Data Element. The user needs to have data read to access the parent Program Stage and Program where this Data Element belongs. This works the same way as for category option combinations. In Tracker, events and enrollments are associated with an AttributeOptionCombo, which is composed of multiple Category Options. To read an event or enrollment, a user must have data read access to all Category Options and their corresponding Categories that make up the AttributeOptionCombo of that object. If the user lacks access to even one of the required Category Options or Categories, they will not have access to the entire event or enrollment..
Lorsqu'il s'agit d'accéder aux données d'inscription, il est essentiel d'avoir d'abord accès à l'entité suivie. L'accès à une entité suivie est contrôlé par le partage des paramètres du programme, du type d'entité suivie et de l'attribut d'entité suivie. Une fois que l'on a accédé à l'inscription, il est possible d'accéder aux données d'événement, là encore en fonction de l'étape du programme et des paramètres de partage des éléments de données.
Un autre point essentiel à prendre en considération est la manière de définir l'accès aux différentes étapes d'un programme. Il peut arriver que nous devions accorder l'accès à une étape spécifique - par exemple, « Résultat de laboratoire » - à un groupe d'utilisateurs spécifique (techniciens de laboratoire). Dans ce cas, nous pouvons accorder un accès en écriture aux données de l'étape « Résultat du laboratoire », probablement un accès en lecture à une ou plusieurs étapes au cas où nous voudrions que les techniciens de laboratoire lisent d'autres résultats médicaux, ou aucun accès si nous pensons qu'il n'est pas nécessaire qu'ils consultent des données autres que celles relatives au laboratoire.
En résumé, DHIS2 dispose d'un paramètre de partage très précis que nous pouvons utiliser pour implémenter les mécanismes de contrôle d'accès au niveau des données et des métadonnées. Ces paramètres de partage peuvent être appliqués directement au niveau de l'utilisateur ou du groupe d'utilisateurs. Le paramètre de partage à appliquer dépend du cas d'utilisation.
Organisation units are one of the most fundamental objects in DHIS2. They define a universe under which a user is allowed to record and/or read data. There are three types of organisation units that can be assigned to a user. These are data capture, data view (not used in tracker), and tracker search. As the name implies, these organisation units define a scope under which a user is allowed to conduct the respective operations. A user can search for data in their search scope and capture scope organisation units.
Cependant, pour mieux affiner le champ d'application, DHIS2 Tracker introduit un concept que nous appelons OrganisationUnitSelectionMode (mode de sélection de l'unité d'organisation). Ce mode est souvent utilisé lors de l'exportation d'objets Tracker. Par exemple, si un utilisateur dispose d'un champ de recherche particulier, cela signifie-t-il que nous devons utiliser ce champ chaque fois que l'utilisateur tente de rechercher un objet Tracker, d'inscription ou d'événement ? Ou bien l'utilisateur souhaite-t-il limiter la recherche à l'unité d'organisation sélectionnée, ou à l'ensemble de l'unité d'organisation de saisie, etc.
Les utilisateurs peuvent affiner un champ d'application en transmettant une valeur spécifique de orgUnitMode (mode d'unité d'organisation) dans leur requête API:
/api/tracker/trackedEntities?orgUnit=UID&orgUnitMode=specific_organisation_unit_selection_mode
Actuellement, six modes de sélection sont disponibles: SÉLECTIONNÉ, SUBORDONNÉES, DESCENDANTS, SAISIE, ACCESSIBLE et TOUS.
| Mode | Description |
|---|---|
| SELECTED | Specified organisation units. |
| CHILDREN | Specified organisation unit including immediate children, i.e. organisation units at the immediate level below. |
| DESCENDANTS | Specified organisation unit and all organisation units in the sub-hierarchy, i.e. at all organisation unit levels in the sub-hierarchy below the specified organisation units. |
| CAPTURE | The data capture organisation units associated with the current user and all organisation units in the sub-hierarchy. |
| ACCESSIBLE | The tracker search organisation units associated with the current user and all organisation units in the sub-hierarchy. This includes everything visible to the user, including open and audited programs within its search scope, as well as data in protected and closed programs within the user's capture scope. If a user lacks search organisation units, the system defaults to capture scope, ensuring that the user always has access to at least one universe. The capture scope, being mandatory, serves as a foundational element in guaranteeing a data environment for the user. |
| ALL | All organisation units in the system. This mode is reserved for authorized users, specifically those with the authority ALL (super users). Users with the authority F_TRACKED_ENTITY_INSTANCE_SEARCH_IN_ALL_ORGUNITS can also search system-wide but need sharing access to the returned program, program stage, and/or tracked entity type. Non-authorized users are not permitted to search using this scope. |
The first three modes, SELECTED, CHILDREN and DESCENDANTS, expect an organisation unit to be supplied in the request, while the last three, CAPTURE, ACCESSIBLE and ALL do not.
The organisation unit mode will be one of the ones listed above when it is explicitly provided in the API request. Since it is not a mandatory paramter, when not specified, the default value will be SELECTED if an organisation unit is present, and ACCESSIBLE if not.
Il n'est pas judicieux de transmettre ces modes lors des opérations d'importation du Tracker. En effet, lors de l'écriture des données Tracker, chaque objet doit être rattaché à une unité d'organisation spécifique. Le système vérifiera alors si chacune des unités d'organisation mentionnées relève du champ d'application de la SAISIE. Si ce n'est pas le cas, le système rejettera simplement l'opération d'écriture.
Note that there are four type of organisation unit associations relevant for tracker objects. A Tracked Entity has an organisation unit, commonly referred to as the Registration Organisation unit. Enrollments have an organisation unit associated with them. Events also have an organisation unit associated with them. There is also an Owner organisation unit for a tracker program combination.
Lors de la récupération des objets Tracker, selon le contexte, le champ d'application de l'unité d'organisation est appliquée à l'une des quatre associations d'unités d'organisation ci-dessus.
For example, when retrieving Tracked Entities without the context of a program, the organisation unit scope is applied to the registration organisation unit of the Tracked Entity. Whereas, when retrieving Tracked Entities, including specific program data, the organisation unit scope is applied to the owner organisation unit.
Tracker Ownership, introduced in DHIS2 2.30, defines an organisation unit association for a TrackedEntity - Program combination. We call this the Owner (or Owning) Organisation unit of a TrackedEntity in the context of a Program. The Owner organisation unit is used to decide access privileges when reading and writing tracker data related to a program. This, along with the Program's Access Level configuration, decides the access behavior for Program-related data (Enrollments and Events). A user can access a TrackedEntity's Program data if the corresponding Owner OrganisationUnit for that TrackedEntity-Program combination falls under the user's organisation unit scope (Search/Capture). For Programs that are configured with access level OPEN or AUDITED , the Owner OrganisationUnit has to be in the user's search scope. For Programs that are configured with access level PROTECTED or CLOSED , the Owner OrganisationUnit has to be in the user's capture scope to be able to access the corresponding program data for the specific tracked entity. Irrespective of the program access level, to access Tracker objects, the requested organisation unit must always be within either the user's search scope or capture scope. A user cannot request objects outside these two scopes unless they are using the organisation unit mode ALL and have sufficient privileges to use that mode.
When requesting tracked entities without specifying a program, the response will include only tracked entities that satisfy metadata sharing settings and one of the following criteria:
It is possible to temporarily override the ownership privilege for a program that is configured with an access level of PROTECTED. Any user with the org unit owner within their search scope, can temporarily access the program-related data by providing a reason for accessing it.
This act of temporarily gaining access is termed breaking the glass. Currently, temporary access is granted for 3 hours. DHIS2 audit breaking the glass along with the reason specified by the user. This information is also stored in the database, but only if the tracked entity type is configured to allow auditing, which is disabled by default.
It is not possible to gain temporary access to a program that has been configured with an access level of CLOSED.
To break the glass for a TrackedEntity-Program combination, the following POST request can be used:
/api/tracker/ownership/override?trackedEntity=DiszpKrYNg8&program=eBAyeGv0exc&reason=patient+showed+up+for+emergency+care
Il est possible de transférer la propriété d'une combinaison Entité suivie - Programme d'une unité d'organisation à une autre. Cela peut s'avérer utile en cas de transfert de patients ou de migration. Seul un utilisateur disposant d'un accès à la propriété (ou d'un accès temporaire en brisant la glace) peut transférer la propriété. Pour transférer la propriété d'une combinaison Entité suivie - Programme à une autre unité d'organisation, la requête "PUT" suivante peut être utilisée :
/api/tracker/ownership/transfer?trackedEntity=DiszpKrYNg8&program=eBAyeGv0exc&ou=EJNxP3WreNP
Tracker data is handled with an extra level of protection. In addition to the standard feature of metadata and data protection through sharing settings, Tracker data are shielded with additional access level protection mechanisms. Currently, there are four access levels that can be configured for a Program: Open, Audited, Protected, and Closed.
Ces niveaux d'accès ne sont déclenchés que lorsque les utilisateurs tentent d'interagir avec les données du programme, c'est-à-dire les données relatives aux inscriptions et aux événements. La configuration des différents niveaux d'accès du programme correspond à un degré d'ouverture (ou de fermeture) des données du programme. Notez que tous les autres paramètres de partage sont toujours respectés et que le niveau d'accès n'est qu'une couche supplémentaire de contrôle d'accès. Voici une brève description des quatre niveaux d'accès qui peuvent être configurés pour un programme.
Ce niveau d'accès est le moins restrictif des niveaux d'accès. Les utilisateurs peuvent accéder aux données d'un programme OUVERT et les modifier si l'unité d'organisation propriétaire fait partie du champ de recherche de l'utilisateur. Avec ce niveau d'accès, il est possible d'accéder à des données qui se trouvent hors du champ de saisie et de les modifier sans justification ni conséquence.
Il s'agit du même niveau d'accès que le niveau Ouvert. La différence est que le système ajoutera automatiquement une entrée dans le journal d'audit sur les données auxquelles l'utilisateur accède.
This access level is slightly more restricted. Data inside a PROTECTED program can only be accessed by users if the Owner organisation unit falls under the user's capture scope. However, a user who only has the Owner organisation unit in the search scope can gain temporary ownership by breaking the glass. The user has to provide a justification of why they are accessing the data at hand. The system will then put a log of both the justification and access audit and provide temporary access for 3 hours to the user. Note that when breaking the glass, the Owner Organisation Unit remains unchanged, and only the user who has broken the glass gains temporary access.
This is the most restricted access level. Data recorded under programs configured with access level CLOSED will not be accessible if the Owner Organisation Unit does not fall within the user's capture scope. It is also not possible to break the glass or gain temporary ownership in this configuration. Note that it is still possible to transfer the ownership to another organisation unit. Only a user who has access to the data can transfer the ownership of a TrackedEntity-Program combination to another Organisation Unit. If ownership is transferred, the Owner Organisation Unit is updated. trackedEntities
Working lists allow users to efficiently organize their workflow by saving filters and sorting preferences for tracked entities, enrollments, and events. Each type of working list—tracked entities, enrollments, and events—has a dedicated API for management.
Working lists are metadata, making them shareable and subject to the same sharing patterns as other metadata. When using the /api/sharing endpoint, the type parameter should be set to the name of the working list API. For example, use trackedEntityInstanceFilter for tracked entity working lists.
Since working lists are metadata refer to metadata on how to create, update and delete metadata. The following sections describe the payloads of each of the working lists endpoints.
Create, update and delete tracked entity working lists using
/api/trackedEntityInstanceFilters
Tableau : Charge
| Propriété | Description | Exemple |
|---|---|---|
| name | Nom de la liste de tâches. Obligatoire. | |
| description | Il s'agit d'une description de la liste de tâches. | |
| sortOrder | The sort order of the working list. | |
| style | Objet contenant un style css. | {"color": "blue", "icon": "fa fa-calendar"} |
| program | Objet contenant l'identifiant du programme. Obligatoire. | { "id" : "uy2gU8kTjF"} |
| entityQueryCriteria | An object representing various possible filtering values. | See Entity Query Criteria definition table below. |
| eventFilters | Une liste de filtres d'événements. Voir le tableau de définition des filtres d'événements ci-dessous. | [{"programStage": "eaDH9089uMp", "eventStatus": "OVERDUE", "eventCreatedPeriod": {"periodFrom": -15, "periodTo": 15}}] |
| Propriété | Description | Exemple |
|---|---|---|
| attributeValueFilters | A list of attributeValueFilters. This is used to specify filters for attribute values when listing tracked entities | "attributeValueFilters":[{"attribute": "abcAttributeUid","le": "20","ge": "10","lt": "20","gt": "10","in": ["India", "Norway"],"like": "abc","sw": "abc","ew": "abc","dateFilter": {"startDate": "2014-05-01","endDate": "2019-03-20","startBuffer": -5,"endBuffer": 5,"period": "LAST_WEEK","type": "RELATIVE"}}] |
| enrollmentStatus | The tracked entities enrollment status. Can be none(any enrollmentstatus) or ACTIVE, COMPLETED, CANCELLED | |
| followUp | When this parameter is true, the working list only returns tracked entities that have an enrollment with followUp=true. | |
| organisationUnit | Permet de spécifier l'identifiant de l'unité d'organisation | {"organisationUnit": "a3kGcGDCuk7"} |
| ouMode | To specify the organisation unit selection mode. Options are SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE, ALL | "ouMode": "SELECTED" |
| assignedUserMode | To specify the assigned user selection mode for events. Options are CURRENT, PROVIDED, NONE, ANY. See table below to understand what each value indicates. If PROVIDED (or null), non-empty assignedUsers in the payload will be considered. | "assignedUserMode": "PROVIDED" |
| assignedUser | To specify a list of assigned users for events. To be used along with PROVIDED assignedUserMode above. | "assignedUsers": ["a3kGcGDCuk7", "a3kGcGDCuk8"] |
| displayColumnOrder | Permet de spécifier l'ordre de sortie des colonnes | "displayOrderColumns": ["enrollmentDate", "program"] |
| order | To specify ordering/sorting of fields and its directions in comma separated values. A single item in order is of the form "orderDimension:direction". Note: Supported orderDimensions are trackedEntity, created, createdAt, createdAtClient, updatedAt, updatedAtClient, enrolledAt, inactive and the tracked entity attributes | "order":"a3kGcGDCuk6:desc" |
| programStage | To specify a programStage uid to filter on. tracked entities will be filtered based on presence of enrollment in the specified program stage. | "programStage":"a3kGcGDCuk6" |
| TrackedEntityType | To specify a trackedEntityType filter tracked entities on. | {"trackedEntityType":"a3kGcGDCuk6"} |
| trackedEntities | To specify a list of tracked entities to use when querying tracked entities. | "trackedEntities":["a3kGcGDCuk6","b4jGcGDCuk7"] |
| enrollmentCreatedDate | DateFilterPeriod object date filtering based on enrollment created date. | "enrollmentCreatedDate": { "period": "LAST_WEEK", "type": "RELATIVE" } |
| enrollmentIncidentDate | DateFilterPeriod object date filtering based on enrollment incident date. | "enrollmentIncidentDate": { "startDate": "2014-05-01", "endDate": "2019-03-20", "startBuffer": -5, "endBuffer": 5, "period": "LAST_WEEK", "type": "RELATIVE" } |
| eventStatus | The event status. Options are ACTIVE, COMPLETED, VISITED, SCHEDULE, OVERDUE, SKIPPED and VISITED | "status":"VISITED" |
| eventDate | DateFilterPeriod object date filtering based on event date. | "eventDate": {"startBuffer": -5,"endBuffer": 5, "type": "RELATIVE" } |
| lastUpdatedDate | DateFilterPeriod object date filtering based on last updated date. | "lastUpdatedDate": {"startDate": "2014-05-01", "endDate": "2019-03-20", "type": "ABSOLUTE" } |
Tableau : Définition des filtres d'événements
| Propriété | Description | Exemple |
|---|---|---|
| programStage | Which programStage the tracked entity needs an event in to be returned. | "eaDH9089uMp" |
| eventStatus | The events status. Can be none(any event status) or ACTIVE, COMPLETED, SCHEDULE, OVERDUE | ACTIVE |
| eventCreatedPeriod | FilterPeriod object containing a period in which the event must be created. See Period definition below. | { "periodFrom": -15, "periodTo": 15} |
| assignedUserMode | To specify the assigned user selection mode for events. Options are CURRENT (events assigned to current user), PROVIDED (events assigned to users provided in "assignedUsers" list), NONE (events assigned to no one) , ANY (events assigned to anyone). If PROVIDED (or null), non-empty assignedUsers in the payload will be considered. | "assignedUserMode": "PROVIDED" |
| assignedUser | To specify a list of assigned users for events. To be used along with PROVIDED assignedUserMode above. | "assignedUsers": ["a3kGcGDCuk7", "a3kGcGDCuk8"] |
| Propriété | Description | Exemple |
|---|---|---|
| periodFrom | Nombre de jours à partir du jour actuel. Il peut s'agir d'un nombre entier positif ou négatif. | -15 |
| periodTo | Nombre de jours à partir du jour actuel. Doit être supérieur à periodFrom. Peut être un nombre entier positif ou négatif. | 15 |
Tableau : Paramètres de requête pour les filtres d'instances d'entités suivies
| Paramètre de requête | Description |
|---|---|
| program | Identifiant du programme. Il limite le filtrage au programme donné. |
Create, update and delete program stage working lists using
/api/programStageWorkingLists
Tableau : Charge
| Valeurs de la charge | Description | Exemple |
|---|---|---|
| name | Nom de la liste de tâches. Obligatoire. | |
| description | Il s'agit d'une description de la liste de tâches. | |
| program | Objet contenant l'identifiant du programme. Obligatoire. | {"id" : "uy2gU8kTjF"} |
| programStage | Objet contenant l'identifiant de l'étape de programme. Obligatoire. | {"id" : "oRySG82BKE6"} |
| programStageQueryCriteria (Critères de requête de l'étape de programme) | An object representing various possible filtering values. | See Program Stage Query Criteria definition table below. |
Tableau : Critères de requête de l'étape de programme
| Valeurs des critères | Description | Exemple |
|---|---|---|
| eventStatus | The event status. Options are ACTIVE, COMPLETED, VISITED, SCHEDULE, OVERDUE, SKIPPED and VISITED | "status":"VISITED" |
| Évènement créé à | DateFilterPeriod object filtering based on the event creation date. | {"type":"ABSOLUTE","startDate":"2020-03-01","endDate":"2022-12-30"} |
| eventOccurredAt | DateFilterPeriod object filtering based on the event occurred date. | {"type":"RELATIVE","period":"TODAY"} |
| eventScheduledAt | DateFilterPeriod object filtering based on the event scheduled date. | {"type":"RELATIVE","period":"TODAY"} |
| enrollmentStatus | Any valid EnrollmentStatus. Options are ACTIVE, COMPLETED and CANCELLED. | "enrollmentStatus": "COMPLETED" |
| followUp | Indique s'il faut filtrer ou non les inscriptions marquées pour le suivi | "followUp":true |
| inscrit à | DateFilterPeriod object filtering based on the event enrollment date. | "enrolledAt": {"type":"RELATIVE","period":"THIS_MONTH"} |
| Inscription effectué à | DateFilterPeriod object filtering based on the event occurred date. | {"type":"RELATIVE","period":"THIS_MONTH"} |
| orgUnit | Un UID d'unité d'organisation valide | "orgUnit": "Rp268JB6Ne4" |
| ouMode | Un mode de sélection d'unités d'organisation valide | "ouMode": "SELECTED" |
| assignedUserMode | A valid user selection mode for events. Options are CURRENT, PROVIDED, NONE, ANY and ALL. If PROVIDED (or null), non-empty assignedUsers in the payload will be expected. | "Mode d'utilisateur assigné" : "FOURNI" |
| assignedUser | A list of assigned users for events. To be used along with PROVIDED assignedUserMode above. | "Utilisateurs assignés":["DXyJmlo9rge"] |
| order | Liste des champs et de leurs directions en valeurs séparées par des virgules, les résultats seront triés en fonction de cette liste. Un seul élément dans l'ordre est de la forme « orderDimension:direction ». | "ordre": "w75KJ2mc4zz:asc" |
| displayColumnOrder | Ordre de sortie des colonnes | "Ordre de sortie des colonnes":["w75KJ2mc4zz","zDhUuAYrxNC"] |
| dataFilters | Une liste d'éléments contenant les filtres à utiliser lors de requêtes d'événements | "Filtres de données":[{"dataItem": "GXNUsigphqK","ge": "10","le": "20"}] |
| attributeValueFilters | Une liste de filtres de valeurs d'attribut. Elle est utilisée pour définir des filtres pour les valeurs d'attributs lors de l'établissement de la liste des entités suivies. | "Filtres de valeurs d'attribut":[{"attribute": "ruQQnf6rswq","eq": "15"}] |
See an example payload below.
{
"name": "Test WL",
"description": "Test WL definition",
"program": {
"id": "uy2gU8kT1jF"
},
"programStage": {
"id": "oRySG82BKE6"
},
"programStageQueryCriteria": {
"eventStatus": "VISITED",
"eventCreatedAt": {
"type": "ABSOLUTE",
"startDate": "2020-03-01",
"endDate": "2022-12-30"
},
"eventScheduledAt": {
"type": "RELATIVE",
"period": "TODAY"
},
"enrollmentStatus": "COMPLETED",
"followUp": true,
"enrolledAt": {
"type": "RELATIVE",
"period": "THIS_MONTH"
},
"enrollmentOccurredAt": {
"type": "RELATIVE",
"period": "THIS_MONTH"
},
"orgUnit": "Rp268JB6Ne4",
"ouMode": "SELECTED",
"assignedUserMode": "PROVIDED",
"assignedUsers": [
"DXyJmlo9rge"
],
"order": "w75KJ2mc4zz:asc",
"displayColumnOrder": [
"w75KJ2mc4zz",
"zDhUuAYrxNC"
],
"dataFilters": [
{
"dataItem": "GXNUsigphqK",
"ge": "10",
"le": "20"
}
],
"attributeValueFilters": [
{
"attribute": "ruQQnf6rswq",
"eq": "15"
}
]
}
}
Create, update and delete event working lists using the following endpoint.
/api/eventFilters
Tableau : Charge
| Propriété | Description | Exemple |
|---|---|---|
| name | Name of the working list. | "name":"My working list" |
| description | Il s'agit d'une description de la liste de tâches. | "description":"for listing all events assigned to me". |
| program | L'uid du programme. | "program" : "a3kGcGDCuk6" |
| programStage | L'uid de l'étape de programme. | "programStage" : "a3kGcGDCuk6" |
| eventQueryCriteria | Objet contenant des paramètres pour les requêtes, le tri et le filtrage des événements. | "eventQueryCriteria": { "organisationUnit":"a3kGcGDCuk6", "status": "COMPLETED", "createdDate": { "from": "2014-05-01", "to": "2019-03-20" }, "dataElements": ["a3kGcGDCuk6:EQ:1", "a3kGcGDCuk6"], "filters": ["a3kGcGDCuk6:EQ:1"], "programStatus": "ACTIVE", "ouMode": "SELECTED", "assignedUserMode": "PROVIDED", "assignedUsers" : ["a3kGcGDCuk7", "a3kGcGDCuk8"], "followUp": false, "events": ["a3kGcGDCuk7", "a3kGcGDCuk8"], "fields": "eventDate,dueDate", "order": "dueDate:asc,createdDate:desc" } |
| Propriété | Description | Exemple |
|---|---|---|
| followUp | Used to filter events based on enrollment followUp flag. Options are true, false. | "followUp": true |
| organisationUnit | Permet de spécifier l'identifiant de l'unité d'organisation | "organisationUnit": "a3kGcGDCuk7" |
| ouMode | To specify the OU selection mode. Options are SELECTED, CHILDREN, DESCENDANTS, ACCESSIBLE, CAPTURE, ALL | "ouMode": "SELECTED" |
| assignedUserMode | To specify the assigned user selection mode for events. Options are CURRENT, PROVIDED, NONE, ANY. See table below to understand what each value indicates. If PROVIDED (or null), non-empty assignedUsers in the payload will be considered. | "assignedUserMode": PROVIDED |
| assignedUser | Permet de spécifier une liste d'utilisateurs assignés à des événements. À utiliser avec le mode d'utilisateur assigné PROVIDED ci-dessus. | "assignedUsers": ["a3kGcGDCuk7", "a3kGcGDCuk8"] |
| displayColumnOrder | Permet de spécifier l'ordre de sortie des colonnes | "displayOrderColumns": ["eventDate", "dueDate", "program"] |
| order | To specify ordering/sorting of fields and its directions in comma separated values. A single item in order is of the form "dataItem:direction". | "order"="a3kGcGDCuk6:desc,eventDate:asc" |
| dataFilters | Permet de spécifier les filtres à appliquer lors de l'établissement de la liste des événements | "dataFilters"=[{ "dataItem": "abcDataElementUid", "le": "20", "ge": "10", "lt": "20", "gt": "10", "in": ["India", "Norway"], "like": "abc", "dateFilter": { "startDate": "2014-05-01", "endDate": "2019-03-20", "startBuffer": -5, "endBuffer": 5, "period": "LAST_WEEK", "type": "RELATIVE" } }] |
| status | Tout statut d'événement valide | "eventStatus": "COMPLETED" |
| events | permet de spécifier une liste d'événements | "events"=["a3kGcGDCuk6"] |
| completedDate | DateFilterPeriod object date filtering based on completed date. | "completedDate": { "startDate": "2014-05-01", "endDate": "2019-03-20", "startBuffer": -5, "endBuffer": 5, "period": "LAST_WEEK", "type": "RELATIVE" } |
| eventDate | DateFilterPeriod object date filtering based on event date. | "eventDate": { "startBuffer": -5, "endBuffer": 5, "type": "RELATIVE" } |
| dueDate | DateFilterPeriod object date filtering based on due date. | "dueDate": { "period": "LAST_WEEK", "type": "RELATIVE" } |
| lastUpdatedDate | DateFilterPeriod object date filtering based on last updated date. | "lastUpdatedDate": { "startDate": "2014-05-01", "endDate": "2019-03-20", "type": "ABSOLUTE" } |
See an example payload below.
{
"name": "event working list",
"program": "VBqh0ynB2wv",
"eventQueryCriteria": {
"eventDate": {
"period": "LAST_WEEK",
"type": "RELATIVE"
},
"dataFilters": [
{
"ge": "35",
"le": "70",
"dataItem": "qrur9Dvnyt5"
}
],
"assignedUserMode": "PROVIDED",
"assignedUsers": [
"CotVI2NX0rI",
"xE7jOejl9FI"
],
"status": "ACTIVE",
"order": "occurredAt:desc",
"displayColumnOrder": [
"occurredAt",
"status",
"assignedUser",
"qrur9Dvnyt5",
"oZg33kd9taw"
]
}
}
Tableau : Définition de l'objet DateFilterPeriod
| Propriété | Description | Exemple |
|---|---|---|
| type | Specify whether the date period type is ABSOLUTE, RELATIVE | "type" : "RELATIVE" |
| period | Specify if a relative system defined period is to be used. Applicable only when type is RELATIVE. (see Relative Periods for supported relative periods) | "period" : "THIS_WEEK" |
| startDate | Absolute start date. Applicable only when type is ABSOLUTE | "startDate":"2014-05-01" |
| endDate | Absolute end date. Applicable only when type is ABSOLUTE | "startDate":"2014-05-01" |
| startBuffer | Relative custom start date. Applicable only when type is RELATIVE | "startBuffer":-10 |
| endBuffer | Relative custom end date. Applicable only when type is RELATIVE | "startDate":+10 |
Potential duplicates are records identified by the data deduplication feature as possibly being duplicates. Due to the nature of this feature, the API endpoint has certain restrictions. A potential duplicate represents a pair of records suspected to be duplicates.
To retrieve a list of potential duplicates, use the following endpoint:
GET /api/potentialDuplicates
The response payload for a potential duplicate looks like this.
{
"created": "2024-06-04T10:11:29.110",
"lastUpdated": "2024-06-04T10:11:29.110",
"original": "<UID>",
"duplicate": "<UID>",
"status": "OPEN|INVALID|MERGED",
"id": "<id>"
}
These are the parameters this endpoint accepts:
| Paramètre de requête | Description | Type | Valeurs autorisées |
|---|---|---|---|
| trackedEntities | List of tracked entities | Liste de chaînes (séparées par une virgule) | existing tracked entity UIDs |
| status | Statut de doublon potentiel | chaîne | OPEN, INVALID, MERGED, ALL |
To inspect individual potential duplicate records, use the following endpoint:
GET /api/potentialDuplicates/<{id}
To create a new potential duplicate, use this endpoint:
POST /api/potentialDuplicates
The payload you provide must include the UIDs of the original and duplicate tracked entities. New potential duplicates are open by default.
{
"original": "<UID>",
"duplicate": "<UID>"
}
| Code de statut | Description |
|---|---|
| 400 | Input original or duplicate is null or has invalid uid |
| 403 | User do not have access to read original or duplicate TEs |
| 404 | TE not found |
| 409 | Pair of original and duplicate TEs already existing |
To update the status of a potential duplicate, use the following endpoint:
PUT /api/potentialDuplicates/<id>
| Paramètre de requête | Description | Type | Valeurs autorisées |
|---|---|---|---|
| status | Statut de doublon potentiel | chaîne | OPEN, INVALID |
| Code de statut | Description |
|---|---|
| 400 | Vous ne pouvez pas mettre à jour un doublon potentiel en le faisant passer à MERGED. Pour ce faire, vous devez effectuer une requête de fusion. |
| 400 | Vous ne pouvez pas mettre à jour un doublon potentiel qui a déjà le statut MERGED. |
Tracked entities can be merged together if they are deemed viable. To initiate a merge, the first step is to define two tracked entities as a Potential Duplicate. The merge endpoint moves data from the duplicate tracked entity to the original tracked entity and deletes the remaining data of the duplicate.
To merge a Potential Duplicate, i.e. the two tracked entities the Potential Duplicate represents, use the following endpoint:
POST /api/potentialDuplicates/<id>/merge
| Paramètre de requête | Description | Type | Valeurs autorisées |
|---|---|---|---|
| mergeStrategy | Stratégie à utiliser pour fusionner le doublon potentiel | chaîne | AUTO (par défaut) ou MANUAL |
The endpoint accepts a single parameter, mergeStrategy, which determines the strategy used when merging. For the AUTO strategy, the server will attempt to merge the two tracked entities automatically without user input. This strategy only allows merging tracked entities without conflicting data (see examples below). The MANUAL strategy requires the user to send in a payload describing how the merge should be done. For examples and rules for each strategy, see their respective sections below.
The automatic merge evaluates the mergability of the two tracked entities and merges them if they are deemed mergeable. The mergability is based on whether the two tracked entities have any conflicts. Conflicts refer to data that cannot be merged automatically. Examples of possible conflicts include:
If any conflict is encountered, an error message is returned to the user.
When no conflicts are found, all data in the duplicate that is not already in the original will be moved to the original. This includes attribute values, enrollments (including events), and relationships. After the merge completes, the duplicate is deleted and the Potential Duplicate is marked as MERGED. When requesting an automatic merge, a payload is not required and will be ignored.
The manual merge is suitable when there are resolvable conflicts or when not all the data needs to be moved during the merge. For example, if an attribute has different values in both tracked entities , the user can specify whether to keep the original value or move over the duplicate's value. Since the manual merge involves the user explicitly requesting to move data, there are some additional checks:
Il existe deux façons d'effectuer une fusion manuelle : Avec et sans charge.
When a manual merge is requested without a payload, we are telling the API to merge the two tracked entities without moving any data. In other words, we are just removing the duplicate and marking the potentialDuplicate MERGED. This might be valid in a lot of cases where the tracked entity was just created, but not enrolled for example.
Otherwise, if a manual merge is requested with a payload, the payload refers to what data should be moved from the duplicate to the original. The payload looks like this:
{
"trackedEntityAttributes": ["B58KFJ45L9D"],
"enrollments": ["F61SJ2DhINO"],
"relationships": ["ETkkZVSNSVw"]
}
This payload contains three lists, one for each of the types of data that can be moved. trackedEntityAttributes is a list of uids for tracked entity attributes, enrollments is a list of uids for enrollments and relationships a list of uids for relationships. The uids in this payload have to refer to data that actually exists on the duplicate. There is no way to add new data or change data using the merge endpoint - Only moving data.
Currently it is not possible to merge tracked entities that are enrolled in the same program, due to the added complexity. A workaround is to manually remove the enrollments from one of the tracked entities before starting the merge.
All merging is based on data already persisted in the database, which means the current merging service is not validating that data again. This means if data was already invalid, it will not be reported during the merge. The only validation done in the service relates to relationships, as mentioned in the previous section.
The Program Notification Template allows you to create message templates that can be sent based on different types of events. The message and subject templates are translated into actual values and sent to the configured destination. Each program notification template is transformed into either a MessageConversation object or a ProgramMessage object, depending on whether the recipient is external or internal. These intermediate objects will contain only the translated message and subject text.
There are several configuration parameters in the Program Notification Template that are essential for the proper functioning of notifications. These parameters are explained in the table below.
POST /api/programNotificationTemplates
{
"name": "Case notification",
"notificationTrigger": "ENROLLMENT",
"subjectTemplate": "Case notification V{org_unit_name}",
"displaySubjectTemplate": "Case notification V{org_unit_name}",
"notifyUsersInHierarchyOnly": false,
"sendRepeatable": false,
"notificationRecipient": "ORGANISATION_UNIT_CONTACT",
"notifyParentOrganisationUnitOnly": false,
"displayMessageTemplate": "Case notification A{h5FuguPFF2j}",
"messageTemplate": "Case notification A{h5FuguPFF2j}",
"deliveryChannels": [
"EMAIL"
]
}
| Champ | Obligatoire | Description | Valeurs |
|---|---|---|---|
| name | Oui | Name of the Program Notification Template | case-notification-alert |
| notificationTrigger | Oui | When notification should be triggered. Options are ENROLLMENT, COMPLETION, PROGRAM_RULE, SCHEDULED_DAYS_DUE_DATE | ENROLLMENT |
| subjectTemplate | Non | Subject template string | Case notification V{org_unit_name} |
| messageTemplate | Oui | Chaîne du modèle de message | Case notification A{h5FuguPFF2j} |
| notificationRecipient | Oui | Who is going to receive notification. Options are USER_GROUP, ORGANISATION_UNIT_CONTACT, TRACKED_ENTITY_INSTANCE, USERS_AT_ORGANISATION_UNIT, DATA_ELEMENT, PROGRAM_ATTRIBUTE, WEB_HOOK | USER_GROUP |
| deliveryChannels | Non | Which channel should be used for this notification. It can be either SMS, EMAIL, or HTTP | SMS |
| sendRepeatable | Non | Détermine si la notification doit être envoyée plusieurs fois | false |
The WEB_HOOK notificationRecipient is used exclusively for sending HTTP POST requests to external systems. Ensure that the HTTP delivery channel is selected when using this option.
As program notification template is a type of metadata, you can create, update, and delete it just like other metadata.
The program message feature enables you to send messages to tracked entities, contact addresses associated with organisation units, phone numbers, and email addresses. Messages can be sent using the messages resource.
POST /api/messages
Les messages de programme peuvent être envoyés à l'aide de deux canaux :
Les messages de programme peuvent être envoyés à différents destinataires :
PHONE_NUMBER or EMAIL (depending on the specified delivery channels) and use the corresponding attribute values.Below is a sample JSON payload for sending messages using POST requests.
{
"programMessages": [{
"recipients": {
"trackedEntity": {
"id": "UN810PwyVYO"
},
"organisationUnit": {
"id": "Rp268JB6Ne4"
},
"phoneNumbers": [
"55512345",
"55545678"
],
"emailAddresses": [
"johndoe@mail.com",
"markdoe@mail.com"
]
},
"enrollment": {
"id": "f3rg8gFag8j"
},
"event": {
"id": "pSllsjpfLH2"
},
"deliveryChannels": [
"SMS", "EMAIL"
],
"notificationTemplate": "Zp268JB6Ne5",
"subject": "Outbreak alert",
"text": "An outbreak has been detected",
"storeCopy": false
}]
}
| Champ | Obligatoire | Description | Valeurs |
|---|---|---|---|
| recipients² | Oui | Recipients of the program message. At least one recipient must be specified. | Can be trackedEntity, organisationUnit, an array of phoneNumbers or an array of emailAddresses. |
| enrollment | Non | Enrollment which ProgramMessage is attached to. | ID de l'inscription. |
| event | Non | Event which ProgramMessage is attached to. | ID de l'événement. |
| deliveryChannels | Oui | Tableau des canaux d'envoi de messages. | SMS, EMAIL |
| notificationTemplate | Non | ProgramNotificationTemplate UID is used to cross-check which program message belongs to which notification template. | Text. |
| subject | Non | L'objet du message. Ne s'applique pas au canal SMS. | Text. |
| text | Oui | Le texte du message. | Text. |
| storeCopy | Non | Indique si une copie du message doit être stockée dans DHIS2. | false, true |
The program message API supports querying messages using specific request parameters.
GET /api/messages
To retrieve a specific message.
GET /api/messages/scheduled/sent?enrollment={uid}
GET /api/messages/scheduled/sent?event={uid}
To retrieve a specific message.
GET /api/messages/{uid}
To delete a message.
DELETE /api/messages/{uid}
The program message API supports querying messages using specific request parameters. You can filter messages based on the parameters listed below. All requests should use the GET HTTP verb to retrieve information.
| Paramètre | URL |
|---|---|
| enrollment | /api/messages?enrollment=6yWDMa0LP7 |
| event | /api/messages?event=SllsjpfLH2 |
| trackedEntity | /api/messages?trackedEntity=xdfejpfLH2 |
| organisationUnit | /api/messages?ou=Sllsjdhoe3 |
| processedDate | /api/messages?processedDate=2016-02-01 |
/api/programNotificationInstances exposes program notification instances, i.e. concrete scheduled or sent notifications created from program notification templates.
Returns program notification instances, optionally filtered and paginated.
GET /api/programNotificationInstances
| Nom | Type | Obligatoire | Description |
|---|---|---|---|
scheduledAt | date (ISO-8601) | no | Returns notification instances scheduled to be sent on the given date. Example: scheduledAt=2025-01-01. |
paging | boolean | no | Enables or disables pagination. Default is true. Use paging=false to return all matching instances without pagination. |
page | integer | no | Page number to return when pagination is enabled. |
pageSize | integer | no | Number of items per page when pagination is enabled. |
event | UID | no | Program notification instances attached to this event. |
enrollment | UID | no | Program notification instances attached to this enrollment. |
This section covers general performance principles followed by endpoint-specific guidance for the tracker export endpoints. Further performance optimizations require knowledge of real-world access patterns and data distribution. If your implementation can share this information, it will help prioritize improvements.
For tracker performance improvements relative to previous releases, see the corresponding release note, e.g. 2.43.
Notifications are dispatched asynchronously after import but compete with concurrent requests for database connections, CPU, and memory. With many entities and notification templates this can increase latency. For bulk imports where notifications are not needed, skip them:
POST /api/tracker?skipSideEffects=true
The rule engine runs synchronously during import for every enrollment and event in the bundle, which can increase latency significantly for bulk imports. Skip it only if the programs have no rules with validations or assignments that must be enforced on import:
POST /api/tracker?skipRuleEngine=true
Export endpoint response times are typically dominated by database query execution. The recommendations below focus on reducing the amount of work the database has to do.
The tracker data model has three levels: tracked entities, enrollments, and events. Always query at the lowest level that satisfies your need. Use GET /api/tracker/events instead of GET /api/tracker/trackedEntities?fields=enrollments[events]. Querying via a parent endpoint increases query complexity or the number of queries.
fieldsBy default, all endpoints exclude nested collections such as enrollments, events, and relationships. Each additional collection increases resource utilization and response times. Only request the fields you need and avoid fields=*.
Query performance depends on how many records the database must process before returning results. The fewer records to scan, sort, and deduplicate, the faster the response. This is selectivity: the fraction of total records that match the query conditions.
Selectivity comes from several sources, all of which compound: request parameters (such as program, filter, date ranges), user scope, and orgUnitMode.
Filters narrow the result set before sorting and pagination. They are most effective when backed by a database index. Broad filters (e.g., filter=w75KJ2mc4zz:like:J) may match a large portion of the dataset and provide little selectivity. Narrow filters (e.g., filter=w75KJ2mc4zz:eq:Jerald or a tight date range) reduce the working set significantly. like filters on tracked entity attributes can benefit from trigram indexing.
The "Minimum number of attributes required to search" setting on programs and tracked entity types requires a minimum number of attribute filters when searching outside the user's capture scope.
Specifying program enables ownership-based access control. Without program, the system must evaluate access rules dynamically across all programs a tracked entity is enrolled in. Always include program when querying program-specific data.
Note that even with program specified, selectivity depends on how much data exists for that program. A program enrolling most tracked entities will not be very selective.
orgUnitMode and the user's organisation unit scope directly affect how many records the database processes. Performance depends on how much data the included org units own. A user scoped to a single facility queries a small subset of records; a user with root-level access may scan the entire program. SELECTED is the most efficient as the database can seek directly to records owned by the specified org units.
CHILDREN is slow when the children do not own data. Data is typically captured at facilities (the lowest level). Using CHILDREN at a higher level (e.g. district) returns administrative org units that have no events, forcing the database to scan all events in the program to confirm this. CHILDREN is fast when the children are org units that actually capture data.
ALL includes no geographic restriction. ACCESSIBLE depends on the user's search scope, which for users with broad access can cover most of the program's data. Combine with selective filters to keep the working set manageable.
The order parameter can significantly impact query performance. Order fields fall into performance tiers:
orgUnitMode.enrolledAt or an attribute value). The database must look up these values for every matching record before sorting.Selectivity matters more than order field choice. With selective filters or narrow user scope, even slow order fields are fast because the database only sorts a small set. Note that filters without a backing index still reduce the sort cost but not the scan cost.
See the endpoint-specific sections below for which order fields fall into which tier.
DHIS2 uses offset-based pagination. High page numbers are inherently slower because the database must compute and discard all preceding rows. This is a fundamental property of offset-based pagination, not specific to DHIS2.
Recommandations : * Keep page sizes reasonable (default is 50) * Avoid navigating to very high page numbers * Avoid totalPages=true unless necessary as it runs an additional count query that must process all matching records regardless of page size * Avoid paging=false as it returns all matching records in a single response
Configure collection limits to cap the result set size and protect database and server resources.
/api/tracker/trackedEntitiesEither program or trackedEntityType is required. Prefer program as it enables direct ownership-based access control.
| Tier | Order fields | Coût |
|---|---|---|
| Fast | trackedEntity, createdAt | Proportional to page (offset) + pageSize |
| Slow | updatedAt, createdAtClient, updatedAtClient, inactive | Proportional to total matching tracked entities |
| Very slow | enrolledAt, tracked entity attribute UIDs | Proportional to total matching tracked entities + per-record lookup in related tables |
enrolledAt additionally requires deduplication when a tracked entity has multiple enrollments in the same program. Programs configured with "Only enroll once" avoid this deduplication cost.
/api/tracker/enrollments| Tier | Order fields | Coût |
|---|---|---|
| Slow | enrolledAt, createdAt, completedAt, updatedAt, createdAtClient, updatedAtClient | Proportional to total matching enrollments |
All enrollment order fields currently lack a composite index. The database must scan and sort all matching enrollments before returning the requested page.
/api/tracker/events (Tracker Programs)program is mandatory and can be combined with programStage to narrow to a single stage.
Every tracker event query must traverse enrollment and ownership records to enforce access control. On a program with hundreds of thousands of enrollments, broad queries (e.g., orgUnitMode=ALL without filters) must process all ownership records before any event-level work can begin. An index on the event table alone cannot help because the ownership check happens on a different table.
The most effective way to reduce cost is to provide a narrow org unit scope. A user scoped to a single facility produces a small ownership set, making the rest of the query fast regardless of other parameters.
Enrollment-level filters (enrollmentStatus, followUp, enrollment date ranges) are not backed by indexes. They can still reduce the result set but do not reduce the number of records the database scans.
| Tier | Order fields | Coût |
|---|---|---|
| Slow | occurredAt, scheduledAt, createdAt, updatedAt, completedAt, createdAtClient, updatedAtClient, enrolledAt, data element UIDs | Proportional to total matching events (after ownership join) |
| Very slow | tracked entity attribute UIDs | Proportional to total matching events + per-event cross-resource lookup |
All tracker event order fields lack a composite index at the program level. The database must traverse enrollment and ownership records, collect all matching events, sort them, and return the requested page. Cost scales with total matching events, not page size.
Specifying programStage does not improve ordering performance because the bottleneck is the ownership join, not the event-level scan.
enrolledAt comes from the enrollment table which is already part of the ownership join, so it does not require an additional lookup. Attribute UIDs require a cross-resource lookup to the tracked entity for every matching event.
/api/tracker/events (Event Programs)Event programs (programs without registration) have no enrollment or ownership overhead. The database goes directly from the event to its org unit, making these queries structurally faster than tracker program queries.
program is mandatory.
With the default occurredAt order, the database walks the sorted index and filters each event by org unit. This is fast when matching events appear early in the index. For SELECTED, DESCENDANTS, and ACCESSIBLE, performance depends on how the matching org units' events are distributed across the sort order. If matching events are rare or concentrated at the end of the index, the database must scan many non-matching events first. On program stages with millions of events where the user's org units cover only a small fraction, this can result in scanning large portions of the index before filling a single page. Adding occurredAfter and/or occurredBefore limits the scan to a bounded window and is recommended for high-volume program stages.
ALL avoids org unit filtering entirely and is fast with the default order. CHILDREN is slow for the same reasons described in the general principles.
Without the default occurredAt order, all modes require scanning and sorting all matching events.
The default order is occurredAt desc. This is the most efficient order for event programs.
| Tier | Order fields | Coût |
|---|---|---|
| Fast (indexed) | occurredAt | Proportional to page (offset) + pageSize. Degrades when org unit filtering is active but matches are sparse — see Organisation Unit Mode above. |
| Slow (no index) | createdAt, updatedAt, completedAt, createdAtClient, updatedAtClient | Proportional to total events for the program stage |
| Slow (JSON extraction) | Data element UIDs | Requires extracting and sorting JSON values for every matching event |
L'API Web propose une ressource pour l'envoi de courriers électroniques. Pour que des courriels puissent être envoyés, il faut que la configuration SMTP soit correctement établie et qu'une adresse électronique de notification du système soit définie pour l'instance DHIS2. Vous pouvez définir les paramètres SMTP à partir de l'écran des paramètres de messagerie et l'adresse électronique de notification du système à partir de l'écran des paramètres généraux de DHIS2.
/api/33/email
La ressource notification vous permet d'envoyer des notifications par courriel au système avec un sujet et un texte donnés en JSON ou XML. Le courriel sera envoyé à l'adresse électronique de notification définie dans les paramètres généraux du système DHIS2 :
{
"subject": "Integrity check summary",
"text": "All checks ran successfully"
}
Vous pouvez envoyer une notification par courrier électronique au système en envoyant un message à la ressource notification comme suit :
curl -d @email.json "localhost/api/33/email/notification" -X POST
-H "Content-Type:application/json" -u admin:district
Vous pouvez également envoyer une notification générale par courrier électronique en postant dans la ressource de notification comme indiqué ci-dessous. F_SEND_EMAIL ou ALL doit être présente dans le système pour pouvoir utiliser cette API. Le paramètre est facultatif. La chaîne "DHIS 2" sera envoyée comme sujet par défaut s'il n'est pas fourni dans l'url. L'url doit être encodée pour pouvoir utiliser cette API.
curl "localhost/api/33/email/notification?recipients=xyz%40abc.com&message=sample%20email&subject=Test%20Email"
-X POST -u admin:district
The previous example is convenient for short messages. However, since the message is passed as a query string, it can quickly hit the URL length limit of the server. For longer messages, it is better to send the data in the POST request body. The following example shows how to send an email with a longer message in the request body:
curl -u admin:district -X POST 'localhost/api/33/email/notification' \
-H 'Content-Type: application/x-www-form-urlencoded' \
--data-urlencode 'recipients=recipient1@example.com,recipient2@example.com' \
--data-urlencode 'subject=Important System Update' \
--data-urlencode 'message=Dear user, we are writing to inform you about an important system update that will take place this weekend. The system will be unavailable for a few hours. We apologize for any inconvenience this may cause. Please plan your work accordingly. Best regards, The DHIS2 Team.'
To send an email with an HTML body, you can simply provide the HTML content in the message parameter. The email client should interpret the HTML and render it accordingly. Note that the Content-Type header in the curl command should be application/x-www-form-urlencoded, as the data is sent as URL-encoded form data. The following example shows how to send an email with a simple HTML table:
curl -u admin:district -X POST 'localhost/api/33/email/notification' \
-H 'Content-Type: application/x-www-form-urlencoded' \
--data-urlencode 'recipients=recipient1@example.com,recipient2@example.com' \
--data-urlencode 'subject=System Maintenance Schedule' \
--data-urlencode 'message=<html><body><h2>System Maintenance</h2><p>Dear user,</p><p>We are writing to inform you about scheduled system maintenance. The following table shows the maintenance schedule for the upcoming week:</p><table border="1"><tr><th>Day</th><th>Time</th></tr><tr><td>Monday</td><td>10 PM - 11 PM</td></tr><tr><td>Wednesday</td><td>10 PM - 11 PM</td></tr></table><p>We apologize for any inconvenience this may cause. Please plan your work accordingly.</p><p>Best regards,<br>The DHIS2 Team</p></body></html>'
Pour tester si la configuration SMTP est correcte en vous envoyant à vous-même un e-mail de test, vous pouvez interagir avec la ressource test. Pour envoyer des courriels de test, il faut que votre compte utilisateur DHIS2 soit associé à une adresse électronique valide. Vous pouvez envoyer un courriel de test comme suit :
curl "localhost/api/33/email/test" -X POST -H "Content-Type:application/json" -u admin:district
En utilisant la ressource dataStore ("magasin de données"), les développeurs peuvent stocker des données arbitraires pour leurs applications. L'accès à la clé d'un magasin de données est basé sur ses paramètres de partage. Par défaut, toutes les clés créées sont accessibles au public (lecture et écriture). En outre, l'accès à l'espace de noms d'un datastore est limité à l'accès de l'utilisateur à l'application correspondante, si l'application a réservé l'espace de noms. Par exemple, un utilisateur ayant accès à l'application « sampleApp » pourra également utiliser l'espace de noms sampleApp dans le magasin de données. Si un espace de noms n'est pas réservé, aucun accès spécifique n'est requis pour l'utiliser.
/api/33/dataStore
Notez qu'il existe des espaces de noms réservés utilisés par le système qui requièrent une autorité spéciale pour pouvoir lire ou écrire des données. Par exemple, l'espace de noms pour l'application de réglages android ANDROID_SETTINGS_APP nécessitera l'autorité M_androidsettingsapp.
Les données du magasin de données se composent d'un espace de noms, d'une clé et d'une valeur. La combinaison de l'espace de noms et de la clé est unique. Le type de données de la valeur est JSON.
Tableau : Structure du magasin de données
| Élément | Description | Type de données |
|---|---|---|
| Espace de noms | Espace-noms pour l'organisation des données | Chaîne |
| Clé | Clé d'identification des valeurs. | Chaîne |
| Valeur | Valeur contenant les informations à saisir | JSON |
| Chiffré | Indique si la valeur de la clé donnée doit être chiffrée | Booléen |
Pour obtenir une liste de tous les espaces de noms existants :
GET /api/33/dataStore
Exemple de requête curl pour le listing :
curl "play.dhis2.org/demo/api/33/dataStore" -u admin:district
Exemple de réponse :
[
"foo",
"bar"
]
Pour obtenir la liste de toutes les clés d'un espace de noms :
GET /api/33/dataStore/<namespace>
Exemple de requête curl pour le listing :
curl "play.dhis2.org/demo/api/33/dataStore/foo" -u admin:district
Exemple de réponse :
[
"key_1",
"key_2"
]
Pour récupérer une valeur pour une clé existante dans un espace de noms :
GET /api/33/dataStore/<namespace>/<key>
Exemple de requête curl pour l'extraction :
curl "play.dhis2.org/demo/api/33/dataStore/foo/key_1"-u admin:district
Exemple de réponse :
{
"foo":"bar"
}
Pour récupérer les métadonnées d'une clé existante dans un espace de noms :
GET /api/33/dataStore/<namespace>/<key>/metaData
Exemple de requête curl pour l'extraction :
curl "play.dhis2.org/demo/api/33/dataStore/foo/key_1/metaData" -u admin:district
Exemple de réponse :
{
"id": "dsKeyUid001",
"created": "...",
"user": {...},
"namespace": "foo",
"key": "key_1"
}
L'API de requête permet d'interroger et de filtrer les valeurs de toutes les clés d'un espace de noms. Le paramètre fields (champs) est utilisé pour spécifier la requête. Ceci est utile pour récupérer des valeurs spécifiques de clés dans un espace de noms en une seule requête.
GET /api/dataStore/<namespace>?fields=
La liste des champs peut être :
.: renvoie la valeur de la racine telle qu'elle est stockée<path>[,<path>] ; chacun <path> peut être un simple nom de propriété (comme age) ou un chemin imbriqué (comme person.age) En outre, les entrées peuvent être filtrées à l'aide d'un ou plusieurs paramètres filter (filtre) et triées à l'aide du paramètre order (ordre).
Plusieurs filtres peuvent être combinés en utilisant rootJunction=OR (par défaut) ou rootJunction=AND.
Tous les détails sur les paramètres fields(champs), filter(filtre) et order(ordre) sont donnés dans les sections suivantes.
Par défaut, les résultats utilisent la pagination. Utilisez pageSize ("taille de page") et page ("page") pour ajuster la taille et le décalage. Le paramètre paging=false peut être utilisé pour ne pas utiliser la pagination et toujours retourner toutes les correspondances. Ceci doit être utilisé avec précaution car il peut y avoir beaucoup d'entrées dans un espace de noms. La taille de page par défaut est de 50.
GET /api/dataStore/<namespace>?fields=.&page=2&pageSize=10
Lorsque la pagination est désactivée, les entrées sont renvoyées sous la forme d'un tableau de résultats simple en tant que structure JSON racine. Le même effet peut être obtenu avec des résultats paginés en utilisant headless=true(sans en-tête).
{
"pager": { ... },
"entries": [...]
}
[...]
Le magasin de données permet d'extraire des valeurs simples ou complexes entières ainsi que l'extraction de parties de valeurs JSON complexes.
Remarque
Pour plus de clarté dans les exemples, les réponses présentées omettent pour la plupart l'objet le plus externe avec les informations de
paginationet le tableau d'entréesprésenté dans les exemples.
Pour filtrer un certain ensemble de champs, ajoutez un paramètre fields à l’espace de noms requête:
GET /api/dataStore/<namespace>?fields=name,description
Cela renvoie une liste de toutes les entrées ayant un nom non nul et/ou un description comme dans l’exemple suivant :
[
{"key": "key1", "name": "name1", "description": "description1"},
{"key": "key2", "name": "name2", "description": "description2"}
]
Si, pour une raison quelconque, nous souhaitons que la liste de résultats contienne des entrées pour lesquelles aucun des champs extraits n'est non nul, le paramètre includeAll (inclure tous) peut être ajouté :
GET /api/dataStore/<namespace>?fields=name,description&includeAll=true
La réponse pourrait ressembler à ceci maintenant:
[
{"key": "key1", "name": "name1", "description": "description1"},
{"key": "key2", "name": "name2", "description": "description2"},
{"key": "key3", "name": null, "description": null},
{"key": "key4", "name": null, "description": null}
]
L'extraction n'est pas limitée aux simples membres de niveau racine, mais peut également prendre des membres imbriqués en utilisant des crochets ou des parenthèses rondes après le nom d'un membre :
GET /api/dataStore/<namespace>?fields=name,root[child1,child2]
GET /api/dataStore/<namespace>?fields=name,root(child1,child2)
L'exemple de réponse pourrait ressembler à ceci :
[
{ "key": "key1", "name": "name1", "root": {"child1": 1, "child2": []}},
{ "key": "key2", "name": "name2", "root": {"child1": 2, "child2": []}}
]
La même syntaxe s'applique aux membres imbriqués :
GET /api/dataStore/<namespace>?fields=root[level1[level2[level3]]]
GET /api/dataStore/<namespace>?fields=root(level1(level2(level3)))
L'exemple de réponse ici:
[
{ "key": "key1", "root": {"level1": {"level2": {"level3": 42}}}},
{ "key": "key1", "root": {"level1": {"level2": {"level3": 13}}}}
]
Lorsque de telles valeurs profondément imbriquées sont extraites, il se peut que nous ne voulions pas conserver la structure mais extraire le membre de la feuille vers un membre de niveau supérieur dans la réponse. Les alias peuvent être utilisés à cette fin. Un alias peut être placé n'importe où après le nom d'un membre en utilisant ~hoist suivi de l'alias entre crochets comme suit :
GET /api/dataStore/<namespace>?fields=root[level1[level2[level3~hoist(my-prop)]]]
La réponse ressemblerait à ceci maintenant:
[
{ "key": "key1", "my-prop": 42},
{ "key": "key2", "my-prop": 13}
]
Si le chemin complet doit être conservé tout en donnant un alias à un membre imbriqué, le chemin parent doit être répété en utilisant la syntaxe des points pour indiquer l'imbrication. Cette méthode peut également être utilisée pour restructurer une réponse dans une nouvelle structure différente comme suit :
GET /api/dataStore/<namespace>?fields=root[level1[level2[level3~hoist(my-root.my-prop)]]]
La réponse nouvellement structurée se présente désormais comme suit :
[
{ "key": "key1", "my-root": {"my-prop": 42}},
{ "key": "key2", "my-root": {"my-prop": 13}}
]
OBS! Un alias ne peut pas être utilisé pour renommer un niveau intermédiaire. Cependant, un alias peut être utilisé pour résoudre une collision de noms avec le membre key (clé).
GET /api/dataStore/<namespace>?fields=id,key~hoist(value-key)
[
{ "key": "key1", "id": 1, "value-key": "my-key1"},
{ "key": "key2", "id": 2, "value-key": "my-key2"}
]
Les résultats peuvent être classés en fonction d'une seule propriété en utilisant le paramètre order=<path>[:direction]. Il peut s'agir de toute valeur valide <path> ou de la clé d'entrée (utiliser _ comme chemin).
Par défaut, le tri est alphanumérique si la valeur du chemin d'accès est une chaîne de caractères de type mixte.
Par exemple, pour extraire la propriété nom et trier le résultat en fonction de celle-ci, utilisez :
GET /api/dataStore/<namespace>?fields=name&order=name
Pour passer à l'ordre décroissant, utilisez :desc :
GET /api/dataStore/<namespace>?fields=name&order=name:desc
Parfois, la propriété triée est numérique, de sorte que l'interprétation alphanumérique prêterait à confusion. Dans ce cas, les types de classement spéciaux :nasc et :ndesc peuvent être utilisés.
En résumé, l'ordre peut être l'un des éléments suivants :
asc: ordre alphanumérique croissantdesc:: ordre alphanumérique décroissantnasc: ordre numérique croissantndesc: ordre numérique décroissantOBS!
Lors de l'utilisation de l'ordre numérique, toutes les correspondances doivent avoir une valeur numérique pour la propriété à l'emplacement fourni
<path>.
Pour filtrer les entrées dans le contexte API de la requête, ajoutez un ou plusieurs paramètres filter (filtre). tout en utilisant le paramètre fields (champs).
Chaque paramètre filtre a la forme suivante :
<path>:<operator><path>:<operator>:<value><path>:<operator>:[<value>,<value>,...]Les opérateurs unitaires sont:
| Opérateur | Description |
|---|---|
nul | La valeur est JSON null |
!nul | La valeur est définie mais différente de la valeur JSON null |
vide | la valeur est un objet vide, un tableau vide ou une chaîne JSON de longueur zéro |
!vide | la valeur est différente d'un objet vide, d'un tableau vide ou d'une chaîne de longueur zéro |
Les opérateurs binaires sont:
| Opérateur | Description |
|---|---|
eq | la valeur est égale au booléen, au nombre ou à la chaîne de caractères donné(e) |
!eq, ne, neq | la valeur n'est pas égale au booléen, au nombre ou à la chaîne de caractères donné(e) |
lt | la valeur est numériquement ou alphabétiquement inférieure au nombre ou à la chaîne de caractères donné(e) |
le | la valeur est numériquement ou alphabétiquement inférieure ou égale au nombre ou à la chaîne de caractères donné(e) |
gt | la valeur est numériquement ou alphabétiquement supérieure au nombre ou à la chaîne de caractères donné(e) |
ge | la valeur est numériquement ou alphabétiquement supérieure ou égale au nombre ou à la chaîne de caractères donné(e) |
Les opérateurs binaires de correspondance de motifs de texte sont les suivants :
| Opérateur | Insensible à la casse | Description |
|---|---|---|
like | ilike | La valeur correspond au modèle de texte indiqué |
!like | !ilike | La valeur ne correspond pas au modèle de texte indiqué |
$like | $ilike, startswith (commence avec) | La valeur commence par le modèle de texte indiqué |
!$like | !$ilike, !startswith (commence avec) | La valeur ne commence pas par le modèle de texte indiqué |
like$ | ilike$, endswith (se termine par) | La valeur se termine par le modèle de texte indiqué |
!like$ | !ilike$, !endswith (se termine par) | La valeur ne se termine pas par le modèle de texte indiqué |
Pour les opérateurs qui fonctionnent pour plusieurs types de noeuds JSON, la sémantique est déterminée à partir de la valeur fournie. Si la valeur est true ou false, le filtre correspond aux valeurs JSON booléennes. Si la valeur est un nombre, le filtre correspond aux valeurs JSON de type nombre. Sinon, la valeur correspond à des valeurs JSON de type chaîne ou à des types de valeurs mixtes.
Conseil
Pour forcer la comparaison de texte pour une valeur numérique, mettez la valeur entre guillemets simples. Par exemple, la valeur
'13'est le texte 13 alors que13est le nombre 13.
Les opérateurs de l'ensemble sont :
| Opérateur | Description |
|---|---|
in | la valeur d'entrée est textuellement égale à l'une des valeurs données (est dans l'ensemble) |
!in | la valeur d'entrée n'est pas textuellement égale à l'une des valeurs données (n'est pas dans l'ensemble) |
Ils <path> peuvent être :
_: la clé d'entrée est.: la valeur de la racine d'entrée est<member>: le membre de la valeur racine est<member>.<member>: le membre du chemin est (jusqu'à 5 niveaux de profondeur)L'expression <member> path peut être un nom de membre ou, dans le cas d'un tableau, un index de tableau. Dans le cas d'un tableau, l'index peut également être donné sous la forme : [<index>]. Par exemple, le chemin adresses[0].street serait identique à adresses.0.street.
Vous trouverez ci-dessous quelques exemples de requêtes.
Le nom (de l'objet racine) est "Luke" :
GET /api/dataStore/<namespace>?fields=.&filter=name:eq:Luke
L'âge (de l'objet racine) est supérieur à 42 (numérique) :
GET /api/dataStore/<namespace>?fields=.&filter=age:gt:42
La valeur racine est un nombre supérieur à 42 (correspondance numérique déduite de la valeur) :
GET /api/dataStore/<namespace>?fields=.&filter=.:gt:42
L'option Activé (de l'objet racine) est vraie (correspondance booléenne déduite de la valeur) :
GET /api/dataStore/<namespace>?fields=.&filter=enabled:eq:true
L'objet racine a un nom contenant « Pet » et a un âge supérieur à 20 ans :
GET /api/dataStore/<namespace>?fields=.&filter=name:like:Pet&filter=age:gt:20
L'objet racine est signalé comme mineur ou a un âge inférieur à 18 ans :
GET /api/dataStore/<namespace>?fields=.&filter=minor:eq:true&filter=age:lt:18&rootJunction=or
Pour créer une nouvelle clé et une nouvelle valeur pour un espace de noms :
POST /api/33/dataStore/<namespace>/<key>
Exemple de requête curl pour créer, en présumant que la charge JSON est valide :
curl "https://play.dhis2.org/demo/api/33/dataStore/foo/key_1" -X POST
-H "Content-Type: application/json" -d "{\"foo\":\"bar\"}" -u admin:district
Exemple de réponse :
{
"httpStatus": "OK",
"httpStatusCode": 201,
"status": "OK",
"message": "Key 'key_1' created."
}
Si vous souhaitez que les données que vous stockez soient cryptées (par exemple les informations d'identification de l'utilisateur ou autres), vous pouvez ajouter une requête à l'URL comme suit :
GET /api/33/dataStore/<namespace>/<key>?encrypt=true
Pour mettre à jour une clé qui existe dans un espace de noms :
PUT /api/33/dataStore/<namespace>/<key>
Exemple de requête curl pour mettre à jour, en présumant que la charge JSON est valide :
curl "https://play.dhis2.org/demo/api/33/dataStore/foo/key_1" -X PUT -d "[1, 2, 3]"
-H "Content-Type: application/json" -u admin:district
Exemple de réponse :
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"message": "Key 'key_1' updated."
}
Pour supprimer une clé existante d'un espace de noms :
DELETE /api/33/dataStore/<namespace>/<key>
Exemple de requête curl pour la suppression :
curl "play.dhis2.org/demo/api/33/dataStore/foo/key_1" -X DELETE -u admin:district
Exemple de réponse :
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"message": "Key 'key_1' deleted from namespace 'foo'."
}
Pour supprimer toutes les clés d'un espace de noms :
DELETE /api/33/dataStore/<namespace>
Exemple de requête curl pour la suppression :
curl "play.dhis2.org/demo/api/33/dataStore/foo" -X DELETE -u admin:district
Exemple de réponse :
{
"httpStatus": "OK",
"httpStatusCode": 200,
"status": "OK",
"message": "Namespace 'foo' deleted."
}
Le partage des clés des magasins de données suit le même principe que le partage d'autres métadonnées (voir Partage).
Pour obtenir les paramètres de partage d'une clé de magasin de données spécifique :
GET /api/33/sharing?type=dataStore&id=<uid>
L'identifiant de la clé du magasin de données provient du point d'extrémité /metaData de cette clé :
GET /api/33/dataStore/<namespace>/<key>/metaData
Comme d'habitude, la propriété access dans la réponse reflète les capacités de l'utilisateur actuel pour l'entrée cible. La protection de l'espace de nommage peut toujours s'appliquer et rendre un utilisateur incapable d'effectuer certaines modifications.
Pour modifier les paramètres de partage d'une clé de stockage de données spécifique :
POST /api/33/sharing?type=dataStore&id=<uid>
avec la requête suivante:
{
"object": {
"publicAccess": "rw------",
"externalAccess": false,
"user": {},
"userAccesses": [],
"userGroupAccesses": [
{
"id": "hj0nnsVsPLU",
"access": "rw------"
},
{
"id": "qMjBflJMOfB",
"access": "r-------"
}
]
}
}
Outre le magasin de données qui est partagé par tous les utilisateurs du système, un magasin de données basé sur l'utilisateur est également disponible. Les données stockées dans le magasin de données de l'utilisateur sont associées à des utilisateurs individuels, afin que chaque utilisateur puisse avoir des données différentes dans le même espace de noms et la même combinaison de touches. Tous les appels au magasin de données de l'utilisateur seront associés à l'utilisateur connecté. Cela signifie que l'on ne peut voir, modifier, supprimer et ajouter que les valeurs associées à l'utilisateur connecté.
/api/33/userDataStore
Le magasin de données de l'utilisateur se compose d'un utilisateur, d'un espace de noms, de clés et de valeurs associées. La combinaison d'un utilisateur, d'un espace de noms et d'une clé est unique.
Tableau : Structure du magasin de données de l'utilisateur
| Élément | Description | Type de données |
|---|---|---|
| Utilisateur | L'utilisateur auquel ces données sont associées | Chaîne |
| Espace de noms | L'espace de noms auquel appartient la clé | Chaîne |
| Clé | La clé sur laquelle une valeur est stockée | Chaîne |
| Valeur | La valeur stockée | JSON |
| Chiffré | Indique si la valeur doit être cryptée | Booléen |
Renvoie un tableau de tous les espaces de noms existants
GET /api/33/userDataStore
Exemple requête:
curl -H "Content-Type: application/json" -u admin:district "play.dhis2.org/api/33/userDataStore"
[
"foo",
"bar"
]
Renvoie un tableau de toutes les clés existantes dans un espace de noms donné
GET /api/userDataStore/<namespace>
Exemple de requête:
curl -H "Content-Type: application/json" -u admin:district "play.dhis2.org/api/33/userDataStore/foo"
[
"key_1",
"key_2"
]
Renvoie la valeur d'un espace de noms et d'une clé donnés
GET /api/33/userDataStore/<namespace>/<key>
Exemple de requête:
curl -H "Content-Type: application/json" -u admin:district "play.dhis2.org/api/33/userDataStore/foo/bar"
{
"some": "value"
}
Ajoute une nouvelle valeur à une clé donnée dans un espace de noms donné.
POST /api/33/userDataStore/<namespace>/<key>
Exemple de requête:
curl -X POST -H "Content-Type: application/json" -u admin:district -d "['some value']"
"play.dhis2.org/api/33/userDataStore/foo/bar"
{
"httpStatus": "Created",
"httpStatusCode": 201,
"status": "OK",
"message": "Key 'bar' in namespace 'foo' created."
}
Si vous souhaitez que la valeur soit cryptée (par exemple, les informations d'identification de l'utilisateur et autres), vous pouvez ajouter une requête à l'url comme ceci :
GET /api/33/userDataStore/<namespace>/<key>?encrypt=true
Met à jour une valeur existante
PUT /api/33/userDataStore/<namespace>/<key>
Exemple de requête:
curl -X PUT -H "Content-Type: application/json" -u admin:district -d "['new value']"
"play.dhis2.org/api/33/userDataStore/foo/bar"
{
"httpStatus":"Created",
"httpStatusCode":201,
"status":"OK",
"message":"Key 'bar' in namespace 'foo' updated."
}
Supprimer une clé
DELETE /api/33/userDataStore/<namespace>/<key>
Exemple de requête:
curl -X DELETE -u admin:district "play.dhis2.org/api/33/userDataStore/foo/bar"
{
"httpStatus":"OK",
"httpStatusCode":200,
"status":"OK",
"message":"Key 'bar' deleted from the namespace 'foo."
}
Supprimer toutes les clés de l'espace de noms donné
DELETE /api/33/userDataStore/<namespace>
Exemple de requête:
curl -X DELETE -u admin:district "play.dhis2.org/api/33/userDataStore/foo"
{
"httpStatus":"OK",
"httpStatusCode":200,
"status":"OK",
"message":"All keys from namespace 'foo' deleted."
}
Les administrateurs peuvent manipuler le magasin de données d'un autre utilisateur en ajoutant le paramètre nom d'utilisateur à n'importe laquelle des manipulations décrites ci-dessus pour qu'elles n'affectent pas le magasin de données de l'administrateur mais celui de l'utilisateur indiqué par le paramètre nom d'utilisateur.
Par exemple, pour ajouter une valeur au magasin de données de Peter, un administrateur utilise :
POST /api/userDataStore/<namespace>/<key>?username=Peter
Le datastore et le datastore utilisateur permettent tous deux une mise à jour partielle des valeurs d'entrée.
Tous les exemples suivants partent du principe que l'entrée JSON suivante se trouve dans l'espace de noms pets avec la clé whiskers.
{
"name": "wisker",
"favFood": [
"fish", "rabbit"
]
}
Nous pouvons effectuer de nombreuses opérations de mise à jour sur cette entrée. Les exemples suivants utilisent {store} dans les appels API, veuillez le remplacer par dataStore ou userDataStore selon votre cas d'utilisation.
Nous pouvons effectuer une mise à jour de l'entrée à la racine en ne fournissant pas le paramètre de requête path ou en le laissant vide path=.
PUT /api/{store}/pets/whiskers avec le corps "whiskers" met à jour l'entrée avec le corps fourni. Donc une requête GET vers /api/{store}/pets/whiskers afficherait maintenant :
"whiskers"
Nous pouvons mettre à jour l'entrée selon un chemin spécifique en fournissant le paramètre de requête path et la propriété à mettre à jour.
PUT /api/{store}/pets/whiskers?path=name avec le corps "whiskers" met à jour l'entrée au niveau de la propriété name uniquement. Donc une requête GET vers /api/{store}/pets/whiskers affichera maintenant le nom mis à jour :
{
"name": "whiskers",
"favFood": [
"fish",
"rabbit"
]
}
Nous pouvons mettre à jour un élément de tableau selon un chemin spécifique.
PUT /api/{store}/pets/whiskers?path=favFood.[0] avec le corps "carrot" (carotte) met à jour le premier élément du tableau favFood (plat préféré) uniquement. Donc une requête GET vers /api/{store}/pets/whiskers montrerait maintenant le favFood mis à jour :
{
"name": "wisker",
"favFood": [
"carrot",
"rabbit"
]
}
Le paramètre de requête roll permet à l'utilisateur d'avoir un nombre 'roulant' d'éléments dans un tableau. Dans notre exemple, nous avons le tableau favFood. Si nous voulions mettre à jour ce tableau précédemment, nous devrions fournir toute la charge comme suit : PUT /api/{store}/pets/whiskers avec corps
{
"name": "wisker",
"favFood": [
"fish",
"rabbit",
"carrot"
]
}
Maintenant, nous pouvons utiliser le paramètre de requête roll (avec la fonctionnalité path) pour indiquer que nous voulons la fonctionnalité de roulement pour n nombre d'éléments. Dans cet exemple, nous indiquons que nous voulons que le tableau ait une valeur de roulement de 3, en passant un élément supplémentaire dans l'appel. PUT /api/{store}/pets/whiskers?roll=3&path=favFood avec le corps "carrot" donnerait le résultat suivant.
{
"name": "wisker",
"favFood": [
"fish",
"rabbit",
"carrot"
]
}
Puisque nous avons utilisé la valeur de roulement 3, cela indique que nous ne voulons que les 3 derniers éléments dans le tableau. Donc si nous faisons un autre appel et que nous ajoutons un nouvel élément au tableau, nous nous attendons à ce que le premier élément (fish) soit supprimé du tableau. PUT /api/{store}/pets/whiskers?roll=3&path=favFood avec le corps "bird" donnerait le résultat suivant :
{
"name": "wisker",
"favFood": [
"rabbit",
"carrot",
"bird"
]
}
Remarque
Une fois qu'une valeur de roulement a été fixée (par exemple
role=3), elle ne peut être qu'augmentée (par exempleroll=5) et ne peut pas être diminuée (par exempleroll=2).
La notation par points permet d'effectuer des appels imbriqués. Supposons que nous ayons cette valeur d'entrée actuelle :
{
"name": "wisker",
"favFood": [
"fish", "rabbit"
],
"type": {
"breed": ["shorthair"]
}
}
Si nous voulions ajouter une autre variété en utilisant un tableau de roulement, nous pourrions faire l'appel : PUT /api/{store}/pets/whiskers?roll=3&path=type.breed avec le corps "small" ce qui donnerait le résultat suivant :
{
"name": "wisker",
"favFood": [
"fish", "rabbit"
],
"type": {
"breed": ["shorthair, small"]
}
}
La ressource profil d'unité d'organisation permet de définir et d'extraire un profil d'information pour les unités d'organisation dans DHIS 2.
/api/organisationUnitProfile
Un seul profil d'unité d'organisation peut être créé et s'applique à toutes les unités d'organisation.
La partie information du profil de l'unité d'organisation comprend :
Pour définir le profil de l'unité d'organisation, vous pouvez utiliser une requête POST :
POST /api/organisationUnitProfile
La charge au format JSON ressemble à ceci, où attributes fait référence aux attributs de métadonnées, groupSets fait référence aux ensembles de groupes d'unités d'organisation et dataItems fait référence aux éléments de données, aux indicateurs, aux ensembles de données et aux indicateurs de programme :
{
"attributes": [
"xqWyz9jNCA5",
"n2xYlNbsfko"
],
"groupSets": [
"Bpx0589u8y0",
"J5jldMd8OHv"
],
"dataItems": [
"WUg3MYWQ7pt",
"vg6pdjObxsm",
"DTVRnCGamkV",
"Uvn6LCg7dVU",
"eTDtyyaSA7f"
]
}
L'autorité F_ORG_UNIT_PROFILE_ADD est nécessaire pour définir le profil.
Pour extraire la définition du profil de l'unité d'organisation, vous pouvez utiliser une requête GET :
GET /api/organisationUnitProfile
La réponse sera au format JSON.
Pour extraire les données du profil d'une unité d'organisation, vous pouvez utiliser une requête GET :
GET /api/organisationUnitProfile/{org-unit-id}/data?period={iso-period}
Le endpoint des données du profil de l'unité d'organisation combinera la définition du profil avec les valeurs d'informations/données qui lui sont associées.
org-unit-id est obligatoire et fait référence à l'identifiant de l'unité d'organisation pour laquelle des données agrégées doivent être fournies.iso-period est facultatif et se réfère à l'identifiant ISO de la période pour fournir des données agrégées pour les éléments de données. Si aucun n'est spécifié, la période relative cette année sera utilisée comme solution de repli.La réponse comprendra les sections suivantes :
info (informations): Informations fixes sur l'unité d'organisation.attributes (attributs) : Attributs de métadonnées avec les valeurs d'attributs correspondantes.groupSets (ensembles de groupes): Ensembles de groupes d'unités d'organisation avec le groupe d'unités d'organisation correspondant dont l'unité d'organisation est membre.dataItems (éléments de données) : Éléments de données avec la valeur de données agrégées correspondante.Notez que des contrôles d'accès sont effectués et que les éléments de métadonnées qui ne sont pas accessibles à l'utilisateur actuel seront omis.
Voici donc un exemple de requête :
GET /api/organisationUnitProfile/DiszpKrYNg8/data?period=2021
La réponse aux données de profil au format JSON se présente comme suit : les champs id (identifiant) et label (étiquette) renvoient à l'élément de métadonnées, et le champ value (valeur) renvoie à la valeur associée :
{
"info": {
"id": "DiszpKrYNg8",
"code": "OU_559",
"name": "Ngelehun CHC",
"shortName": "Ngelehun CHC",
"parentName": "Badjia",
"level": 4,
"levelName": "Facility",
"openingDate": "1970-01-01T00:00:00.000",
"longitude": -11.4197,
"latitude": 8.1039
},
"attributes": [
{
"id": "n2xYlNbsfko",
"label": "NGO ID",
"value": "GHE51"
},
{
"id": "xqWyz9jNCA5",
"label": "TZ code",
"value": "NGE54"
}
],
"groupSets": [
{
"id": "Bpx0589u8y0",
"label": "Facility Ownership",
"value": "Public facilities"
},
{
"id": "J5jldMd8OHv",
"label": "Facility Type",
"value": "CHC"
}
],
"dataItems": [
{
"id": "WUg3MYWQ7pt",
"label": "Total Population",
"value": 3503
},
{
"id": "DTVRnCGamkV",
"label": "Total population < 1 year",
"value": 140
},
{
"id": "vg6pdjObxsm",
"label": "Population of women of child bearing age (WRA)",
"value": 716
},
{
"id": "Uvn6LCg7dVU",
"label": "ANC 1 Coverage",
"value": 368.2
},
{
"id": "eTDtyyaSA7f",
"label": "FIC <1y",
"value": 291.4
}
]
}
Pour télécharger une image pour une unité d'organisation, vous pouvez utiliser le endpoint fileResources.
/api/fileResources
Le endpoint fileResource accepte un fichier brut comme corps de la requête. Les formats JPG, JPEG et PNG sont supportés pour les images d'unités d'organisation. Le domaine pour les images d'unités d'organisation est ORG_UNIT.
Veuillez consulter Ressources de fichiers dans la section Métadonnées pour plus de détails sur le endpoint fileResources.
Pour télécharger une image, vous pouvez envoyer une requête POST avec ORG_UNIT comme paramètre de requête de domaine ainsi que l'image comme charge de la requête. L'en-tête Content-Type (type de contenu) doit correspondre au type de fichier téléchargé.
POST /api/fileResources?domain=ORG_UNIT
La propriété id (identifiant) de l'objet response (réponse) > fileResource (ressource de fichier) dans la réponse JSON contiendra une référence à l'identifiant de la ressource de fichier.
L'entité unité d'organisation a une propriété image qui fait référence à l'image de la ressource fichier. Pour définir la référence de la ressource fichier sur une unité d'organisation, vous pouvez envoyer une requête PATCH à l'unité d'organisation avec une charge JSON :
PATCH /api/organisationUnits/{id}
{
"image": "{file-resource-id}"
}
Vous pouvez également utiliser une requête PUT avec l'unité d'organisation complète (les champs sont omis pour des raisons de concision) :
PUT /api/organisationUnits/{id}
{
"id": "Rp268JB6Ne4",
"name": "Adonkia CHP",
"image": {
"id": "{file-resource-iid}"
}
}
L'entité unité d'organisation possède un objet image qui fait référence à une ressource fichier par identifiant. Vous pouvez obtenir les informations sur l'unité d'organisation à partir du endpoint organisationUnits. S'il est défini, le format JSON ressemble à ceci :
GET /api/organisationUnits/{id}
{
"id": "Rp268JB6Ne4",
"name": "Adonkia CHP",
"image": {
"id": "{file-resource-id}"
}
}
L'identifiant de la ressource du fichier image peut être utilisé pour faire une demande au endpoint fileResources afin de récupérer le contenu du fichier :
GET /api/fileResources/{id}/data
L'en-tête Content-Type (type de contenu) reflète le type de fichier récupéré.
Le endpoint /api/apps peut être utilisé pour installer, supprimer et lister des applications. La clé de l'application est basée sur le nom de l'application, mais tous les caractères non alphanumériques sont supprimés, et les espaces sont remplacés par un tiret. My app! renverra la clé My-app.
Remarque
Avant la version 2.28, la clé d'application était dérivée du nom de l'archive ZIP , à l'exclusion de l'extension du fichier. Les URLs utilisant l'ancien format devraient toujours renvoyer l'application correcte dans l'api.
/api/33/apps
Remarque
Avant la version 2.28, la propriété d'application folderName faisait référence au chemin réel de l'application installée. Avec la possibilité de stocker les applications sur des services en nuage, l'objectif de folderName a changé et fait désormais référence à la clé de l'application.
Vous pouvez lire les clés des applications en listant toutes les applications de la ressource apps et en recherchant la propriété key. Pour lister toutes les applications installées au format JSON :
curl -u user:pass -H "Accept: application/json" "http://server.com/api/33/apps"
Vous pouvez aussi simplement orienter votre navigateur web vers l'URL de la ressource :
http://server.com/api/33/apps
La liste des applications peut également être filtrée par type d'application et par nom, en ajoutant un ou plusieurs paramètres filtre à l'URL :
http://server.com/api/33/apps?filter=appType:eq:DASHBOARD_APP&filter=name:ilike:youtube
Les noms d'applications prennent en charge les opérateurs de filtrage eq et ilike, tandis que appType ne prend en charge que eq.
Pour installer une application, la commande suivante peut être exécutée :
curl -X POST -u user:pass -F file=@app.zip "http://server.com/api/33/apps"
Pour supprimer une application, vous pouvez exécuter la commande suivante :
curl -X DELETE -u user:pass "http://server.com/api/33/apps/<app-key>"
Pour forcer le rechargement des applications actuellement installées, vous pouvez lancer la commande suivante. Cette commande est utile si vous avez ajouté manuellement un fichier directement dans le système de fichiers, au lieu de le télécharger via l'interface utilisateur de DHIS2.
curl -X PUT -u user:pass "http://server.com/api/33/apps"
Si l'instance DHIS2 a été configurée pour utiliser le stockage en nuage, les applications seront désormais installées et stockées sur le service en nuage. Cela permettra à plusieurs instances de partager les mêmes versions des applications installées, au lieu d'installer les mêmes applications sur chaque instance individuelle.
Remarque
Avant la version 2.28, les applications installées étaient uniquement stockées sur le système de fichiers local de l'instance. Les applications installées avant la version 2.28 seront toujours disponibles sur l'instance où elles ont été installées, mais elles ne seront pas partagées avec d'autres instances, car elles sont toujours situées sur le système de fichiers local de l'instance.
L'API Web expose le contenu de l'App Store DHIS2 sous la forme d'une représentation JSON que l'on peut trouver dans la ressource /api/appHub.
/api/33/appHub
Vous pouvez extraire les applications à l'aide d'une requête GET :
GET /api/33/appHub
Un exemple de réponse JSON est décrit ci-dessous.
{
[
{
"name": "Tabular Tracker Capture",
"description": "Tabular Tracker Capture is an app that makes you more effective.",
"sourceUrl": "https://github.com/dhis2/App-repository",
"appType": "DASHBOARD_WIDGET",
"status": "PENDING",
"id": "NSD06BVoV21",
"developer": {
"name": "DHIS",
"organisation": "Uio",
"address": "Oslo",
"email": "dhis@abc.com",
},
"versions": [
{
"id": "upAPqrVgwK6",
"version": "1.2",
"minDhisVersion": "2.17",
"maxDhisVersion": "2.20",
"downloadUrl": "https://dhis2.org/download/appstore/tabular-capture-12.zip",
"demoUrl": "http://play.dhis2.org/demo"
}
],
"images": [
{
"id": "upAPqrVgwK6",
"logo": "true",
"imageUrl": "https://dhis2.org/download/appstore/tabular-capture-12.png",
"description": "added feature snapshot",
"caption": "dialog",
}
]
}
]
}
Vous pouvez installer des applications sur votre instance DHIS2 en supposant que vous avez les permissions appropriées. Une application est référencée en utilisant la propriété id de la version correspondante de l'application. Une application est installée par une requête POST avec l'identifiant de la version à la ressource suivante :
POST /api/33/appHub/{app-version-id}
Le serveur DHIS2 peut fournir un document OpenAPI pour son API. Ce document est créé à la volée à partir de l'analyse de l'API réelle. Cela signifie que le document est terminé, mais que des détails peuvent être perdus ou mal interprétés en raison des limites de l'analyse.
Les formats JSON et YAML sont supportés par tous les points d'entrée de l'OpenAPI. YAML doit être consulté avec un en-tête Accepter de application/x-yaml.
Pour récupérer un document unique contenant tous les points d'accès du serveur, utilisez :
GET /api/openapi.json
GET /api/openapi.yaml
OBS ! Sachez que cette opération génère un document de plusieurs Mo.
Il est possible d'accéder à un document pour un point de terminaison spécifique en ajoutant soit openapi.json ou openapi.yaml au chemin racine d'un point de terminaison. Par exemple, pour générer un document pour les points de terminaison /users, utilisez :
GET /api/users/openapi.json
GET /api/users/openapi.yaml
Pour générer un document avec une sélection spécifique de chemins d'accès à la racine et/ou des étiquettes, le point d'accès général /openapi peut être utilisé avec un ou plusieurs sélecteurs étiquette et chemin.
GET /api/openapi/openapi.json?path=/users&path=/dataElements
GET /api/openapi/openapi.yaml?tag=system&tag=metadata
Les étiquettes disponibles sont :
utilisateurdonnéesmétadonnéesuianalysessystèmemessagerietrackerintégrationconnexionrequêtegestionAll endpoints that generate a OpenAPI document support the following optional request parameters:
failOnNameClashWhen set to true, two or more types of same simple (unqualified) name are considered clashing and the generation fails with an error.
When set false (default), name clashes are resolved by adding numbers to the simple name to make each of them unique. As a result the names are not predictable or stable. Merging simple names with their intended markdown documentation based on name will be broken. This option is meant as a preview feature which should only be used during development.
failOnInconsistencyWhen set to true, a semantic inconsistency in the declaration causes the generation to fail with an error. Usually this indicates a programming mistake. For example, declaring a field both as required and having a default value.
When set to false, a semantic inconsistency is logged as warning but the generation proceeds. This might produce a document that contradicts itself semantically but is valid formally.