Datos individuales analítica

Las aplicaciones analíticas de DHIS2 pueden consumir los datos individuales de cuatro formas principales para generar resultados analíticos, como tablas, gráficos y mapas.
- Line Listing
- Elementos de datos de eventos en la aplicación Data Visualizer
- Indicadores de programa
- Indicadores (véase "Reto común 4: Agregación y Desagregación")
Line Listing (v2.38 y superiores)
Produce una lista de todas las inscripciones o eventos de un programa que cumplen los criterios definidos. Estos criterios pueden ser una combinación de unidades organizativas, dimensiones temporales y valores de datos específicos. Por ejemplo, podría definir una lista de líneas para todas las inscripciones en el programa de tratamiento de la malaria, donde la unidad organizativa son todos los centros del distrito, las fechas de inscripción se produjeron en los últimos 3 meses y el valor del elemento de datos ''Resultado del caso" es defunción.
Los campos de cada fila de la lista pueden ser especificados por el usuario, por ejemplo, un atributo de entidad rastreada (ID de caso), un valor de elemento de datos en una etapa determinada del programa (medicación contra la malaria). El siguiente ejemplo del programa de eventos de morbilidad y mortalidad de pacientes hospitalizados muestra las admisiones por fecha de admisión, género y fecha de alta, todas ellas filtradas por edad en el momento de la admisión. Por lo tanto, combina atributos de entidad rastreada (TEA), valores de indicador de programa y valores de elemento de datos.
Si utiliza los programas datos individuales, puede combinar varias etapas y mostrar los datos de los últimos X eventos de cada etapa en una lista horizontal.
Encontrará más información en documentation.
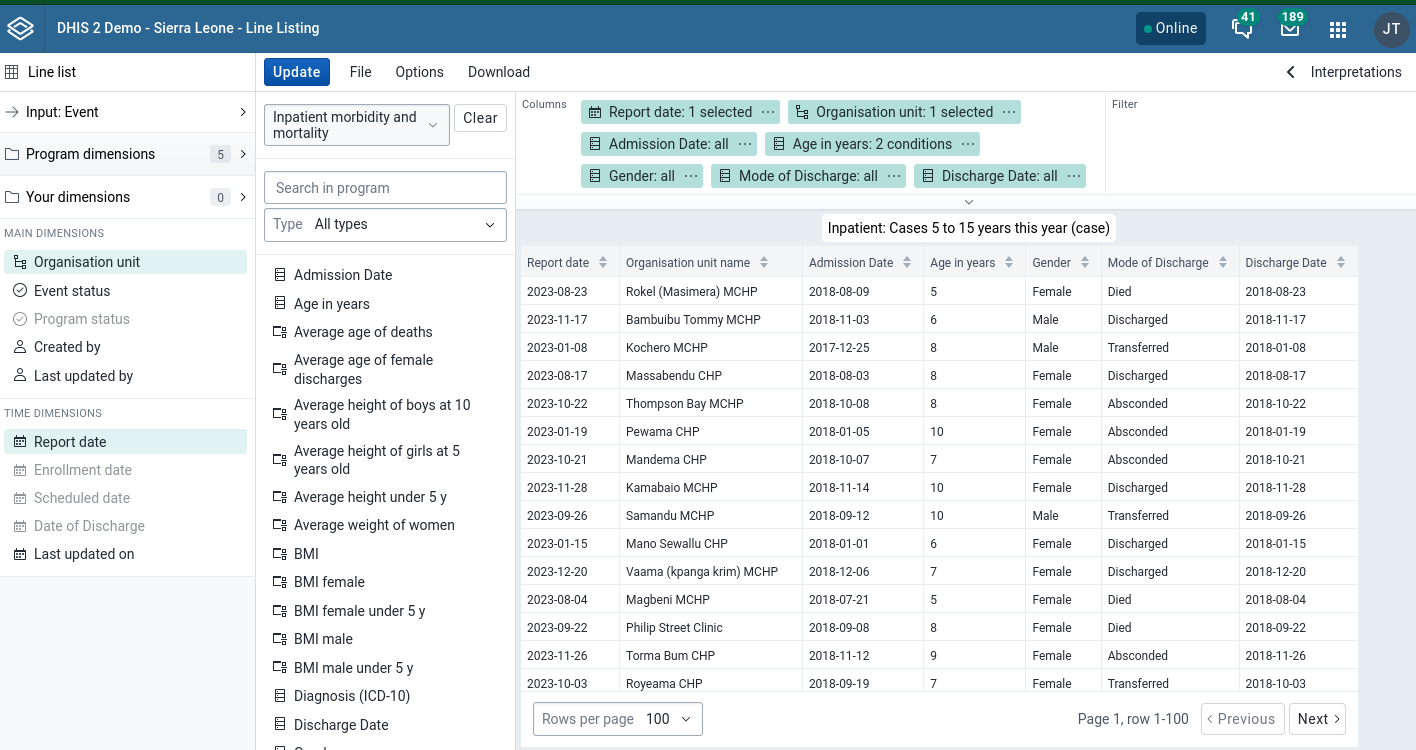
Tenga en cuenta que muchas de las funciones de la lista de líneas también son posibles con una lista de trabajo en la aplicación Capture o en la aplicación Tracker Capture. Para un usuario final, la Lista de Trabajo puede ser más útil que una Lista de Líneas, porque no necesita abrir una nueva ventana/aplicación para ver la lista de pacientes, y haciendo clic en un caso individual dentro de una Lista de Trabajo le llevará directamente a la página del perfil TEI.
Para los analistas de datos, los listados de líneas son muy útiles para localizar valores atípicos individuales que cumplan determinadas condiciones, especialmente en unidades organizativas y periodos. Sin embargo, es muy difícil ver tendencias subyacentes en los datos viendo una larga lista de eventos o inscripciones. A medida que los programas de datos individuales crezcan en escala, querrá ver los datos individuales agregados de forma significativa.
El core de DHIS2 recomienda utilizar la nueva aplicación Line Listing en lugar de la antigua aplicación "Event Reports", que ha sido sustituida por Line Listing y dejará de recibir soporte en futuras versiones.
Elementos de datos de eventos en la aplicación Data Visualizer
También es posible agregar algunos datos de eventos directamente en la aplicación de visualización de datos para producir tablas dinámicas y gráficos. Los informes de la aplicación de visualización de datos pueden ser manipulados y modificados en tiempo real por el usuario final.
Es importante destacar que sólo se pueden agregar valores de datos numéricos. La forma en que se agregan estos valores numéricos se establece mediante el tipo de agregación del elemento de datos, o la agregación puede establecerse en Opciones para toda la visualización. Estas visualizaciones de datos datos individuales pueden generarse directamente desde la aplicación Data Visualizer:
Peso medio en gramos al nacer en el programa infantil, por mes en el centro.
Número total de hogares controlados por investigaciones focales sobre el paludismo, por distrito este año
Para algunas configuraciones, el visualizador de datos puede ser una forma rápida de obtener un resumen de las entradas de datos de eventos. Pero hay limitaciones críticas para agregar elementos de datos directamente:
- La consulta incluye todos los valores de elementos de datos encontrados en todos los eventos para las dimensiones de programa, unidad organizativa y periodo dadas. Si el elemento de datos está presente en varias etapas, o se encuentra dentro de una etapa repetible, entonces esos valores de elementos de datos se agregarían juntos.
- Sólo se puede utilizar la fecha del evento como dimensión temporal, no la fecha de inscripción, ni un límite de periodo retrospectivo para crear una "cohorte" de eventos desde antes de que comenzara el periodo.
- No se puede agregar por un valor de conjunto de opciones (variable categórica), como el total de eventos en los que el elemento de datos "Resultado" es "Curado".
- No se pueden aplicar filtros para excluir valores de elementos de datos numéricos introducidos por error por encima o por debajo de umbrales, como excluir todos los "pesos de lactantes superiores a 10.000 g".
- No puede aplicar crear desagregaciones basadas en un segundo dato de suceso, ya sea numérico o categórico, como "peso al nacer, por encima y por debajo de 35 semanas de gestación" o "peso al nacer por sexo".
- Tenga en cuenta que con la aplicación Mapas, puede aplicar filtros de elementos de datos de eventos a las consultas de la capa de eventos. Las consultas filtradas también pueden agregar valores a niveles geográficos superiores. Estos filtros no están disponibles en la aplicación Visualizador de datos.
Y lo que es más importante, es muy difícil mostrar recuentos básicos de eventos o recuentos de inscripciones con criterios determinados en la aplicación de visualización de datos. En el caso de los rastreadores habituales en el ámbito sanitario, lo que se desea es generar un simple recuento de pacientes o encuentros que cumplen determinadas condiciones. La agregación de valores de elementos de datos individuales no es tan esencial.
Indicadores de programa
Los indicadores de programa (IP) permiten configurar fácilmente consultas de varios niveles de los datos a nivel individual. Permiten crear valores basados en elementos de datos y/o atributos de entidades rastreadas pertenecientes a los programas de datos individuales. Esencialmente, podemos tomar los elementos de datos individuales dentro de un programa datos individuales y generar valores agregados para utilizarlos en análisis rutinarios.
IP puede utilizarse para resumir datos dentro de un evento o en toda la inscripción, combinando datos introducidos de varias etapas diferentes o atributos de entidad rastreados. Algunas configuraciones también podrían incluir IP en el "TEI tablero" en la web o Android, para proporcionar cálculos a través o dentro de eventos y proporcionar un resumen de la inscripción al usuario durante la entrada de datos (número total de eventos, % de valores de elementos de datos que están en blanco, días desde la última visita, etc.). En esta sección nos centraremos en la configuración de los indicadores del programa para mostrar datos resumidos (recuentos, sumas, promedios, etc.) para todos los eventos o inscripciones dentro de una unidad organizativa/período especificado.
Hay dos tipos de indicadores de programa:
- Evento: Dimensiones basadas en la unidad organizativa del evento y (por por defecto) la fecha del evento. Esto realizará una operación basada en todos los eventos dentro de una única etapa de programa
- Inscripción: Dimensiones basadas en la unidad organizativa de inscripción y (por defecto) la fecha de inscripción. Puede evaluar valores de datos de múltiples etapas del programa, pero cuando se realiza una consulta basada en un único valor de elemento de datos, evalúa los datos del evento más reciente de cada etapa repetible en por defecto.
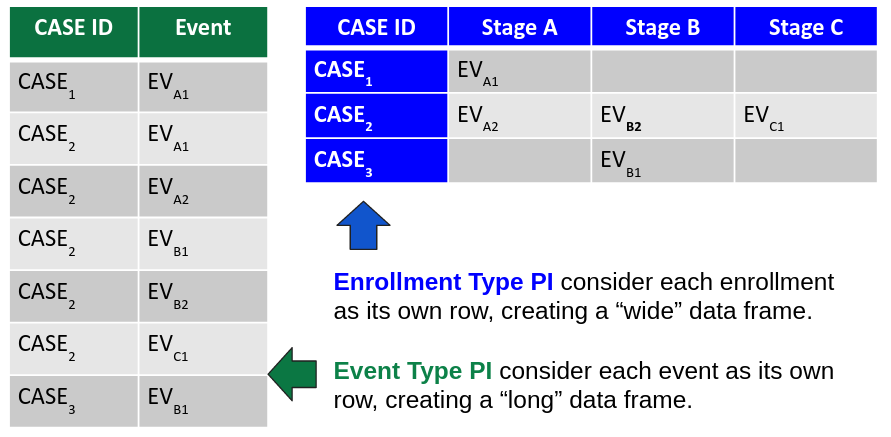
Hay cinco componentes de los indicadores del programa que definen cómo se calcula el valor. Se evalúan en este orden (véase más adelante por qué esto puede ser importante).
| Evaluación | Componente | Comentario |
|---|---|---|
| 1 | Unidad Organizativa | Para IP de tipo evento, es la unidad organizativa del evento. Para IP de tipo inscripción, es la unidad organizativa de la inscripción, aunque algunos eventos de una inscripción se hayan introducido en otro lugar. |
| 2 | Período | Definido por los límites del periodo analítico. Dependiendo del tipo de IP, por defecto es la fecha de inscripción o la fecha del evento que cae entre el inicio y el final del periodo de reporte. |
| 3 | Filtro | Crea un filtro de valores para el evento o la inscripción. Incluye valores de atributo de la TEI, o cualquier elemento de datos dentro de una etapa de programa específica (tipo de evento), o cualquier elemento de datos dentro de cualquier etapa de programa. Se dispone de una variedad de funciones y variables para operaciones adicionales, como el filtrado de TEIs en los que el número de años entre la fecha de inscripción y la fecha de nacimiento es superior a 18. |
| 4 | Expresión | Los criterios anteriores definen qué inscripciones (o evento) incluir. La expresión es el valor que se aplica a cada inscripción (o evento). Normalmente será event_count, enrollment_count o tei_count, pero también puede ser un valor de elemento de datos o una expresión más compleja. |
| 5 | Tipo de agregación | Cómo agregar la expresión aplicada a cada inscripción (o evento). Normalmente "recuento" o "media". |
IP son más potentes en la condición FILTRO para definir si una inscripción o evento cumple ciertos criterios. Los criterios de filtrado pueden derivarse de múltiples elementos de datos y/o eventos y/o atributos de entidades rastreadas. Esta capacidad es de vital importancia para la mayoría de los contextos de informes de casos y centrados en el paciente, donde no se trata de agregar valores de elementos de datos atómicos, sino de contar eventos (encuentros) y pacientes (inscripciones) que cumplen ciertas condiciones.
Por esta razón es altamente recomendable configurar indicadores de programa para todas las necesidades rutinarias de información del sistema datos individuales.
¿Qué es realmente un indicador de programa y por qué es importante?
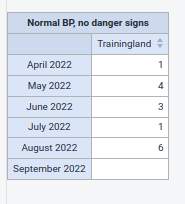
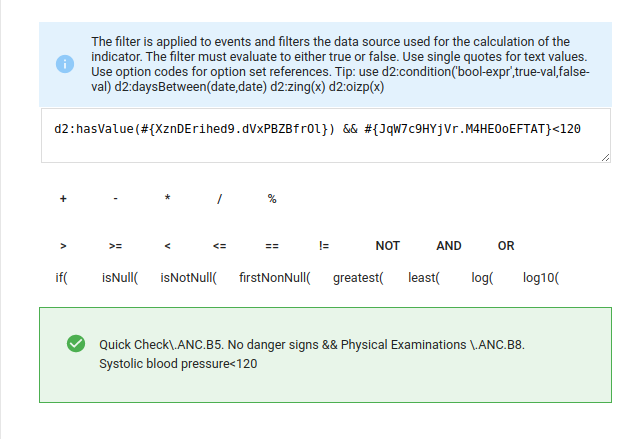
Técnicamente, un indicador de programa es un fragmento de Java preconfigurado que el motor de análisis de DHIS2 puede traducir en una expresión SQL. Cuando se incluye un indicador de programa en una consulta analítica, por ejemplo abriendo un gráfico en Data Visualizer, esa expresión SQL se combina con las dimensiones de periodo y unidad organizativa en una consulta, y la consulta de base de datos resultante de las tablas analíticas de inscripciones y/o eventos devuelve un resultado.
 |  |
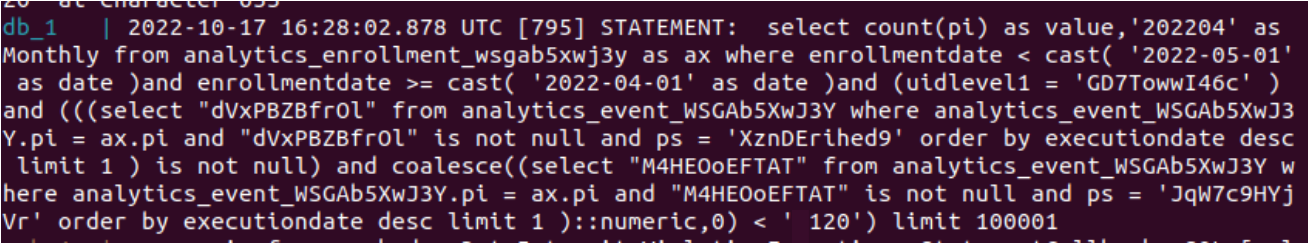
Esta rápida explicación técnica es importante para comprender algunas cosas clave sobre los Indicadores de Programa.
En primer lugar, los IP permiten construir consultas SQL muy complejas con una configuración mínima por parte del diseñador del sistema. En el ejemplo anterior, una sola línea de código en el filtro IP produce 8 líneas de código SQL, que se repetirían para cada período y dimensión de unidad organizativa de una consulta analítica. En comparación con las consultas SQL, los indicadores de programa son relativamente fáciles de configurar y, cuando se gestionan con habilidad, son lo suficientemente flexibles como para cubrir la mayoría de las consultas importantes que necesitaría realizar en los datos individuales.
En segundo lugar, los valores de los indicadores de programa no se almacenan en la base de datos DHIS2, sino que proporcionan un marco para una consulta a las tablas de análisis de la base de datos que se realiza "sobre la marcha", o tan pronto como un usuario final carga una visualización con un indicador de programa. Esto significa que no es necesario volver a generar tablas de análisis cada vez que se crea o edita un indicador de programa.
Estos dos puntos tienen ventajas y desventajas. Los IP son flexibles y fáciles de configurar, pero las consultas SQL resultantes no están optimizadas para el rendimiento y, a gran escala, pueden ser muy ineficaces. Los IP también se calculan bajo demanda, lo que significa que cada vez que un usuario carga un tablero con indicadores de programa, también desencadena una consulta a la base de datos. Muchos usuarios pueden realizar conjuntamente consultas analíticas simultáneas e ineficaces, lo que somete al servidor a una tensión innecesaria y provoca una ralentización importante de todo el sistema.
Country Case Study
Las repercusiones en el rendimiento de los indicadores del programa fueron evidentes durante las campañas de vacunación de Covid-19, cuando millones de datos individuales inscripciones fueron consultadas por cientos de paneles de control de usuarios finales diariamente, lo que a menudo provocó graves problemas de rendimiento. Las lecciones aprendidas de esta experiencia proporcionaron un marco con técnicas específicas para mejorar los análisis de datos individuales a escala, como datos individuales-to-Aggregate scripts para escribir periódicamente valores de indicadores de programa en elementos de datos agregados.
Por último, al igual que los elementos de datos agregados, los indicadores de programa requieren una dimensión de unidad organizativa y una dimensión de periodo para devolver un valor significativo. Pero mientras que un elemento de datos agregados se introduce para un único periodo y una única unidad organizativa, los datos individuales son naturalmente mucho más complicados: una única inscripción tendrá probablemente múltiples eventos a lo largo del tiempo, y cada evento puede ser introducido por diferentes centros. Sin embargo, el IP producirá en última instancia un único valor para cada combinación de unidad organizativa y periodo. Por lo tanto, cuando diseñe indicadores de programa, deberá considerar cuidadosamente cómo interpretar el "dónde" y el "cuándo" de sus datos longitudinales.
A continuación se ofrecen ejemplos ilustrativos de los retos que se plantean a la hora de definir y configurar los indicadores de programa, en particular en lo que respecta al tipo de indicador de programa, los límites del periodo, la asignación de unidades organizativas y la (des)agregación.
Reto común 1: Indicadores de programa de tipo evento vs inscripción
La decisión más importante a la hora de crear un indicador de programa es si debe ser de tipo evento o de tipo inscripción.
La mayoría de los implementadores saben que ambos tipos de IP pueden filtrar por valores de elementos de datos y/o valores de atributos de entidad rastreada (TEA). Y si el indicador de programa debe evaluar valores de dos o más etapas del programa, sólo se puede utilizar IP de tipo inscripción.
Pero un error muy común es confundir los dos tipos cuando se agregan datos de etapas de programas repetibles.
Recuerde que los eventos representan encuentros distintos y las inscripciones representan expedientes distintos. Cuando se utilizan indicadores de programa para producir recuentos agregados de datos individuales, se aplica la misma lógica conceptual: en general, utilizamos IP de tipo evento cuando queremos contar distintos encuentros, y utilizamos tipo inscripción cuando queremos contar distintos expedientes de casos (o personas).
Los responsables de la aplicación deben preguntarse: ¿quiero resumir todos los encuentros o sólo los de las personas únicas?.
En este ejemplo de la academia de datos individuales Use Level 1, estamos contando casos con condiciones subyacentes en un programa de vacunación Covid-19. El elemento de datos "COVAC - Afecciones subyacentes" se encuentra en una etapa de programa repetible.
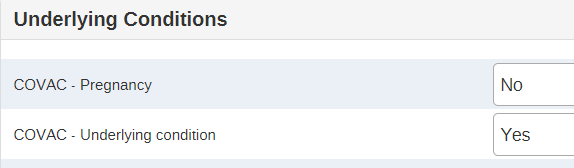
Elaboramos dos indicadores de programa: uno es de tipo inscripción con agregación de recuento de inscripciones, y el otro es de tipo evento utilizando una agregación de recuento de eventos.
Verá que el indicador basado en eventos reporta valores más altos ya que está contando la variable de condición subyacente para cada evento; esto no tiene sentido en este escenario si quiere saber el número total de personas únicas con una condición subyacente.

¿Por qué?
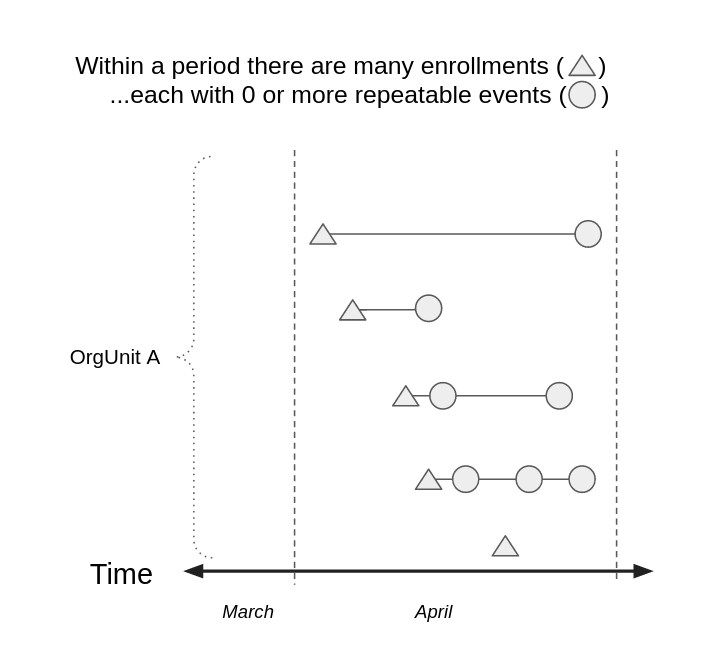
Un mismo paciente puede tener varios eventos con este valor de elemento de datos. Todos estos eventos pueden tener lugar en el mismo periodo. Además, una misma persona puede tener incidentes en diferentes distritos (unidades organizativas). Por lo tanto, existe un alto riesgo de doble recuento de personas con los IP de tipo evento.
Mientras tanto, sólo hay una fecha de inscripción y una unidad organizativa de inscripción asociada a cada inscripción.
 |  |  |
Si desea contar individuos únicos, el tipo de inscripción suele ser el mejor enfoque.
Pero eche otro vistazo al indicador de programa de ejemplo para Afecciones subyacentes. Es posible que haya un inscrito con dos respuestas distintas a esa pregunta. Tal vez una afección subyacente no se notificó en la visita inicial y en una visita posterior el valor es diferente. ¿Cómo manejaría un indicador de programa de tipo inscripción múltiples valores para un elemento de datos en la misma etapa del programa?
Dentro de una etapa de programa que tiene eventos repetidos, los indicadores de tipo inscripción utilizan los datos del evento más reciente que tiene un valor para ese elemento de datos. En el diagrama siguiente, las inscripciones no se cuentan si no tienen ningún evento para la etapa de programa en el filtro, y sólo se evalúan los eventos con un valor para el elemento de datos.
Suele ser útil considerar sólo el valor más reciente para cada caso, ya que ese valor puede considerarse más oportuno y más preciso. Pero en algunos casos, se desea evaluar todas las inscripciones que alguna vez tuvieron un determinado valor para un elemento de datos. Aquí es donde la clase de funciones d2:count son útiles en el filtro del IP. Aseguran que el indicador de programa evalúa todos los eventos dentro de cada inscripción y cuenta el número que cumple los criterios.
Utilizando estas funciones en los filtros indicadores de los programas se puede responder a preguntas como ésta:
d2:count(#{jdRD35YwbRH.zocHNQIQBIN})>=1
¿Cuántos pacientes con tuberculosis han obtenido al menos un resultado en la prueba de baciloscopia?
d2:countIfValue(#{jdRD35YwbRH.zocHNQIQBIN},'Positivo')>=1
¿Cuántos pacientes con tuberculosis tuvieron al menos un resultado _positivo en una prueba de baciloscopia?_
d2:countIfCondition(#{edqlbukwRfQ.vANAXwtLwcT},'>8')>=1
¿Cuántos embarazos tuvieron al menos una visita a AP con un valor de hemoglobina superior a 8?
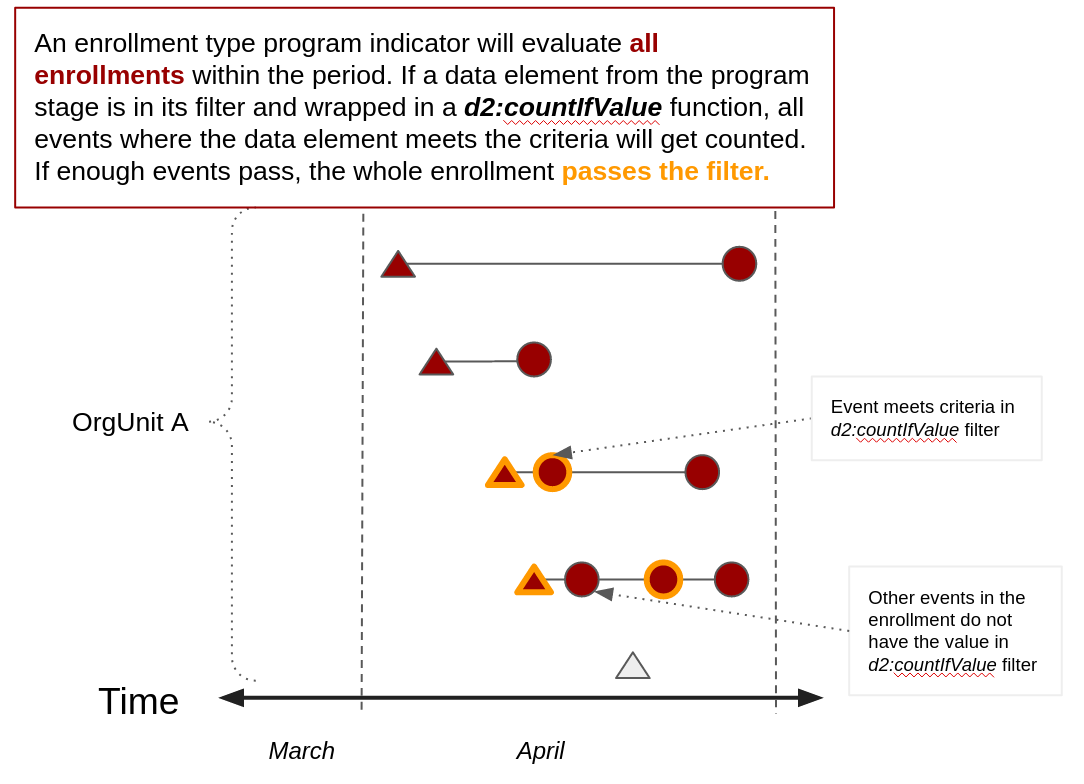
Puede construir un filtro de indicador de programa con una combinación de elementos de datos y valores de atributo de entidad rastreada (TEA). Con los indicadores de inscripción, estos elementos de datos pueden proceder de diferentes etapas del programa, e incluso puede buscar un valor de elemento de datos que cumpla ciertos criterios dentro de todos los eventos de una etapa. Sin embargo, no puede construir múltiples subexpresiones dentro de un filtro d2:countIfCondition para asegurarse de que dos valores de elementos de datos están presentes en el mismo evento.
Por ejemplo, puede filtrar las inscripciones en las que algún evento haya notificado Afecciones subyacentes:
d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Sí')>=1
Y puede filtrar las inscripciones en las que cualquier evento haya notificado un Embarazo y cualquier evento haya notificado Afecciones subyacentes:
d2:countIfValue(#{covacprogramUID.pregnancymarkUID},'Sí')>=1 && d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Sí')>=1
Pero NO SE PUEDE filtrar que tanto el embarazo como las condiciones subyacentes fueron reportadas en el MISMO evento con indicadores de programa de tipo inscripción. Ese tipo de evaluación (dos valores dentro del mismo evento) sólo es posible en indicadores de programa de tipo evento.
Por último, las implementaciones a gran escala deben tener en cuenta que cuando se añaden funciones count* al filtro, esto añadirá retos de rendimiento para la evaluación del IP. En el backend, los indicadores de tipo inscripción se unen a la tabla analytics_enrollment_[programUID] con analytics_event_[stageUID] cada vez que se consulta el indicador de programa. Cada uso de count* durante esta consulta conducirá a una exploración independiente de la tabla de eventos y a una unión independiente. La flexibilidad de d2:countIf ha provocado algunos de los mayores retrasos observados en la carga de cuadros de mando.
Las diferencias entre los dos tipos de IP se detallan en la siguiente tabla.
| Tipo evento | Tipo inscripción | |
|---|---|---|
| Unidad Organizativa dx | Unidad organizativa del Evento | Unidad organizativa de la inscripción |
| Periodo dx (por defecto) | Fecha del evento | Fecha de inscripción |
| Puede filtrar por valores TEA | Sí | Sí |
| Puede filtrar por varios valores en una sola etapa no repetible | Sí | Sí |
| Puede filtrar por varios valores en una etapa repetible | Sí | Selecciona el valor del último evento de la etapa en periodo*. |
| Puede filtrar por valores en varias fases del programa | No | Sí |
* Si se aplica una función d2:countIfValue, el valor puede aparecer en cualquier evento de una etapa repetible. Si la función se aplica a múltiples elementos de datos, cada uno de los valores de elementos de datos en una etapa repetible puede ocurrir, pero a través de diferentes eventos.
Reto común 2: Periodicidad de los indicadores de programa
Todas las consultas analíticas requieren al menos una dimensión de periodo, como "Última semana", "Enero de 2022" o "Este año". Sin embargo, los datos individuales son longitudinales por naturaleza y, por lo tanto, no están vinculados intrínsecamente a un único periodo base.
Los indicadores de programa definen el período de una consulta analítica mediante límites de periodo analítico.
Cualquier fecha derivada de los datos individuales puede utilizarse como límite de período para evaluar los datos individuales. Si el valor de la fecha especificada cae dentro del rango establecido por estos límites de periodo, entonces esa inscripción o evento se incluye dentro de la consulta.
Al elegir el tipo de indicador de programa se configuran automáticamente dos valores por defecto.
- Por defecto, la fecha que se utilizará como límite de período viene determinada por el tipo de indicador de programa. Los IP de tipo inscripción utilizan la fecha de inscripción como objetivo, mientras que los IP de tipo evento utilizan la fecha de evento.
- En por defecto, los límites del periodo se establecen en el inicio y el final del periodo de reporte en la consulta analítica.
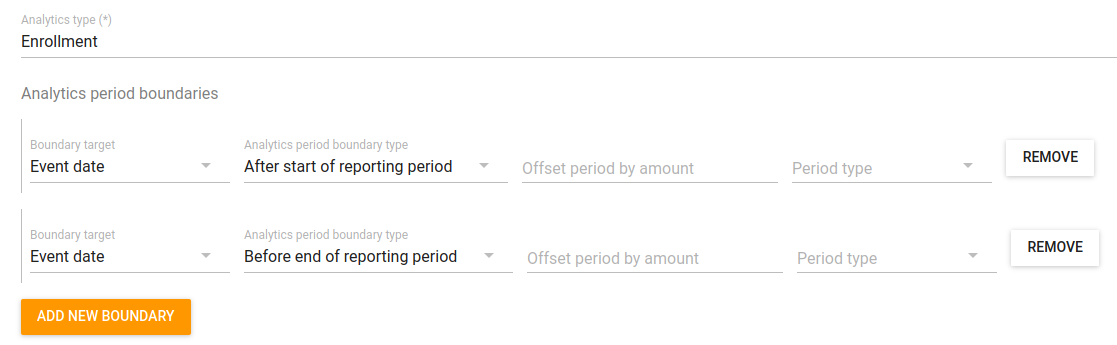
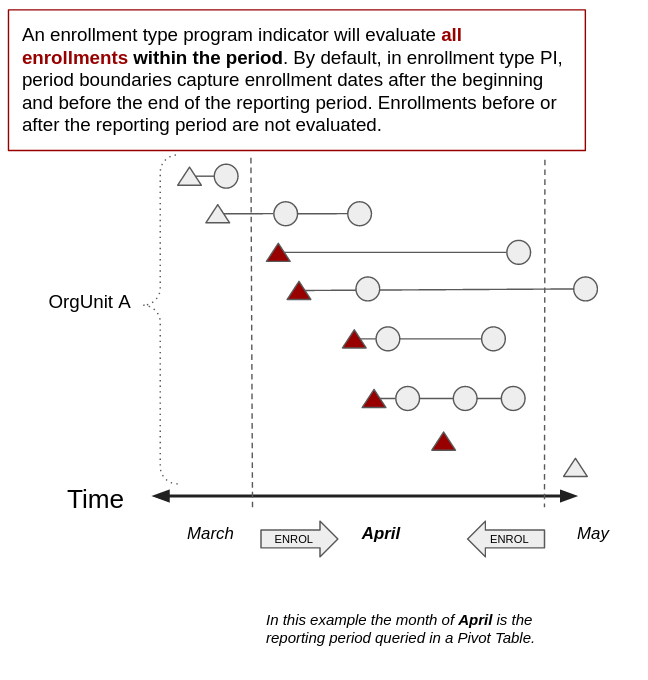
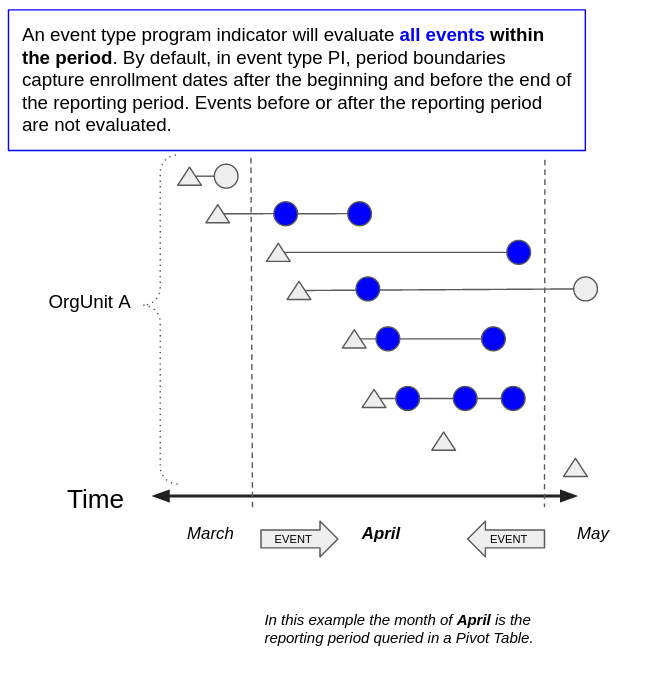
Esto significa que para la mayoría de los indicadores de programa de tipo evento, la periodicidad del indicador de programa se define como las fechas del evento que caen dentro del período de reporte. Para la mayoría de los indicadores de programa de tipo inscripción, la periodicidad del indicador de programa se define como las fechas de inscripción que caen dentro del período de reporte.
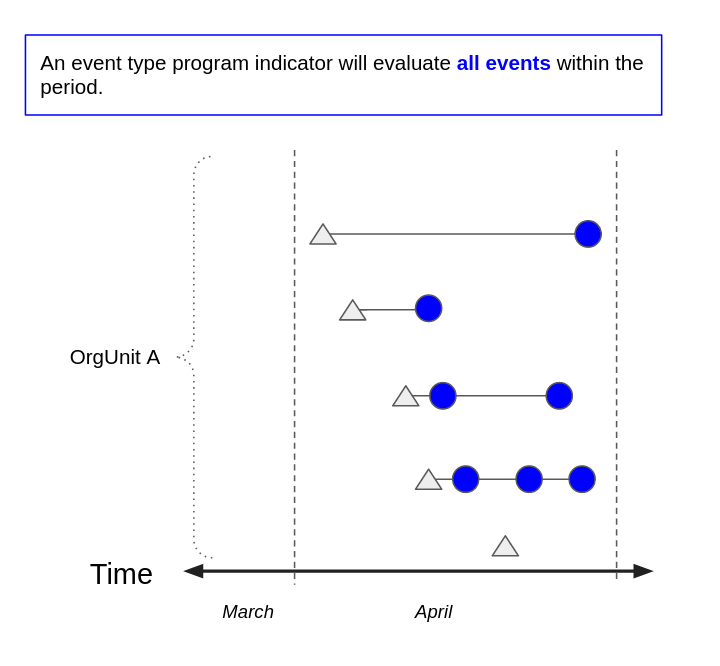
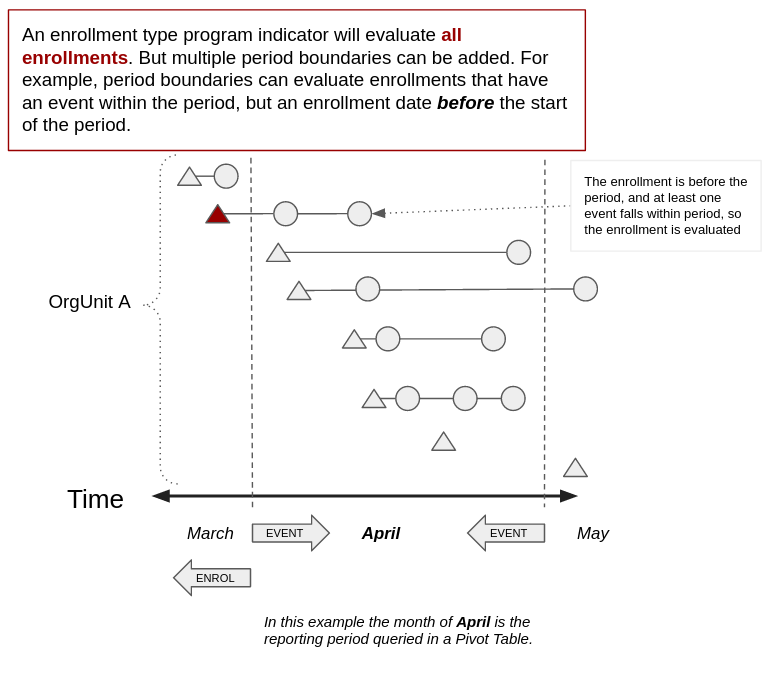
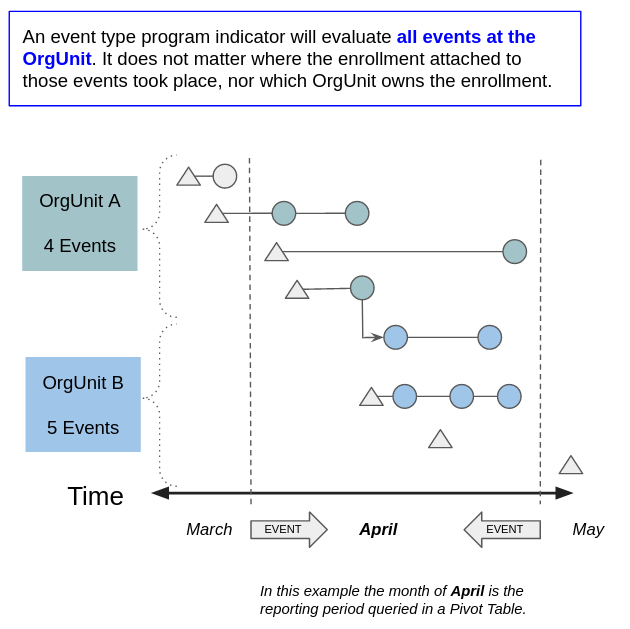
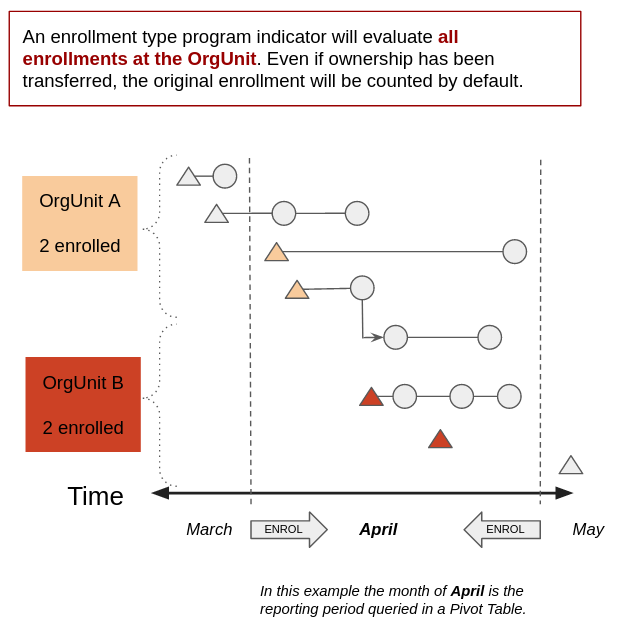
Los siguientes diagramas muestran cómo los límites del período por defecto para los IP de tipo evento y de tipo inscripción seleccionan los eventos o inscripciones a evaluar. Si coloca un indicador de programa en una tabla pivote para consultar eventos en abril de este año, los límites de por defecto para un indicador de programa de tipo evento evaluarán todos los eventos ocurridos dentro del mes de abril de este año.
 | |
No obstante, estos límites del periodo por defecto pueden adaptarse a necesidades analíticas específicas.
Eliminación de un límite de período
Puede ser útil pensar en la primera palabra de un tipo de límite de período, "antes" o "después", como flechas que apuntan hacia atrás o hacia delante en el tiempo. Si se establecen dos límites con direcciones temporales opuestas ("después del inicio" y "antes del final"), se garantiza que los límites queden cerrados. Si elimina uno de los dos, los límites quedan abiertos. Esto se puede utilizar para crear un indicador de programa acumulativo, como en "contar todas las inscripciones antes del final del periodo de reporte". Una consulta para el mes de abril seleccionaría todas las inscripciones desde cualquier momento antes del final de abril.
Tenga en cuenta que dicho IP de "recuento acumulado" debe utilizarse con precaución debido a las implicaciones de rendimiento. Si tuviera que consultar los últimos 12 meses de datos con un IP de recuento acumulativo, se realizaría una consulta acumulativa separada para cada uno de esos periodos mensuales, en lugar de sumar los recuentos mensuales subsiguientes (sumando el total del Mes 2 al valor acumulativo del Mes 1, sumando el total del Mes 3 a ese valor acumulativo del Mes 2, etc.).
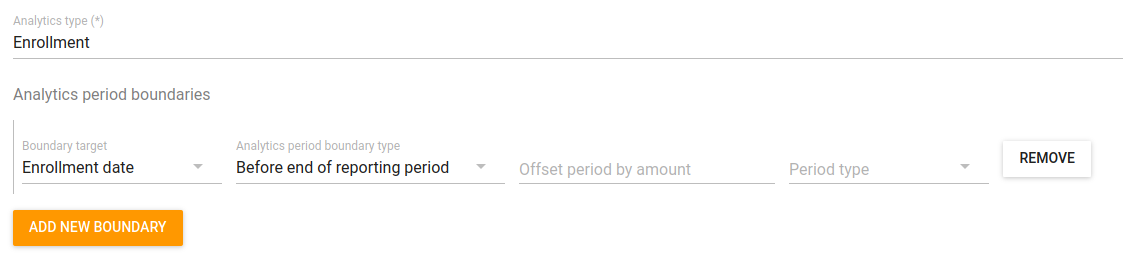
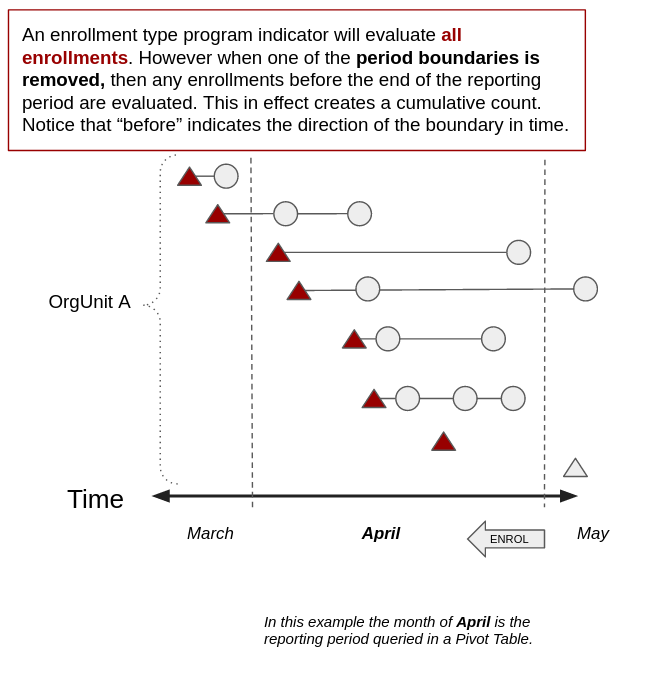
Añadir y mezclar límites de periodo
Cuando se trabaja con IP de tipo inscripción para filtrar por valores de datos de dos o más eventos, un error común es pensar que los límites del periodo abarcarán el periodo en el que ocurrieron esos eventos. Pero como se ha descrito anteriormente, los límites de periodo de por defecto se dirigirán a todas las _fechas de inscripción _dentro del periodo. En los programas de gestión de casos en los que los casos suelen estar activos durante mucho tiempo, por ejemplo un programa de vigilancia de casos VIH, la mayoría de las fechas de inscripción pueden ser en realidad muchos meses o años anteriores al periodo de interés.
En tales escenarios, puede cambiar los límites de período de un IP de tipo inscripción a la fecha del evento. A continuación, se evalúan todas las inscripciones con al menos un evento en el período de reporte.
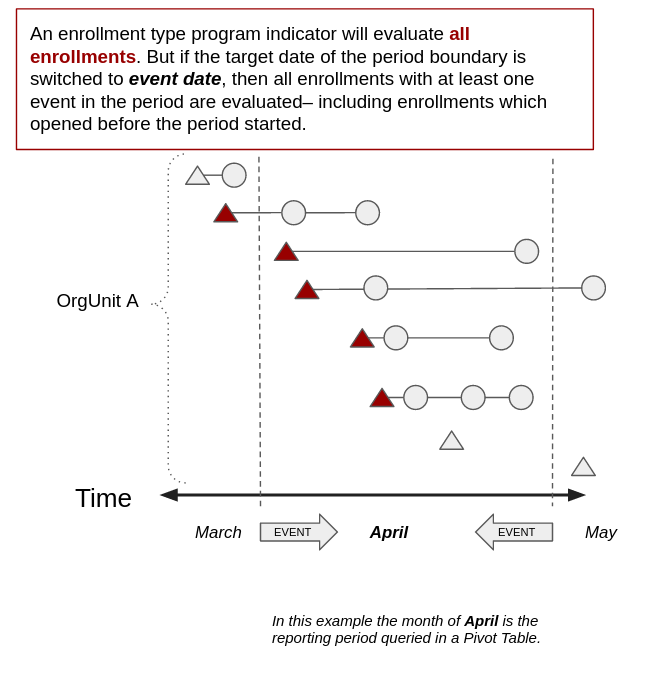
Al igual que se pueden cambiar o eliminar los límites de periodo, también se pueden superponer varios tipos de límites de periodo para restringir aún más la periodicidad.
Por ejemplo, puede tener un IP de tipo inscripción que restrinja la evaluación a fechas de eventos dentro del periodo, y fechas de inscripción anteriores a la fecha de inicio del periodo. Esto garantiza que todos los eventos evaluados son "seguimientos", ya que la inscripción se abrió por primera vez en un periodo anterior.
Consejo
Si incluye un valor de elemento de dato en el filtro, el IP consultará el valor del elemento de dato en el último evento de seguimiento de este mes. Si ese valor de elemento de datos está envuelto en una función
d2:countIfValue(), la consulta IP buscará valores de elemento de datos de todos los eventos de seguimiento de este mes.
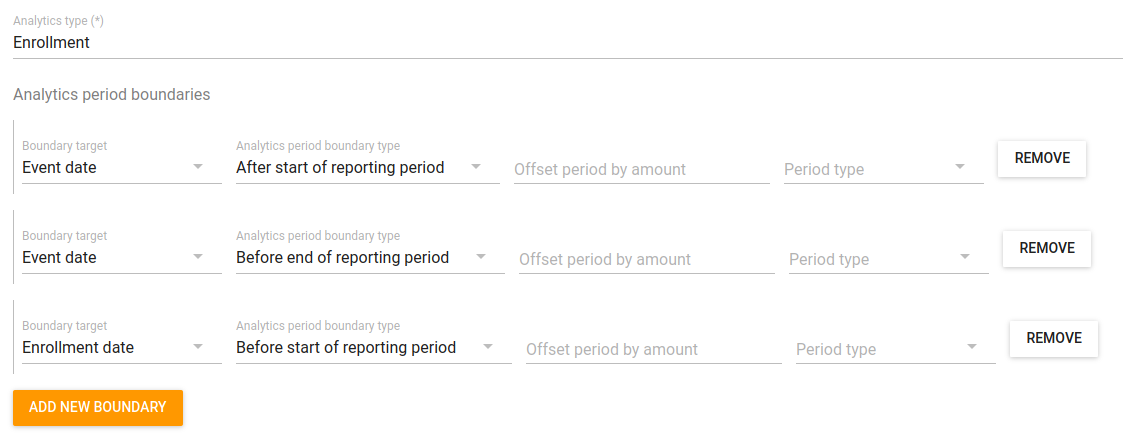
Si el objetivo delimitador debe restringirse a los eventos de una etapa específica, puede seleccionar "Custom" boundary target, e introducir el texto PS_EVENTDATE:{programStageUid}
El objetivo de límite personalizado también podría ser un atributo de entidad rastreada (TEA) o un elemento de datos de tipo de datos de fecha, por ejemplo una fecha de nacimiento TEIA, o un valor de elemento de datos para "fecha de resultado de prueba de laboratorio". Consulte la Guía del usuario para obtener más ejemplos de objetivos límite personalizados y elementos de datos adicionales.
Período Límite Desplazamientos
En la mayoría de los escenarios, el periodo de la consulta analítica es el periodo en el que deben tener lugar los eventos o las inscripciones. En unos pocos casos de uso muy específicos de análisis longitudinal, el indicador del programa debe evaluar los datos individuales de una cierta cantidad de tiempo antes (o después) del periodo de reporte. Se denominan cohortes y pueden ser útiles en diversos contextos:
- Abandonos: evaluación de las inscripciones en las que se esperaba que se produjeran eventos en el periodo de reporte, pero no tuvieron lugar.
- Intervalos de eventos previstos que no coinciden con el intervalo del periodo de reporte:
- Se debe realizar una prueba de laboratorio 6 semanas después de una visita hospitalaria.
- La visita rutinaria de control de la hipertensión debe ser cada 5 semanas, y usted quiere saber cuántos tenían la tensión arterial controlada en su última visita de los tres meses anteriores
- Gestión del programa: una cohorte de VIH cuenta los pacientes que han estado inscritos en TAR durante seis meses exactos en algún momento del periodo, y de esos pacientes, cuántos se han sometido a una prueba de carga viral.
Al definir un límite de período, dos valores opcionales -Desplazar período por importe y Tipo de período- definen cómo mover ("desplazar") el límite del período en relación con el período del informe.
En el siguiente ejemplo, los límites del periodo de análisis para un IP de tipo inscripción se desplazan un mes hacia atrás. El tipo de periodo de desplazamiento es Mensual, y el periodo de desplazamiento por importe es -1.
Así es como creamos una cohorte con nuestro indicador de programa desplazando la ventana de análisis para examinar los datos individuales de un marco temporal anterior, relativo al periodo de análisis.
Importante
Los desfases de período con valores negativos reposicionarán el objetivo hacia atrás en el tiempo. Los límites de desfase positivos son más raros en la práctica, ya que evalúan datos individuales datos de después de que el período de información haya finalizado. Se trata de un escenario poco probable para el "análisis en tiempo real" en casos de uso rutinario de HIS.
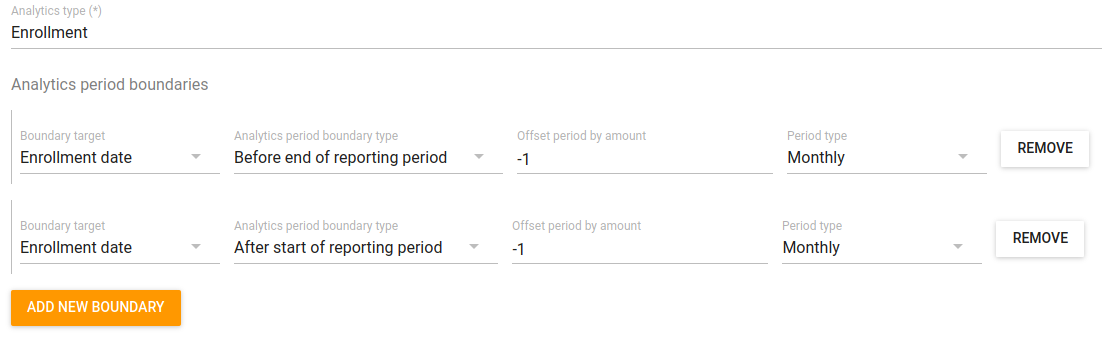
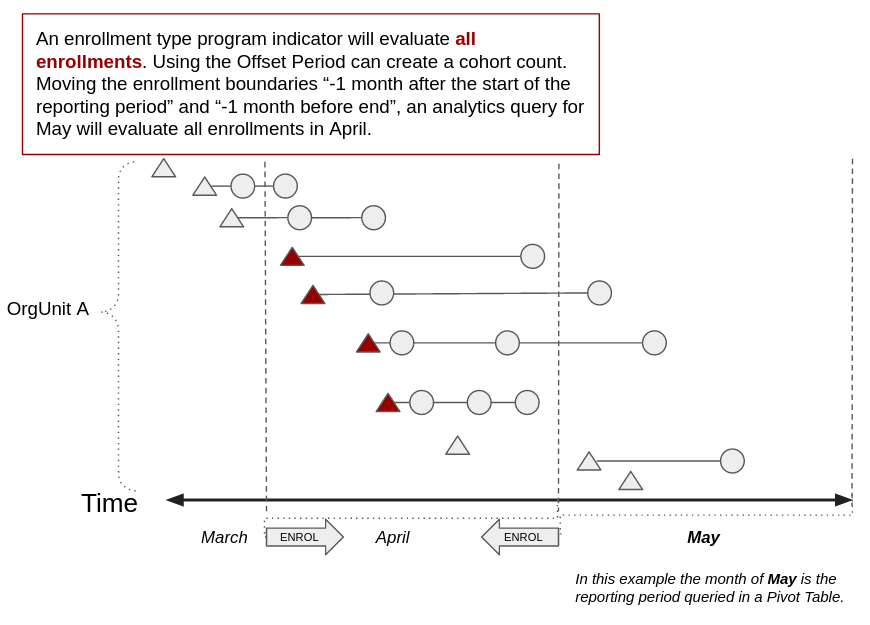
Lo importante de este ejemplo es observar que el límite de inscripción simplemente se ha desplazado a exactamente un mes antes de que se abriera el periodo de análisis, y finaliza un mes antes de que se cierre el periodo de notificación.
- Una consulta para el mes de mayo muestra las inscripciones introducidas para el mes de abril.
- Una consulta anual para el año 2022 evaluaría en realidad todas las inscripciones desde el 1 de diciembre de 2021 hasta el 30 de noviembre de 2022.
- Una consulta semanal para la semana 18 de 2023 (del 1 al 7 de mayo) también se desplazaría un mes hacia atrás y evaluaría todas las inscripciones del 1 al 7 de abril de 2023.
Para basarse en el indicador de programa "cohorte", puede combinar los límites de periodo de la fecha de inscripción y de la fecha del evento como en la sección anterior, pero utilizando eficazmente el desplazamiento de periodo.
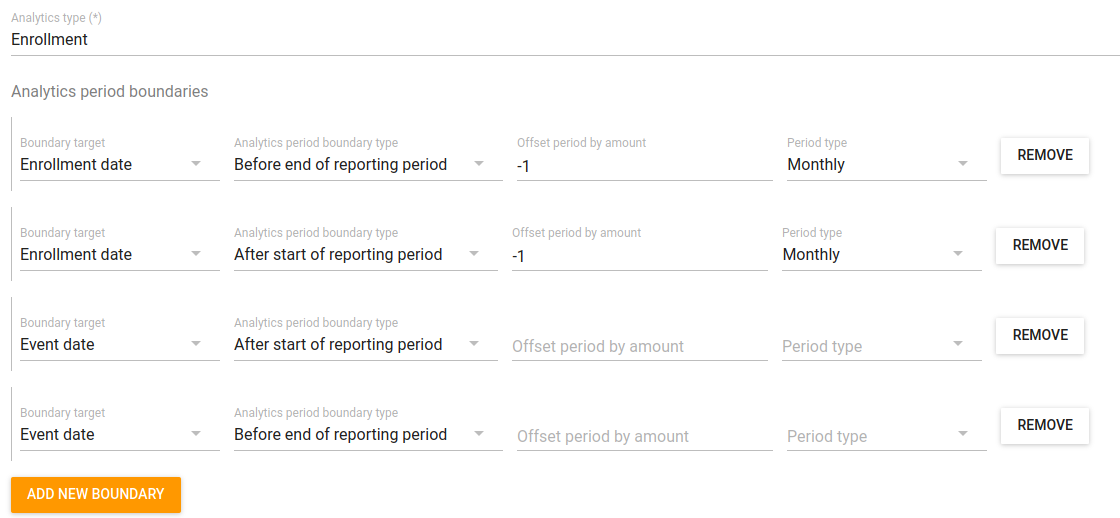
En este ejemplo, queremos contar las inscripciones que se crearon en el mes anterior pero que tuvieron al menos un evento en el mes actual del informe. Esto podría ser útil para describir el seguimiento de los casos: ¿cuántos casos nuevos de su programa tuvieron una visita de seguimiento en el plazo de un mes?
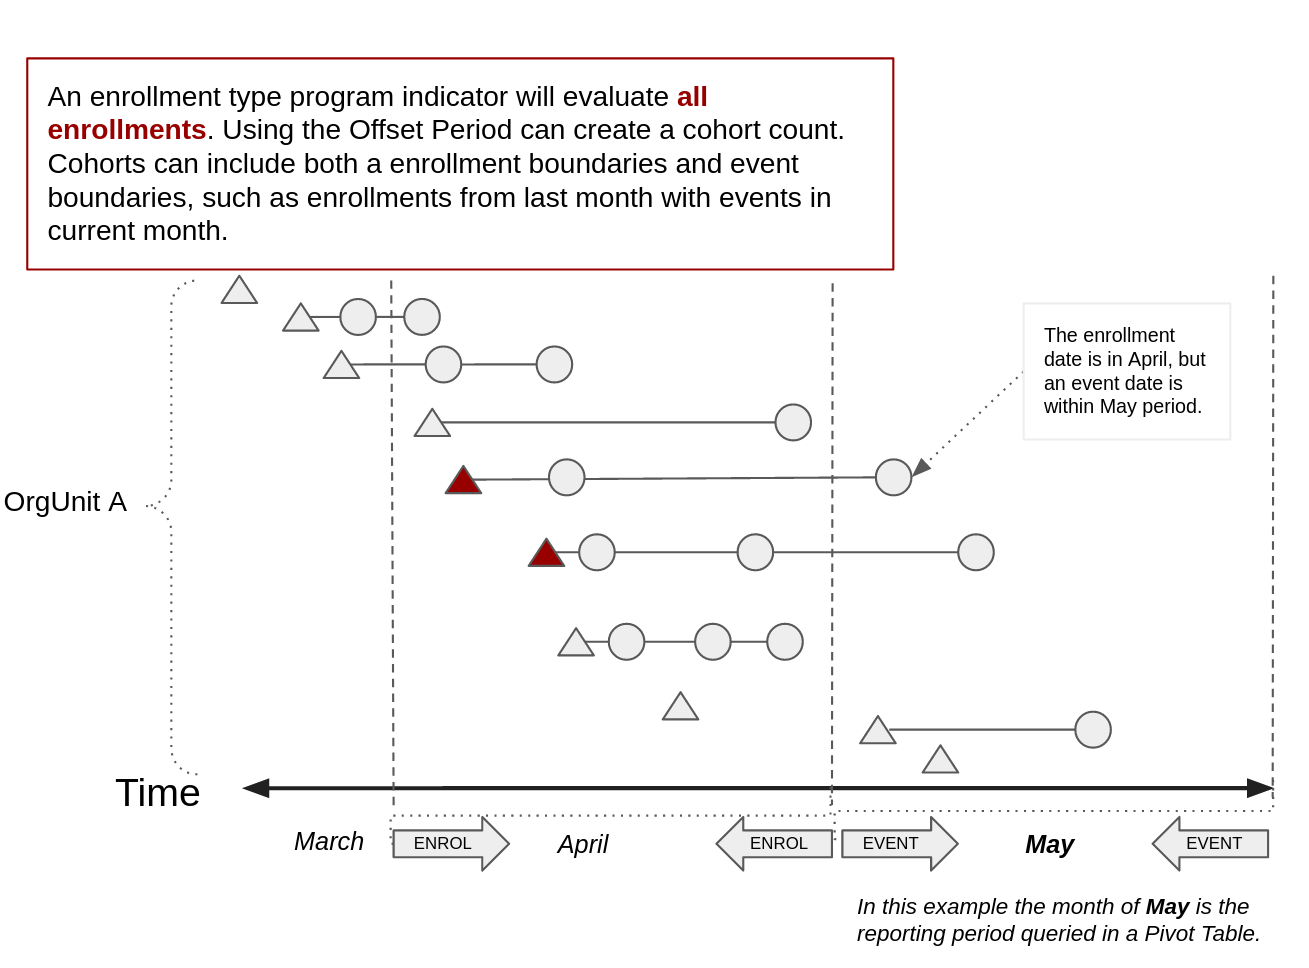
¿Cohorte de ventana fija o cohorte de ventana relativa?
Observe que aún hemos definido desplazamientos de periodo en ambos límites de periodo de apertura y cierre para la fecha de inscripción. Aquí, la "ventana" para nuestra cohorte son todas las inscripciones introducidas desde un mes antes de que se abra el periodo de análisis hasta un mes antes de que se cierre el periodo de análisis. Esta ventana de cohorte es por tanto dependiente de la duración del periodo analítico.
Si los usuarios finales seleccionan un periodo de análisis semanal, la ventana de cohorte tendría una duración de una semana, mientras que si seleccionan un periodo de análisis anual, la ventana de cohorte tendría una duración de un año, y así sucesivamente.
Esto no es ideal para muchas situaciones de análisis de cohortes, en las que una duración fija de la ventana de cohorte es elemental en la definición del propio indicador del programa. Por ejemplo, es posible que desee averiguar cuántos pacientes con hipertensión tuvieron una visita de seguimiento exactamente 90 días después de la inscripción. O bien, desea definir una ventana de cohorte mensual como la anterior, pero calcular el número medio mensual de casos en esta cohorte mensual a lo largo de un año.
Una opción es utilizar una cohorte flexible de "ventana relativa", pero indicar en el nombre o la descripción del indicador de programa que sólo debe utilizarse con tipos específicos de periodos, por ejemplo, mensuales. Sin embargo, es probable que esto se preste a malas interpretaciones.
Si su indicador de programa especifica una ventana fija para la cohorte, es mejor basar la apertura y el cierre de los límites del período de la cohorte en un único punto, como el comienzo del período analítico. Este enfoque garantiza una duración fija de la ventana de cohorte, independientemente del periodo consultado.
En el ejemplo siguiente, se genera una cohorte de inscripción mensual, aunque el periodo de notificación sea semanal. Se podría imaginar la adición de límites dirigidos a la fecha del evento, para responder a la pregunta "¿cuántos casos inscritos en el mes anterior han tenido una visita de seguimiento en la semana actual?".
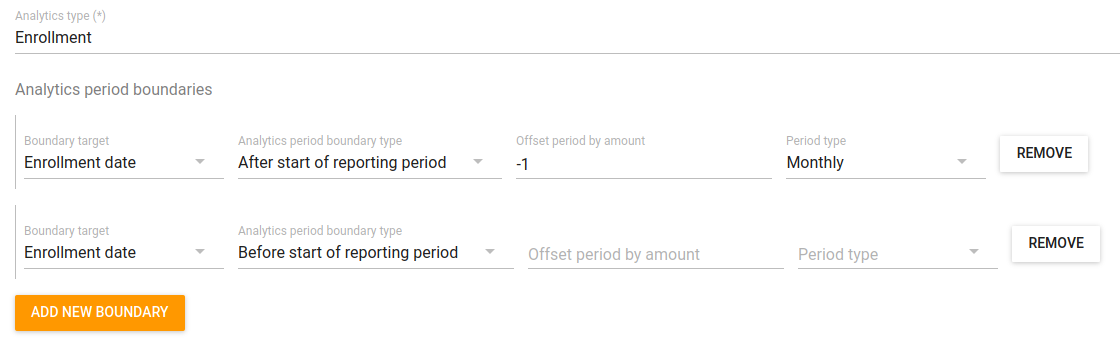
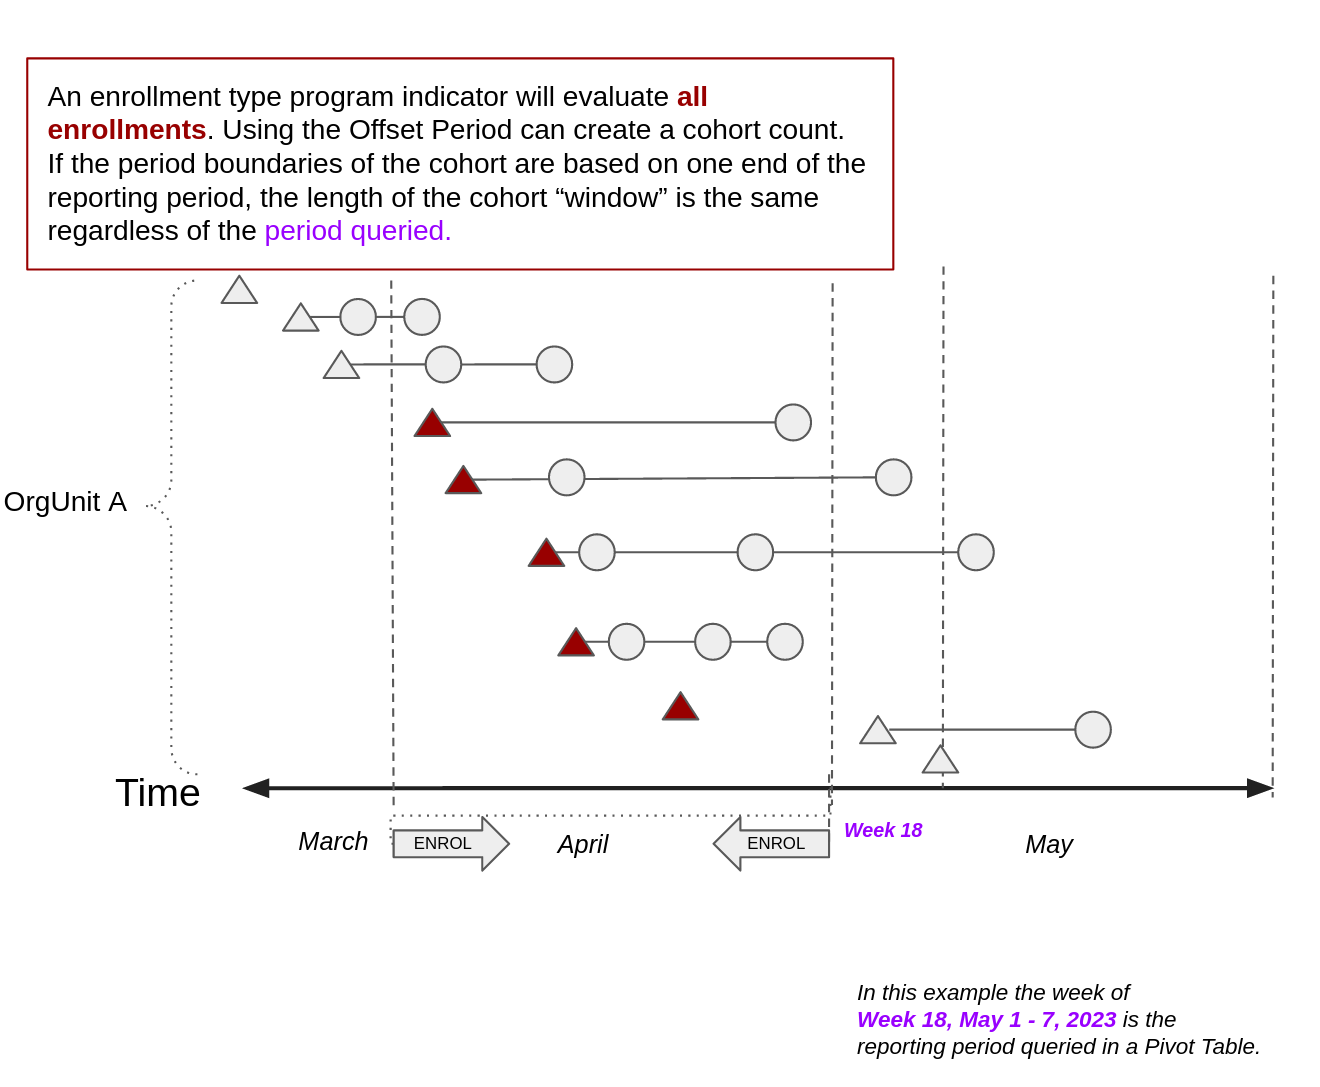
Tenga en cuenta que, dado que la duración de la cohorte es una parte fija y esencial de la definición del indicador de programa, tendría que crear un nuevo indicador de programa para cada duración fija de la cohorte necesaria (cohorte mensual, cohorte semanal, etc.).
Reto común 3: Transferencias y Propiedad
Las secciones anteriores sobre análisis de datos individuales han examinado las complejidades que surgen de los datos longitudinales episódicos a través de una única dimensión: el tiempo. Sin embargo, otra dimensión esencial es la localización. Como hemos visto anteriormente, la unidad organizativa es el primer componente que se analiza cuando se calcula un indicador de programa. Entonces, ¿cómo determinar la "localización" de una inscripción cuando sus eventos asociados tuvieron lugar realmente en múltiples unidades organizativas distintas?
En los sistemas sanitarios, las personas suelen trasladarse de un centro de salud a otro para recibir servicios por la misma dolencia. Puede que se les diagnostique en un centro de atención primaria y luego se trasladen a una clínica especializada para recibir tratamiento. Los resultados de las pruebas pueden ser introducidos por un técnico de laboratorio en otro centro. Un agente de salud comunitario puede hacer un seguimiento con una visita domiciliaria una vez iniciado el tratamiento.
Dependiendo del contexto, el movimiento de pacientes puede ocurrir con alta frecuencia. En un ensayo de DHIS2 datos individuales para la atención prenatal en Bangladesh for example, pregnancy registrations and follow up treatment could be provided both by community health workers and public rural health clinics, all sharing the same patient health record on a Tracker program with Open access. Out of about 14,000 total registrations, el 81% tuvo al menos una visita de seguimiento después del registro inicial; de las 7750 visitas de seguimiento, aproximadamente el 8% se produjo en una unidad organizativa distinta del registro. Esto significa que diferentes centros públicos, incluso diferentes tipos de centros, prestaron servicios a la misma persona.
En DHIS2 captura de datos individuales, varias unidades organizativas pueden introducir datos de eventos para la misma inscripción. Existen tres formas diferentes en las que el segundo centro ("Org Unit B") puede acceder a un registro de inscripción creado en otro centro ("Org Unit A") y crear un nuevo evento.
- El paciente realiza una visita espontánea a la OrgUnit B. Esto supone que el Ámbito de Búsqueda del usuario permite el acceso a TEI registrados en la OrgUnit A. También supone que el nivel de acceso al programa es Abierto, Auditado o Protegido. (Véase Docs para una explicación de los diferentes niveles de acceso al programa).
- El usuario de la OrgUnit A realiza una One-time Referral a la OrgUnit B. El programa puede tener cualquier nivel de acceso para permitir esto, sin embargo la OrgUnit B necesitará tener asignado el programa. Los usuarios de la OrgUnit B sólo podrán introducir datos para un único evento dentro de la etapa del programa especificada, y no podrán editar los eventos anteriores.
- El usuario de la OrgUnit A realiza una Transferencia Permanente a la OrgUnit B. El programa puede tener cualquier nivel de acceso para permitir esto, sin embargo la OrgUnit B necesitará que se le asigne el programa. Esto difiere de la Transferencia Única ya que la OrgUnit B tendrá acceso de edición a todas las etapas del programa para la inscripción, que también será accesible a la OrgUnit B en las listas de trabajo y a través de la búsqueda. Después de esta transferencia, podría decirse que esta inscripción ahora "pertenece" a la orgUnit B porque se le ha conferido la Propiedad.
En la guía del usuario encontrará información sobre cómo utilizar "One-Time referral" y "Move Permanently" en la aplicación Tracker Capture. Actualmente se están diseñando flujos de trabajo de transferencia y referral para la aplicación Capture.
Hagamos un diagrama de cómo los indicadores de programa manejan las inscripciones con eventos de diferentes OrgUnits. En los ejemplos de abajo, se hace una transferencia permanente de OrgUnit A a OrgUnit B.
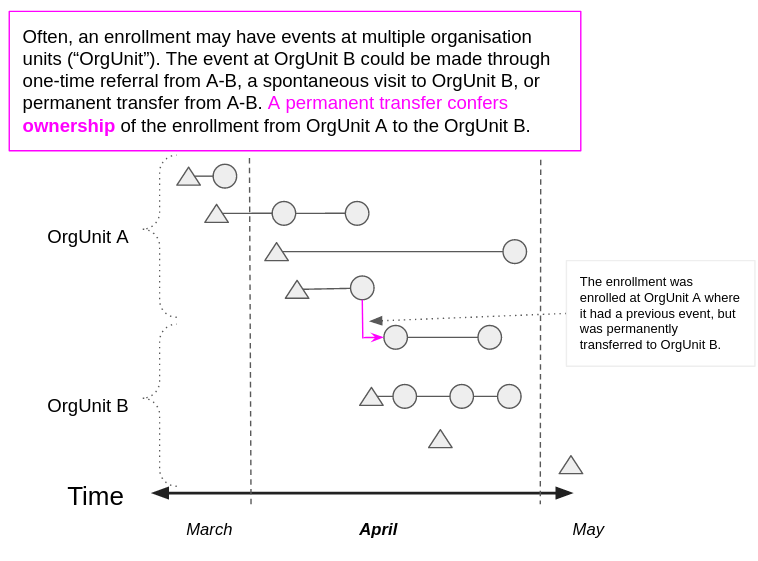
Normalmente, un indicador de programa de tipo evento determinará simplemente su dimensión "Dónde" en función de los eventos que hayan tenido lugar en cada unidad organizativa. Del mismo modo, un indicador de programa de tipo inscripción evaluará en función de las unidades organizativas en las que los usuarios crearon originalmente cada inscripción.
 |  |
Cuando se producen transferencias, hay algunos tipos de consultas que son difíciles de responder con IP de forma precisa, como por ejemplo:
- En conjunto, ¿cuántos pacientes únicos fueron atendidos tanto en la OrgUnit A como en la OrgUnit B durante el mes de abril?
- Problema: Un IP de tipo evento con una expresión V{enrollment_count} contaría todas las inscripciones únicas que tuvieron al menos un evento en OrgUnit A y OrgUnit B. Pero cuando se agrega a un nivel superior, esto contaría doblemente al paciente transferido, que tuvo eventos en ambas OrgUnits durante el mismo periodo.
- Suponiendo que se produzca al menos una visita al mes, ¿cuántos pacientes debería tener la unidad organizativa B en mayo?
- Problema: IP podría contar todas las inscripciones realizadas en la OrgUnit B antes del comienzo de mayo, pero esto no incluiría la transferencia desde la OrgUnit A, que debería esperarse en mayo.
- Para todas las inscripciones realizadas en la unidad organizativa A en marzo, ¿cuántas visitas de seguimiento tuvieron en abril?
- Problema: Sería posible construir un IP de tipo evento con límites de periodo analítico personalizados para encontrar inscripciones realizadas antes en marzo, y eventos realizados en abril. Sin embargo, con el IP de tipo evento, los dos eventos posteriores a la transferencia a la OrgUnit B no se contabilizarían para la OrgUnit A.
En algunos programas para enfermedades crónicas de larga duración, una inscripción puede estar abierta durante mucho tiempo, y un mismo paciente puede transferirse varias veces. El problema central se hace más evidente cuando se trabaja con IP de tipo inscripción para analizar datos a través de múltiples eventos a diferentes intervalos, como un evento de inscripción con una visita de seguimiento puntual.
En este sencillo ejemplo, queremos averiguar cuántos pacientes se inscribieron el mes anterior, pero también tuvieron una visita de seguimiento (evento) en el periodo de notificación. ¿Cómo debemos clasificar a los pacientes que fueron trasladados dentro o durante el periodo de notificación? ¿Es más importante saber dónde se inscribieron o dónde tuvieron lugar sus últimas visitas?
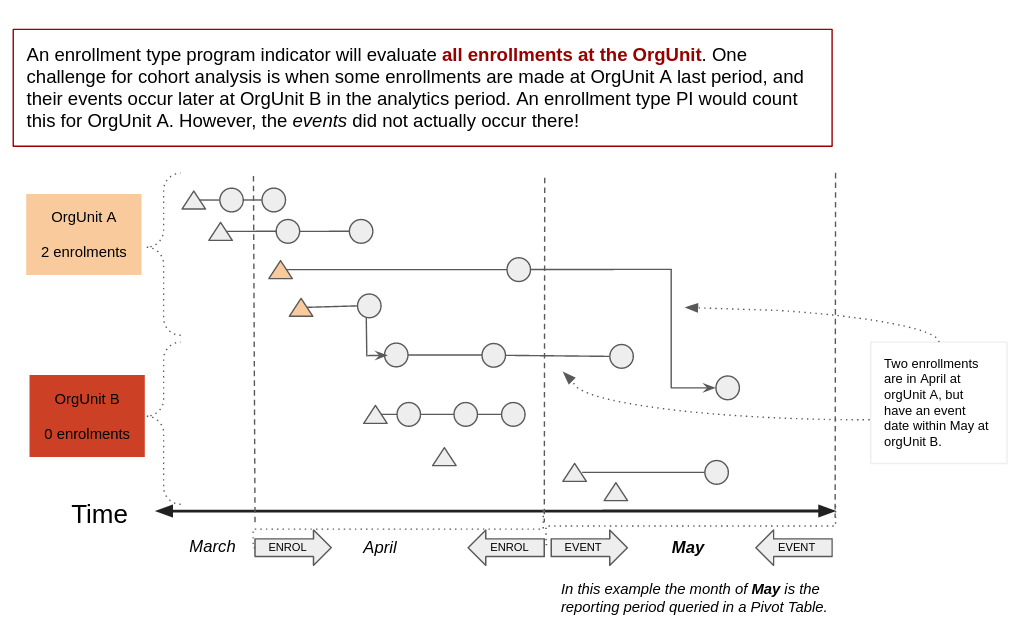
Pero aquí, sólo se puede utilizar la unidad organizativa de la inscripción. Esto podría tener graves consecuencias para grandes implementaciones como VIH o los rastreadores de Nutrición Infantil, donde los pacientes podrían estar inscritos durante varios años y trasladarse repetidamente. Cuando los pacientes se han trasladado, la unidad organizativa de inscripción tergiversa qué unidad organizativa era realmente responsable de proporcionar los servicios e introducir los datos. La mayoría de los gestores de programas querrían controlar el estado de los pacientes basándose en el último lugar en el que recibieron servicios, no en el lugar en el que se inscribieron años antes.
Ownership Analytics (v2.40 y superior)
A partir de la versión 2.40 de DHIS2, el "campo de unidad organizativa" para el cálculo de IP está disponible en la aplicación Mantenimiento (que se encuentra encima de los ajustes de los límites del periodo analítico para cada IP). Esta función ofrece a los diseñadores de sistemas una mayor flexibilidad para configurar la dimensión de la unidad organizativa del cálculo de IP, y aborda los problemas identificados anteriormente.
Ahora hay varias opciones para asignar la unidad organizativa utilizada para el cálculo del IP.
- Unidad organizativa del evento (por defecto para IP de tipo evento, no disponible para el IP de tipo inscripción)
- Unidad organizativa de la inscripción (por defecto para IP de tipo inscripción)
- Unidad organizativa de registro (donde se creó el TEI)
- Unidad organizativa propietaria al inicio del periodo de reporte
- Unidad organizativa propietaria al final del periodo de reporte
Las dos últimas opciones permiten a los diseñadores configurar cómo debe decidirse la dimensión de unidad organizativa del IP: la ubicación antes o después de que se realice una transferencia durante el periodo de reporte.
Volvamos al ejemplo anterior. Queremos ver los pacientes que se inscribieron en el mes anterior y que tuvieron al menos un evento en el periodo de reporte. En este caso, seleccionamos "Unidad organizativa propietaria al final" como campo de unidad organizativa.
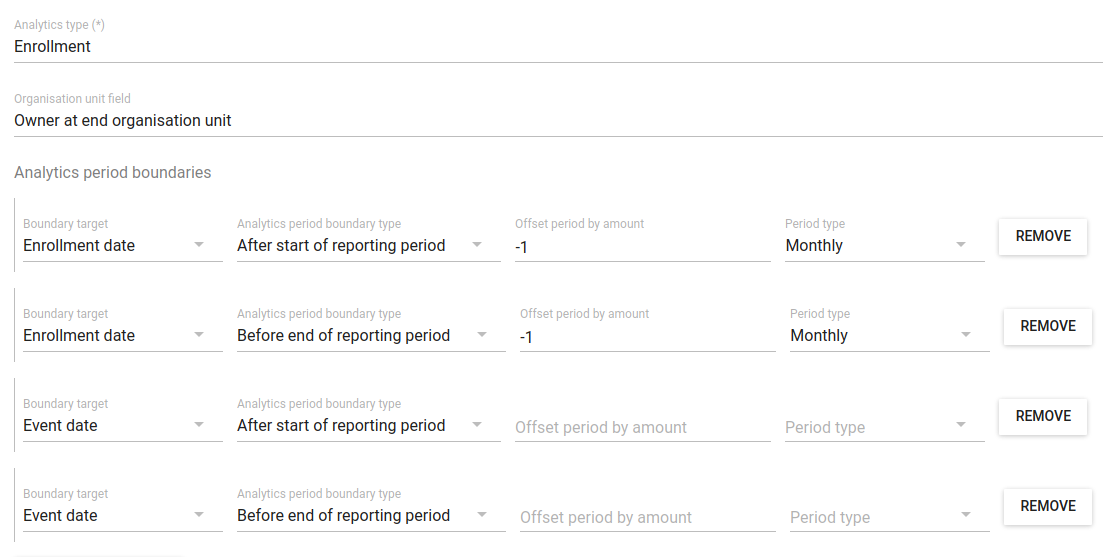
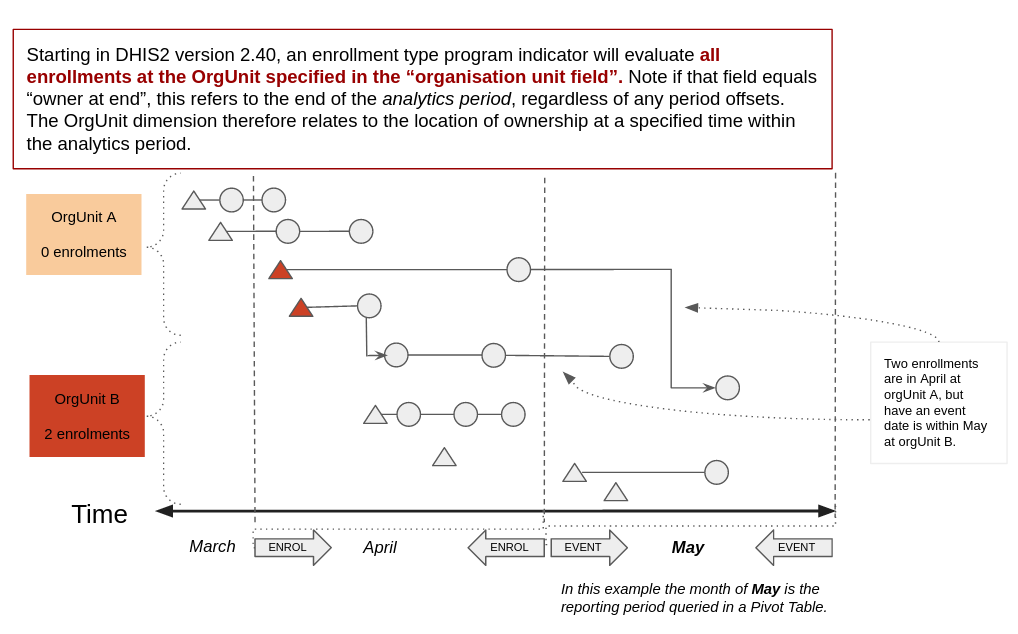
¿Qué ocurre? Las dos inscripciones transferidas de la OrgUnit A se contabilizan ahora para la OrgUnit B. Esto ocurre porque eran propiedad de la OrgUnit B al final del periodo de informe que se está consultando.
Volviendo a nuestros retos anteriores, un uso inteligente de los análisis de propiedad podría resultar decisivo para resolverlos.
- En conjunto, ¿cuántos pacientes únicos fueron atendidos tanto en la OrgUnit A como en la OrgUnit B durante el mes de abril?
- Problema: Un IP de tipo evento con una expresión V{enrollment_count} contaría todas las inscripciones únicas que tuvieran al menos un evento en OrgUnit A y OrgUnit B. Pero cuando se agrega a un nivel superior, esto contaría dos veces al paciente transferido, que tuvo eventos en ambas OrgUnits durante el mismo periodo.
- Respuesta: Un IP de tipo inscripción con una expresión V{enrollment_count}, y los límites del periodo objetivo del evento desde el inicio y el final del mes. El campo de unidad organizativa es "propietario a final de mes", la inscripción transferida contaría para la OrgUnit A, y no para la OrgUnit B.
- Suponiendo que los pacientes deban tener al menos una visita cada mes, ¿cuántos pacientes debe esperar la unidad organizativa B en mayo?
- Problema: IP podría contar todas las inscripciones realizadas en la OrgUnit B antes del comienzo de mayo, pero esto no incluiría el traslado desde la OrgUnit A, que debería esperarse en mayo.
- Respuesta: Un IP de tipo inscripción con una expresión V{enrollment_count}, y los límites del periodo objetivo de inscripción antes del inicio del mes. El campo de unidad organizativa es "propietario al inicio del periodo de reporte", la inscripción transferida contaría para la OrgUnit B.
- Para todas las inscripciones realizadas en la unidad organizativa A en marzo, ¿cuántas visitas de seguimiento tuvieron en abril?
- Problema: Sería posible construir un IP de tipo evento con límites de periodo analítico personalizados para encontrar inscripciones realizadas antes en marzo, y eventos realizados en abril. Sin embargo, con el IP de tipo evento, los dos eventos posteriores a la transferencia a la OrgUnit B no se contabilizarían para la OrgUnit A.
- Respuesta: Un IP de tipo evento con una expresión V{event_count}, límites de periodo objetivo de inscripción con un desplazamiento de periodo para cubrir el mes anterior, y límites de periodo objetivo de evento para capturar todos los eventos dentro del periodo de informe. A continuación, puede decidir cómo gestionar las transferencias realizadas dentro del periodo de notificación. Si el campo de unidad organizativa es "propietario al inicio del período de reporte", entonces los dos eventos en orgUnit B, creados después de la transferencia de propiedad, seguirían contando para OrgUnit A.
Hay que tener en cuenta varias advertencias a la hora de utilizar la unidad organizativa propietaria en los análisis.
- Incluso cuando se produzcan desplazamientos de los límites del periodo analítico que desplacen la ventana analítica hacia delante o hacia atrás en el tiempo, la dimensión de la unidad organizativa seguirá siendo la propietaria al comienzo o al final del periodo de reporte..
- Si se combinan varios periodos en una consulta de este tipo, deberá utilizarse el propietario al principio del primer periodo o el propietario al final del último periodo. Así, mientras que "Meses de este año" y "Este año" cubren el mismo periodo de tiempo, "Meses de este año" mostraría 12 periodos y calcularía la titularidad al final de cada mes por separado, mientras que "Este año" mostraría un periodo y sólo examinaría la titularidad al final del año.
- Las remisiones no confieren la propiedad de la inscripción y sus eventos. Cuando se realizan derivaciones, solo la unidad organizativa "derivada" es la propietaria a efectos de análisis.
- Cuando se realiza una transferencia permanente en Capture o Tracker Capture, esa fecha de transferencia de propiedad es la fecha actual. Por lo tanto, si el personal de entrada de datos registra remisiones realizadas en el pasado, o realiza entradas retrospectivas de datos heredados, el historial de propiedad debe ser actualizado con precisión en el backend SQL de DHIS2 por los administradores del sistema.
- A partir de la v2.40, el número total de derivaciones y traslados no puede calcularse utilizando los indicadores del programa. Esto incluye preguntas como "¿Cuántos pacientes fueron transferidos este periodo?" y "¿Cuántos pacientes han sido referidos en total, y de ellos, cuántos completaron el evento después de su traslado?" Aunque puede ser posible encontrar esta información a través de vistas SQL de la tabla de historial de Titularidad, todavía no es posible desarrollar un IP para calcular el número de acciones de traslado o derivación a partir de mayo de 2023. Esto se está desarrollando para futuras versiones de DHIS2.
Reto común 4: Agregación y Desagregación
En las secciones anteriores se ha asumido que el valor esperado de un indicador de programa debe ser un recuento de casos o encuentros que cumplan determinadas condiciones. Ahora veremos cómo se puede adaptar la configuración de los indicadores de programa para obtener resultados distintos del recuento de casos, por ejemplo, porcentajes o promedios.
En primer lugar, recuerde que cada indicador de programa requiere una "Expresión" y un "Tipo de Agregación", ambos utilizados para agregar los valores del IP. Para IP como recuento de casos, suelen ser muy simples, como Expresión = V{enrollment_count} y Tipo de agregación = Recuento. Pueden adaptarse para diferentes agregaciones, como "el número medio de vacunas administradas a cada bebé nacido el año pasado".
A continuación, es importante recordar que los indicadores de programa también pueden formar el numerador o denominador de un Indicador. Aquí puede relacionar las entradas de datos basadas en datos individuales con los valores de datos agregados de los conjuntos de datos de DHIS2. La mayoría de los programas utilizan este enfoque denominado "superindicadores" para calcular las tasas de cobertura de población de una intervención, incluyendo los valores de población en el denominador y los valores de los indicadores de programa en el denominador. Por ejemplo, podría calcular los recién nacidos vacunados con BCG como porcentaje de todos los recién nacidos en un centro de salud, donde las vacunas BCG administradas se derivan de un programa datos individuales y los recién nacidos son un formulario HMIS a nivel de centro. El numerador y el denominador del indicador pueden incluir expresiones en línea, y el propio indicador tiene un tipo de agregación.
Si se incluye un indicador de programa en el numerador de un indicador, existen cuatro propiedades diferentes que definen la agregación cada vez que se consulta el valor del indicador. Estas propiedades se aplican en un orden específico, que se describe a continuación.
Propiedades de agregación y orden calculado
| Orden | Característica | Nivel de agregación aplicado | Ejemplo |
|---|---|---|---|
| 1 | IP Expresión | Cada evento (o inscripción, según el tipo de IP) | Días transcurridos entre la fecha de nacimiento y la primera vacuna BCG |
| 2 | IP Tipo de agregación | Dentro de todos los eventos (o inscripciones) para cada periodo y dimensión de unidad organizativa | Media de días entre el nacimiento y la vacuna BCG |
| 3 | Expresiones de los indicadores (numerador/denominador) | Modifica el valor del IP después del tipo de agregación, si es necesario, antes de dividir el numerador por el denominador | Si la unidad organizativa tiene una media de más de 60 días entre el nacimiento y la BCG, el valor es 1, en caso contrario 0 |
| 4 | Indicador Tipo de agregación | Cómo combinar valores para múltiples unidades organizativas y/o múltiples periodos | Suma del número de unidades organizativas de las instalaciones que proporcionan "retrasado TAR" este periodo |
¿Qué pasa con la desagregación de los indicadores de programa por características TEI importantes, como la edad y el sexo del paciente? A diferencia de los indicadores agregados, los indicadores de programa no permiten la desagregación de datos sobre la marcha por combinación de opciones de categorías. Para desagregar un indicador de programa, hay que crear un nuevo indicador de programa para cada desglose necesario.
Para crear una desagregación, se une una nueva subexpresión al filtro del indicador de programa. Por ejemplo, el filtro para pacientes con enfermedades subyacentes IP descrito en la sección anterior:
d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Sí')>=1
Añadir un desglose por sexo del paciente requeriría dos indicadores de programa adicionales que filtraran los valores de atributo de entidad rastreados, uno para Hombre y otro para Mujer.
d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Yes')>=1 && A{sex}=='Male'
d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Yes')>=1 && A{sex}=='Female'
Para restringir el filtro por edad, añada una subexpresión para filtrar el tiempo transcurrido entre la fecha de nacimiento y la fecha de inicio del periodo analítico.
d2:countIfValue(#{covacprogramUID.underlyingcondUID},'Yes')>=1 && d2 yearsBetween(A{dob}, V{analytics_period_start}>=60)
Estas adiciones pueden no suponer un reto para producir un pequeño número de desagregaciones. Sin embargo, en situaciones en las que hay muchos desgloses, es una tarea tediosa duplicar y modificar manualmente cada indicador de programa, y mantener los cambios en ellos a largo plazo. Por ejemplo, el desglose por dos sexos y cuatro rangos de edad requeriría ocho indicadores de programa diferentes.
Se han desarrollado dos aplicaciones personalizadas de DHIS2 para automatizar el desglose de los indicadores del programa por múltiples condiciones.
Consejo
Si utiliza la aplicación PDAC, puede aplicar desagregaciones de un indicador de programa a combinaciones de categorías de un elemento de datos agregado. Esto facilita la canalización de datos individuales a agregado, lo que tiene una serie de ventajas, como acelerar las consultas analíticas en los cuadros de mando.
Implicaciones de análisis de datos individuales para el uso de datos
- datos individuales Los datos son longitudinales y están distribuidos geográficamente. Esto significa que los datos de un único TEI no están intrínsecamente ligados a un periodo o a una unidad organizativa. Los indicadores de programa definen cómo consultar los datos individuales basándose en una dimensión de periodo y una dimensión de unidad organizativa.
- Al diseñar un indicador de programa para agregar datos individuales, es esencial definir si se están contando encuentros únicos (eventos) o pacientes (inscripciones o, si la inscripción es repetible, TEI).
- Todos los recuentos de pacientes únicos deben utilizar el IP de tipo inscripción, ya que el tipo de evento conducirá a un doble recuento de pacientes en niveles inferiores. Del mismo modo, todos los IP longitudinales (cálculos que requieren datos de más de un evento) deben utilizar el IP de tipo inscripción. En las versiones de DHIS2 inferiores a la 2.40, los recuentos de pacientes y los indicadores longitudinales están vinculados a la unidad organizativa en la que se inscribió el paciente, que a veces no es el lugar en el que se prestaron los servicios.
- Los IP de tipo inscripción proporcionan una potente forma de consultar datos longitudinales, pero en contextos de gestión de pacientes en los que la inscripción probablemente esté abierta durante un largo periodo de tiempo, la adición de sentencias
d2:countIf()debe utilizarse con discreción. Cuando se calculan sobre la marcha en los cuadros de mando, estas sentencias ralentizan los cuadros de mando y disminuyen el rendimiento del sistema. - En los IP de tipo inscripción existe la posibilidad de malinterpretar la dimensión "dónde" como la unidad organizativa del evento, en lugar de la unidad organizativa de inscripción. Esto debería comunicarse a los usuarios finales de los tableros y participantes de las formaciones.
- Cuando desarrolle IP con "límites del periodo analítico" o "unidad organizativa" personalizados, asegúrese de incluir texto que describa estas personalizaciones en el nombre y la descripción del IP y de cualquier indicador del que forme parte, así como en cualquier visualización o cuadro de mando que presente esos datos, con el fin de facilitar la interpretación del resultado.
- A escala nacional, los IP de tipo evento suelen ser mucho más rápidos de calcular que los IP de tipo inscripción, y potencialmente más fáciles de interpretar para los usuarios finales. Cuando diseñe indicadores de programa esenciales para su programa, intente encontrar formas de incluir todos los datos relevantes del programa en una única etapa del programa si es posible. Las reglas de programa permiten asignar valores de elementos de datos de un evento anterior a eventos posteriores, o a otra etapa. Además, las reglas de programa pueden emplearse para mostrar sólo secciones específicas de las etapas del programa en función de los valores de datos introducidos, lo que facilita la inclusión de todos los datos relevantes en una única etapa.
- Consulte la guía de implementación datos individuales para obtener más lecciones de los sistemas de vacunas COVID-19 sobre la configuración de datos individuales analytics at scale
Una vez que tenga una idea de los atributos de la entidad rastreada (TEA), las etapas del programa, los elementos de datos y los indicadores requeridos del programa, debería poder dibujar un diagrama de diseño del sistema para su sistema datos individuales propuesto, destacando cómo progresa una inscripción individual entre cada etapa. Consulte la documentación del Paquete de Metadatos DHIS2 para ver ejemplos.
Después de haber desarrollado un esquema para su programa, o un primer prototipo, debe revisar las características adicionales que facilitarán la entrada de datos del usuario final.
También puede revisar este primer prototipo con las partes interesadas y una selección de usuarios finales para obtener una ronda de comentarios sobre la viabilidad del diseño del programa propuesto.